


原作者:Heyang Zhou、Andy Jiang、Luca Casonato。原文发表于 Deno Blog,2023 年 9 月 14 日。
原文:Deno KV internals: building a database for the modern web
编者说明:本文按原文完整译写,描述的是 2023 年公开的 Deno KV 分布式实现。下文中的“我们”指 Deno 原作者团队;接口示例、开放测试与免费使用的表述均保留其历史语境。代码仅做静态审查,未运行,也未据此验证当前版本兼容性或性能。本文讨论事务层的设计,不展开本地 SQLite 实现。
Deno 希望简化 Web 与云端开发:它内置现代开发工具,支持直接访问 Web 平台 API,也能通过 npm 导入模块。Web 应用通常还需要持久保存一些应用状态。配置数据库往往意味着一系列设置步骤,之后还要集成 ORM 或其他系统。
如果不做任何前期配置,就能直接使用这样的数据库,会怎样?这正是 Deno KV 提供的能力:
const kv = await Deno.openKv();
const userId = crypto.randomUUID();
await kv.set(["users", userId], { userId, name: "Alice" });
为什么要构建 Deno KV?
Deno 运行时既可以作为 deno 可执行程序在本地计算机上运行,也可以运行在我们的 Deno Deploy 云平台上。Deno Deploy 能把 Deno 应用部署到世界各地的多个区域,让应用的计算资源更接近用户,尽可能降低两者之间的延迟,从而大幅改善应用性能。
我们确定要为 Deno 构建数据库,是因为许多客户都提出了一个很直接的问题:如果应用数据没有同样分布到全球各地,仅把计算分散到各地,就无法真正利用这种部署方式带来的性能收益。
此外,Deno 运行时既面向本地单实例场景,也面向全球多实例场景。我们为其中一种场景引入的任何 API,都应当在另一种场景下同样好用。这样,开发者才能轻松地在本地开发和测试应用,然后把它部署到全球,而不必修改代码或添加配置。
这些需求使我们为 Deno KV 确定了几个设计目标:
- 可扩展:作为分布式数据库,能够以较高吞吐量处理大规模数据。
- 高性能:尽量减少计算端与数据库之间高延迟的网络往返,降低网络延迟的影响。
- JavaScript 原生:面向 JavaScript 和 TypeScript 使用场景设计,API 原生采用 JavaScript 类型。
- 原子事务:提供原子操作,保证数据完整性,并支持复杂的应用逻辑。
- 本地与全球环境无缝衔接:在单实例和多实例场景下都能良好运作。
因此,我们着手构建两个具有相同用户 API 的 Deno KV 版本:一个基于 SQLite,用于本地开发和测试;另一个是面向生产环境的分布式系统版本,尤其用于 Deno Deploy。本文介绍后者的实现。如果你对 SQLite 版本感兴趣,可以直接阅读它的开源代码。
FoundationDB:可扩展、分布式、灵活,并已用于生产环境
我们选择在 FoundationDB 之上构建 Deno KV。FoundationDB 是苹果开源的分布式数据库,应用于 iCloud,也被 Snowflake 使用。它适合用来构建可扩展的数据库方案:通过确定性模拟接受充分验证,具有可扩展性与效率,并提供事务型键值存储 API。
FoundationDB 提供了健壮的分布式数据库所需的机制。不过,要把这些机制转化为一种可在 Deno Deploy 平台上流畅使用、原生面向 JavaScript 的体验,我们仍然面临几项挑战:
- Deno KV 的多租户需求既涉及数据,也涉及配置。不同用户会有不同的复制设置、备份策略和吞吐配额,FoundationDB 并没有原生机制来处理这些差异。
- 我们希望 Deno KV 完全原生地支持 JavaScript,并采用 JavaScript 类型。例如,Deno KV 可以存储有符号变长整数(
bigint),我们还希望能对它们执行原子求和,但 FoundationDB 本身并不支持对变长整数进行原子求和。 - 为了尽量避免计算端和数据端之间的交互延迟持续累积,Deno KV API 围绕非交互式事务,也就是原子操作设计;FoundationDB 提供的则是乐观的交互式事务。虽然可以在其基础上实现 Deno KV API,但直接实现会带来不必要的开销。
这些约束促使我们在 FoundationDB 之上设计了一个新系统,称为事务层(Transaction Layer)。事务层以分布式方式完成事务处理和跨区域数据复制,同时仍把分布式数据库中的困难部分交给 FoundationDB:数据分片、集群内部的同步复制、确保事务处理具备可串行化和线性一致性,以及数据的持久存储。
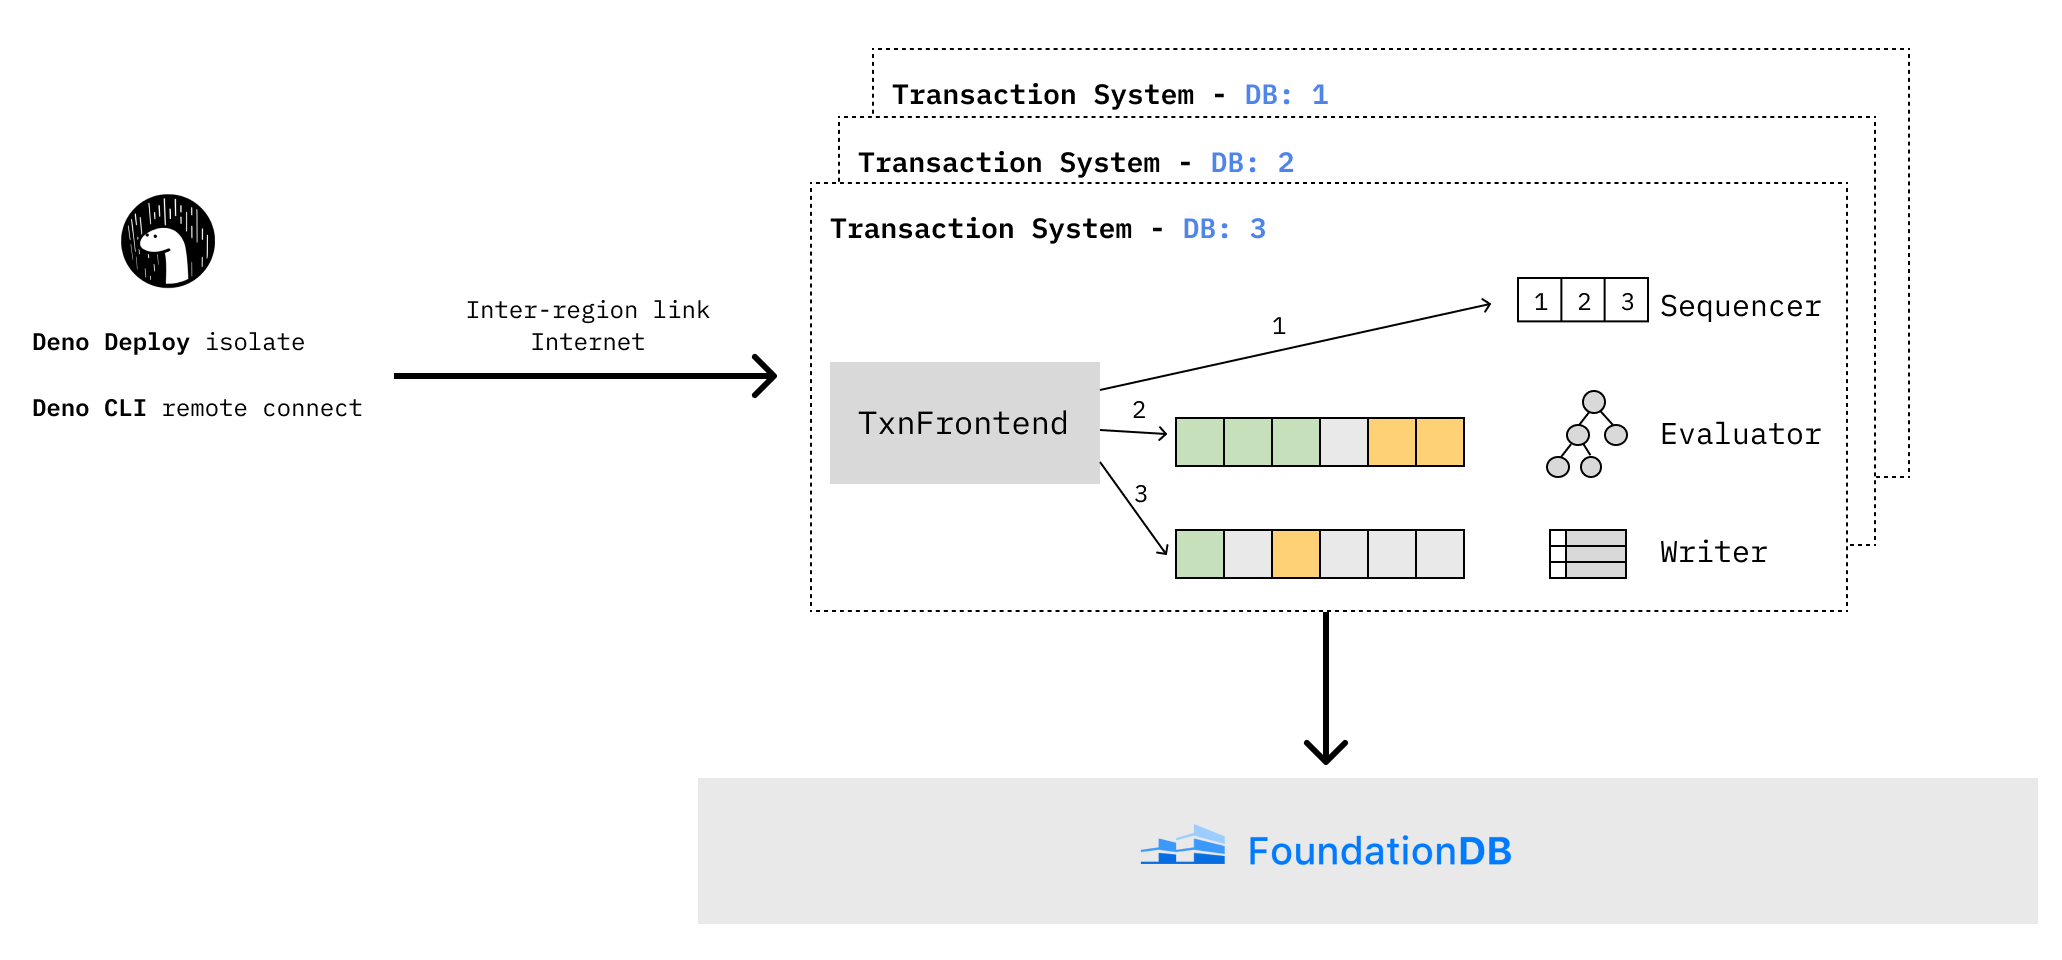
接下来看看,我们如何围绕原子性、低延迟和高并发来设计这个事务层。
用尽可能少的网络请求完成原子操作
原子操作通常借助交互式事务完成:为了保证原子性,需要向数据库发送多次请求。
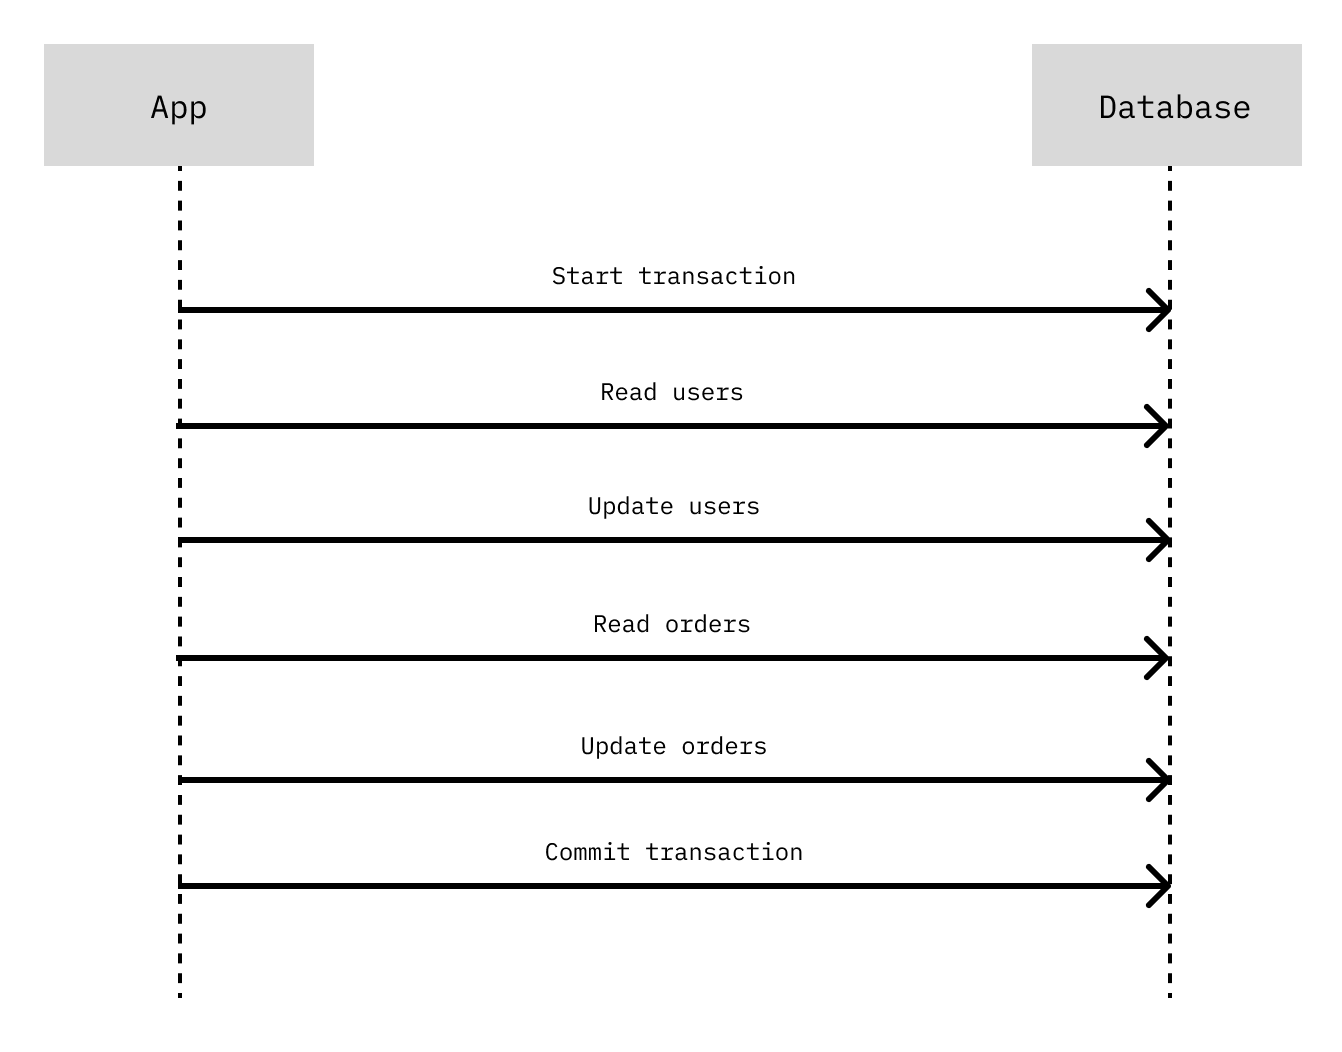
然而,对全球分布式数据库来说,交互式事务代价很高。如果一次写操作就需要在计算服务器与数据库所在区域之间来回数次,那么连续执行多次写操作的 Web 应用就可能承受较高的网络延迟。
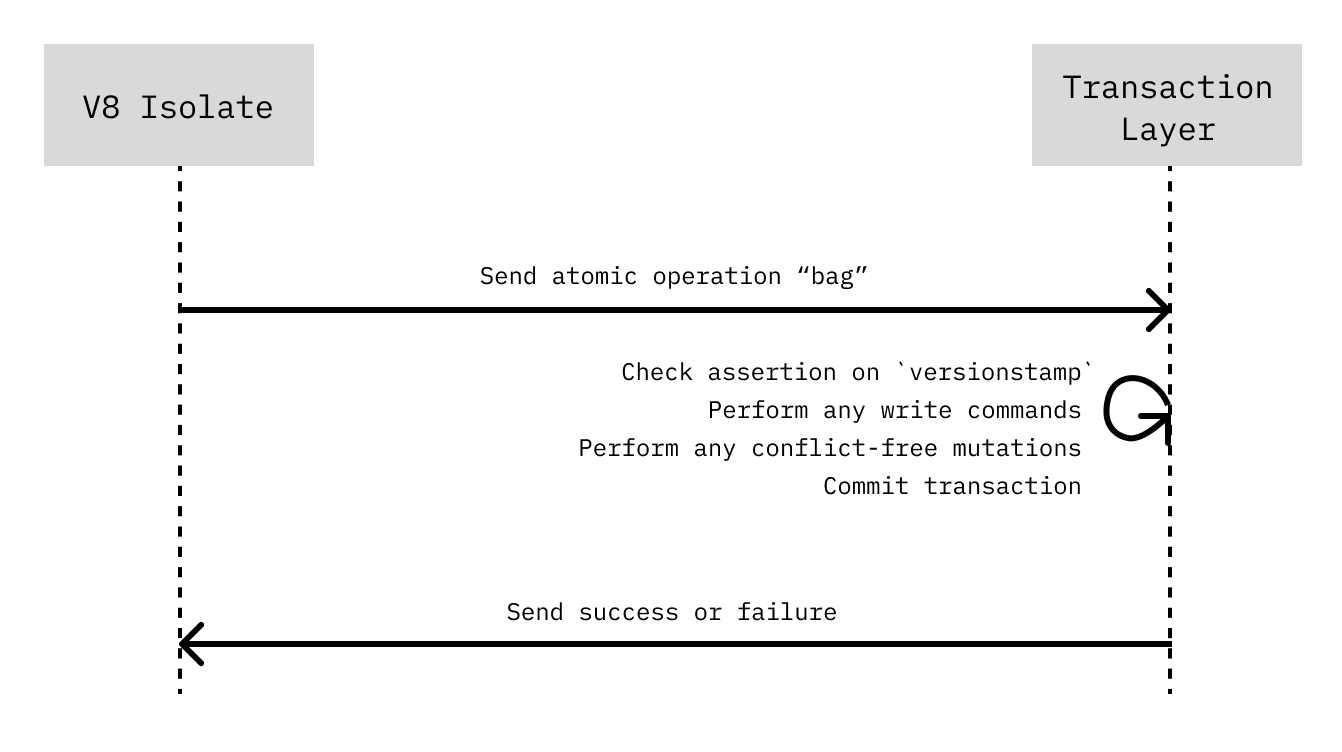
为降低延迟,我们把全球 Deno KV 设计成非交互式系统,目标是让每个事务在一至两次网络往返内完成。为此,所有原子写入都会封装进一个“包”中,里面包含检查条件、写入命令和无冲突变更:
- 检查条件:为了保证原子性,检查键的
versionstamp。如果执行操作时检查不成立,就放弃整个操作。 - 写入命令:针对键执行的任何
.set()或.delete()操作。 - 无冲突变更:从键的旧值计算出新值的操作。例如,
.sum()这种变更会把提供的操作数加到旧值上。
为了构造这个“包”,Deno KV 要求把各项原子操作链接在 .atomic() 之后:
const kv = await Deno.openKv();
const change = 10;

const bob = await kv.get(["balance", "bob"]);
const liz = await kv.get(["balance", "liz"]);
if (bob.value < change) {
  throw "not enough balance";
}

const success = await kv.atomic()
  .check(bob, liz) // balances did not change
  .set(["balance", "bob"], bob.value - change)
  .set(["balance", "liz"], liz.value + change)
.commit();其中,.check(bob, liz) 检查两笔余额在读取后没有发生变化。这样的原子操作 API 设计,旨在尽量减少计算端与数据库之间的往返,以获得更好的性能。
在 FoundationDB 的无锁系统之上构建
数据库中的锁是确保数据完整性的一种机制,它们限制同一时刻能够修改或访问相关数据的事务。相比之下,无锁系统允许并发进程访问和修改数据,在不牺牲数据完整性的前提下提供并行性和可扩展性。
尽管 FoundationDB 采用无锁设计,但如果把冲突检查机制直接交给 FoundationDB,仍然会产生延迟问题。当原子操作包含某种无冲突变更,而这种变更又无法下推为底层数据库的原语时,问题尤其明显。例如:
await kv.atomic().sum(["visitor_count"], 1n).commit();这个原子操作无法直接下推,因为 FoundationDB 原生并不理解 JavaScript bigint 这样的变长整数类型,也就没有为这种类型实现无冲突变更操作。
为了尽可能提高原子操作的性能和并发度,我们构建了 Deno KV 事务层,由它管理原子操作的全局顺序。事务层收到每个事务后,会执行以下流程:
- 排序器(sequencer)分配事务序列号:这个 Transaction Sequence Number,简称 TSN,是一个单调递增整数;它所表示的顺序与原子操作的线性化顺序一致。
- 求值器(evaluator)批量构建并计算依赖图:把该事务与其他事务组成一个批次,构建一张描述所有检查条件、写入命令和无冲突变更之间关系的图,再以尽可能高的并发度处理这张图,直到所有节点的值都已确定。
- 写入器(writer)提交:最终把事务提交给 FoundationDB。
排序器、求值器和写入器是彼此独立的组件,它们协同处理大量操作。我们还能怎样从这条流水线中挤出更多性能?
借助推测执行加快操作
推测执行(speculative execution)是一种提高指令处理吞吐量的技术:它会提前做一些工作,即便这些工作最后可能并不需要。
Deno KV 的事务层采用了这种技术。系统集中为事务分配全局顺序,但允许其他部分以不同的顺序处理事务。在事务输出尚未持久化到磁盘之前,后续事务就可以推测性地使用这些输出。不过,一个事务的效果只有在提交到 FoundationDB 之后,才会对外可见。
这一机制的核心数据结构叫作事务重排缓冲区(Transaction Reorder Buffer),它管理待处理事务的流转过程:
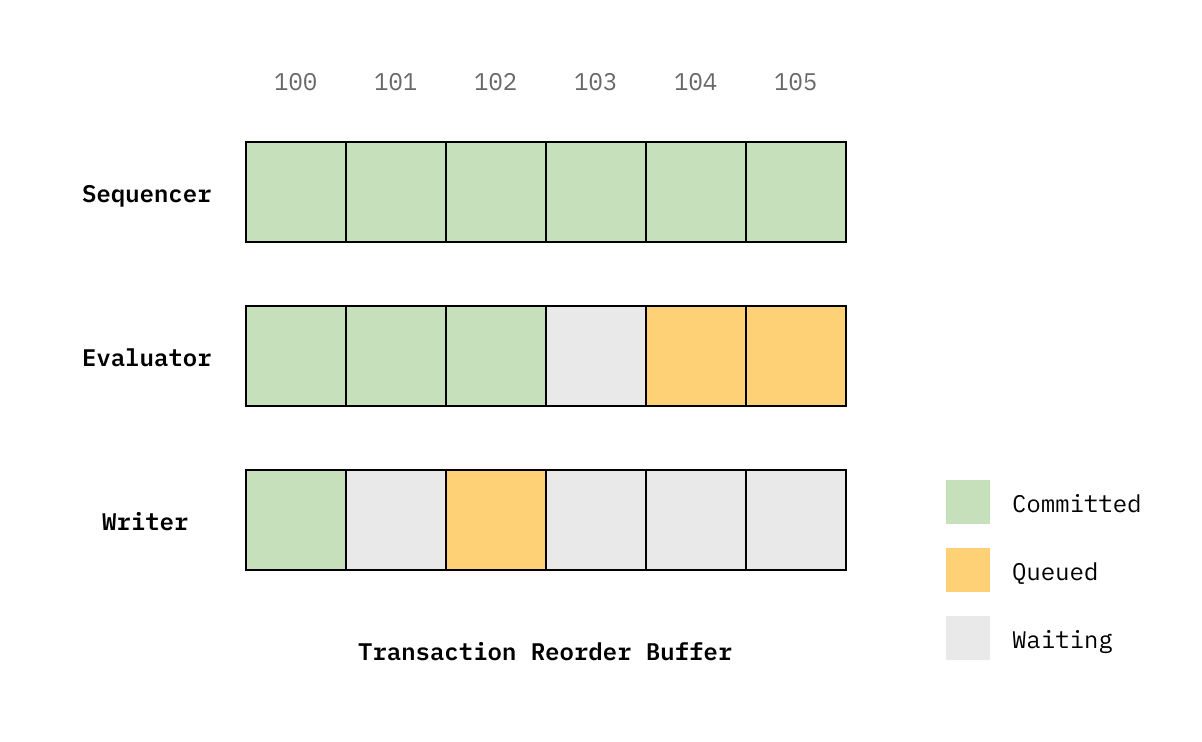
排序器负责发放单调递增的整数,这些整数在同一个 epoch(任期)内是连续的。每个 KV 数据库只有一个排序器实例,但排序成本很低,因为它只需要递增一个内存中的原子计数器。原文还指出,排序阶段只需等待前一个排序阶段提交,即图中的绿色状态。
求值器以批次处理事务。在每个批次中,它会构建一个“数据流子图”,描述所有检查条件、写入命令和无冲突变更之间的关系。这张操作图决定事务成功还是失败,以及各项操作的最终值。随后,求值器以尽可能高的并发度处理子图,直到每个节点的值都已确定。
要更具体地理解数据流子图如何在无锁系统中提供高并发,可以看下面的例子:
// Client 1 is updating the login of user UID1 from “alice” to “bob”
await kv
  .atomic()
  .check({ key: ["users", UID1], versionstamp: V1 })
  .check({ key: ["user_by_login", "bob"], versionstamp: null })
  .set(["users", UID1], user1)
  .set(["user_by_login", "bob"], UID1)
  .delete(["user_by_login", "alice"])
  .commit();

// Client 2 is creating a new user with login "bob"
await kv
  .atomic()
  .check({ key: ["user_by_login", "bob"], versionstamp: null })
  .set(["users", UID2], user2)
  .set(["user_by_login", "bob"], UID2)
  .commit();
客户端 1 要把用户 UID1 的登录名从 alice 改为 bob;客户端 2 则要创建一个登录名为 bob 的新用户。这两个操作相互冲突,因此至多一个能够成功。假设第二个操作分到的 TSN 大于第一个,那么包含这两个操作的求值批次会构建如下数据流子图:
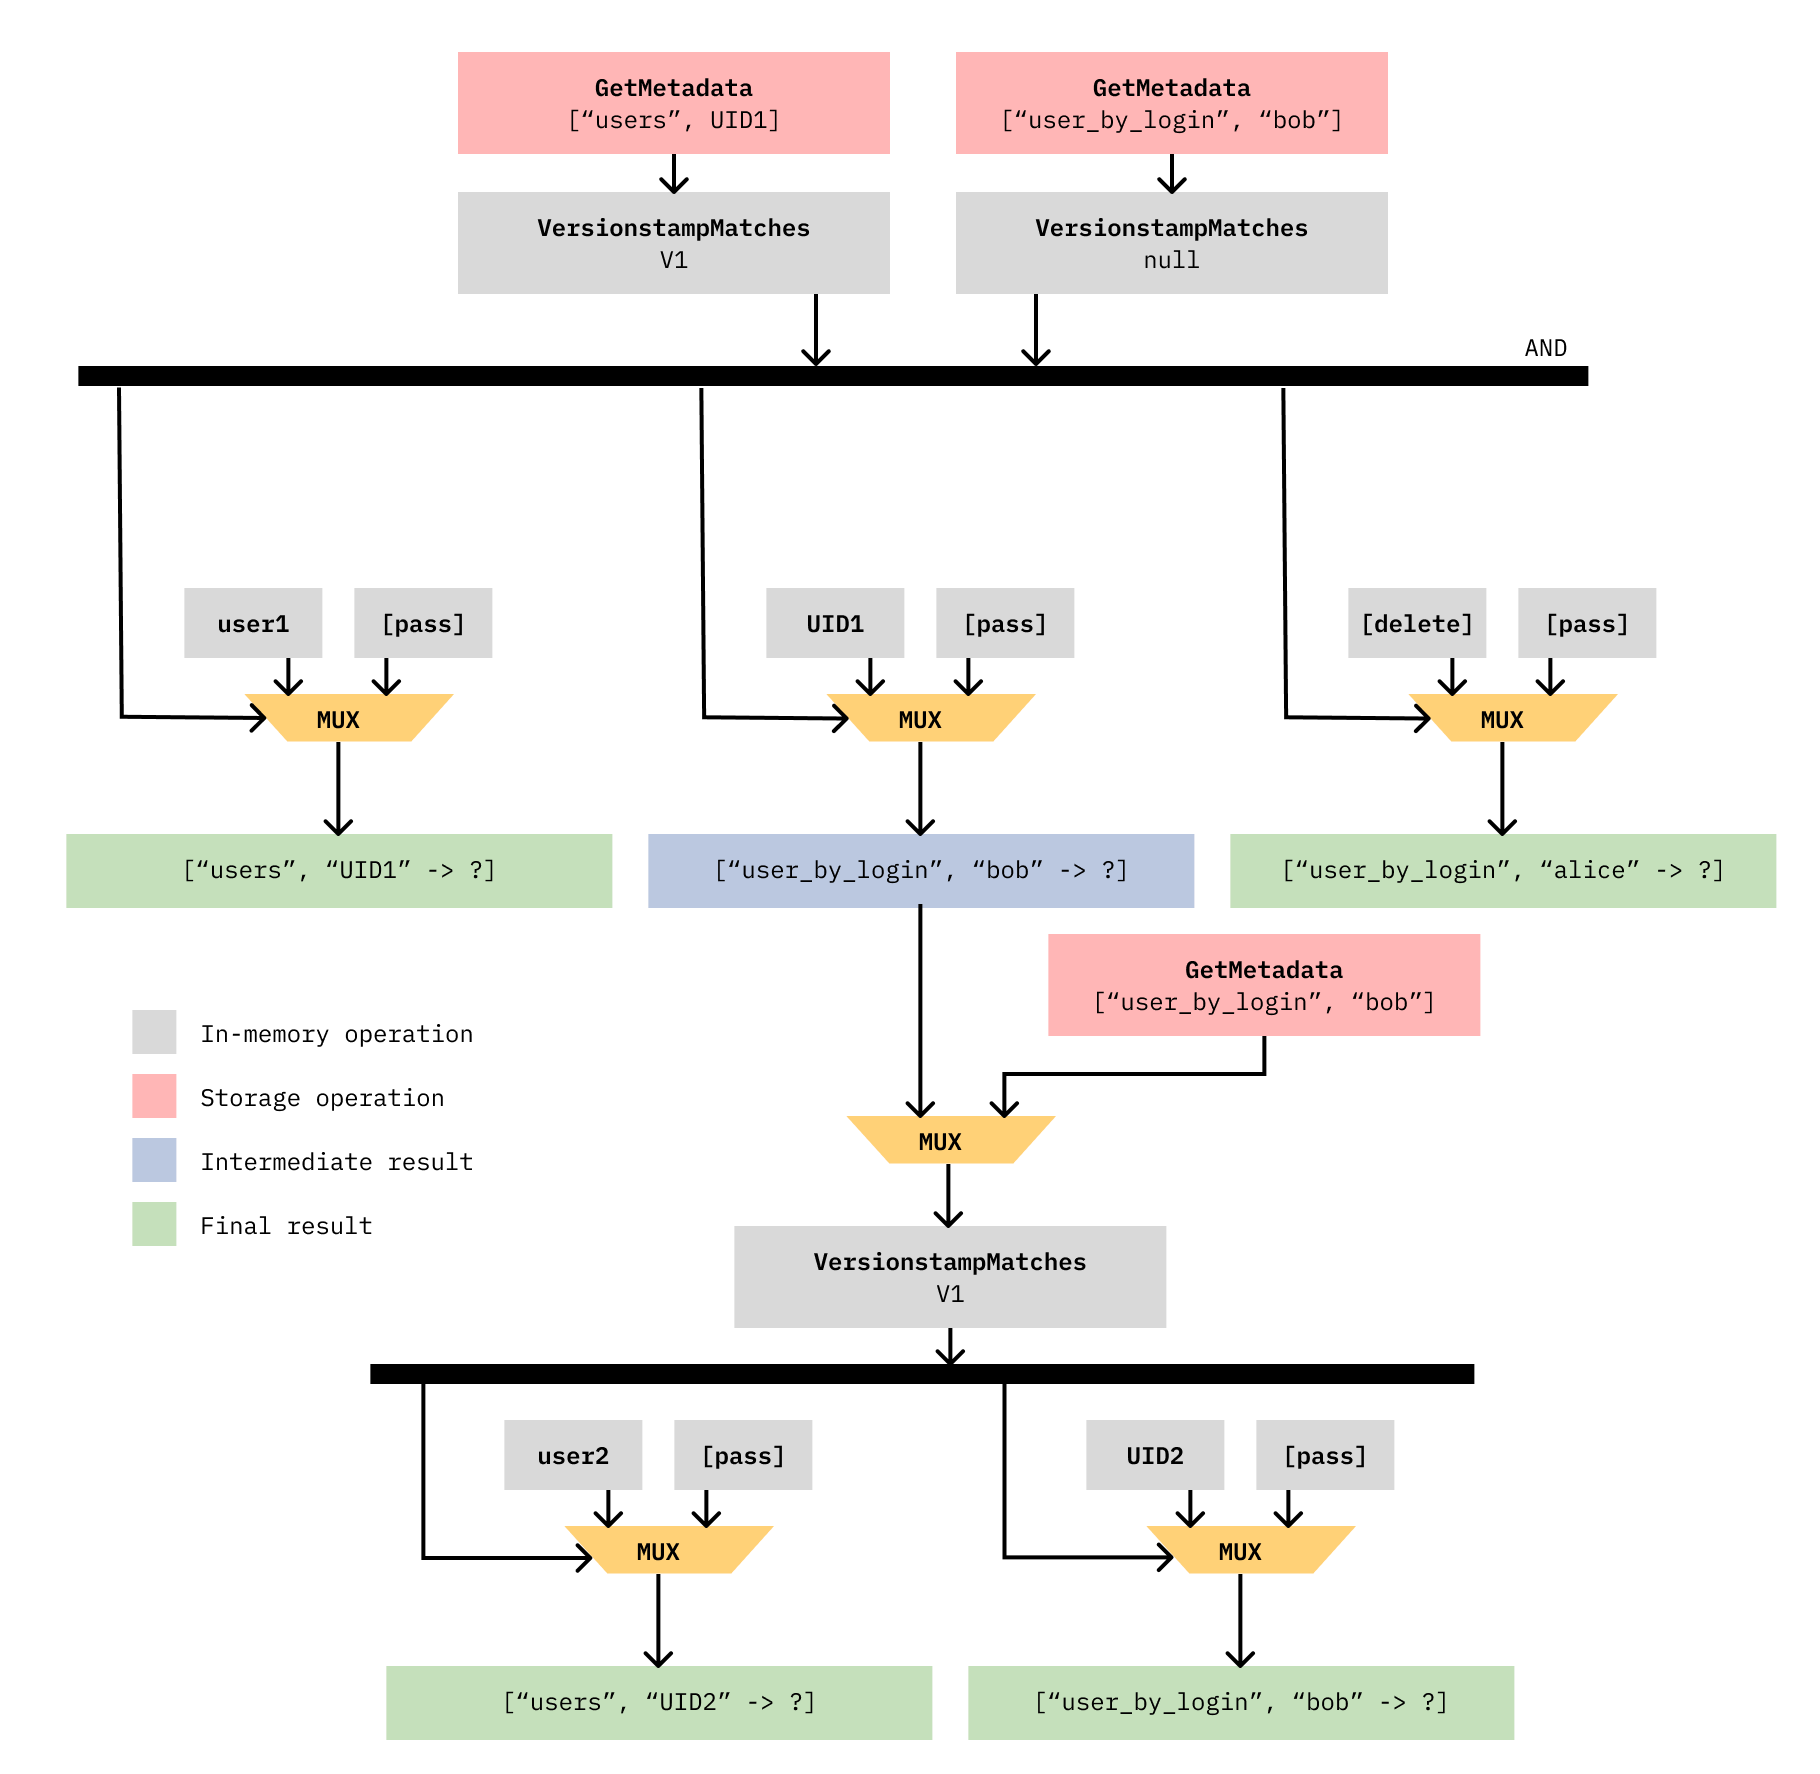
图看起来有些复杂,我们逐步来看。
最上面一行的两个 GetMetadata 方框,对应客户端 1 的两条 .check() 命令:.check({ key: ["users", UID1], versionstamp: V1 }) 与 .check({ key: ["user_by_login", "bob"], versionstamp: null })。它们汇入水平的 AND 线,因为两个检查都必须通过。
从上往下第二行,也就是水平 AND 线下方,是三个 MUX 操作。MUX 即多路选择器逻辑门。这三个操作分别对应客户端 1 的两条 .set() 命令和一条 .delete() 命令。每个 MUX 上方是对应命令的输入:
.set(["users", UID1], user1):在user1和[pass]之间选择。.set(["user_by_login", "bob"], UID1):在UID1和[pass]之间选择。.delete(["user_by_login", "alice"]):在[delete]和[pass]之间选择。
[pass] 的意思只是保留旧值。原命令自身只有一个操作输入,而 MUX 可以接收两个候选输入,因此需要这个表示“不变”的分支。
第一个和第三个 MUX 的输出是绿色,表示最终结果;中间那个 MUX 的输出则是蓝色,表示中间结果。注意,这里的“最终结果”还不是一个已经求出的值,而是一个写入函数;它的输入在图中以 ? 表示,会在这张图构建完成之后再求值。
为什么中间还需要保留一个中间结果?因为客户端 2 的 .check() 需要断言共享键 ["user_by_login", "bob"] 的 versionstamp。要把这个中间结果继续求解为最终结果,就要再引入一个 MUX,让它接收前面的中间结果,以及 ["user_by_login", "bob"] 的 GetMetadata 结果。
最后来到图底部的两个 MUX,它们对应客户端 2 的两条写入命令:.set(["users", UID2], user2) 和 .set(["user_by_login", "bob"], UID2)。从这里就能得到最终结果。
求值器根据一批操作构建出数据流子图后,会计算结果并把它们缓存在内存中。由于这些结果可能还没有在 FoundationDB 中可见,后续求值批次可以使用内存里的结果,继续开展推测执行。随着已知提交版本向前推进,或者系统能够确定相关数据已经可以从 FoundationDB 读取,这些内存结果就会被丢弃。
最后启动写入器,把变更持久化。写入器同样以批次处理事务。在每个批次中,它会把事务结果写入底层数据库,同时完成其他任务,例如写入复制日志,以及把需要过期处理的键加入队列。
把推测执行与“排序器—求值器—写入器”流水线结合起来,有助于尽可能提高并发度和性能,同时保持原子操作的数据完整性。
结语
Deno KV 的开发受到现代 Web 开发需求的推动,也建立在 FoundationDB 所提供的可能性之上。我们一直把功能、可扩展性,以及与 JavaScript 的顺畅集成放在首位。借助 FoundationDB 的无锁系统,再引入事务层和推测执行,我们希望同时改善性能和使用体验。
不过,技术和需求都在变化。我们相信 Deno KV 的基础与设计原则,也清楚技术领域正在不断进步。Deno KV 的发展仍在继续,既由我们的愿景驱动,也受到用户社区宝贵反馈的塑造。
面向未来,我们会继续完善 Deno KV,回应不断出现的新需求,使它适应快速变化的 Web 与云环境。欢迎开发者尝试 Deno KV;更重要的是,欢迎分享见解与反馈,帮助我们决定它未来的发展方向。
原文发布时的说明:Deno KV 已进入开放测试阶段。注册 Deno Deploy,即可免费使用零配置、全球分布式数据库。
编者补充:以上是 2023 年 9 月的产品状态,不是对当前可用性、价格或服务条款的确认。
代码静态审查说明
本次仅检查原文四个代码块,没有执行任何示例,也没有连接数据库。代码会实际新增用户记录、修改余额、累加计数,以及删除旧登录名索引;在真实数据库上运行会改变业务数据。转账示例没有处理记录缺失、类型校验、提交冲突重试或业务幂等性,不能直接当作完整的资金处理程序。两个客户端示例依赖外部定义的 kv、UID1、UID2、V1、user1 和 user2,还假定原登录名索引与用户记录相符。
示例未包含硬编码密钥、日志输出、动态执行或字符串拼接查询;这只能说明所示片段中没有这些内容,不能证明完整应用没有漏洞。它们也没有展示认证、权限隔离、TLS 或连接配置,因此无法据此判断实际部署是否安全。.sum(..., 1n) 等历史类型与接口兼容性未实测;实际使用前应另按目标版本核对。除上述明确标出的文字校注外,代码保持原文,不提供声称已运行成功的修正版。











暂无评论内容