


原文:Unions,Pydantic 官方文档;作者归属为 Pydantic 文档贡献者,页面版权标注 Pydantic Services Inc.。本文按读取时的 latest 页面译写,保留文中明确的版本差异;所有代码仅静态审核,输出均按原文说明,未在本机运行。
多数类型验证要求字段、元素或值符合各自的约束;联合类型只需要其中一个成员验证成功。问题也随之增加:先试哪个分支?第一个成功就停止,还是继续找更合适的?所有分支都失败时,应该呈现哪些错误?
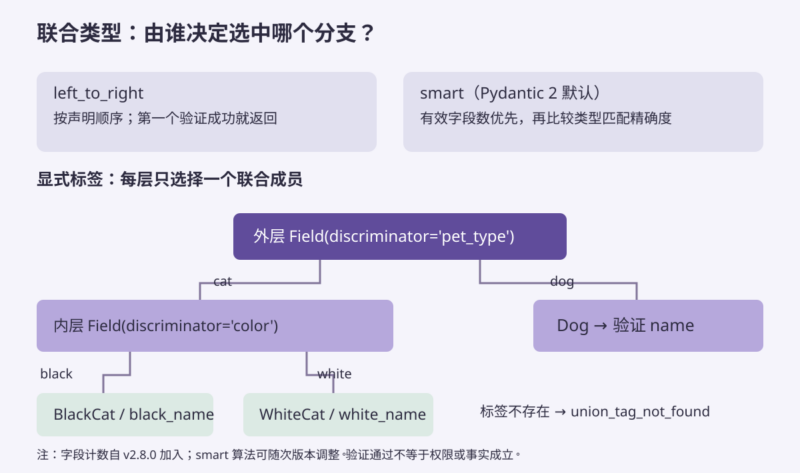
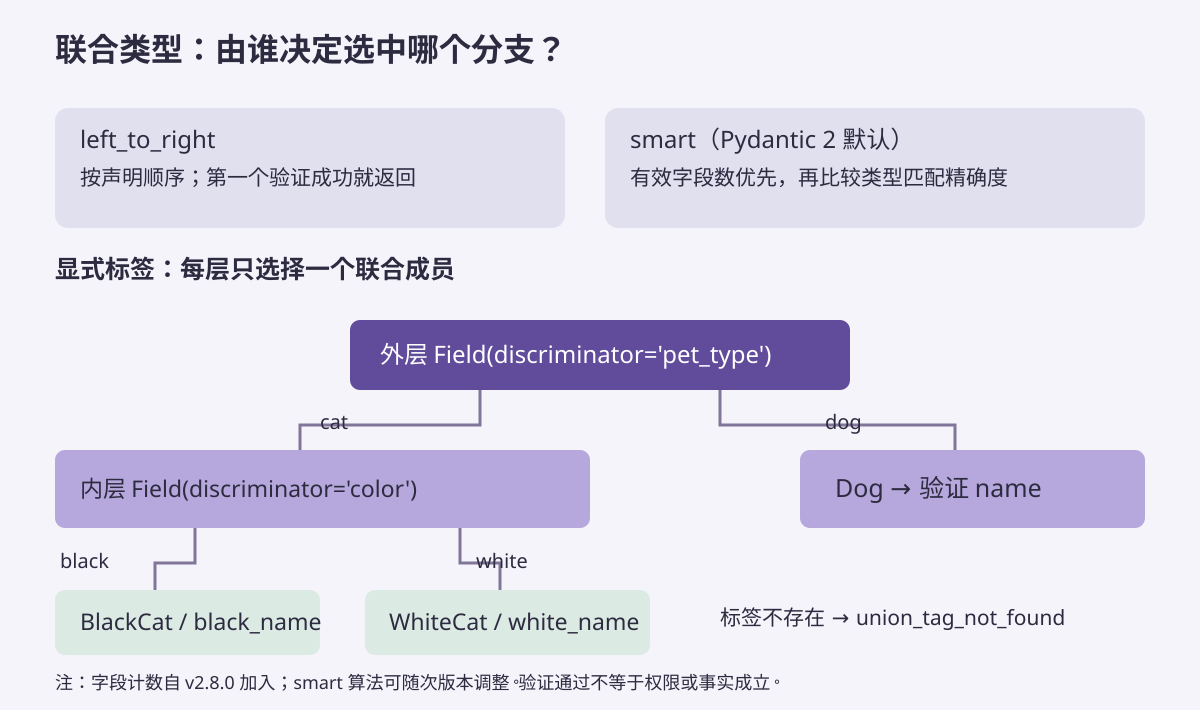
Pydantic 提供三条路径:left_to_right 按声明顺序尝试,采用第一个成功分支;smart 也按顺序尝试,但会在需要时继续寻找更好的匹配,是 Pydantic 2 大多数联合验证的默认模式;判别联合则先读取标签,只验证被指定的那个成员。
官方通常建议使用判别联合,因为分支选择更可预测,也能减少无关验证。复杂的无标签联合若必须保证尝试顺序,可明确使用 left_to_right;更特殊的需求还可以通过自定义验证器表达。
按从左到右的顺序:第一个成功就返回
在联合字段上设置 Field(union_mode='left_to_right'),即可启用按顺序验证。每个成员依次尝试,第一个成功结果被采用;若全部失败,错误中包含所有成员的失败信息。
from typing import Union

from pydantic import BaseModel, Field, ValidationError


class User(BaseModel):
    id: Union[str, int] = Field(union_mode='left_to_right')


print(User(id=123))
# 原文输出:id=123
print(User(id='hello'))
# 原文输出:id='hello'

try:
    User(id=[])
except ValidationError as e:
    print(e)
列表 [] 既不是有效字符串,也不是有效整数,原例因此出现两条错误:id.str 下的 string_type,以及 id.int 下的 int_type,两条都指出原输入为列表。
联合成员的顺序非常重要。交换两个成员后,数字字符串可能被排在前面的整数分支接受:
from typing import Union

from pydantic import BaseModel, Field


class User(BaseModel):
    id: Union[int, str] = Field(union_mode='left_to_right')


print(User(id=123))
# 原文输出:id=123
print(User(id='456'))
# 原文输出:id=456
输入 123 本来就是整数,结果没有意外;输入 '456' 虽然是字符串,却能在宽松模式下转换成整数,因此不会走到后面的字符串分支。这也是 Pydantic 2 不把从左到右模式作为默认值的原因。编者在这段解释中统一使用代码里的 '456',避免原页注释举例字符串与代码不一致。
Smart 模式:字段数量和匹配精确程度
Pydantic 2 默认采用 union_mode='smart',目的是从候选类型中选出更合适的匹配。但官方明确保留在次版本中调整算法的权利,以改善性能和准确性。如果协议依赖非常具体的分支选择结果,应使用显式判别标签,或者在确实需要顺序语义时选择从左到右模式。
当前页面描述两个评分指标:有效设置的字段数,以及类型匹配的精确程度。字段计数是在 2.8.0 加入的,之前只考虑精确程度。
有效字段数用于模型、dataclass 和 TypedDict。成功设置的字段越多,匹配越好;嵌套模型的字段数量也向上累加到顶层联合。在这些类型中,字段数量优先于精确程度;其他类型只看精确程度。
匹配精确程度分为三档,由高到低依次是:输入类型完全匹配;在严格模式下也能通过;只有宽松模式下才能通过。例如对 float | int,整数输入属于 int 分支的精确类型匹配。
对于模型、dataclass 和 TypedDict,算法从左到右评估各分支,记录成功分支的字段数和精确度;全部评估后取有效字段数最多的分支,字段数并列则用精确度决胜。如果所有分支失败,返回全部错误。对于其他类型,一旦遇到完全匹配就立即返回;否则优先取最左侧的严格匹配,再取最左侧的宽松匹配;全部失败则返回所有错误。
from typing import Union
from uuid import UUID

from pydantic import BaseModel


class User(BaseModel):
    id: Union[int, str, UUID]
    name: str


user_01 = User(id=123, name='John Doe')
print(user_01)
# 原文:id=123 name='John Doe'
print(user_01.id)
# 原文:123

user_02 = User(id='1234', name='John Doe')
print(user_02)
# 原文:id='1234' name='John Doe'
print(user_02.id)
# 原文打印:1234;类型仍是 str。

user_03_uuid = UUID('cf57432e-809e-4353-adbd-9d5c0d733868')
user_03 = User(id=user_03_uuid, name='John Doe')
print(user_03)
# 原文:id=UUID('cf57432e-809e-4353-adbd-9d5c0d733868') name='John Doe'
print(user_03.id)
# 原文:cf57432e-809e-4353-adbd-9d5c0d733868
print(user_03_uuid.int)
# 原文:275603287559914445491632874575877060712
这组例子保留了整数、字符串和 UUID 各自的类型。尤其要注意,print(user_02.id) 打印时不带引号,不能只凭打印外观断言它变成了整数。
共同字段作为判别标签
判别联合也叫带标签联合。它先根据判别器确定目标分支,再只验证该分支,从而减少无关分支的开销和错误。生成的 JSON Schema 也会体现 OpenAPI 规范中的 discriminator 信息。
最常见的做法是让每个模型都拥有相同的字段,例如 pet_type,并把字段类型限定为一个或多个 Literal 值。然后在联合字段上指定该字段名:
from typing import Literal, Union

from pydantic import BaseModel, Field, ValidationError


class Cat(BaseModel):
    pet_type: Literal['cat']
    meows: int


class Dog(BaseModel):
    pet_type: Literal['dog']
    barks: float


class Lizard(BaseModel):
    pet_type: Literal['reptile', 'lizard']
    scales: bool


class Model(BaseModel):
    pet: Union[Cat, Dog, Lizard] = Field(discriminator='pet_type')
    n: int


print(Model(pet={'pet_type': 'dog', 'barks': 3.14}, n=1))
# 原文:pet=Dog(pet_type='dog', barks=3.14) n=1

try:
    Model(pet={'pet_type': 'dog'}, n=1)
except ValidationError as e:
    print(e)
pet_type='dog' 已经确定使用 Dog,因此第二次输入只产生一个缺少字段的错误:pet.dog.barks,错误类型为 missing,不会再把 Cat 和 Lizard 的错误一并展开。Lizard 的两个 Literal 值则说明,一个分支可以对应多个标签。
版本提示:当前页面标注,从 2.13 起,以 Literal 为根类型的 RootModel 也可用于原先使用 Literal 类型的位置。不要把这一能力直接假定为所有 Pydantic 2 版本都支持。
没有共同字段时,使用可调用判别器
有些联合模型没有统一字段名:一种对象使用 fruit,另一种使用 filling。这时可以通过可调用的 Discriminator 提取标签,再用 Tag 把标签对应到分支。
设计函数时不能只处理字典。Pydantic 在序列化时也会调用判别器,此时传入的很可能是模型实例。原文因此同时使用字典查找和 getattr:
from typing import Annotated, Any, Literal, Optional, Union

from pydantic import BaseModel, Discriminator, Tag


class Pie(BaseModel):
    time_to_cook: int
    num_ingredients: int


class ApplePie(Pie):
    fruit: Literal['apple'] = 'apple'


class PumpkinPie(Pie):
    filling: Literal['pumpkin'] = 'pumpkin'


def get_discriminator_value(v: Any) -> Optional[str]:
    if isinstance(v, dict):
        return v.get('fruit', v.get('filling'))
    return getattr(v, 'fruit', getattr(v, 'filling', None))


class ThanksgivingDinner(BaseModel):
    dessert: Annotated[
        Union[
            Annotated[ApplePie, Tag('apple')],
            Annotated[PumpkinPie, Tag('pumpkin')],
        ],
        Discriminator(get_discriminator_value),
    ]


apple_variation = ThanksgivingDinner.model_validate(
    {'dessert': {'fruit': 'apple', 'time_to_cook': 60, 'num_ingredients': 8}}
)
print(repr(apple_variation))

pumpkin_variation = ThanksgivingDinner.model_validate(
    {'dessert': {'filling': 'pumpkin', 'time_to_cook': 40, 'num_ingredients': 6}}
)
print(repr(pumpkin_variation))
原例分别得到包含 ApplePie(time_to_cook=60, num_ingredients=8, fruit='apple') 与 PumpkinPie(time_to_cook=40, num_ingredients=6, filling='pumpkin') 的 ThanksgivingDinner。若判别器忽略模型实例输入,轻则在序列化中出现警告,重则在验证阶段发生运行错误。
混合模型与基本类型
判别器不局限于多个模型之间选择。下面把整数与一个模型组合:整数返回标签 int,字典或模型返回 model,其他输入返回 None。
from typing import Annotated, Any, Optional, Union

from pydantic import BaseModel, Discriminator, Tag, ValidationError


def model_x_discriminator(v: Any) -> Optional[str]:
    if isinstance(v, int):
        return 'int'
    if isinstance(v, (dict, BaseModel)):
        return 'model'
    return None


class SpecialValue(BaseModel):
    value: int


class DiscriminatedModel(BaseModel):
    value: Annotated[
        Union[
            Annotated[int, Tag('int')],
            Annotated['SpecialValue', Tag('model')],
        ],
        Discriminator(model_x_discriminator),
    ]


print(DiscriminatedModel.model_validate({'value': {'value': 1}}))
# 原文:value=SpecialValue(value=1)
print(DiscriminatedModel.model_validate({'value': 123}))
# 原文:value=123

try:
    DiscriminatedModel.model_validate({'value': 'not an int or a model'})
except ValidationError as e:
    print(e)
最后的字符串无法提取标签,产生一个位于 value 的 union_tag_not_found 错误,并指出调用的是 model_x_discriminator()。编者说明:返回标签只决定“接下来验证谁”,并不会跳过被选模型的字段校验。
判别器有几种等价的声明位置。以下是语法形式,省略号代表要填入自己的联合成员或 callable,不是完整业务模型:
# 字符串字段名:
some_field: Union[...] = Field(discriminator='my_discriminator')
some_field: Annotated[Union[...], Field(discriminator='my_discriminator')]

# 可调用判别器:
some_field: Union[...] = Field(discriminator=Discriminator(...))
some_field: Annotated[Union[...], Discriminator(...)]
some_field: Annotated[Union[...], Field(discriminator=Discriminator(...))]
不要写只有单一分支的判别联合。Python 在解释类型时会把 Union[T] 变成 T,Pydantic 无法再区分“一个分支的联合”与普通类型。例如 Union[Cat] 不能保留所期望的联合结构。
多层标签通过嵌套 Annotated 表达
一个字段在同一层只能设置一个判别器,但可以把判别联合再包进另一层联合。例如,外层先按 pet_type 区分猫和狗,进入猫分支后再按 color 区分黑猫与白猫:
from typing import Annotated, Literal, Union

from pydantic import BaseModel, Field, TypeAdapter, ValidationError


class BlackCat(BaseModel):
    pet_type: Literal['cat']
    color: Literal['black']
    black_name: str


class WhiteCat(BaseModel):
    pet_type: Literal['cat']
    color: Literal['white']
    white_name: str


Cat = Annotated[Union[BlackCat, WhiteCat], Field(discriminator='color')]


class Dog(BaseModel):
    pet_type: Literal['dog']
    name: str


Pet = Annotated[Union[Cat, Dog], Field(discriminator='pet_type')]


class Model(BaseModel):
    pet: Pet
    n: int


m = Model(
    pet={'pet_type': 'cat', 'color': 'black', 'black_name': 'felix'},
    n=1,
)
print(m)
# 原文:pet=BlackCat(pet_type='cat', color='black', black_name='felix') n=1

try:
    Model(pet={'pet_type': 'cat', 'color': 'red'}, n='1')
except ValidationError as e:
    print(e)

try:
    Model(pet={'pet_type': 'cat', 'color': 'black'}, n='1')
except ValidationError as e:
    print(e)

type_adapter = TypeAdapter(Pet)
pet = type_adapter.validate_python(
    {'pet_type': 'cat', 'color': 'black', 'black_name': 'felix'}
)
print(repr(pet))
# 原文:BlackCat(pet_type='cat', color='black', black_name='felix')
颜色为 red 时,外层已匹配 cat,内层在 pet.cat 报 union_tag_invalid,说明合法标签只有 black 和 white。颜色为 black 但缺少名字时,则在 pet.cat.black.black_name 报 missing。错误路径因此反映实际走过的分支。
如果只需验证联合本身,不必再包一层 BaseModel,可以像末尾那样创建 TypeAdapter(Pet)。编者将原页后续片段所需的 TypeAdapter 导入一并写入上方,使这组代码的依赖关系完整。
递归模型的错误,怎样变得可读
普通联合失败时会记录各个分支的错误;递归模型可能在每一层都重复这一过程。判别联合只对匹配分支生成验证错误,因此错误信息更集中。
from typing import Union

from pydantic import BaseModel, ValidationError


class Model(BaseModel):
    x: Union[str, 'Model']


for data in (
    {'x': {'x': {'x': 1}}},
    {'x': {'x': {'x': {}}}},
):
    try:
        Model.model_validate(data)
    except ValidationError as e:
print(e)原文第一个输入产生四条错误:x.str、x.Model.x.str、x.Model.x.Model.x.str 都无法得到有效字符串,最深层的 x.Model.x.Model.x.Model 则需要字典或模型实例。第二个输入也有四条错误,前三个字符串分支失败,最后是 x.Model.x.Model.x.Model.x 缺少字段。
下面使用判别器,并自定义错误类型、消息和上下文:
from typing import Annotated, Union

from pydantic import BaseModel, Discriminator, Tag, ValidationError


def model_x_discriminator(v):
    if isinstance(v, str):
        return 'str'
    if isinstance(v, (dict, BaseModel)):
        return 'model'


class DiscriminatedModel(BaseModel):
    x: Annotated[
        Union[
            Annotated[str, Tag('str')],
            Annotated['DiscriminatedModel', Tag('model')],
        ],
        Discriminator(
            model_x_discriminator,
            custom_error_type='invalid_union_member',
            custom_error_message='Invalid union member',
            custom_error_context={'discriminator': 'str_or_model'},
        ),
    ]


for data in (
    {'x': {'x': {'x': 1}}},
    {'x': {'x': {'x': {}}}},
):
    try:
        DiscriminatedModel.model_validate(data)
    except ValidationError as e:
        print(e)

data = {'x': {'x': {'x': 'a'}}}
m = DiscriminatedModel.model_validate(data)
print(m.model_dump())
# 原文:{'x': {'x': {'x': 'a'}}}
对最深处为整数 1 的输入,现在只报一条错误,路径为 x.model.x.model.x,类型 invalid_union_member,消息 Invalid union member。对最深处为空字典的输入,只报 x.model.x.model.x.model.x 缺字段。合法的嵌套字符串仍正确往返为原结构。
三个自定义参数分别对应 ValidationError 中的 type、msg 和 ctx 属性。这里将原页两段重复的异常捕获合并为循环,两个输入和验证含义保持不变。
用 Tag 给复杂分支命名
即便没有用判别器先选择分支,也可以给每个联合成员加上 Tag,让错误路径少一些内部类型表示:
from typing import Annotated, Union

from pydantic import AfterValidator, Tag, TypeAdapter, ValidationError

DoubledList = Annotated[list[int], AfterValidator(lambda x: x * 2)]
StringsMap = dict[str, str]

adapter = TypeAdapter(Union[DoubledList, StringsMap])
try:
    adapter.validate_python(['a'])
except ValidationError as exc_info:
    print(exc_info)

tag_adapter = TypeAdapter(
    Union[
        Annotated[DoubledList, Tag('DoubledList')],
        Annotated[StringsMap, Tag('StringsMap')],
    ]
)
try:
    tag_adapter.validate_python(['a'])
except ValidationError as exc_info:
    print(exc_info)
原文未加 Tag 时的两条路径为 function-after[<lambda>(), list[int]].0 和 dict[str,str];加标签后,变为 DoubledList.0 与 StringsMap。错误本身仍然是无法把 'a' 解析为整数,以及输入列表不是字典,并没有因为重命名就减少或绕过验证。示例中的 x * 2 对列表执行的是列表重复,不是把每个数值乘二。
把分支协议和业务信任分开
编者说明:对于稳定 API 或消息格式,显式标签把选择规则写进协议,更容易在新增分支和升级 Pydantic 时评估兼容性;smart 的“最佳匹配”不能被当作永远固定的业务规则。可调用判别器则同时承担字典输入、模型实例和无法判别输入的处理责任。
ValidationError 会包含错误分支和被拒绝的输入值;原文还提到可以借助 Logfire 连同追踪上下文保留这些信息。错误条数变少并不等于输入已脱敏。生产日志或外部观测系统是否保留输入,需要另行制定规则,不能直接将含秘密的异常打印出去。
最后,验证成功只说明数据符合模型与分支规则,不能证明访问者有权限,也不能证明字段所描述的事实真实。本稿没有执行任何代码;静态审查未发现示例中的文件删除、网络请求、真实密钥或关闭 TLS 操作,但实际系统仍须检查自定义验证器、副作用及日志策略。
归属:Pydantic 文档贡献者,© Pydantic Services Inc.。本文增加的边界说明、代码排版及示意图均已明确区分于原文。











暂无评论内容