


原文:File layouts;作者:Ceph authors and contributors。本文依据 Ceph latest 开发版文档译写,按 CC BY-SA 3.0 保留归属并以相同方式共享。文中另行标明了编者的操作边界与核对说明。
CephFS 的文件布局决定文件内容怎样映射到 RADOS 对象:数据进入哪个池、哪个命名空间,以及如何在条带与对象间分配。它不是一个仅影响显示的目录属性。通过虚拟扩展属性(xattr)读取或修改布局,才能明确后续新文件的数据放置方式。
普通文件使用 ceph.file.layout,目录使用 ceph.dir.layout。下文操作文件时以 file 为例,操作目录时应换用 dir 前缀。Linux 发行版未必默认安装扩展属性工具,所需软件包通常名为 attr。
版本与执行边界:原页明确是开发版文档。应用到生产集群之前,应切回实际部署发行版,复核客户端、MDS 和 OSD 的支持情况。本稿未连接 Ceph、未修改布局,也没有执行命令;示例返回值均是原文示例或清楚标记的预期关系。
先认清布局字段
| 字段 | 含义 |
|---|---|
pool |
池名或池 ID,决定文件数据对象所在的 RADOS 池;允许字符为 [a-zA-Z0-9_-.]。 |
pool_id |
数字字符串,表示 Ceph 创建该 RADOS 池时分配的 ID。 |
pool_name |
用户创建池时指定的名称。 |
pool_namespace |
数据池内部的 RADOS 命名空间,仅允许 [a-zA-Z0-9_-.];默认是空字符串,即默认命名空间。 |
stripe_unit |
以字节为单位的条带单元大小。各单元大小相同,最后一个单元可能只有部分空间包含截至 EOF 的文件数据。 |
stripe_count |
组成一个类似 RAID 0 条带的连续条带单元数量。 |
object_size |
RADOS 对象大小,文件内容按此大小组织到对象中,单位为字节。 |
对象大小还有 RADOS 的上限约束。原文给出的 osd_max_object_size 默认值为 128MB;将 CephFS 对象大小设到超过该限制,写入可能失败。过大的对象也可能妨碍集群平稳运行,原文不建议把上限提高到默认值以上。条带参数不存在脱离工作负载的通用最优值。
读取文件布局和有效目录布局
用一个属性可以读出整个布局:
touch file
getfattr -n ceph.file.layout file
# 原文输出:
# file: file
# ceph.file.layout="stripe_unit=4194304 stripe_count=1 object_size=4194304 pool=cephfs_data"
也可以按字段读取。以下是原文的独立查询及对应示例值:
getfattr -n ceph.file.layout.pool_name file
# ceph.file.layout.pool_name="cephfs_data"
getfattr -n ceph.file.layout.pool_id file
# ceph.file.layout.pool_id="5"
getfattr -n ceph.file.layout.pool file
# ceph.file.layout.pool="cephfs_data"
getfattr -n ceph.file.layout.stripe_unit file
# ceph.file.layout.stripe_unit="4194304"
getfattr -n ceph.file.layout.stripe_count file
# ceph.file.layout.stripe_count="1"
getfattr -n ceph.file.layout.object_size file
# ceph.file.layout.object_size="4194304"
池通常以名称返回;刚创建的池在少数情况下可能暂时显示为 ID。目录则还有另一层含义:没有人为定制过布局的目录,并不拥有显式布局,读取 ceph.dir.layout 会报属性不存在。这不表示目录无布局可用,而是会沿祖先目录查找最近的显式布局。
mkdir dir
getfattr -n ceph.dir.layout dir
# 原文输出:dir: ceph.dir.layout: No such attribute
setfattr -n ceph.dir.layout.stripe_count -v 2 dir
getfattr -n ceph.dir.layout dir
# 原文输出:
# ceph.dir.layout="stripe_unit=4194304 stripe_count=2 object_size=4194304 pool=cephfs_data"
需要直接了解有效布局时,可读取 JSON 虚拟属性。当前 inode 没有显式布局时,系统沿路径向上查找最近祖先,再以 JSON 返回。普通文件对应 ceph.file.layout.json:
getfattr -n ceph.dir.layout.json --only-values /mnt/mycephs/accounts
# 原文输出:
# {"stripe_unit": 4194304, "stripe_count": 1, "object_size": 4194304,
#  "pool_name": "cephfs.a.data", "pool_id": 3, "pool_namespace": "",
#  "inheritance": "@default"}
JSON 中额外的虚拟字段 inheritance 用来区分来源:@default 是系统默认布局;@set 表示该 inode 明确设置了布局;@inherited 表示返回的布局继承自某个祖先。
修改布局之前,确认文件为空且客户端有权操作
修改布局用 setfattr。原文先列出池,再分别展示条带与池字段的写法。下面的 file2 必须事先是空文件,各池名和 ID 也必须按实际集群替换:
ceph osd lspools
# 原文输出:
# 0 rbd
# 1 cephfs_data
# 2 cephfs_metadata

setfattr -n ceph.file.layout.stripe_unit -v 1048576 file2
setfattr -n ceph.file.layout.stripe_count -v 8 file2
setfattr -n ceph.file.layout.object_size -v 10485760 file2
setfattr -n ceph.file.layout.pool -v 1 file2
setfattr -n ceph.file.layout.pool -v cephfs_data file2
setfattr -n ceph.file.layout.pool_id -v 1 file2
setfattr -n ceph.file.layout.pool_name -v cephfs_data file2
这些命令展示了不同字段和按 ID、名称设置池的等价入口,不是在推荐一组生产性能参数。文件一旦有内容,就不能用上述方式更改它的布局。原文用下面的过程演示这一限制:
# 仅用于事先确认不存在同名文件的隔离演示目录。
touch file1
setfattr -n ceph.file.layout.stripe_count -v 3 file1
echo "hello world" > file1
setfattr -n ceph.file.layout.stripe_count -v 4 file1
# 原文此时返回:
# setfattr: file1: Directory not empty编者说明:这里虽然目标是普通文件,错误文字仍是 Directory not empty。不要因此改去清空目录。touch 遇到已有文件不会把它变成空文件,> 则可能覆盖同名文件;这组命令只适合确认过路径的专用演示环境。
文件和目录都能用 JSON 设置布局。写入时 inheritance 会被忽略;如果同时指定 pool_name 和 pool_id,以池名优先消除歧义。下面保留原文的属性值,但把目标改成独立的空文件名,以免紧接上一段操作已经写入内容的 file1:
# 编者调整目标名:empty-layout-file 必须是事先创建并确认为空的文件。
setfattr -n ceph.file.layout.json -v '{"stripe_unit": 4194304, "stripe_count": 1, "object_size": 4194304, "pool_name": "cephfs.a.data", "pool_id": 3, "pool_namespace": "", "inheritance": "@default"}' empty-layout-file
权限方面,普通 rw 不足以允许修改布局。原页链接的 客户端能力文档要求在 MDS 能力中额外具备 p 标志,也就是相应范围的 rwp。同时,CephX 客户端还必须拥有目标数据池的 OSD 访问权限。布局设置权和数据池访问权需要分别检查。
编者补充:能力文档还指出,MDS 路径限制只限制文件系统元数据树;若要隔离不可信客户端,应把其数据置于专用 RADOS 命名空间,并配套限制 OSD 能力。单独写一个 pool_namespace 不会自动完成权限隔离。本文不复制文档中的示例密钥,也不提供覆盖现有能力的通用命令。
把新增数据池纳入文件系统,再设置目录
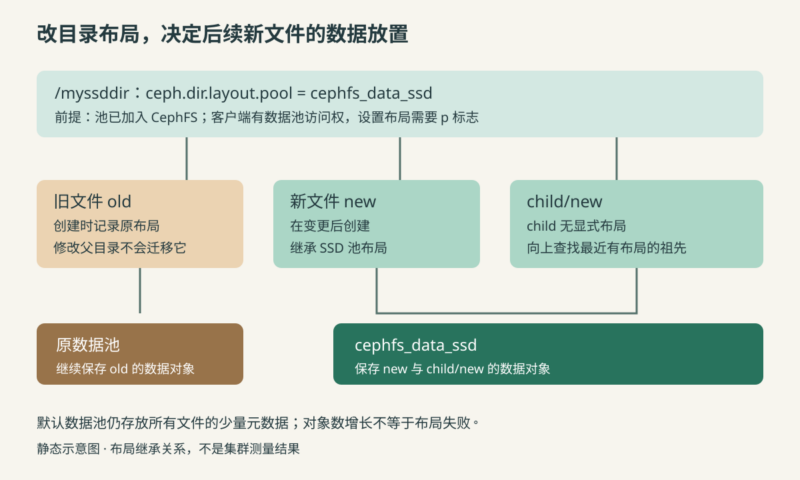
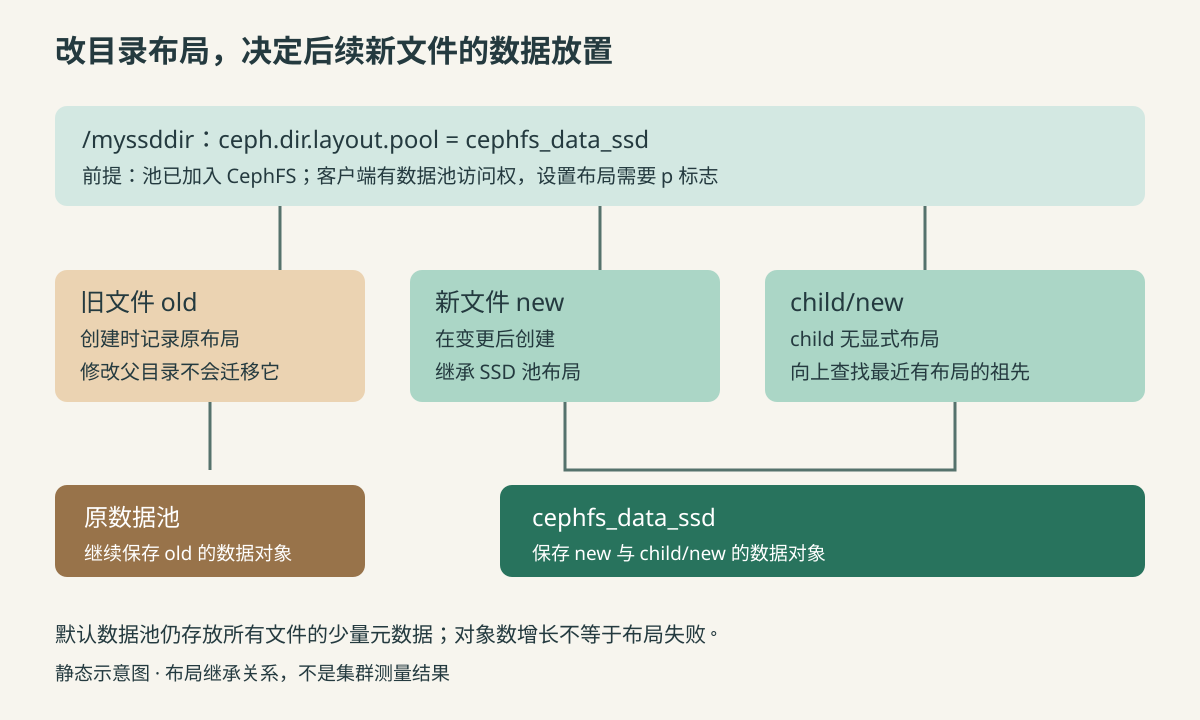
下面假定目标池 cephfs_data_ssd 已按集群要求创建。文件布局页并不负责创建这个池;在使用它之前,先把池加入相应 CephFS 的数据池集合,让 MDS 知道它:
ceph fs add_data_pool cephfs cephfs_data_ssd
ceph fs ls
# 原文展示的结果中应包含:
# .... data pools: [cephfs_data cephfs_data_ssd ]
确认 CephX 密钥允许客户端访问新池,且设置布局的客户端具备前述 p 权限后,再建立目录并将池设置到目录布局:
mkdir /mnt/cephfs/myssddir
setfattr -n ceph.dir.layout.pool -v cephfs_data_ssd /mnt/cephfs/myssddir
从这时起,在该目录中新建的文件会继承这个布局,将文件数据写入新加入的池。它不会搬迁目录中已经存在的文件。
即便新文件的数据已放到指定池,最初传给 fs new 的默认数据池对象数仍可能增长。这是原文明确提醒的正常现象:所有文件仍会在默认数据池保留少量元数据。不能只看默认池对象计数增加,就断言目录布局没有生效。
用新旧文件对照检验继承
文件在创建时继承父目录布局。随后修改父目录,不会改变已有文件的布局。原文用 stripe_count 从 2 改成 4 的方式,使差异容易观察:
getfattr -n ceph.dir.layout dir
# 原文:stripe_count=2,其他字段为 stripe_unit=4194304、
# object_size=4194304、pool=cephfs_data。

touch dir/file1
getfattr -n ceph.file.layout dir/file1
# 原文:file1 的 stripe_count=2。

setfattr -n ceph.dir.layout.stripe_count -v 4 dir
touch dir/file2

getfattr -n ceph.file.layout dir/file1
# 原文:旧文件仍为 stripe_count=2。
getfattr -n ceph.file.layout dir/file2
# 原文:新文件为 stripe_count=4。
若中间目录没有显式布局,后代文件同样会沿祖先链继承:
mkdir dir/childdir
getfattr -n ceph.dir.layout dir/childdir
# 原文:dir/childdir: ceph.dir.layout: No such attribute

touch dir/childdir/grandchild
getfattr -n ceph.file.layout dir/childdir/grandchild
# 原文:
# ceph.file.layout="stripe_unit=4194304 stripe_count=4 object_size=4194304 pool=cephfs_data"编者核对方法:验证指定池时,也应按这一思路分别读取变更前已有文件和变更后新建文件的 ceph.file.layout.pool_name;需要核对命名空间,则读取相应 pool_namespace。这些查询证明的是 inode 的布局信息,不等同于已经做过底层对象逐一盘点或数据迁移验证。本稿没有伪造后一类结果。
清除显式布局,或仅清除命名空间
要让目录恢复从祖先继承布局,可移除它的显式目录布局:
setfattr -x ceph.dir.layout mydir如果只是想回到默认命名空间,不必去掉整个布局。原文先设置 foons,再单独删除命名空间属性:
mkdir mydir
setfattr -n ceph.dir.layout.pool_namespace -v foons mydir
getfattr -n ceph.dir.layout mydir
# 原文:
# ceph.dir.layout="stripe_unit=4194304 stripe_count=1 object_size=4194304 pool=cephfs_data_a pool_namespace=foons"

setfattr -x ceph.dir.layout.pool_namespace mydir
getfattr -n ceph.dir.layout mydir
# 原文:
# ceph.dir.layout="stripe_unit=4194304 stripe_count=1 object_size=4194304 pool=cephfs_data_a"
这里移除的是布局属性或命名空间设置,不是删除文件数据。不过,后续新文件的放置规则会随之改变,所以依然属于会影响生产行为的配置变更;已有文件不会因此自动迁回默认池或默认命名空间。
原文归属:Ceph authors and contributors。许可证:Creative Commons Attribution-ShareAlike 3.0。本篇中文译写与原创示意图按 CC BY-SA 3.0 提供,改动包括中文表达、章节顺序、明确标注的权限补充及静态风险说明。











暂无评论内容