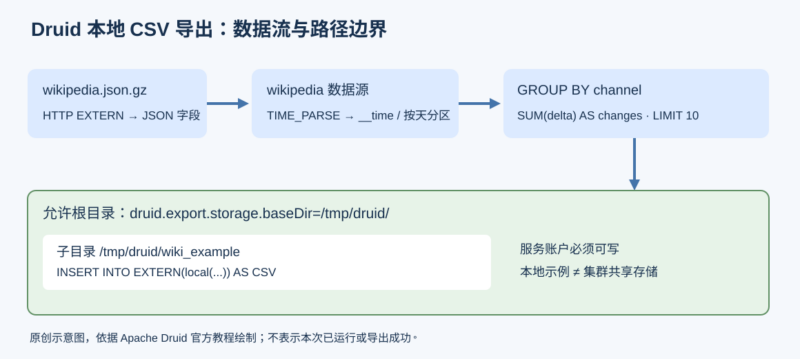



Apache Druid 的 EXTERN 不仅能描述导入数据源,也能在导出语句中指定结果目的地。这篇教程先在单机环境里完成一条完整链路:设置允许的导出根目录,加载 Wikipedia 样例,按频道聚合,再把查询结果写成 CSV。
本文根据 Apache Software Foundation 的 Export query results 译写,核对日期为 2026-10-05。原页未列个人作者。原文除另有说明外采用 CC BY-SA 4.0,本译写遵循同一许可。以下是文档步骤,未在本次编辑中实际执行。
开始前:下载完成,但先不要启动
先按 Druid 的 本地入门指南下载发行包,暂时不要启动,因为导出目录要先写入配置。读者应熟悉基本的数据摄取和 SQL 查询;如还没有操作过,可先阅读 Query data。
本地文件系统导出适合学习语法,原文明确说明它不适用于生产场景。这里的“本地”是运行导出任务的 Druid 环境,不是浏览器所在电脑的下载目录;集群中不同机器上的同名路径也不自动构成共享存储。
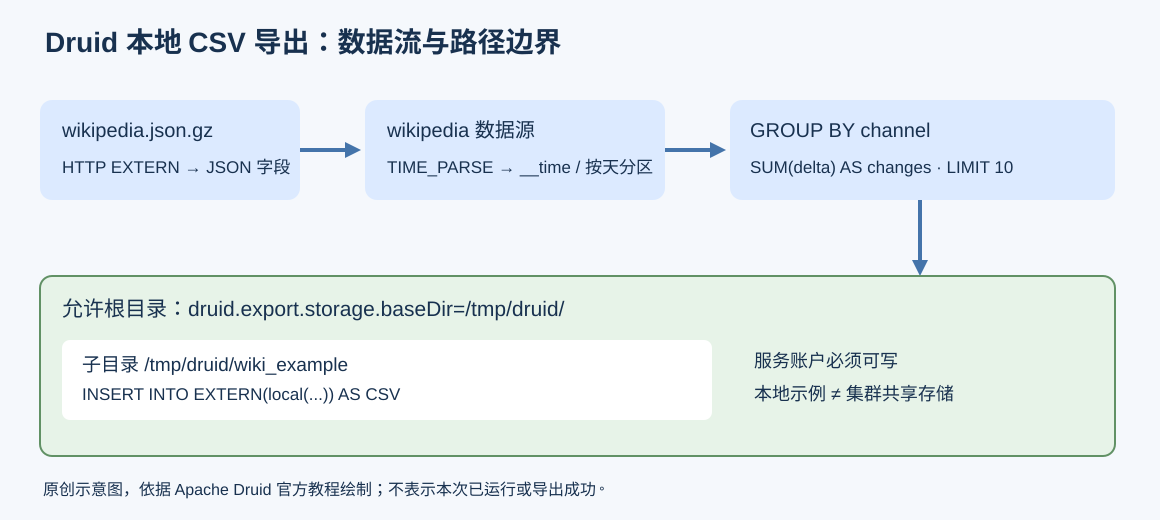
1. 设置允许的本地导出根目录
原文采用 /tmp/druid/。如果运行 Druid 的账户不能访问该目录,应选一个可写目录,例如 /Users/Example/druid,并在后面的所有步骤中同步替换路径。
要修改的是发行包根目录下的 conf/druid/auto/_common/common.runtime.properties。原文使用 export export_path="/tmp/druid" 和 sed -i 追加配置。为避免不同 shell、GNU/BSD sed 的转义差异,下面直接展示应写入文件的内容;这是编者对操作形式的替换,配置含义不变:
#
###Local export
#
druid.export.storage.baseDir=/tmp/druid/
编辑前检查文件中是否已经存在这一属性,避免多次追加相同配置。不要把允许根目录扩大到无关路径。服务账户对目录的访问权限,以及目录所在文件系统的可用空间,都是后续导出能否完成的前提。
2. 启动 Druid 并加载完整样例
从发行包根目录启动:
./bin/start-druid启动后,在浏览器打开 http://localhost:8888/,进入 Web Console 的 Query 视图。以下 SQL 读取官方 Wikipedia JSON 样例,把字符串时间转换为 Druid 的 __time,并按天分区。保留完整字段有助于后续查询使用相同数据模式。
执行前注意:REPLACE INTO "wikipedia" OVERWRITE ALL 会替换同名数据源的全部数据。示例应放在隔离的学习环境;不要对已有业务表直接照抄执行。
REPLACE INTO "wikipedia" OVERWRITE ALL
WITH "ext" AS (
  SELECT *
  FROM TABLE(
    EXTERN(
      '{"type":"http","uris":["https://druid.apache.org/data/wikipedia.json.gz"]}',
      '{"type":"json"}'
    )
  ) EXTEND (
    "isRobot" VARCHAR, "channel" VARCHAR, "timestamp" VARCHAR,
    "flags" VARCHAR, "isUnpatrolled" VARCHAR, "page" VARCHAR,
    "diffUrl" VARCHAR, "added" BIGINT, "comment" VARCHAR,
    "commentLength" BIGINT, "isNew" VARCHAR, "isMinor" VARCHAR,
    "delta" BIGINT, "isAnonymous" VARCHAR, "user" VARCHAR,
    "deltaBucket" BIGINT, "deleted" BIGINT, "namespace" VARCHAR,
    "cityName" VARCHAR, "countryName" VARCHAR, "regionIsoCode" VARCHAR,
    "metroCode" BIGINT, "countryIsoCode" VARCHAR, "regionName" VARCHAR
  )
)
SELECT
  TIME_PARSE("timestamp") AS "__time",
  "isRobot", "channel", "flags", "isUnpatrolled", "page", "diffUrl",
  "added", "comment", "commentLength", "isNew", "isMinor", "delta",
  "isAnonymous", "user", "deltaBucket", "deleted", "namespace",
  "cityName", "countryName", "regionIsoCode", "metroCode",
  "countryIsoCode", "regionName"
FROM "ext"
PARTITIONED BY DAY
这里的摄取语句会访问外部 HTTPS 地址。上面的字段、类型和选择列与原文一致,仅重新排版,未增添原文没有的处理步骤。
3. 聚合并导出 CSV
在 Query 视图中新建一个查询标签,运行下面的导出语句。目标 /tmp/druid/wiki_example 必须是 druid.export.storage.baseDir 的子目录。
INSERT INTO
  EXTERN(
    local(exportPath => '/tmp/druid/wiki_example')
  )
AS CSV
SELECT "channel",
  SUM("delta") AS "changes"
FROM "wikipedia"
GROUP BY 1
LIMIT 10
local(exportPath => ...) 选择本地导出目标,AS CSV 指定格式;查询按第一列 channel 分组,输出每个频道的 delta 总和。LIMIT 10 限制结果行数。原查询没有 ORDER BY,因此这里不把输出解释为“变化最多的十个频道”。
文档随后用下面的命令检查输出目录:
ls /tmp/druid/wiki_example原文描述目录中会出现 CSV 导出文件及一个目录,没有给出固定的文件名,也没有列出实际 CSV 内容。本文同样不虚构文件名、行值或成功截图。实际操作时,应核对任务结果和该目录内容。
原文中的云存储分支
Druid 也支持把查询结果写入 Amazon S3 或 Google Cloud Storage。总体步骤与本地导出相似,但还需要扩展、临时目录、允许的对象前缀与云端授权。本篇保留这些原文条件,不能据此宣称已经完成一个可运行的云部署。
- 启用目的地扩展:S3 使用
druid-s3-extensions,GCS 使用google-extensions。 - 将属性中的
{CLOUD}替换为s3或google。druid.export.storage.{CLOUD}.tempLocalDir是导出暂存目录;allowedExportPaths是允许写入的 S3/GS 前缀,例如["s3://bucket1/export/","s3://bucket2/export/"];maxRetry控制云 API 遇到临时错误时的最大尝试次数。S3 另有druid.export.storage.s3.chunkSize,用于限定暂存目录中单个数据块的最大尺寸。 - 核对实例角色对相应桶和目录的读、写、创建、删除权限。权限应限制到实际导出位置。
- 将本地目的地替换成相应的云存储目的地,并保留后面的查询。
本次下载的原页给出的 S3 示例包含 assumeRoleArn:
INSERT INTO
EXTERN(
  s3(bucket => 'your_bucket',
     prefix => 'prefix/to/files',
     assumeRoleArn => 'arn:aws:iam::some-role'))
AS CSV
SELECT "channel", SUM("delta") AS "changes"
FROM "wikipedia"
GROUP BY 1
LIMIT 10
这些桶名、前缀和角色值只是占位示例,必须按实际环境配置,不能作为真实凭证或已验证 ARN 使用。原页的 GCS 片段写成如下形式:
INSERT INTO
EXTERN
 google(bucket => 'your_bucket', prefix => 'prefix/to/files')
AS CSV
SELECT "channel", SUM("delta") AS "changes"
FROM "wikipedia"
GROUP BY 1
LIMIT 10编者核对:这一 GCS 片段没有像本地/S3 示例那样用括号包住 EXTERN 的参数。本文保留其原貌作为原文记录,不把它作为已验证可运行语句,也不在未核对参考语法的情况下暗中修补。读者实际使用云导出时应再查 导出目的地参考和 SQL-based ingestion security。
最后,原文建议用查询上下文参数 rowsPerPage 控制输出文件大小。虽然可以在末尾加入非常大的 LIMIT 来强制生成单文件,原文不推荐这种方法。行数限制、分页和文件数量不是同一个概念,应按导出需求分别核对。
本篇已静态核对完整原文、配置和代码;没有启动服务、运行查询、访问云桶或实测导出。示例的安全重点是避免覆盖现有数据,并把文件写入与云端权限限定在明确的导出范围内。











暂无评论内容