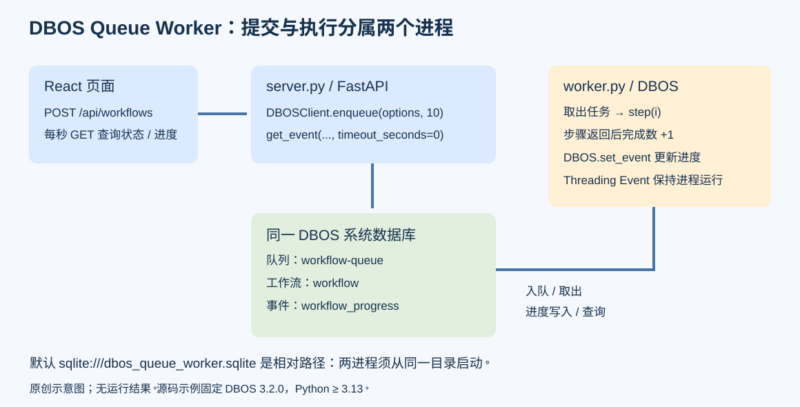



一个 Web 服务可以接收请求、显示任务状态,却不必在自己的进程里执行耗时工作。DBOS 的 Queue Worker 示例把这两种职责拆成两个服务:Web 服务通过 DBOSClient 把工作流放入队列并查询状态,worker 服务负责取出和执行工作流。这样,处理 HTTP 请求与执行持久化任务的进程可以分别管理、分别扩容。
本文依据 DBOS 官方 Queue Worker 教程和 配套示例仓库 译写,已于 2026-10-05 核对页面、README、启动脚本和两端源码。原页未列个人作者,发布方为 DBOS,版权归 DBOS, Inc.。教程另提供 TypeScript 版本;本文只处理 Python 示例。
本次示例项目固定 dbos==3.2.0,要求 Python ≥ 3.13,并依赖 fastapi[standard]>=0.123.8。前端使用 React/React DOM ^18.3.1 与 Vite ^6.0.3,构建需要 Node.js 与 npm,Python 依赖由 uv 管理。这些是所核对仓库的条件,不是所有 DBOS 版本的通用最低要求。
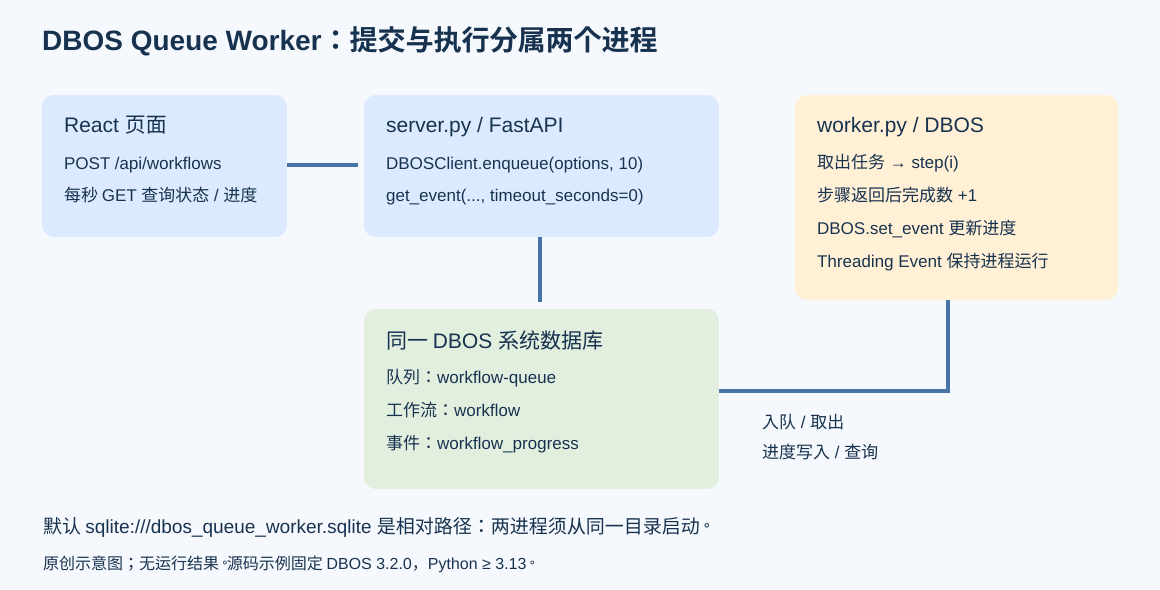
两端的契约:数据库、队列名、工作流名与事件键
这个例子没有让 Web 服务导入并直接调用 worker 的业务函数,而是通过四个一致的约定连接起来:
- 两个进程使用同一个
DBOS_SYSTEM_DATABASE_URL;未设置时默认sqlite:///dbos_queue_worker.sqlite。 - worker 注册
workflow-queue,提交端把相同名称放入EnqueueOptions.queue_name。 - worker 注册名为
workflow的工作流,提交端通过workflow_name指定它。 - 两端都用
workflow_progress作为进度事件键。
默认 SQLite URL 是相对路径。两个服务若从不同工作目录启动,可能分别创建同名但不同位置的数据库文件;表现上就像“任务提交了,worker 却不处理”。因此在本地演示中应从同一示例目录启动;显式指定数据库 URL 时,也要确认两端确实指向同一个系统数据库。跨主机部署不能直接把这个相对 SQLite 文件当作共享服务。
worker:业务步骤和可查询的进度
worker 实现持久化工作流及其步骤。工作流先把 steps_completed 设为 0,并保存总步骤数;每执行完一个步骤,就把完成数更新为 i + 1,再次写入事件。Web 端无需与执行线程保持连接,只要查询这个事件就能了解进度。
下面是配套仓库的完整 worker.py,保留导入和启动代码:
import os
import threading
import time

from dbos import DBOS, DBOSConfig

# Define constants and models
WF_PROGRESS_KEY = "workflow_progress"


# This background workflow is submitted by the
# web server. It runs a number of steps,
# periodically reporting its progress.
@DBOS.workflow()
def workflow(num_steps: int):
    progress = {
        "steps_completed": 0,
        "num_steps": num_steps,
    }
    # The server can query this event to obtain
    # the current progress of the workflow
    DBOS.set_event(WF_PROGRESS_KEY, progress)
    for i in range(num_steps):
        step(i)
        # Update workflow progress each time a step completes
        progress["steps_completed"] = i + 1
        DBOS.set_event(WF_PROGRESS_KEY, progress)


@DBOS.step()
def step(i: int):
    print(f"Step {i} completed!")
    time.sleep(1)


# Configure and launch DBOS
if __name__ == "__main__":
    system_database_url = os.environ.get(
        "DBOS_SYSTEM_DATABASE_URL", "sqlite:///dbos_queue_worker.sqlite"
    )
    config: DBOSConfig = {
        "name": "dbos-queue-worker",
        "system_database_url": system_database_url,
        "application_version": "0.1.0",
    }
    DBOS(config=config)
    DBOS.launch()
    # Define a queue on which the web server
    # can submit workflows for execution.
    DBOS.register_queue("workflow-queue")
    # After launching DBOS, the worker waits indefinitely,
    # dequeuing and executing workflows.
    threading.Event().wait()
@DBOS.workflow() 注册工作流,@DBOS.step() 标记步骤。示例步骤打印一行信息并休眠 1 秒来模拟工作。注意源码先打印 “completed”,再执行 time.sleep(1);真正的进度事件在 step(i) 返回后更新,所以不能把那条日志当成步骤已返回的精确时间点。
主函数创建名为 dbos-queue-worker、应用版本 0.1.0 的配置,初始化并启动 DBOS,再注册队列,最后用 threading.Event().wait() 让进程保持运行。该等待不是额外的轮询实现;后台的 DBOS 队列执行机制负责取出和执行工作流。本文保留所核对 3.2.0 示例中的调用次序,没有按其他版本 API 重写。
Web 服务:提交工作流并返回状态
服务端创建 FastAPI 应用和带 /api 前缀的路由,然后连接同一个系统数据库。POST /api/workflows 固定提交一个有 10 个步骤的工作流。它返回 {"status": "enqueued"},表示提交接口已完成,并不等待那 10 个步骤全部执行。
GET /api/workflows 按工作流名列出记录,使用 sort_desc=True 排序,再对每条记录以 timeout_seconds=0 读取进度事件。刚入队但未开始的工作流还没有事件,因此 steps_completed 和 num_steps 允许为空。进度缺失不应直接显示为执行失败。
完整 server.py 如下:
import os
from pathlib import Path
from typing import List, Optional

import uvicorn
from dbos import DBOSClient, EnqueueOptions
from fastapi import APIRouter, FastAPI
from fastapi.responses import FileResponse
from fastapi.staticfiles import StaticFiles
from pydantic import BaseModel

# Create a FastAPI app and API router
app = FastAPI()
api = APIRouter(prefix="/api")

# Create a DBOS client
system_database_url = os.environ.get(
    "DBOS_SYSTEM_DATABASE_URL", "sqlite:///dbos_queue_worker.sqlite"
)
client = DBOSClient(system_database_url=system_database_url)


# Define constants and models
WF_PROGRESS_KEY = "workflow_progress"
frontend_dist = Path(__file__).parent / "frontend" / "dist"


class WorkflowStatus(BaseModel):
    workflow_id: str
    workflow_status: str
    steps_completed: Optional[int]
    num_steps: Optional[int]


# Use the DBOS client to enqueue a workflow
# for execution on the worker.
@api.post("/workflows")
def enqueue_workflow():
    options: EnqueueOptions = {
        "queue_name": "workflow-queue",
        "workflow_name": "workflow",
    }
    num_steps = 10
    client.enqueue(options, num_steps)
    return {"status": "enqueued"}


# List all workflows and their progress to display on the frontend
@api.get("/workflows")
def list_workflows() -> List[WorkflowStatus]:
    # Use the DBOS client to list all workflows
    workflows = client.list_workflows(name="workflow", sort_desc=True)
    statuses: List[WorkflowStatus] = []
    for workflow in workflows:
        # Query each workflow's progress event. This may not be available
        # if the workflow has not yet started executing.
        progress = client.get_event(
            workflow.workflow_id, WF_PROGRESS_KEY, timeout_seconds=0
        )
        status = WorkflowStatus(
            workflow_id=workflow.workflow_id,
            workflow_status=workflow.status,
            steps_completed=progress.get("steps_completed") if progress else None,
            num_steps=progress.get("num_steps") if progress else None,
        )
        statuses.append(status)
    return statuses


# Serve the API router from the FastAPI app
app.include_router(api)


# Serve index.html for root
@app.get("/")
async def serve_index():
    return FileResponse(frontend_dist / "index.html")


# Mount static frontend files last
app.mount("/", StaticFiles(directory=frontend_dist, html=True), name="static")


if __name__ == "__main__":
    uvicorn.run(app, host="0.0.0.0", port=8000)
WorkflowStatus 同时返回 workflow ID、状态字符串和进度字段。Web 端展示状态与进度时应区分两者:例如已经有进度不等于工作流最终成功,事件不存在也不等于失败。源码的事件查询是非等待式读取,不会为了等待一个尚未出现的事件而挂住每次 HTTP 请求。
最后几行还承担前端托管:frontend_dist 指向脚本所在目录下的 frontend/dist,根路径返回 index.html,静态文件挂载放在 API 路由之后。没有先构建前端时,这个目录可能不存在,页面也不会凭空出现。
从仓库启动这个例子
官方教程先让读者取得仓库并进入 Python 示例目录:
git clone https://github.com/dbos-inc/dbos-demo-apps.git
cd dbos-demo-apps/python/queue-worker
README 给出两步:
uv sync
./launch_app.sh
下面是启动脚本全文。它进入 frontend,安装 JavaScript 依赖并构建静态文件,再把服务端和 worker 放到后台启动,最后等待两个进程。
#!/bin/bash

# Trap ctrl+c and kill all background processes
trap 'kill $(jobs -p) 2>/dev/null; exit' INT TERM

# Build the frontend
cd frontend && npm install && npm run build && cd ..

# Launch both server and worker processes
uv run python3 server.py &
uv run python3 worker.py &

# Wait for both background processes
wait
按 README,启动后从 http://localhost:8000 访问应用。前端构建命令 npm run build 实际调用 vite build。前端 package.json 的完整依赖和脚本如下,便于与本机环境核对:
{
  "name": "queue-worker-frontend",
  "private": true,
  "version": "0.0.0",
  "type": "module",
  "scripts": {
    "dev": "vite",
    "build": "vite build",
    "preview": "vite preview"
  },
  "dependencies": {
    "react": "^18.3.1",
    "react-dom": "^18.3.1"
  },
  "devDependencies": {
    "@types/react": "^18.3.12",
    "@types/react-dom": "^18.3.1",
    "@vitejs/plugin-react": "^4.3.3",
    "vite": "^6.0.3"
  }
}
Python 项目依赖文件也一并保留,避免把最新 SDK 的示例与此处固定版本混用:
[project]
name = "queue-worker"
version = "0.1.0"
description = "Add your description here"
readme = "README.md"
requires-python = ">=3.13"
dependencies = [
    "dbos==3.2.0",
    "fastapi[standard]>=0.123.8",
]

[dependency-groups]
dev = [
    "black>=25.11.0",
    "isort>=7.0.0",
]
这组命令来自 Linux/macOS 风格的 Bash 启动方式。本文没有执行 git clone、安装依赖、启动 FastAPI 或构建前端;仅以 HTTP 读取源文件作为核对证据。没有生成任何实际运行截图或声称已看到任务完成。
前端怎样得到持续变化的进度
配套前端的 App.jsx 首次挂载时调用 GET /api/workflows,之后每 1,000 毫秒重复查询;组件卸载时清理定时器。点击 Enqueue Workflow 会发送 POST,提交期间按钮禁用,成功后立即再读一次列表。Vite 开发服务器把 /api 代理到 http://localhost:8000,生产构建则输出 dist,交给前面的 FastAPI 静态路由提供。
页面按返回状态显示标记:SUCCESS 为绿色、PENDING 为黄色、ERROR 为红色,其他状态为灰色。只有完成数和总步数都不为空时才显示进度条,宽度按 steps_completed / num_steps * 100 计算,并显示“已完成 / 总数”。这正好对应尚未执行工作流可能还没有进度事件的情况。示例总步数固定为 10;若将其改成用户输入,应另行处理零值与范围校验。
源文件还会向浏览器控制台输出完整工作流列表及错误响应。示例里主要是 ID、状态和计数,但扩展业务字段时仍应重新评估日志暴露。轮询只是演示用的更新机制,不等于服务端推送;客户端数量和列表大小增长后,它们会同时增加请求与逐条事件查询开销。
读懂演示代码的运行与安全边界
以下是编者的静态审查说明,不是原教程的测试结论。服务端绑定 0.0.0.0:8000,所以能否被别的机器访问取决于主机网络与防火墙。两个 API 路由未包含鉴权或授权逻辑,提交接口也没有限流;直接放到公网可能允许未授权人员持续入队,或读取工作流列表与进度。学习时应限定网络访问范围,实际对外服务再设计身份、权限和负载控制。源码本身没有配置 TLS。
启动脚本没有 set -e。前端目录切换、安装或构建失败,会让同一行的后续 && 命令跳过,但脚本仍可能继续执行下面的启动行;若失败发生在进入 frontend 之后,它还可能停留在该目录。这会进一步影响 Python 文件路径及相对 SQLite 路径。实际排错时,应先确认构建成功、当前目录正确以及 frontend/dist 存在,不能只看到后台命令出现就认定两端已正常运行。
脚本的 INT/TERM trap 会对当前 shell 的后台 job 发送终止信号。应把它当作独立脚本使用,不要随意 source 到一个已有其他后台任务的交互式 shell。它并不是完整的进程管理器,也没有在本次审查中验证优雅退出和故障恢复行为。
数据库连接串从环境变量读取,没有把秘密硬编码进源文件;若实际 URL 含用户名和密码,应避免把它粘贴到日志、截图或公开稿件。npm install 和依赖同步会下载并运行项目依赖所需的安装环节,也会写入本地文件;本文没有执行这些动作。列表接口逐工作流读取一次进度,真实数据量增长后应评估查询范围和请求开销,不能把演示代码当作已经优化的大规模监控接口。
这个示例的重点是服务边界:Web 进程提交并观察,worker 进程执行,并通过持久化事件报告进度。若沿用代码,先保证四项契约一致,再观察入队状态、工作流状态与进度事件之间的关系。生产扩容、跨主机数据库、鉴权、限流和恢复测试都需要后续单独完成。











暂无评论内容