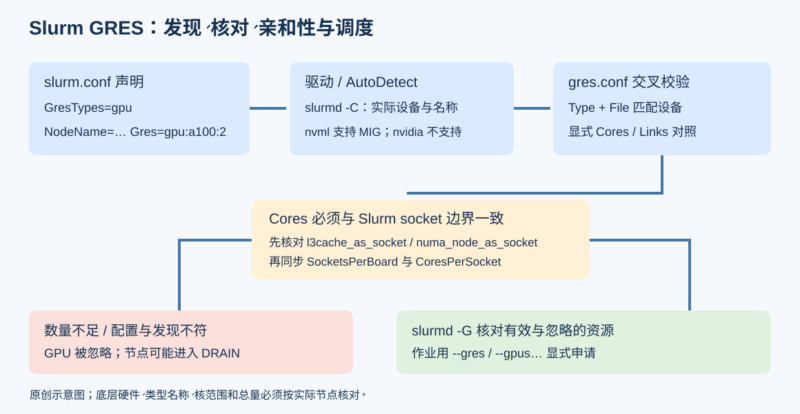



Slurm 通过通用资源(Generic RESources,GRES)管理 GPU,也通过可扩展插件支持 CUDA Multi-Process Service(MPS)和分片共享。接入 GPU 的关键,不只是让操作系统“看见显卡”,还要让控制器声明的数量、节点发现的设备、CPU 拓扑和作业请求彼此一致。
本文根据 SchedMD 的 Generic Resource (GRES) Scheduling 完整译写并重排说明。2026-10-05 下载的导航标示 Slurm 26.05,未见个人署名或独立发布日期。假定集群已安装驱动和 Slurm;所有命令、配置、输出均为官方文档示例,本次只静态阅读,没有修改节点或运行 GPU 负载。
声明资源:slurm.conf 与 gres.conf 分别做什么
集群默认不启用任何 GRES。管理员必须在 slurm.conf 中用 GresTypes 指定管理哪些资源,用节点的 Gres 指定预期数量。若节点发现的资源比配置少,Slurm 会将其置为 DRAIN。原文首先给出四张 GPU、MPS 与文件系统带宽的声明:
# Configure four GPUs (with MPS), plus bandwidth
GresTypes=gpu,mps,bandwidth
NodeName=tux[0-7] Gres=gpu:tesla:2,gpu:kepler:2,mps:400,bandwidth:lustre:no_consume:4G
节点上的 gres.conf 进一步描述资源数、设备文件和应与资源搭配使用的 CPU 核。对于文件系统类型这类不会因作业运行而减少的资源,可使用 no_consume;用户可以请求它,但请求不会消耗一个可递减的库存。完整参数见 gres.conf 手册及 slurm.conf 手册。
编者核对:文档各段配置用于解释不同功能,不能把不同段落直接拼成一套部署配置。例如上面的 MPS 总数为 400,后面的自动发现示例中逐设备 MPS 数量合计为 600;型号标签也不同。实际配置应以本机设备和统一的总量为准。
作业必须明确请求 GPU
salloc、sbatch 和 srun 都可接收资源请求。没有显式请求时,作业不会自动获得 GRES。
| 选项 | 请求范围 |
|---|---|
--gres |
每节点通用资源,格式 name[:type:count] |
--gpus |
整个作业需要的 GPU |
--gpus-per-node |
每节点 GPU,与 GPU 的 --gres 请求等价 |
--gpus-per-socket |
每 socket GPU,作业必须指定 task socket |
--gpus-per-task |
每 task GPU,必须指定任务数 |
--gpu* 类选项只由 select/cons_tres 支持,未配置该插件时会拒绝请求;参数形式为 [type]:count。通用形式中的 name 对应 GresTypes/Gres,type 可指定型号,count 默认是 1。例如:
sbatch --gres=gpu:kepler:2 ....同一作业的类型约束必须一致。若 sbatch 用 --gres=gpu:2 分配,后续不能用 srun --gres=gpu:tesla:2 创建步骤;反过来,分配时指定型号,步骤也应请求同型号。其他专用选项包括 --cpus-per-gpu(每 GPU 的 CPU 数)、--gpu-bind(任务与 GPU 绑定)、--gpu-freq(GPU/显存频率)和 --mem-per-gpu(每 GPU 的内存),同样依赖 select/cons_tres。
分配给暂停作业的 GRES 不会因此释放给其他作业。作业步骤可以从作业已获配的资源中申请子集;默认会得到作业显式请求的 GRES,独占作业隐式得到的资源是例外。步骤显式分配的资源也不会同时给其他步骤使用。原文用三个并行步骤演示 2+1+1 张 GPU 的划分:
#!/bin/bash
#
# gres_test.bash
# Submit as follows:
# sbatch --gres=gpu:4 -n4 -N1-1 gres_test.bash
#
srun --gres=gpu:2 -n2 --exclusive show_device.sh &
srun --gres=gpu:1 -n1 --exclusive show_device.sh &
srun --gres=gpu:1 -n1 --exclusive show_device.sh &
wait
这里的 show_device.sh 未在该页面提供源码,本例用于解释资源划分,不能视为开箱即用的验证脚本。不要在未知内容的脚本上直接启动生产作业。
自动发现与配置交叉校验
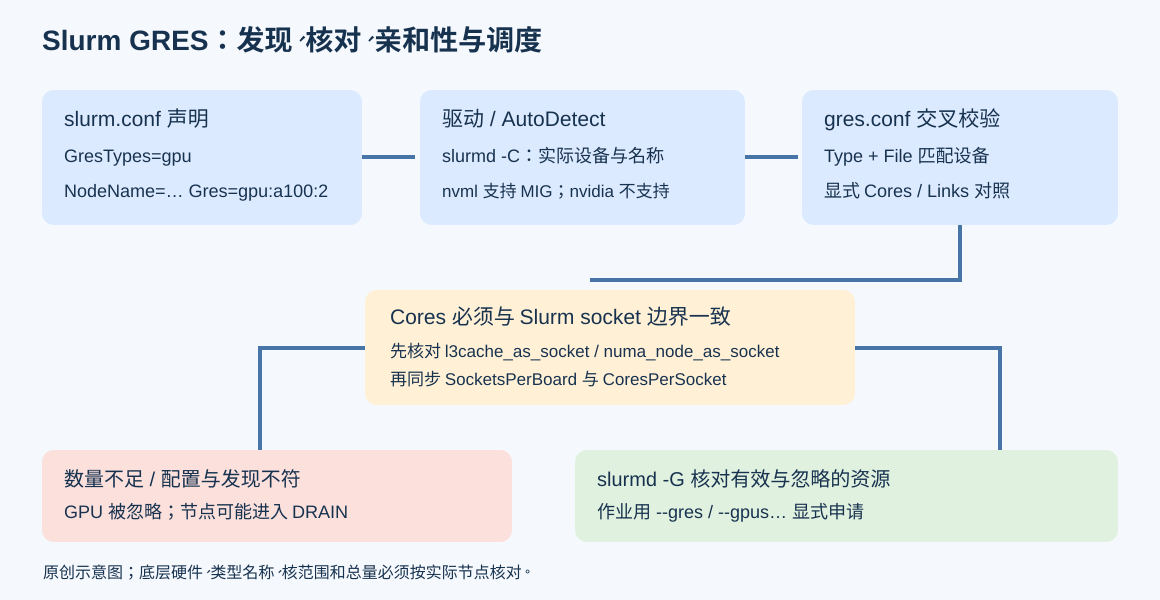
在 gres.conf 设置 AutoDetect=nvml、nvidia、rsmi、nrt 或 oneapi 后,Slurm 可自动填充检测到的 GPU 信息,但 slurm.conf 的 Gres= 仍然必需:控制器要靠它知道预期资源总数。
nvml、rsmi 和 oneapi 需要对应的管理库已安装,并在构建配置 Slurm 时被找到。NVIDIA GPU 可用 nvml 或自 Slurm 24.11 加入的 nvidia 方式;后者不要求 NVML 库,但不会发现 MIG 或 NVLink,不能把“发现了 GPU”理解为具备所有 NVIDIA 功能。
通常 slurmd 完成启动后会卸载为发现而加载的管理库,让其他进程继续使用;若设置 AcctGatherEnergyType=acct_gather_energy/gpu,则会持续持有库以收集功耗。当步骤请求 GPU 时,nvml/rsmi 也会让 slurmstepd 持有库以进行使用量统计;可用 JobAcctGatherParams=DisableGPUAcct 关闭这项统计。请求 --gpu-freq 时,nvml、rsmi、oneapi 同样会由 slurmstepd 加载以设置频率。
原文提醒,管理库被持续持有时,其他进程可能无法配置 GPU。如果 Prolog 需要调整设备,应重新评估 GPU 能耗采集;共享 GPU 的作业还可能需要关闭 GPU accounting。这是功能之间的取舍,不是建议所有集群统一关闭统计。
默认会纳入所有发现的设备。若 gres.conf 中的 Type 和 File 匹配到了实际 GPU,显式填写的 Cores、Links 等属性就会与发现结果交叉校验;不一致时,该 GPU 会被排除并报错。这样,配置文件也能用来发现硬件或拓扑变化。
# Configure four GPUs (with MPS), plus bandwidth
AutoDetect=nvml
Name=gpu Type=gp100  File=/dev/nvidia0 Cores=0,1
Name=gpu Type=gp100  File=/dev/nvidia1 Cores=0,1
Name=gpu Type=p6000  File=/dev/nvidia2 Cores=2,3
Name=gpu Type=p6000  File=/dev/nvidia3 Cores=2,3
Name=mps Count=200  File=/dev/nvidia0
Name=mps Count=200  File=/dev/nvidia1
Name=mps Count=100  File=/dev/nvidia2
Name=mps Count=100  File=/dev/nvidia3
Name=bandwidth Type=lustre Count=4G Flags=CountOnly
这里 Cores 会被核对,未填写的 Links 则由发现结果补足。原文特别说明:如果没有找到匹配的系统 GPU,就不做这种验证,而按配置中的声明处理。因此“写了配置”并不意味着所有属性都已获硬件验证。若发现设备没有全部体现在 slurm.conf 中,相关节点会被 drain;只想使用其中一部分设备时,可以关闭自动发现,再在 gres.conf 中手工列出目标设备。
Type 可以是自动发现 GPU 名称的完整值或子串,名称里的空格会替换成下划线。用下面的命令观察名称:
$ slurmd -C
NodeName=node0 ... Gres=gpu:geforce_rtx_2060:1 ...
Found gpu:geforce_rtx_2060:1 with Autodetect=nvml (Substring of gpu name may be used instead)
UpTime=...
该示例中 geforce、rtx、2060 和 geforce_rtx_2060 都能匹配。接着用 slurmd -G 打印按当前配置形成的 GRES,包括被忽略的自动发现资源。-C 回答“发现了什么”,-G 帮助核对“当前配置会怎样使用它们”。
GPU 亲和性为什么会与 socket 边界冲突
Slurm 调度器内部按 socket 处理 GRES 亲和性。虽然 gres.conf 暴露了 Cores,这不意味着作业调度按任意单核范围执行绑定:步骤检查核,作业使用 socket,两者可能因此对不上。为防止配置承诺调度器做不到的亲和性,Slurm 会检查 Cores 是否与 socket 边界对齐。
自动发现的亲和性来自 GPU 驱动报告的硬件拓扑。在缓存层次复杂的系统中,它可能与 Slurm 当前的 socket 定义不一致,出现类似错误:
error: _check_core_range_matches_sock: gres/gpu GRES autodetected core affinity 0-7 on node node0 doesn't match socket boundaries. (Socket 0 is cores 0-1)官方建议用 l3cache_as_socket 或 numa_node_as_socket 让 Slurm 的 socket 定义贴合实际拓扑,同时调整 SocketsPerBoard 与 CoresPerSocket。持久修改前,先查看参数作用后的发现结果:
$ slurmd -C --parameters=l3cache_as_socket
NodeName=node0 CPUs=32 Boards=1 SocketsPerBoard=8 CoresPerSocket=2 ThreadsPerCore=2 RealMemory=128762 Parameters=l3cache_as_socket Gres=gpu:nvidia_a100-pcie-40gb:2
这里的 32 CPU、8 socket、每 socket 2 核和每核 2 线程只是文档机器的数据。逻辑 socket 数可以不同于物理插槽数;将输出与 nvidia-smi topo -m 对照,确定哪个拓扑参数确实符合本机 GPU 亲和范围。
可通过全局 SlurmdParameters 应用,也可在节点配置中设 Parameters。仅部分节点需要时,原文推荐逐节点设置:
# Global configuration
SlurmdParameters=l3cache_as_socket

# Per-node configuration (recommended when only some nodes need this)
NodeName=node0 CPUs=32 Boards=1 SocketsPerBoard=8 CoresPerSocket=2 ThreadsPerCore=2 Parameters=l3cache_as_socket Gres=gpu:a100:2
随后 gres.conf 保留自动发现:
AutoDetect=nvml原文期望在边界正确对齐后节点正常上线;本次没有硬件实测,不把这项预期写成已发生的结果。另一方案是关闭自动发现,手工填写与实际 socket 边界一致的核范围:
# Manually specify cores for each GPU
NodeName=node0 Autodetect=off Name=gpu Type=a100 File=/dev/nvidia0 Cores=0-15
NodeName=node0 Autodetect=off Name=gpu Type=a100 File=/dev/nvidia1 Cores=16-31
即便手工设置,也不能绕过边界检查;不对齐仍然会被拒绝。修改 CPU 拓扑会影响整个节点的调度语义,应按该节点真实拓扑核对,不能复制示例数值后只消除错误文本。
GPU 使用量统计
将 AccountingStorageTRES=gres/gpu 写入配置后,Slurm 会自动配置并收集 GPU 作业的 gres/gpumem 与 gres/gpuutil;也可以在没有配置 gres/gpu 时单独启用这两项。NVIDIA 需要 AutoDetect=nvml,AMD 需要 AutoDetect=rsmi。NVML 不提供 MIG 利用率指标,因此 Slurm 也不为 MIG 提供这些 gpumem/gpuutil 统计。
原文的节点有两张 A100:
$ nvidia-smi -L
GPU 0: NVIDIA A100-PCIE-40GB (UUID: GPU-...)
GPU 1: NVIDIA A100-PCIE-40GB (UUID: GPU-...)
对应 slurm.conf 与 gres.conf:
AccountingStorageTres=gres/gpu
NodeName=n1 Gres=gpu:a100:2AutoDetect=nvml两个 task、每 task 一张 GPU 的负载示例如下。gpu_burn 源码不在本页,且会产生真实 GPU 负载;本文保留原例但没有执行,不将它列为可复现实验。
$ srun --tres-per-task=gres/gpu:1 -n2 --gpus=2 --mem=2G gpu_burn
GPU 0: NVIDIA A100-PCIE-40GB (UUID: GPU-...)
GPU 0: NVIDIA A100-PCIE-40GB (UUID: GPU-...)
作业结束后,可用 sacct 查看各 rank 的使用高水位;TRESUsageInMin、Max、Ave、Tot 分别体现对应的汇总方式。原文输出为:
$ sacct -j 1277.0 --format=tresusageinave -p
TRESUsageInAve|
cpu=00:00:11,energy=0,fs/disk=87613,gres/gpumem=36266M,gres/gpuutil=100,mem=628748K,pages=0,vmem=0|
$ sacct -j 1277.0 --format=tresusageintot -p
TRESUsageInTot|
cpu=00:00:22,energy=0,fs/disk=175227,gres/gpumem=72532M,gres/gpuutil=200,mem=1257496K,pages=0,vmem=0|
gres/gpuutil=200 是这个多任务示例的总计数值,不能据此解读成单张 GPU 使用率达到 200%。上述作业号、时间、内存和利用率都是官方示例数据。
设备可见性与编号
GRES GPU 插件为每个作业步骤设置 CUDA_VISIBLE_DEVICES,限定该步骤在节点上的可见 GPU。它只在任务被放到具体计算节点上时有意义:salloc 没有全局的统一值,sbatch 环境中的值只反映分配中 node zero 的 GPU。CUDA 3.1 及更高版本利用此变量支持多个作业/步骤使用互不重叠的设备。前面的分步示例可能出现:
JobStep=1234.0 CUDA_VISIBLE_DEVICES=0,1
JobStep=1234.1 CUDA_VISIBLE_DEVICES=2
JobStep=1234.2 CUDA_VISIBLE_DEVICES=3
gres.conf 应填写 File,并按设备编号递增排序。Prolog、Epilog 中也会设置该变量,但它们运行在作业 Linux cgroup 外部,所以其编号可能不同于作业内部。例如分到 /dev/nvidia1 时,Prolog/Epilog 看见 1,只暴露这一张卡的作业内部则可能看见 0。
NVML 按 PCI bus ID 给 GPU 排序。若希望 CUDA 与其一致,应设置 CUDA_DEVICE_ORDER=PCI_BUS_ID。Linux 设备文件编号来自 minor number,两者映射依赖系统,硬件或操作系统改变后重启可能变化。需要保证“这张卡就是这个设备文件”时,应在启动后重新检查,不能仅凭上次编号推断。
MPS:按份额共享一张 GPU
MPS 让多个作业分得同一 GPU 的某个资源比例。slurm.conf 先声明总量,如 NodeName=tux[1-16] Gres=gpu:2,mps:200。gres.conf 有三种表达方式:不写 MPS 条目时,将总量均分给节点 GPU;只写 Name 和 Count 时也均分;写 Name、File、Count 时,逐设备指定份额,适合不同性能 GPU,或用零份额让某张卡不参与 MPS。
MPS 的 Type、Cores 会被忽略,取自底层 gres/gpu。Count 会换算成百分比,通常使用 100 的倍数。通过 NVML 可自动取得 GPU 的 Type、File、Cores、Links,无需重复手写。下面两例分别表示四张卡各 100 份,以及按卡分配不同总份数:
# Example 1 of gres.conf
# Configure four GPUs (with MPS)
AutoDetect=nvml
Name=gpu Type=gp100 File=/dev/nvidia0 Cores=0,1
Name=gpu Type=gp100 File=/dev/nvidia1 Cores=0,1
Name=gpu Type=p6000 File=/dev/nvidia2 Cores=2,3
Name=gpu Type=p6000 File=/dev/nvidia3 Cores=2,3
# Set gres/mps Count value to 100 on each of the 4 available GPUs
Name=mps Count=400
# Example 2 of gres.conf
# Configure four different GPU types (with MPS)
AutoDetect=nvml
Name=gpu Type=gtx1080 File=/dev/nvidia0 Cores=0,1
Name=gpu Type=gtx1070 File=/dev/nvidia1 Cores=0,1
Name=gpu Type=gtx1060 File=/dev/nvidia2 Cores=2,3
Name=gpu Type=gtx1050 File=/dev/nvidia3 Cores=2,3
Name=mps Count=1300 File=/dev/nvidia0
Name=mps Count=1200 File=/dev/nvidia1
Name=mps Count=1100 File=/dev/nvidia2
Name=mps Count=1000 File=/dev/nvidia3MPS 需要 select/cons_tres。默认一个节点上某次 MPS 请求要能放进一张 GPU,不能把 --gres=mps:50 拆成一张卡 20%、另一张 30%。当前页也说明可通过 OPT_MULTIPLE_SHARING_GRES_PJ 更改默认单卡约束;页内随后仍保留单卡模式描述,使用非默认模式时应以相应版本参数手册核对,不能把两段视为无条件同时成立。
同一张卡可以作为完整 gres/gpu,或作为 gres/mps 分配,不能同时处于两种分配方式。同一作业也不能同时请求 GPU 类型与 MPS 类型;MPS 作业不能指定 GPU 频率。多个作业可获分配同一卡上的 MPS,只要总数不超过配置。共享资源与底层整卡分配互斥,查询到相关计数时要区分两层含义。
需要用 Prolog 按需启停 MPS 服务。发行包的 etc/prolog.example 是官方参考:MPS 作业会得到 CUDA_VISIBLE_DEVICES、CUDA_MPS_ACTIVE_THREAD_PERCENTAGE 和 SLURM_JOB_UID,Prolog 应为目标 GPU 与用户启动服务并记录设备 ID;完整 GPU 作业没有线程比例变量,Prolog 则应停止相关 MPS 服务。脚本必须按本地环境调整,本文没有读取或执行该外部脚本,不把它当成完整部署步骤。
MPS 作业还会有 CUDA_DEVICE_ORDER。在原文描述的单卡模式中,设备编号相对于 MPS 服务控制的设备,所以为 0;线程比例由分到的 Count 除以设备总 Count 得出。请求 200 份时,四种卡的例子分别为:
| 设备 | 计算 | 整数百分比 |
|---|---|---|
| gtx1080 /dev/nvidia0 | 200 × 100 / 1300 | 15% |
| gtx1070 /dev/nvidia1 | 200 × 100 / 1200 | 16% |
| gtx1060 /dev/nvidia2 | 200 × 100 / 1100 | 18% |
| gtx1050 /dev/nvidia3 | 200 × 100 / 1000 | 20% |
编者改动:原文在最后三项计算旁重复写了 /dev/nvidia0;此表按其上方完整配置改为 nvidia1/2/3,计算不变。另一种管理方式是先分整卡,再从 scontrol show job 的作业注释中读取 mps-per-gpu 或 mps-per-node,决定按卡或按节点启用 MPS daemon;这同样需要站点自定义 Prolog。
原文提醒旧版 NVIDIA 驱动中的 CVE-2018-6260 可能影响共享 GPU 场景,需按实际驱动核对,不能把历史公告直接当成当前安装版本仍有漏洞。它还指出多用户 MPS 的限制:不同用户的服务器激活由控制 daemon 排队,可能形成用户间分时、串行的独占使用,不能把 Slurm 接受多个用户的 MPS 作业等同于这些用户真正同时在 GPU 上执行。
MIG:已经切分好的实例作为 GPU 调度
Slurm 自 21.08 支持 NVIDIA MIG。部分 GPU(例如 A100)可分成最多七个独立、隔离的实例,Slurm 可把实例看作 GPU,配合 cgroup 隔离和 task 绑定。节点使用 AutoDetect=nvml,slurm.conf 的 Gres 像普通 GPU 一样填写实例数量,例如 NodeName=tux[1-16] gres=gpu:2。
可用 Type 区分 MIG 尺寸和完整 GPU;Type 必须是 slurmd 在 debug2 级别日志中报告的 “MIG Profile” 的子串。两张物理 GPU、一张保留整卡而另一张分成两个 nvidia_a100_3g.20gb 实例的配置为:
AccountingStorageTRES=gres/gpu,gres/gpu:a100,gres/gpu:a100_3g.20gb
GresTypes=gpu
NodeName=tux[1-16] gres=gpu:a100:1,gpu:a100_3g.20gb:2
MultipleFiles 可为一张 GPU 关联多个设备文件。MIG 不支持前面所说的 AutoDetect 属性交叉校验模式;Slurm 要求实例预先完成切分,不负责动态 MIG 分区。切分和驱动能力应另查 NVIDIA MIG 文档。
Sharding:共享名额不等于执行隔离
分片提供一种通用 GPU 共享办法,但它不隔离 GPU 上的进程,只允许共享,因此更适合同质工作流。原文建议节点分片数不要超过能同时运行的作业最大数,例如可用核数。总量在 slurm.conf 声明,如两张 GPU 共 64 片。
分片的三种配置方式与 MPS 类似:不写 shard 条目时均分总量;只写 Name/Count 也均分;写 Name/File/Count 则为每张卡分别指定,零份额可排除设备。Type 与 Cores 从 GPU 条目继承,NVML 可自动发现底层信息。完整 GPU 与 shard 分配互斥,但多个作业或用户可以共享分片,只要不超出总数。默认每节点一次请求要落在一张卡上,也可通过上述 MULTIPLE_SHARING 参数更改。
要启用并统计分片,需要在 GresTypes、节点 Gres 和 AccountingStorageTRES 中都配置相应条目:
AccountingStorageTRES=gres/gpu,gres/shard
GresTypes=gpu,shard
NodeName=tux[1-16] Gres=gpu:2,shard:64
gres.conf 可用四张卡均分 32 片,或逐卡指定每张 8 片:
# Example 1 of gres.conf
# Configure four GPUs (with Sharding)
AutoDetect=nvml
Name=gpu Type=gp100 File=/dev/nvidia0 Cores=0,1
Name=gpu Type=gp100 File=/dev/nvidia1 Cores=0,1
Name=gpu Type=p6000 File=/dev/nvidia2 Cores=2,3
Name=gpu Type=p6000 File=/dev/nvidia3 Cores=2,3
# Set gres/shard Count value to 8 on each of the 4 available GPUs
Name=shard Count=32
# Example 2 of gres.conf
# Configure four different GPU types (with Sharding)
AutoDetect=nvml
Name=gpu Type=gtx1080 File=/dev/nvidia0 Cores=0,1
Name=gpu Type=gtx1070 File=/dev/nvidia1 Cores=0,1
Name=gpu Type=gtx1060 File=/dev/nvidia2 Cores=2,3
Name=gpu Type=gtx1050 File=/dev/nvidia3 Cores=2,3
Name=shard Count=8 File=/dev/nvidia0
Name=shard Count=8 File=/dev/nvidia1
Name=shard Count=8 File=/dev/nvidia2
Name=shard Count=8 File=/dev/nvidia3Sharding 依赖 select/cons_tres,分片作业不能指定 GPU 频率。作业会得到与整卡方式相应的 CUDA_VISIBLE_DEVICES、ROCR_VISIBLE_DEVICES 或 GPU_DEVICE_ORDINAL;步骤还会得到 SLURM_SHARDS_ON_NODE 表示已分配片数。环境变量不构成进程间显存或计算资源的强隔离保证。
查看共享 GRES 的占用
sinfo -O GresUsed 和 scontrol show node -d 会列出已分配 GRES。MPS/shard 显示总量,随后按设备列出占用:
$ sinfo -O NodeList:10,Gres:20,GresUsed:0
NODELIST  GRES                GRES_USED
node0     gpu:4,shard:20      gpu:1(IDX:0),shard:8(-/5,5/5,3/5,0/5)
gpu:1(IDX:0) 表示 GPU 0 被按整卡分配。shard:8(-/5,5/5,3/5,0/5) 中,四张卡各有 5 片:GPU 0 的 -/5 表示因整卡分配而不能再分片;GPU 1 的 5 片已全用;GPU 2 用了 3 片、还能分 2 片;GPU 3 尚未使用,可按整卡或最多 5 片分配。两项计数描述的是同一组底层设备,不能简单把它们相加成独立 GPU 数。
节点排错应回到同一条链路:先核对 slurmd -C 的实际发现,再看 slurmd -G 的有效配置和忽略原因;若是 Cores 错误,再核对 socket 定义、驱动拓扑和设备文件。本文完成了文档与代码静态审查,没有提交作业、运行 show_device.sh/gpu_burn、修改拓扑或重新配置任何集群。











暂无评论内容