


原文:VFS Read Replicas,Litestream 官方指南;作者归属为 Litestream 文档贡献者。本文完整译写该只读 VFS 指南,并标注编者的代码修订与兼容性说明。所有命令和代码仅做静态审查,未构建扩展、连接云存储或执行查询。
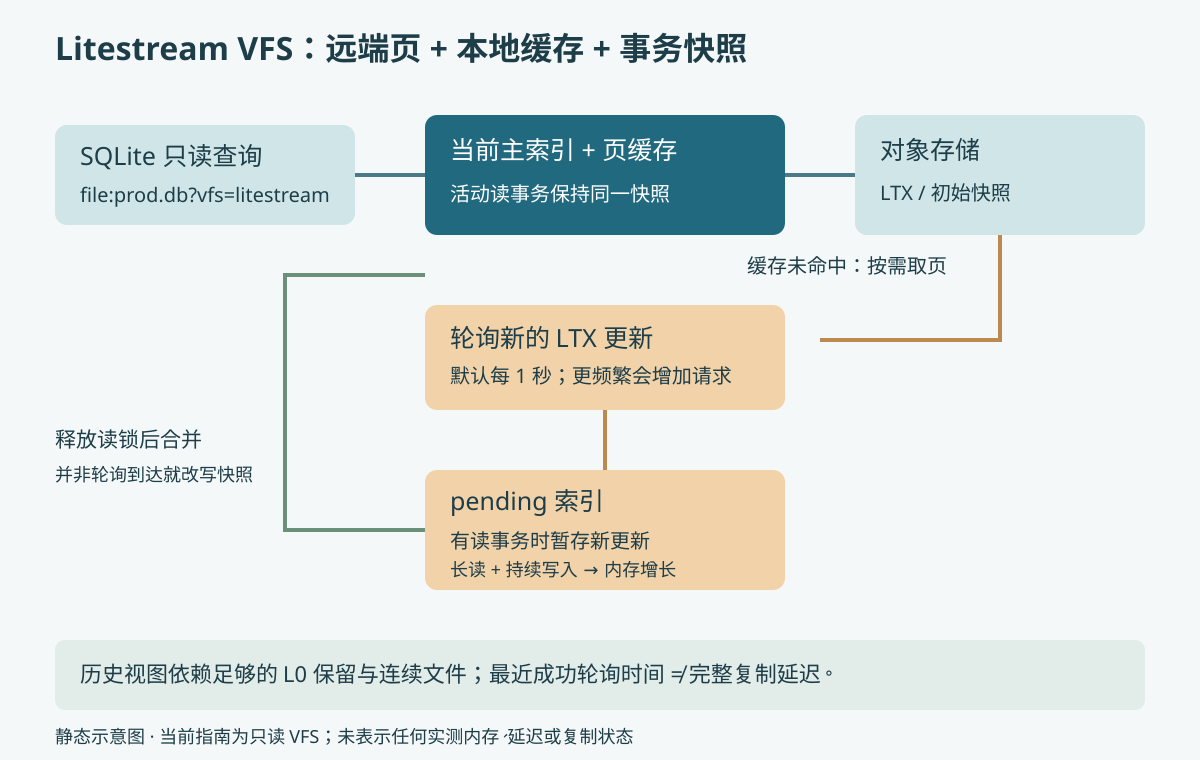
Litestream 的虚拟文件系统(VFS)允许 SQLite 直接读取对象存储中的数据库副本,无须先把整个数据库恢复到本地磁盘。查询按需取得数据页,在客户端缓存,并通过轮询新的 LTX 文件跟进副本变化。
这项指南讨论的是只读 VFS,需要 CGO。它适合报表、仪表盘、临时查询、备份检查,以及本地磁盘有限的临时计算环境;也可以把读副本放到靠近用户的位置,避免先复制整库。它不适合写入需求,也不应被当作本地低延迟、高并发数据库的直接替代品。官方站点另有 VFS Write Mode 页面,那是不同的模式。
准备兼容的副本和客户端
原文列出的前提包括 Go 1.25 或更高版本、启用 CGO 并安装编译工具链;一个已由 Litestream 持续同步的副本;以及支持可加载扩展的 SQLite 客户端,或者以 CGO 构建的 Go 应用。支持的数据页大小为 512–65,536 字节,由 LTX 头自动识别。
可使用官方 GitHub Releases 提供的预构建文件,也可从源码用 -tags vfs 构建。扩展是进程中执行的本机代码,文件应来自可信的官方版本或可审查的构建过程;仅凭文件名带有 Litestream 不能证明它可信。
构建 SQLite 可加载扩展
在 Litestream 仓库根目录,原文优先推荐 Makefile 入口,由它处理各平台所需的选项:
make vfsLinux 下的手动构建过程如下:
CGO_ENABLED=1 go build -tags "vfs,SQLITE3VFS_LOADABLE_EXT" -buildmode=c-archive -o dist/litestream-vfs.a ./cmd/litestream-vfs
cp dist/litestream-vfs.h src/litestream-vfs.h
gcc -DSQLITE3VFS_LOADABLE_EXT -fPIC -shared -o dist/litestream-vfs.so src/litestream-vfs.c dist/litestream-vfs.a -lpthread -ldl -lm
macOS 还需要 Makefile 中列出的附加 framework,所以更应优先使用 make vfs。如果环境要求,macOS 使用 .dylib,Windows 使用 .dll。把共享库放在应用可控制的位置;加载后,它会注册名为 litestream 的 VFS。
扩展支持 S3、GCS、Azure、SFTP、file、NATS、WebDAV 和 Alibaba OSS 等副本后端。SQLite 的扩展入口符号是 sqlite3_litestreamvfs_init;客户端需要显式入口时,应传入这个名字。
指定副本地址与凭证来源
LITESTREAM_REPLICA_URL 是必需变量。缺少它,扩展不能初始化。URL 的 scheme 决定后端,下面各行是互斥的配置示例,选择符合自己后端的一行:
# AWS S3
export LITESTREAM_REPLICA_URL="s3://mybucket/db"

# S3 兼容服务,例如 MinIO、R2、Tigris
export LITESTREAM_REPLICA_URL="s3://mybucket/db?endpoint=minio.example.com"

# Google Cloud Storage
export LITESTREAM_REPLICA_URL="gs://mybucket/db"

# Azure Blob Storage
export LITESTREAM_REPLICA_URL="abs://mycontainer/db"

# SFTP
export LITESTREAM_REPLICA_URL="sftp://user@host/path/db"

# 本地文件系统
export LITESTREAM_REPLICA_URL="file:///backups/db"
各云供应商 SDK 使用各自的标准凭证来源,例如 AWS_ACCESS_KEY_ID、GOOGLE_APPLICATION_CREDENTIALS、AZURE_STORAGE_ACCOUNT。原文 AWS 示例还设置 AWS_SECRET_ACCESS_KEY。本文保留变量名称,但不把真实凭证写进示例或命令历史;应由受控运行环境按最小读取权限提供。
| 变量 | 作用 |
|---|---|
LITESTREAM_LOG_LEVEL |
DEBUG 或默认的 INFO。 |
LITESTREAM_LOG_FILE |
把日志追加到指定文件,而不是标准输出。 |
LITESTREAM_S3_ENDPOINT |
S3 兼容服务的自定义端点,可代替副本 URL 的 endpoint 参数。 |
编者说明:副本 URL、云账号、日志文件和端点都属于部署配置,不要从任意外部输入直接拼接。日志应避免暴露凭证或敏感查询数据。
先用 SQLite CLI 建立最小读取链路
在环境中已提供云凭证之后,设置副本 URL,加载扩展,再用 URI 文件名选择 VFS:
export LITESTREAM_REPLICA_URL="s3://my-backups/prod.db"
sqlite3

# 以下为 SQLite CLI 内输入:
.load ./dist/litestream-vfs sqlite3_litestreamvfs_init
.open 'file:prod.db?vfs=litestream'
SELECT count(*) FROM users;编者修订:原文最后一条是 SELECT count(*) FROM users LIMIT 10;。这里去掉了容易误导的 LIMIT 10:聚合通常只返回一个计数结果,给结果加 LIMIT 并不会让底层只统计十行。统计整表仍可能读取大量页;如果只是检查少量内容,可在明确字段和权限后执行真正返回少量记录的查询。
macOS 系统自带的 SQLite 通常禁用了扩展加载,原文建议安装 Homebrew 的 SQLite(brew install sqlite3)并使用对应版本。选择 Python 客户端也不是自动解决此问题:Python 链接的 SQLite 库同样必须支持可加载扩展。
在 Python 的 sqlite3 中使用 VFS
先设置 LITESTREAM_REPLICA_URL 及该后端所需凭证,再运行脚本。下面保留原文的“两阶段连接”:先通过内存连接注册 VFS,再通过 URI 打开远端副本。
import sqlite3

# 先加载扩展,注册全局名为 "litestream" 的 VFS。
loader = sqlite3.connect(":memory:")
loader.enable_load_extension(True)
loader.load_extension(
    "./dist/litestream-vfs.so",
    entrypoint="sqlite3_litestreamvfs_init",
)
loader.close()

# 再通过已注册的 VFS 连接。
conn = sqlite3.connect(
    "file:prod.db?vfs=litestream",
    uri=True,
    check_same_thread=False,
)

try:
    for row in conn.execute("SELECT name, country FROM customers LIMIT 5"):
        print(row)
finally:
conn.close()兼容性补充:Python 官方 sqlite3 文档明确,load_extension 的 entrypoint 参数从 Python 3.12 才加入。扩展加载能力还取决于 Python 和底层 SQLite 的编译选项,不能只看 Python 版本号。
uri=True 让 vfs=litestream 被当作 URI 参数处理。原例的 check_same_thread=False 解除 Python 的同线程使用检查,却不会自动为共享连接建立安全的并发策略;只在单线程运行时可保留默认检查。上例保留这个参数以对应原文,另增加 finally 关闭查询连接。扩展路径应按平台调整,不要加载不可信共享库。
某些 Node.js SQLite 库,例如原文提及的 better-sqlite3,不支持选择 VFS 所需的 URI 文件名模式。程序访问可选择兼容的 Go 或 Python 路径,临时查询则可以使用 SQLite CLI;仍应对实际客户端版本逐项确认。
直接从 Go 应用使用 VFS
Go 应用可直接创建 ReplicaClient、注册 VFS,再让 github.com/mattn/go-sqlite3 通过该 VFS 打开数据库。构建需启用 CGO,并包含 -tags vfs。原例用 S3,轮询间隔 500 毫秒、缓存 32 MiB:
package main

import (
    "context"
    "database/sql"
    "log/slog"
    "os"
    "time"

    _ "github.com/mattn/go-sqlite3"
    "github.com/psanford/sqlite3vfs"

    "github.com/benbjohnson/litestream"
    "github.com/benbjohnson/litestream/s3"
)

func main() {
    client := s3.NewReplicaClient()
    client.AccessKeyID = os.Getenv("AWS_ACCESS_KEY_ID")
    client.SecretAccessKey = os.Getenv("AWS_SECRET_ACCESS_KEY")
    client.Region = "us-east-1"
    client.Bucket = "my-backups"
    client.Path = "prod.db"
    if err := client.Init(context.Background()); err != nil {
        panic(err)
    }

    logger := slog.New(slog.NewTextHandler(os.Stdout, nil))
    vfs := litestream.NewVFS(client, logger)
    vfs.PollInterval = 500 * time.Millisecond
    vfs.CacheSize = 32 * 1024 * 1024
    if err := sqlite3vfs.RegisterVFS("litestream", vfs); err != nil {
        panic(err)
    }

    db, err := sql.Open("sqlite3", "file:prod.db?vfs=litestream")
    if err != nil {
        panic(err)
    }
    defer db.Close()

    var count int
    if err := db.QueryRow("SELECT COUNT(*) FROM users").Scan(&count); err != nil {
        panic(err)
    }
}编者改动:原例把 Scan 的错误赋给 _,可能隐藏首次远端读取失败。上面改为明确检查错误;初始化、客户端路径、注册方式和参数都沿用原例。这里没有额外声称查询成功或打印真实计数。
应用只要包含所需凭证并用相应构建标签,也可以把 S3 客户端换成其他 ReplicaClient,例如 GCS、Azure、SFTP 或 file。示例仍需按实际区域、桶和副本路径配置。
观察事务位置和轮询状态
VFS 扩展提供 SQL PRAGMA 和函数,帮助检查当前视图。原文示例返回值如下,均不代表本次实测:
-- 当前事务 ID,16 位十六进制字符串。
PRAGMA litestream_txid;
-- 原文示例:0000000000000042

-- 距离最近一次成功轮询的秒数。
PRAGMA litestream_lag;
-- 原文示例:2

-- 当前视图时间,RFC3339Nano 格式。
PRAGMA litestream_time;
-- 原文示例:2024-01-15T10:30:00.123456789Z编者说明:litestream_lag 在这里表示距离最近一次成功 poll 的时间,不是从主库最新提交到当前查询视图的完整端到端复制延迟。轮询成功,也不能单独证明主库刚写入的数据已经上传、可用并进入当前读事务的视图。
按保留窗口查询历史视图
设置 litestream_time 可以把视图移到某个时间点,后续查询读取该时间对应的数据。既可以使用明确时间戳,也可以使用相对表达式:
PRAGMA litestream_time = '2024-01-15T10:30:00Z';

PRAGMA litestream_time = '5 minutes ago';
PRAGMA litestream_time = 'yesterday';
PRAGMA litestream_time = '2 hours ago';

-- 返回最新可见数据。
PRAGMA litestream_time = 'latest';
同样的能力也有函数形式:
SELECT litestream_txid();
SELECT litestream_lag();
SELECT litestream_time();
SELECT litestream_set_time('5 minutes ago');
历史查询依赖主端的 l0-retention 配置,使所需历史 LTX 文件仍然存在。只有时间表达式被接受,并不能凭空找回已清除的历史文件。副本需要连续的 LTX 数据;过于激进的 L0 保留策略造成缺口时,可能一直报错,直到新的压实结果可用。latest 是回到最新可用视图,不是零延迟读取主库的承诺。
性能参数是起点,要同时考虑请求成本
原文给出了以下配置建议:
| 项目 | 原文默认值或建议范围 | 权衡 |
|---|---|---|
缓存 CacheSize |
默认 10MB;数据库小于100MB可从5–10MB起;100MB–1GB可从10–50MB起;大于1GB可从50–100MB或更高起。 | 让常读页靠近应用;更大缓存也需要更多客户端内存。 |
轮询 PollInterval |
默认1秒;追求更新可见性可考虑100–500毫秒;希望减少API调用可考虑5–10秒。 | 更频繁轮询增加API请求;更长间隔延后新写入的可见时间。 |
| 部署位置 | 客户端与副本尽量同区域。 | 减少跨区域网络往返。 |
| 查询形态 | 优先有索引的点查、查找与重复读取。 | 大范围表扫描带来额外存储I/O与网络请求。 |
以上数字是原文的起步建议,不是延迟、费用或内存上限保证。首次读取尚未缓存的数据页,要等待对象存储和网络;更高并发会把对象存储请求量进一步放大。只读写入尝试则会失败,错误为 attempt to write a readonly database。
长读事务为什么使内存增加
为了提供快照隔离,活动读事务存在时,新到达的 LTX 更新先进入 pending 索引,暂时不合并到当前主索引。这样查询可保持一致的快照,但在主库持续写入时,长事务会让 pending 索引增长。
| 场景 | 原文建议的事务时长 | 关注点 |
|---|---|---|
| 点查、有索引的查找 | 原文称通常无实际限制。 | 典型点查开销低;不能推广为任意长事务都无资源成本。 |
| 仪表盘、报表查询 | 小于30秒。 | pending 索引可能适度增长。 |
| 持续写入时的分析 | 小于60秒。 | 观察客户端内存。 |
| 写入期间批量导出 | 考虑拆成多个批次。 | 使用更短的事务。 |
原文把低于 30 秒的事务视为常见仪表盘、报表和临时查询场景下通常可接受的范围,并强调该 VFS 面向中等查询负载。实际资源使用仍由写入速度、涉及页数和并发事务共同决定。
目前没有直接展示 pending 索引大小的 PRAGMA。可以留意长查询期间进程内存上升,以及大 pending map 合并进主索引时解锁变慢。出现这些现象,可缩短事务、拆分查询,把长查询安排到低写入时段,或为重型分析使用本地恢复副本。
| 现象 | SQLite 主库 | Litestream VFS |
|---|---|---|
| 长读事务推迟的工作 | WAL checkpoint。 | pending 索引合并。 |
| 积累的资源 | WAL 文件增长。 | pending 索引增长。 |
| 清理触发点 | 事务提交或结束。 | 锁释放。 |
两者都在活动事务中优先保证快照语义,而不是立即清理资源。原文将它解释为有意的设计选择。若工作负载需要在持续写入下运行数分钟分析、在所有情况下都保持极小内存,或需要低延迟高并发读取,应考虑用 litestream restore 恢复到本地,再用完整的本地 SQLite 读取能力,避免 VFS 网络与 pending 索引开销。
排查问题时,区分数据、网络与快照
- “page not found”或不连续错误:检查主端
l0-retention是否足够,以及副本数据是否有缺口。 - 查询慢:原文建议检查轮询间隔、缓存和客户端位置。编者补充:缩短轮询主要影响发现新更新的速度,不能保证全表扫描或冷页读取变快;应先识别实际瓶颈。
- S3兼容端点或TLS问题:检查副本 URL 的
endpoint或LITESTREAM_S3_ENDPOINT。原文提到自签证书测试可加skip-verify=true;它会跳过证书验证,本文不把它作为生产修复方案。应配置正确的证书信任和端点。 - 看不到数据:VFS 会等待初始快照,确认复制进程正在运行、副本路径正确。
常见用途包括不额外管理整库磁盘的 BI/报表读副本、靠近用户的地理分发只读端点、无需完整恢复的备份检查与灾难恢复演练,以及主库继续写入时的历史数据观察。不过,能够查询一部分副本并不能自动证明备份完整或灾难恢复流程已通过演练。
本稿保留了构建、配置、CLI、Python、Go、可观测性、历史查询、调优、限制、事务内存、替代方案和排错各节。未执行共享库加载、云存储请求、SQL、恢复或故障演练;代码静态审核不构成真实环境兼容或性能保证。
来源与作者归属:Litestream 官方指南、Litestream 文档贡献者。本文的 Python 版本补充、计数 LIMIT 修订、Go 错误处理和原创示意图均为明确标注的编者增补。











暂无评论内容