


原作:Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund,《R for Data Science》第二版第 3 章 Data transformation。本文按 2026 年 10 月 5 日读取的在线章节完整译写,保留主要例子、练习、代码与输出;章节未注明首次发表日期。所有 #> 输出都是原文展示结果,本次只做静态审查,未安装 R 包、下载数据或执行示例。
先认识数据与工具
可视化能帮助我们产生洞见,但拿到的数据很少恰好就是绘图所需的形状。为回答问题,往往要先增加变量、汇总观测,或仅仅调整变量名和记录顺序,让数据更容易处理。本章用 dplyr 和 2013 年从纽约出发的航班记录,介绍数据框变换的核心工具。
我们先处理行,再处理列,然后把这些操作通过管道连接起来,最后学习分组,并用一个案例说明聚合结果与样本量的关系。后续章节还会按数字、字符串、日期等具体变量类型深入讨论。本章需要 nycflights13 和 tidyverse;后者包含 dplyr 和用于理解结果的 ggplot2。
library(nycflights13)
library(tidyverse)
#> ── Attaching core tidyverse packages ───────────────────── tidyverse 2.0.0 ──
#> ✔ dplyr     1.2.1     ✔ readr     2.2.0
#> ✔ forcats   1.0.1     ✔ stringr   1.6.0
#> ✔ ggplot2   4.0.3     ✔ tibble    3.3.1
#> ✔ lubridate 1.9.5     ✔ tidyr     1.3.2
#> ✔ purrr     1.2.2
#> ── Conflicts ─────────────────────────────────────── tidyverse_conflicts() ──
#> ✖ dplyr::filter() masks stats::filter()
#> ✖ dplyr::lag()    masks stats::lag()
#> ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
加载 tidyverse 时,不要忽略函数名冲突信息:dplyr::filter() 和 dplyr::lag() 会遮蔽 stats 包中的同名函数。加载后若需要 stats 版本,就写出 stats::filter() 或 stats::lag()。明确函数来自哪个包,也有助于查帮助和寻找相关工具;完整写法是 packagename::functionname()。
nycflights13::flights 包含 2013 年从纽约市出发的 336,776 个航班,数据来自美国交通统计局,说明见 ?flights。
flights
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
这里的 flights 是 tibble,一种 tidyverse 使用的特殊数据框。它通过一些设计避开常见问题;最容易注意到的是打印方式:面对大数据集,只显示前几行以及屏幕宽度容得下的列。在 RStudio 中,View(flights) 可以打开可滚动和筛选的交互视图;也可用 print(flights, width = Inf) 显示所有列,或用 glimpse() 查看每列概况。
glimpse(flights)
#> Rows: 336,776
#> Columns: 19
#> $ year           <int> 2013, 2013, 2013, 2013, 2013, 2013, 2013, 2013, 2013…
#> $ month          <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
#> $ day            <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
#> $ dep_time       <int> 517, 533, 542, 544, 554, 554, 555, 557, 557, 558, 55…
#> $ sched_dep_time <int> 515, 529, 540, 545, 600, 558, 600, 600, 600, 600, 60…
#> $ dep_delay      <dbl> 2, 4, 2, -1, -6, -4, -5, -3, -3, -2, -2, -2, -2, -2,…
#> $ arr_time       <int> 830, 850, 923, 1004, 812, 740, 913, 709, 838, 753, 8…
#> $ sched_arr_time <int> 819, 830, 850, 1022, 837, 728, 854, 723, 846, 745, 8…
#> $ arr_delay      <dbl> 11, 20, 33, -18, -25, 12, 19, -14, -8, 8, -2, -3, 7,…
#> $ carrier        <chr> "UA", "UA", "AA", "B6", "DL", "UA", "B6", "EV", "B6"…
#> $ flight         <int> 1545, 1714, 1141, 725, 461, 1696, 507, 5708, 79, 301…
#> $ tailnum        <chr> "N14228", "N24211", "N619AA", "N804JB", "N668DN", "N…
#> $ origin         <chr> "EWR", "LGA", "JFK", "JFK", "LGA", "EWR", "EWR", "LG…
#> $ dest           <chr> "IAH", "IAH", "MIA", "BQN", "ATL", "ORD", "FLL", "IA…
#> $ air_time       <dbl> 227, 227, 160, 183, 116, 150, 158, 53, 140, 138, 149…
#> $ distance       <dbl> 1400, 1416, 1089, 1576, 762, 719, 1065, 229, 944, 73…
#> $ hour           <dbl> 5, 5, 5, 5, 6, 5, 6, 6, 6, 6, 6, 6, 6, 6, 6, 5, 6, 6…
#> $ minute         <dbl> 15, 29, 40, 45, 0, 58, 0, 0, 0, 0, 0, 0, 0, 0, 0, 59…
#> $ time_hour <dttm> 2013-01-01 05:00:00, 2013-01-01 05:00:00, 2013-01-0…类型缩写告诉我们每列能做什么:<int> 是整数,<dbl> 是双精度数值,<chr> 是字符串,<dttm> 是日期时间。
dplyr 的主要动词有共同结构:第一个参数是数据框;后续参数通常用不加引号的列名描述操作;输出是一个新的数据框。每个动词专注一件事,复杂任务则靠组合。
管道 |> 把左侧结果传给右侧函数,可以读成“然后”。x |> f(y) 相当于 f(x, y),x |> f(y) |> g(z) 相当于 g(f(x, y), z)。即使尚未逐个学完函数,也能大致读懂:
flights |>
  filter(dest == "IAH") |>
  group_by(year, month, day) |>
  summarize(
    arr_delay = mean(arr_delay, na.rm = TRUE)
  )
从航班表出发,筛选飞往 IAH 的航班,然后按日期分组,再计算每一天的平均到达延误。dplyr 的动词可按行、列、组和表分类;本章介绍前三类,跨表连接留待全书第 19 章。
处理行:筛选、排序、去重
filter() 改变保留哪些行而不改变它们的相对顺序;arrange() 改变顺序而不删行。这两者不改变列。distinct() 寻找唯一的行或列值组合,也可以只返回所选列。
用 filter() 表达条件
filter() 的第二个及后续参数是保留行时必须满足的条件。下面找出起飞晚了超过 120 分钟,也就是两个小时的航班:
flights |>
  filter(dep_delay > 120)
#> # A tibble: 9,723 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      848           1835       853     1001           1950
#> 2  2013     1     1      957            733       144     1056            853
#> 3  2013     1     1     1114            900       134     1447           1222
#> 4  2013     1     1     1540           1338       122     2020           1825
#> 5  2013     1     1     1815           1325       290     2120           1542
#> 6  2013     1     1     1842           1422       260     1958           1535
#> # ℹ 9,717 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
除 > 之外,还可以使用 >=、<、<=、== 和 !=。多个条件通过 & 或逗号表达“同时满足”,通过 | 表达“至少满足一个”。
# Flights that departed on January 1
flights |>
  filter(month == 1 & day == 1)
#> # A tibble: 842 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 836 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …

# Flights that departed in January or February
flights |>
  filter(month == 1 | month == 2)
#> # A tibble: 51,955 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 51,949 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
第一个查询保留 1 月 1 日起飞的航班;第二个保留 1 月或 2 月的航班。若是把多个相等条件用“或”连接,可改用 %in%,检查值是否属于右侧集合:
# A shorter way to select flights that departed in January or February
flights |>
  filter(month %in% c(1, 2))
#> # A tibble: 51,955 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 51,949 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
这些比较和逻辑运算会在全书第 12 章详细展开。现在还要记住:dplyr 函数不会直接修改输入对象。筛选结果默认只是被打印;想保留,必须赋值。
jan1 <- flights |>
  filter(month == 1 & day == 1)
两个常见错误
测试相等要用 ==,不能写成 =。后者会被当作命名参数,filter() 会提示可能写错:
flights |>
  filter(month = 1)
#> Error in `filter()`:
#> ! We detected a named input.
#> ℹ This usually means that you've used `=` instead of `==`.
#> ℹ Did you mean `month == 1`?
另一个错误是把自然语言里的“一月或二月”写成:
flights |>
filter(month == 1 | 2)它可能不报错,却不表达预期含义:| 的两边分别是 month == 1 与数字 2,右侧不是一次月份比较。应重复完整条件,或使用上面的 %in%。
用 arrange() 调整行顺序
给 arrange() 一个数据框和若干列名或表达式,就能按这些值排序。多个列依次用于打破前一列的并列。下面先按年,再按月、日和起飞时间排序:
flights |>
  arrange(year, month, day, dep_time)
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
把列放进 desc(),即可按从大到小的顺序排列,例如找到起飞延误最多的航班:
flights |>
  arrange(desc(dep_delay))
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     9      641            900      1301     1242           1530
#> 2  2013     6    15     1432           1935      1137     1607           2120
#> 3  2013     1    10     1121           1635      1126     1239           1810
#> 4  2013     9    20     1139           1845      1014     1457           2210
#> 5  2013     7    22      845           1600      1005     1044           1815
#> 6  2013     4    10     1100           1900       960     1342           2211
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
行数仍是 336,776;这里只排序,没有筛选。
用 distinct() 查唯一组合
不指定列时,distinct() 去除整行重复。通常更常见的需求是某几个变量的唯一组合,例如出发地与目的地:
# Remove duplicate rows, if any
flights |>
  distinct()
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …

# Find all unique origin and destination pairs
flights |>
  distinct(origin, dest)
#> # A tibble: 224 × 2
#>   origin dest
#>   <chr>  <chr>
#> 1 EWR    IAH
#> 2 LGA    IAH
#> 3 JFK    MIA
#> 4 JFK    BQN
#> 5 LGA    ATL
#> 6 EWR    ORD
#> # ℹ 218 more rows
若还想保留其他列,加入 .keep_all = TRUE:
flights |>
  distinct(origin, dest, .keep_all = TRUE)
#> # A tibble: 224 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 218 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
原文结果中这些前几条记录都来自 1 月 1 日并非巧合:distinct() 保留每个唯一组合首次出现的行,丢弃后续重复组合。
若想知道每种组合出现多少次,应改用 count()。设置 sort = TRUE 会按次数降序排列:
flights |>
  count(origin, dest, sort = TRUE)
#> # A tibble: 224 × 3
#>   origin dest      n
#>   <chr>  <chr> <int>
#> 1 JFK    LAX   11262
#> 2 LGA    ATL   10263
#> 3 LGA    ORD    8857
#> 4 JFK    SFO    8204
#> 5 LGA    CLT    6168
#> 6 EWR    ORD    6100
#> # ℹ 218 more rows
行操作练习
- 每项各用一条管道找出:到达晚点至少两小时;飞往 Houston(IAH 或 HOU);由 United、American 或 Delta 执飞;在夏季(本题指定 7、8、9 月)起飞;到达晚点超过两小时但起飞不晚;起飞延误至少一小时、途中追回超过 30 分钟的航班。
- 按起飞延误排序,找出延误最久的航班;再找出一天中最早起飞的航班。
- 找出速度最快的航班。提示:排序表达式里可以包含数学计算。
- 2013 年的每一天都有航班吗?
- 哪些航班距离最远,哪些最近?
- 同时使用
filter()和arrange()时,前后次序是否重要?分别从结果和计算工作量思考。
处理列:创建、选择、重命名与移动
下面四种动词改变列而不改变行:mutate() 用已有列派生新列,select() 选择列,rename() 修改列名,relocate() 调整列的位置。
用 mutate() 计算新变量
后续章节会介绍按数据类型变换变量的更多函数。这里先用基本代数计算 gain(起飞延误减到达延误,即途中追回的分钟数)和 speed(英里每小时):
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    speed = distance / air_time * 60
  )
#> # A tibble: 336,776 × 21
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 13 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
默认新列加在数据最右侧,打印时可能看不见。用 .before = 1 把它们放到最前面:
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    speed = distance / air_time * 60,
    .before = 1
  )
#> # A tibble: 336,776 × 21
#>    gain speed  year month   day dep_time sched_dep_time dep_delay arr_time
#>   <dbl> <dbl> <int> <int> <int>    <int>          <int>     <dbl>    <int>
#> 1    -9  370.  2013     1     1      517            515         2      830
#> 2   -16  374.  2013     1     1      533            529         4      850
#> 3   -31  408.  2013     1     1      542            540         2      923
#> 4    17  517.  2013     1     1      544            545        -1     1004
#> 5    19  394.  2013     1     1      554            600        -6      812
#> 6   -16  288.  2013     1     1      554            558        -4      740
#> # ℹ 336,770 more rows
#> # ℹ 12 more variables: sched_arr_time <int>, arr_delay <dbl>, …
.before 开头的点提醒我们,这是函数参数,不是第三个新变量的名字。.before 和 .after 都可以使用列名而非位置,比如放在 day 后面:
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    speed = distance / air_time * 60,
    .after = day
  )
还可以用 .keep 决定保留哪些变量。"used" 只保留参与这次计算或在其中新建的列。下一例会留下 dep_delay、arr_delay、air_time、gain、hours 和 gain_per_hour。
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    hours = air_time / 60,
    gain_per_hour = gain / hours,
    .keep = "used"
  )
新变量可以在同一次 mutate() 中继续使用。由于这里仍未赋值回 flights,结果只是打印。需要保存时,应认真决定是覆盖原对象,还是使用诸如 delay_gain 这样能说明内容的新名字;通常后者更清楚,但也可能有覆盖原表的合理理由。
用 select() 缩小关注范围
面对几百乃至几千列的数据,先选出需要的变量很有用。以下依次按名字选择列、选择从 year 到 day 的连续区间(含两端)、选择该区间之外的列、选择所有字符串列:
flights |>
  select(year, month, day)
flights |>
select(year:day)flights |>
select(!year:day)flights |>
select(where(is.character))旧代码经常用负号 - 排除列,而不是 !。两者目的相似,但某些细节行为不同。原作者推荐 !,因为它读作“非”,也更容易和 &、| 组合。
选择辅助函数还能根据列名匹配:
starts_with("abc"):名字以 abc 开头。ends_with("xyz"):名字以 xyz 结尾。contains("ijk"):名字包含 ijk。num_range("x", 1:3):匹配 x1、x2、x3。
更多规则见 ?select;学过正则表达式后,还可用 matches() 选择符合模式的列。选择时也可以重命名:等号左边是新名字,右边是旧名字。
flights |>
  select(tail_num = tailnum)
#> # A tibble: 336,776 × 1
#>   tail_num
#>   <chr>
#> 1 N14228
#> 2 N24211
#> 3 N619AA
#> 4 N804JB
#> 5 N668DN
#> 6 N39463
#> # ℹ 336,770 more rows
用 rename() 保留其他列
如果只改少量列名,并希望其他列原样保留,应使用 rename():
flights |>
  rename(tail_num = tailnum)
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
若很多列的命名都不一致,逐一修改很费劲,可以了解 janitor::clean_names() 提供的自动整理功能。
用 relocate() 调整位置
可以把相关变量摆在一起,或把重要变量移到前面。relocate() 默认移到最前:
flights |>
  relocate(time_hour, air_time)
#> # A tibble: 336,776 × 19
#>   time_hour           air_time  year month   day dep_time sched_dep_time
#>   <dttm>                 <dbl> <int> <int> <int>    <int>          <int>
#> 1 2013-01-01 05:00:00      227  2013     1     1      517            515
#> 2 2013-01-01 05:00:00      227  2013     1     1      533            529
#> 3 2013-01-01 05:00:00      160  2013     1     1      542            540
#> 4 2013-01-01 05:00:00      183  2013     1     1      544            545
#> 5 2013-01-01 06:00:00      116  2013     1     1      554            600
#> 6 2013-01-01 05:00:00      150  2013     1     1      554            558
#> # ℹ 336,770 more rows
#> # ℹ 12 more variables: dep_delay <dbl>, arr_time <int>, …
也可以像 mutate() 一样,用 .before 或 .after 指定位置:
flights |>
  relocate(year:dep_time, .after = time_hour)
flights |>
  relocate(starts_with("arr"), .before = dep_time)
列操作练习
- 比较
dep_time、sched_dep_time和dep_delay;你预期它们之间是什么关系? - 尽可能多地想出选择
dep_time、dep_delay、arr_time、arr_delay的写法。 - 在一次
select()中重复写同一个变量名会怎样? any_of()做什么?为什么可能适合与下面的字符向量一起使用?
variables <- c("year", "month", "day", "dep_delay", "arr_delay")5. 下面的结果是否让你意外?选择辅助函数默认怎样处理大小写,如何改变这个默认值?
flights |> select(contains("TIME"))6. 把 air_time 改名为 air_time_min 来说明单位,并把它移到数据框最前。7. 下面为什么不能运行,错误信息是什么意思?
flights |>
  select(tailnum) |>
  arrange(arr_delay)
#> Error in `arrange()`:
#> ℹ In argument: `..1 = arr_delay`.
#> Caused by error:
#> ! object 'arr_delay' not found
把动词连接成管道
管道的真正作用在于连接多个动词。例如,要找到飞往 Houston IAH 机场速度最快的航班,可以先筛选,再计算速度,选择展示列,最后按速度降序排列:
flights |>
  filter(dest == "IAH") |>
  mutate(speed = distance / air_time * 60) |>
  select(year:day, dep_time, carrier, flight, speed) |>
  arrange(desc(speed))
#> # A tibble: 7,198 × 7
#>    year month   day dep_time carrier flight speed
#>   <int> <int> <int>    <int> <chr>    <int> <dbl>
#> 1  2013     7     9      707 UA         226  522.
#> 2  2013     8    27     1850 UA        1128  521.
#> 3  2013     8    28      902 UA        1711  519.
#> 4  2013     8    28     2122 UA        1022  519.
#> 5  2013     6    11     1628 UA        1178  515.
#> 6  2013     8    27     1017 UA         333  515.
#> # ℹ 7,192 more rows
虽然有四步,但动词都位于每一行的开头,很容易从上到下阅读。如果不用管道,可以写成嵌套调用:
arrange(
  select(
    mutate(
      filter(
        flights,
        dest == "IAH"
      ),
      speed = distance / air_time * 60
    ),
    year:day, dep_time, carrier, flight, speed
  ),
  desc(speed)
)
或者创建一串中间对象:
flights1 <- filter(flights, dest == "IAH")
flights2 <- mutate(flights1, speed = distance / air_time * 60)
flights3 <- select(flights2, year:day, dep_time, carrier, flight, speed)
arrange(flights3, desc(speed))
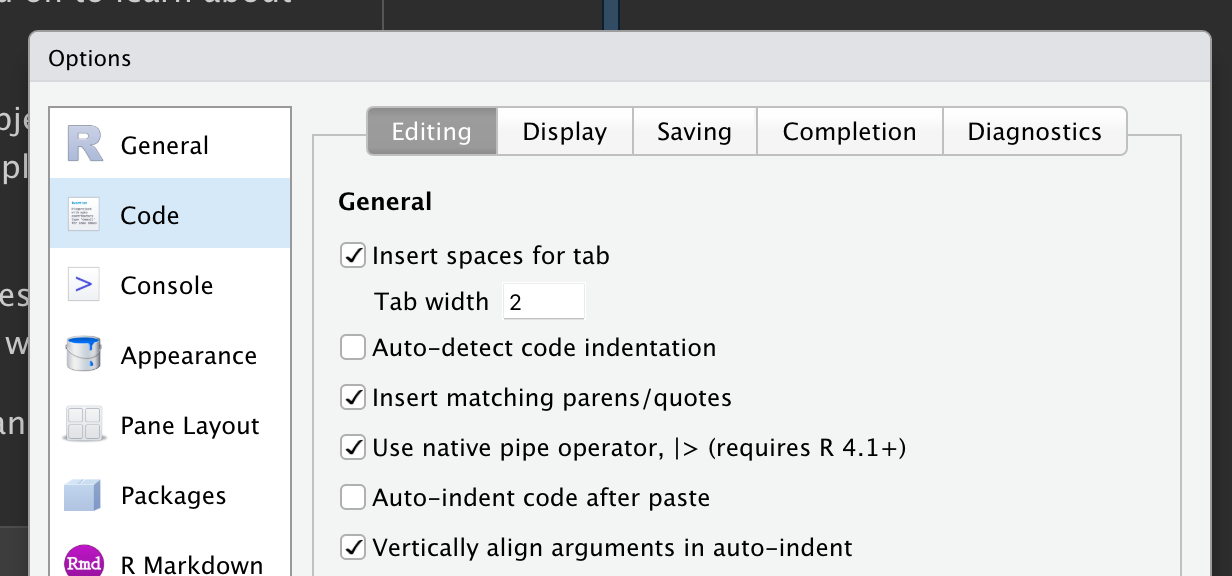
这两种写法各有适用场合,但管道通常让数据分析代码更容易编写和阅读。在 RStudio 中,可以用 Ctrl/Cmd + Shift + M 插入管道。要插入 |> 而不是 %>%,应在 Code → Editing 设置中勾选 “Use native pipe operator”。
如果此前使用过 tidyverse,可能熟悉 magrittr 包提供的 %>%。magrittr 也包含在核心 tidyverse 中,加载后可以直接使用:
library(tidyverse)

mtcars %>%
  group_by(cyl) %>%
  summarize(n = n())
简单情形下两种管道行为一致。作者推荐基础 R 管道,因为它属于 R 自身,不依赖加载 tidyverse,而且设计更简单。从 %>% 于 2014 年出现,到 |> 于 2021 年进入 R 4.1.0,社区对管道积累了更多经验,基础实现因此能够去掉一些不常用、重要性较低的特性。
分组:同一套操作分别应用于不同子集
group_by() 改变后续动词的语义
group_by() 按对分析有意义的变量分组,例如月份:
flights |>
  group_by(month)
#> # A tibble: 336,776 × 19
#> # Groups:   month [12]
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
数据行列本身没有变化,但打印结果多了 Groups: month [12]。这是给数据框增加分组特征,改变后续动词的行为;后续操作将按月份分别进行。
summarize() 汇总时要处理缺失值
计算每组一个汇总统计量时,summarize()(也可拼成英式的 summarise())把每组压缩成一行。先试着计算每月平均起飞延误:
flights |>
  group_by(month) |>
  summarize(
    avg_delay = mean(dep_delay)
  )
#> # A tibble: 12 × 2
#>   month avg_delay
#>   <int>     <dbl>
#> 1     1        NA
#> 2     2        NA
#> 3     3        NA
#> 4     4        NA
#> 5     5        NA
#> 6     6        NA
#> # ℹ 6 more rows
结果全是 NA,R 用它表示缺失值。原因是部分航班的延误数据缺失,均值把这些缺失值也纳入了计算。暂时可通过 na.rm = TRUE 明确告诉 mean() 忽略缺失值;全书第 18 章会进一步讨论缺失数据。
flights |>
  group_by(month) |>
  summarize(
    avg_delay = mean(dep_delay, na.rm = TRUE)
  )
#> # A tibble: 12 × 2
#>   month avg_delay
#>   <int>     <dbl>
#> 1     1      10.0
#> 2     2      10.8
#> 3     3      13.2
#> 4     4      13.9
#> 5     5      13.0
#> 6     6      20.8
#> # ℹ 6 more rows
一次 summarize() 可以计算多个统计量。一个很有用的函数是 n(),它返回每组的行数:
flights |>
  group_by(month) |>
  summarize(
    avg_delay = mean(dep_delay, na.rm = TRUE),
    n = n()
  )
#> # A tibble: 12 × 3
#>   month avg_delay     n
#>   <int>     <dbl> <int>
#> 1     1      10.0 27004
#> 2     2      10.8 24951
#> 3     3      13.2 28834
#> 4     4      13.9 28330
#> 5     5      13.0 28796
#> 6     6      20.8 28243
#> # ℹ 6 more rows均值加计数,已经能支持许多分析。编者补充:这里的 n() 是全组行数,包含延误值缺失的记录;它不等于计算均值时实际使用的非缺失观测数。评估样本支撑时要区分这两者。
slice 系列保留原始记录
以下函数从每一组中取特定的行:
slice_head(n = 1)取第一行。slice_tail(n = 1)取最后一行。slice_min(x, n = 1)取 x 最小的行。slice_max(x, n = 1)取 x 最大的行。slice_sample(n = 1)随机取一行。
可以增加 n 选多行,或使用 prop = 0.1 选每组的 10%。下面找各目的地到达延误最多的航班:
flights |>
  group_by(dest) |>
  slice_max(arr_delay, n = 1) |>
  relocate(dest)
#> # A tibble: 108 × 19
#> # Groups:   dest [105]
#>   dest   year month   day dep_time sched_dep_time dep_delay arr_time
#>   <chr> <int> <int> <int>    <int>          <int>     <dbl>    <int>
#> 1 ABQ    2013     7    22     2145           2007        98      132
#> 2 ACK    2013     7    23     1139            800       219     1250
#> 3 ALB    2013     1    25      123           2000       323      229
#> 4 ANC    2013     8    17     1740           1625        75     2042
#> 5 ATL    2013     7    22     2257            759       898      121
#> 6 AUS    2013     7    10     2056           1505       351     2347
#> # ℹ 102 more rows
#> # ℹ 11 more variables: sched_arr_time <int>, arr_delay <dbl>, …
为什么 105 个目的地却返回 108 行?因为 slice_min() 和 slice_max() 默认保留并列值,n = 1 会保留所有达到最高值的行。若每组必须恰好一行,可以设置 with_ties = FALSE。
这与用 summarize() 求最大延误类似,但它保留整条记录;有并列时保留多条,而不是只得到一个最大值。
多变量分组与汇总后的分组状态
也可以按多列分组,例如为每个日期建立一组:
daily <- flights |>
  group_by(year, month, day)
daily
#> # A tibble: 336,776 × 19
#> # Groups:   year, month, day [365]
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
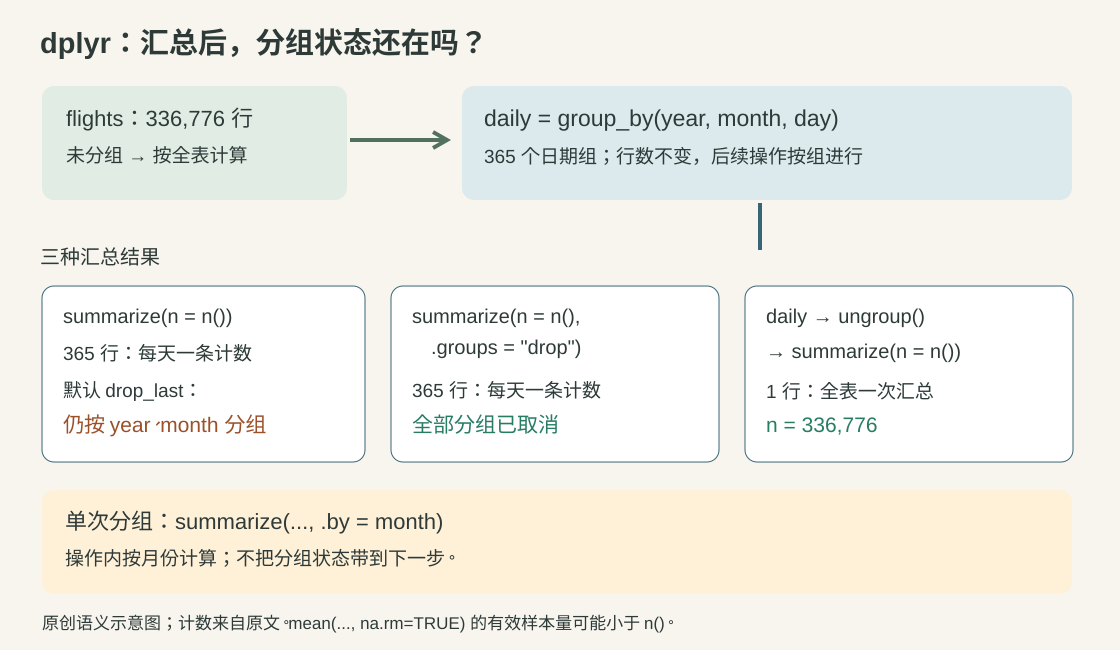
对按多列分组的 tibble 做这种单行汇总时,默认会剥掉最后一层分组。作者承认,回头看这不算理想的设计,但改变它会破坏已有代码,因此 dplyr 会用信息提示结果的分组状态:
daily_flights <- daily |>
  summarize(n = n())
#> `summarise()` has regrouped the output.
#> ℹ Summaries were computed grouped by year, month, and day.
#> ℹ Output is grouped by year and month.
#> ℹ Use `summarise(.groups = "drop_last")` to silence this message.
#> ℹ Use `summarise(.by = c(year, month, day))` for per-operation grouping
#>   (`?dplyr::dplyr_by`) instead.
按年、月、日计算后,结果仍按年、月分组。若正是想要这种行为,可显式写出 .groups = "drop_last",消除提示:
daily_flights <- daily |>
  summarize(
    n = n(),
    .groups = "drop_last"
  )
也可以设为 "drop",去掉全部分组;或者设为 "keep",保留相同的分组。
显式取消分组
不经过汇总,也能用 ungroup() 取消分组:
daily |>
  ungroup()
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
取消分组后再汇总:
daily |>
  ungroup() |>
  summarize(
    avg_delay = mean(dep_delay, na.rm = TRUE),
    flights = n()
  )
#> # A tibble: 1 × 2
#>   avg_delay flights
#>       <dbl>   <int>
#> 1      12.6  336776
结果只有一行,因为 dplyr 把未分组数据框的全部记录当作同一组。原文的全体平均起飞延误为 12.6 分钟,航班数为 336,776。
用 .by 表达单次分组
原书写作时,dplyr 1.1.0 新增了当时标为实验性的按次分组语法 .by。group_by() 和 ungroup() 仍然保留,但也可以只在一个操作内部指定分组:
flights |>
  summarize(
    delay = mean(dep_delay, na.rm = TRUE),
    n = n(),
    .by = month
  )
多个分组变量使用 c():
flights |>
  summarize(
    delay = mean(dep_delay, na.rm = TRUE),
    n = n(),
    .by = c(origin, dest)
  )
对于支持该参数的动词,按次分组的好处是操作结束后不必再用 ungroup() 清理,也不必为消除分组提示而设定 .groups。原书没有以它为主线,是因为写作时这套语法很新;更多背景可看 dplyr 1.1.0 的发布文章。编者将原文宽泛的“所有动词”收窄为“支持该参数的动词”,避免误认为任意函数都接收 .by。
分组练习
- 哪家航空公司的平均延误最严重?能否分开机场和航空公司的影响,为什么?提示:考虑
flights |> group_by(carrier, dest) |> summarize(n())。 - 找出前往每个目的地时,起飞延误最久的航班。
- 延误怎样随一天中的时间变化?用图说明。
- 给
slice_min()等函数传入负数n会怎样? - 用本章已经学过的动词解释
count();其中的sort参数做什么?
6. 对下面的小表,先预测各段代码的输出,再在自己的环境里核对并解释。
df <- tibble(
  x = 1:5,
  y = c("a", "b", "a", "a", "b"),
  z = c("K", "K", "L", "L", "K")
)(a)group_by() 做了什么?
df |>
group_by(y)(b)arrange() 做了什么,与(a)的分组有什么不同?
df |>
  arrange(y)
(c)这条管道如何汇总数据?
df |>
  group_by(y) |>
  summarize(mean_x = mean(x))
(d)这条管道如何汇总,结果信息又说明了什么?
df |>
  group_by(y, z) |>
  summarize(mean_x = mean(x))
(e)与(d)相比,输出的分组状态有什么变化?
df |>
  group_by(y, z) |>
  summarize(mean_x = mean(x), .groups = "drop")
(f)下面两条管道的输出有什么不同?
df |>
  group_by(y, z) |>
  summarize(mean_x = mean(x))

df |>
  group_by(y, z) |>
  mutate(mean_x = mean(x))
案例:平均表现为什么必须搭配样本量
聚合时保留计数,是为了避免从极少数据中得出过强结论。下面换用 Lahman 包的棒球记录,比对球员安打数 H 与打数 AB 的比例。这个扩展示例需要另外准备 Lahman 包。
batters <- Lahman::Batting |>
  group_by(playerID) |>
  summarize(
    performance = sum(H, na.rm = TRUE) / sum(AB, na.rm = TRUE),
    n = sum(AB, na.rm = TRUE)
  )
batters
#> # A tibble: 24,011 × 3
#>   playerID  performance     n
#>   <chr>           <dbl> <int>
#> 1 aardsda01      0          4
#> 2 aaronha01      0.305  12364
#> 3 aaronto01      0.229    944
#> 4 aasedo01       0          5
#> 5 abadan01       0.0952    21
#> 6 abadfe01       0.111      9
#> # ℹ 24,005 more rows
performance 是按球员汇总的安打数除以打数,n 是总打数。把这两个量画在一起,原文指出两个模式:打数少的球员,表现比例的波动更大;当把均值或其他汇总量与组大小放在一张图中时,往往会看到样本量增大、波动收窄的形状。原书脚注用“大数定律”提示这个现象。
原作者还将表现与机会之间的正相关解释为:球队倾向于给表现更好的打者更多机会。这里应把它理解成对数据现象的讨论;该图自身并不能证明个人能力或确立因果关系。
batters |>
  filter(n > 100) |>
  ggplot(aes(x = n, y = performance)) +
  geom_point(alpha = 1 / 10) +
  geom_smooth(se = FALSE)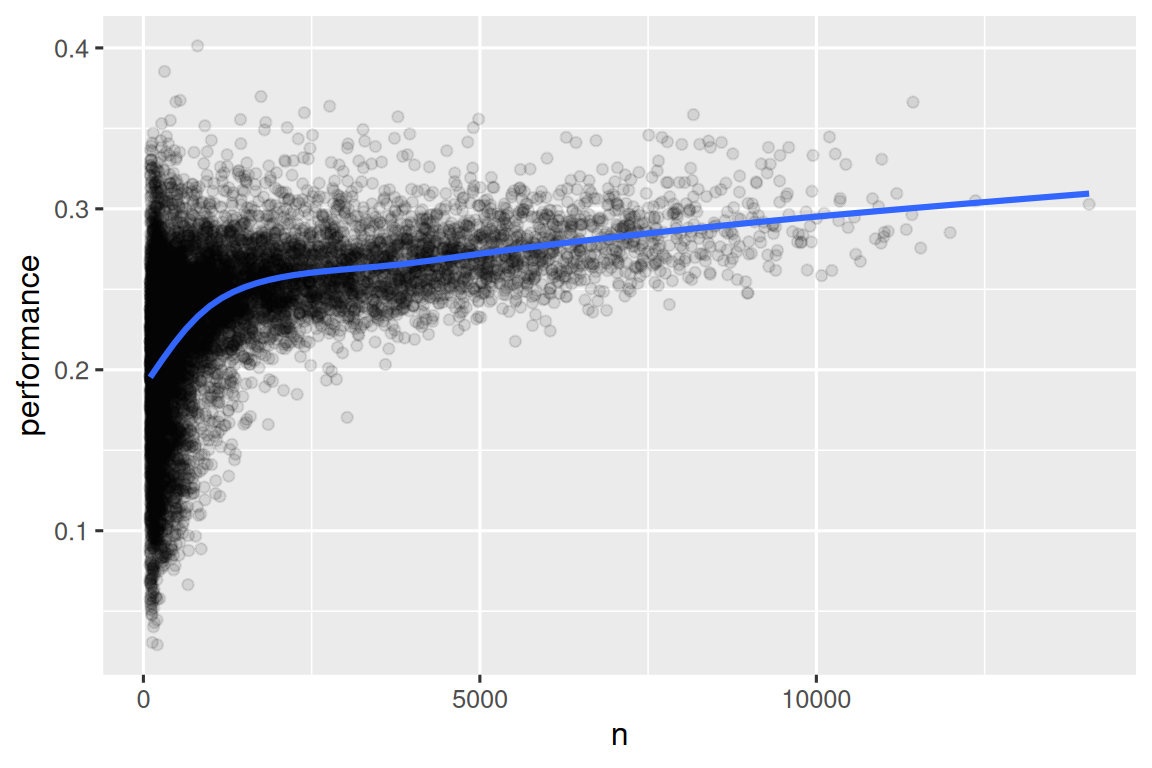
n > 100 后,比较总打数和安打比例。图源:《R for Data Science》第二版,Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund;本次未重新计算。这里还有一个很实用的组合方式:用 |> 处理数据,到 ggplot2 之后改用 + 添加图层。
样本量也会影响排名。如果只按 desc(performance) 排序,最前面的球员可能只尝试过一两次,碰巧全都安打;他们并不因此必然是能力最强的人:
batters |>
  arrange(desc(performance))
#> # A tibble: 24,011 × 3
#>   playerID  performance     n
#>   <chr>           <dbl> <int>
#> 1 abramge01           1     1
#> 2 alberan01           1     1
#> 3 averysk01           1     1
#> 4 banisje01           1     1
#> 5 barbesa01           1     2
#> 6 bartocl01           1     1
#> # ℹ 24,005 more rows
原文推荐进一步阅读 棒球案例中的经验贝叶斯解释和 为什么不应只按平均评分排序。这些是延伸材料,不是本次译写的合并章节,也未据其增加新的方法或结论。
本章之后
本章介绍的工具可以大致分成三类:处理行的 filter()、arrange(),处理列的 select()、mutate(),以及处理组的 group_by()、summarize()。它们关注整个数据框;单个变量能做什么,还会在全书 Transform 部分按变量类型展开。下一章回到工作流程,讨论代码风格与组织方式,让自己和他人更容易阅读代码。
编者静态审查:本章代码在内存中变换包内数据,未发现删除文件、执行外部命令、硬编码真实秘密或网络写入。赋值可能覆盖同名内存对象;随机抽样、绘图和包版本会影响读者的输出。原文刻意保留的错误示例已经说明;均值排除缺失值、样本规模、分组残留及小样本排名应作为解释结果时的检查点。
来源:R for Data Science(第二版):Data transformation;作者和许可见全书首页。原网站声明 CC BY-NC-ND 3.0。不将该公共许可解读为自动允许翻译改编。











暂无评论内容