


原作者:Tom Aarsen;原文于 2026 年 4 月 16 日发表于 Hugging Face Blog。本文为获授权的完整中文翻译整理。下述性能数字均来自原作者实验,不是本次运行结果。
Sentence Transformers 是用于调用和训练嵌入模型、重排模型的 Python 库,常见用途包括检索增强生成(RAG)和语义搜索。前一篇文章介绍了它处理文本、图像、音频和视频的多模态能力;本文进一步说明,如何使用自己的数据训练或微调这些模型。
贯穿全文的任务是视觉文档检索(Visual Document Retrieval,VDR):给定文本查询,找出最相关的文档页面图像,同时保留页面中的图表、表格与版式。作者以 Qwen/Qwen3-VL-Embedding-2B 为基础,训练得到 tomaarsen/Qwen3-VL-Embedding-2B-vdr。在他的评估数据上,NDCG@10 从 0.888 提升到 0.947,超过了纳入比较的其他 VDR 模型,包括规模约为它四倍的模型。
如果还不熟悉多模态推理,建议先读 Sentence Transformers 多模态嵌入与重排模型使用篇;文末另列出纯文本、稀疏嵌入和重排训练指南。
为什么要微调
通用多模态嵌入模型在多种语言和任务上训练,能够做图文匹配、视觉问答、文档理解等工作。但覆盖面广,并不代表在每一种具体任务上都是最优选择。
例如,用户问“公司第三季度的营收是多少”,模型需要从上千页文档截图中找到相关页面。这依赖对布局、图表、表格和文字的共同理解,与把鞋子的商品图匹配到商品描述是不同的能力。领域数据微调能让模型学会这些专门模式。作者的实验正展示了这种收益:在其评估集上,微调后的 2B 级模型领先于测试中的大型通用模型。因此,有适合的领域数据时,微调值得与直接换大模型一同考虑。
训练由哪些部分组成
多模态训练与纯文本训练使用相同的基本结构:待训练模型、训练与评估数据、指导优化的损失函数、可选的训练参数、可选的评估器,以及把这些组件连接起来的 Trainer。仍然使用 SentenceTransformerTrainer,主要变化是数据中包含图像或其他模态,模型的 processor 自动完成相应预处理。
加载模型
常见做法是微调已有多模态嵌入模型,也可以从尚未接受嵌入训练的视觉语言模型(VLM)检查点开始。Transformer 模块会从 processor 识别支持的模态。
对已有嵌入模型,例如仓库已经包含 modules.json 的模型,可分别通过 processor_kwargs 和 model_kwargs 控制预处理与模型加载。前者传给 AutoProcessor.from_pretrained();例如较大的 max_pixels 保留更多图像细节,但需要更多内存。后者传给相应的 AutoModel.from_pretrained(),控制精度和注意力实现:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "Qwen/Qwen3-VL-Embedding-2B",
    model_kwargs={"attn_implementation": "flash_attention_2", "torch_dtype": "bfloat16"},
    processor_kwargs={"min_pixels": 28 * 28, "max_pixels": 600 * 600},
)
也可以直接从原始 VLM 检查点构建模型:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("Qwen/Qwen3-VL-2B")
Sentence Transformers 会尝试识别架构、模态、前向方法和池化方式。如果某个模型没有被完整识别,可以编辑保存后的 sentence_bert_config.json,调整模态配置、前向方法和输出处理。需要时会自动添加 Pooling。以下接口可用于检查支持的模态:
print(model.modalities)
# ['text', 'image', 'video', 'message']

print(model.supports("image"))
# True
另一条路线:用 Router 组合多个编码器
不必总是选择一个大型 VLM。Router 可以按输入模态,将文本和图像分别送到专门的编码器。下面的模型用 MiniLM 编码文本,通过平均池化和 Dense 投影得到 768 维向量;图像端使用 SigLIP,它直接输出池化后的嵌入,因此不额外添加 Pooling。
from sentence_transformers import SentenceTransformer
from sentence_transformers.sentence_transformer.modules import Dense, Pooling, Router, Transformer

# Create separate encoders for different modalities
text_encoder = Transformer("sentence-transformers/all-MiniLM-L6-v2")
text_pooling = Pooling(text_encoder.get_embedding_dimension(), pooling_mode="mean")
text_projection = Dense(text_encoder.get_embedding_dimension(), 768)

# SigLIP outputs pooled embeddings directly, so no separate Pooling module is needed
image_encoder = Transformer("google/siglip2-base-patch16-224")

# Route inputs based on modality
router = Router(
    sub_modules={
        "text": [text_encoder, text_pooling, text_projection],
        "image": [image_encoder],
    },
)

model = SentenceTransformer(modules=[router])
注意:两个独立编码器的嵌入空间起初并未对齐。即使向量维度相同,也不能直接把跨模态相似度当作有意义的检索分数;需要训练来完成空间对齐。Dense 投影层帮助映射到共享空间。该方案适合组合轻量的专用编码器,也能通过 route_mappings 叠加任务路由,例如查询与文档采用不同编码器。进阶用法见 模块文档。
准备数据
视觉文档检索数据集
本例使用 tomaarsen/llamaindex-vdr-en-train-preprocessed,它是 llamaindex/vdr-multilingual-train 的预处理英语子集。源数据随 LlamaIndex 的 Visual Document Retrieval Goes Multilingual 发布,包含约 50 万条多语言查询—图像样本,页面来自公开互联网 PDF,查询由 gemini-1.5-pro 和 Qwen2-VL-72B 等 VLM 合成。
作者筛出 53,512 条英语样本,并将每条样本的 16 个基于 ID 的难负例中的 4 个解析成实际文档截图,使数据可以直接用于训练:
from datasets import load_dataset

train_dataset = load_dataset("tomaarsen/llamaindex-vdr-en-train-preprocessed", "train", split="train")
train_dataset = train_dataset.select_columns(["query", "image", "negative_0"])
eval_dataset = load_dataset("tomaarsen/llamaindex-vdr-en-train-preprocessed", "eval", split="train")
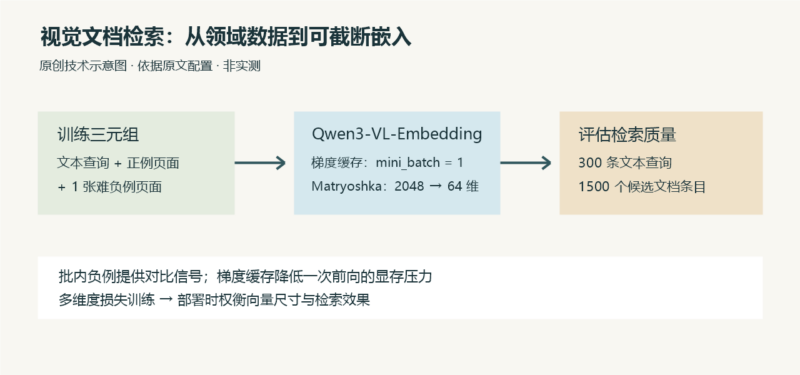
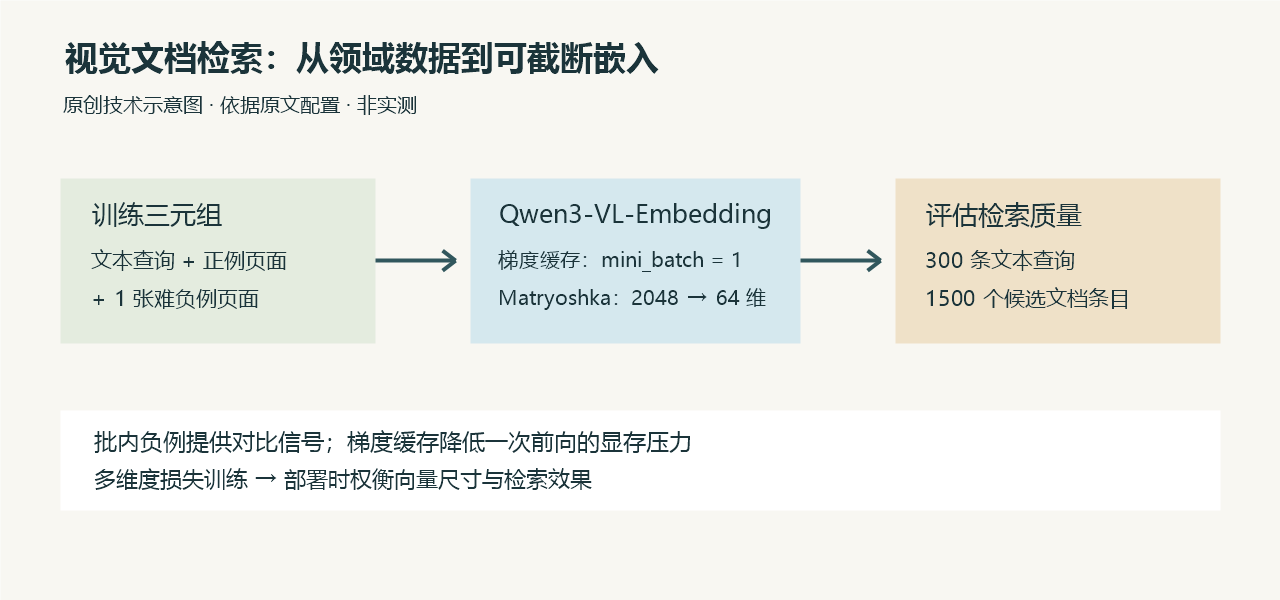
train 配置包含前 10,000 条样本,eval 配置包含接下来的 300 条;另有含全部 53,512 条样本的 full 配置。训练时只保留 query、image、negative_0,形成“锚点、正例、难负例”三元组。增加难负例可能改善训练信号,但每增加一张负例图像也增加内存与时间成本,因此本例只使用一个。评估时则保留全部四个难负例,以构建更具挑战性的候选文档集合。
数据格式规则
数据格式必须与损失函数匹配。如果损失需要标签,数据列必须命名为 label 或 score;其他列都会被视为输入,数量要与损失支持的输入个数一致。除了标签列之外,列名本身通常不重要,输入列的顺序才决定其角色。
多模态输入支持以下表示:
- 文本:字符串。
- 图像:PIL 图像、文件路径、URL,或 NumPy/PyTorch 数组。
- 音频:文件路径、数组、包含
array和sampling_rate的字典;安装 torchcodec 后,也可以使用torchcodec.AudioDecoder。 - 视频:文件路径、数组、包含
array和video_metadata的字典;安装 torchcodec 后,也可使用torchcodec.VideoDecoder。 - 多模态字典:用
text、image、audio或video键映射各模态,例如{"text": ..., "image": ...}。
数据整理器会自动调用 model.preprocess(),识别模态并应用对应预处理,无需手动分词或处理图像。Hugging Face 上不少可直接使用的数据集带有 sentence-transformers 标签。
选择损失函数
CachedMultipleNegativesRankingLoss
本例采用检索任务常用的 CachedMultipleNegativesRankingLoss。它接受“查询、正例”数据对,还可以增加任意固定数量的难负例列,只要各样本的负例数量相同。训练会提高查询与正例的相似度,并压低其与负例的相似度。
负例来自两处:一是显式提供的难负例,本例为 negative_0;二是同一批次其他样本的正例与难负例,复用为当前查询的批内负例。批次越大,可用的批内负例越多,通常能提供更强的训练信号。缓存版本通过梯度缓存,让显存受限时仍可使用较大的有效批次。
mini_batch_size 控制缓存前向过程中一次处理的样本数。大型多模态模型可把它设为 1,以降低峰值显存,同时保留较大批次带来的对比学习信号:
from sentence_transformers.sentence_transformer.losses import CachedMultipleNegativesRankingLoss

loss = CachedMultipleNegativesRankingLoss(model, mini_batch_size=1)
编辑补充:批内样本“不同”不等于语义上一定不相关,领域数据仍可能出现假负例。mini_batch_size=1 也不是不会显存溢出的保证,图像分辨率、模型大小与硬件条件仍然重要。
MatryoshkaLoss
为使不同截断维度都能得到有用的嵌入,可以用 MatryoshkaLoss 包装基础损失,同时训练多个维度:
from sentence_transformers.sentence_transformer.losses import CachedMultipleNegativesRankingLoss, MatryoshkaLoss

loss = CachedMultipleNegativesRankingLoss(model, mini_batch_size=1)
loss = MatryoshkaLoss(model, loss, matryoshka_dims=[2048, 1536, 1024, 512, 256, 128, 64])
Qwen3-VL 的完整嵌入为 2048 维。Matryoshka 训练将重要信息集中到靠前的维度,使部署时可以取 256、128 等较短向量,以减少存储和检索开销。后面的实验显示,微调模型在 512 维时仍接近完整维度的表现。
设置训练参数
SentenceTransformerTrainingArguments 负责训练超参数与过程记录。作者的 VDR 微调配置如下:
from sentence_transformers.sentence_transformer.training_args import SentenceTransformerTrainingArguments, BatchSamplers

run_name = "Qwen3-VL-Embedding-2B-vdr"
args = SentenceTransformerTrainingArguments(
    # Required parameter:
    output_dir=f"models/{run_name}",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=64,
    per_device_eval_batch_size=64,
    learning_rate=2e-5,
    warmup_ratio=0.1,
    fp16=False,
    bf16=True,
    batch_sampler=BatchSamplers.NO_DUPLICATES,
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.1,
    save_total_limit=2,
    logging_steps=0.05,
    run_name=run_name,
)
其中,bf16=True 采用 bfloat16;在支持它的硬件上,其数值稳定性通常比 float16 更好。BatchSamplers.NO_DUPLICATES 避免同一批次中的重复样本,减少把同一实例当负例的问题。虽然每设备批大小 64 对 2B 参数 VLM 看起来很大,但缓存损失使用 mini_batch_size=1 分段处理。
eval_steps、save_steps 和 logging_steps 可以设置为小于 1 的比例。原文的单轮训练中,0.1 对应训练进度约每 10% 执行一次评估或保存。编辑澄清:这里的比例以训练步数为依据;改成多轮训练时不能简单解释为“每一轮的 10%”。save_total_limit=2 会限制保留的检查点数量,较早检查点可能被清理,应将需要长期保留的模型另存。
构建评估器
InformationRetrievalEvaluator 可以在训练前、中、后计算 NDCG@10、MAP 和 Recall@k 等检索指标。以下代码用整数作为查询和文档 ID,让第 i 条查询的相关文档就是第 i 张正例图像;难负例使用偏移 ID,避免与正例 ID 冲突:
from sentence_transformers.sentence_transformer.evaluation import InformationRetrievalEvaluator

# Build the evaluation data from the eval dataset.
# Queries and corpus use integer IDs: query 0's relevant document is corpus 0.
eval_queries = {qid: sample["query"] for qid, sample in enumerate(eval_dataset)}
eval_corpus = {did: sample["image"] for did, sample in enumerate(eval_dataset)}
num_eval = len(eval_dataset)

# Add hard negatives to the corpus with offset IDs (num_eval, 2*num_eval, ...)
# so they don't collide with the positive document IDs (0..num_eval-1).
negative_columns = ["negative_0", "negative_1", "negative_2", "negative_3"]
for neg_idx, neg_col in enumerate(negative_columns):
    for did, sample in enumerate(eval_dataset):
        eval_corpus[num_eval * (neg_idx + 1) + did] = sample[neg_col]

# Each query's relevant document is the positive at the same index
eval_relevant_docs = {idx: [idx] for idx in range(len(eval_dataset))}

eval_evaluator = InformationRetrievalEvaluator(
    queries=eval_queries,
    corpus=eval_corpus,
    relevant_docs=eval_relevant_docs,
    batch_size=1,
    show_progress_bar=True,
    name="vdr-eval-hard",
)
评估器接收文本查询、包含图像的候选语料库,以及每条查询对应的相关文档映射。300 张正例与四组各 300 张难负例构成 1500 个候选文档条目。batch_size=1 降低大型 VLM 评估时的显存压力。这个设置是作者的评估范围,不是整个公开互联网文档检索任务的全面基准。
把组件交给 Trainer
SentenceTransformerTrainer 把所有部分串起来。下面保留原文完整训练脚本:加载模型与模型卡信息,准备数据,定义双层损失,配置参数,评估基线,训练,再评估不同维度并保存。
代码编辑说明:原文最后一行会向 Hugging Face Hub 上传模型。本文将这一行改为注释,明确作为可选发布步骤;其他训练逻辑保持原文结构。本次没有执行训练或上传。模型卡中的 license="apache-2.0" 是元数据声明,不会自动为数据或权重赋予额外授权。
from datasets import load_dataset

from sentence_transformers import SentenceTransformer
from sentence_transformers.sentence_transformer.evaluation import InformationRetrievalEvaluator
from sentence_transformers.sentence_transformer.losses import CachedMultipleNegativesRankingLoss, MatryoshkaLoss
from sentence_transformers.sentence_transformer.model_card import SentenceTransformerModelCardData
from sentence_transformers.sentence_transformer.trainer import SentenceTransformerTrainer
from sentence_transformers.sentence_transformer.training_args import (
    BatchSamplers,
    SentenceTransformerTrainingArguments,
)

# 1. Load a model to finetune with (optional) model card data
model = SentenceTransformer(
    "Qwen/Qwen3-VL-Embedding-2B",
    model_card_data=SentenceTransformerModelCardData(
        language="en",
        license="apache-2.0",
        model_name="Qwen3-VL-Embedding-2B model trained on Visual Document Retrieval query-document screenshot pairs",
    ),
    model_kwargs={"attn_implementation": "flash_attention_2", "torch_dtype": "bfloat16"},
    # Control image resolution: lower values save memory, higher values preserve detail
    processor_kwargs={"min_pixels": 28 * 28, "max_pixels": 600 * 600},
)

# 2. Load a dataset to finetune on: (query, positive, negative_0) triplets for training,
# all 4 hard negatives retained for evaluation
train_dataset = load_dataset("tomaarsen/llamaindex-vdr-en-train-preprocessed", "train", split="train")
train_dataset = train_dataset.select_columns(["query", "image", "negative_0"])
eval_dataset = load_dataset("tomaarsen/llamaindex-vdr-en-train-preprocessed", "eval", split="train")

# 3. Define a loss function
loss = CachedMultipleNegativesRankingLoss(model, mini_batch_size=1)
loss = MatryoshkaLoss(model, loss, matryoshka_dims=[2048, 1536, 1024, 512, 256, 128, 64])

# 4. (Optional) Specify training arguments
run_name = "Qwen3-VL-Embedding-2B-vdr"
args = SentenceTransformerTrainingArguments(
    # Required parameter:
    output_dir=f"models/{run_name}",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=64,
    per_device_eval_batch_size=64,
    learning_rate=2e-5,
    warmup_ratio=0.1,
    fp16=False,  # BF16 is preferred over FP16 for VLMs due to better numerical stability
    bf16=True,  # Set to True if your GPU supports BF16 (most modern GPUs do)
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # MultipleNegativesRankingLoss benefits from no duplicates
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.1,
    save_total_limit=2,
    logging_steps=0.05,
    run_name=run_name,  # Used in e.g. Trackio if installed
    # report_to=["codecarbon", "trackio"],  # Uncomment to enable logging (pip install codecarbon trackio)
)

# 5. (Optional) Create an evaluator & evaluate the base model
eval_queries = {qid: sample["query"] for qid, sample in enumerate(eval_dataset)}
eval_corpus = {did: sample["image"] for did, sample in enumerate(eval_dataset)}
num_eval = len(eval_dataset)
negative_columns = ["negative_0", "negative_1", "negative_2", "negative_3"]
for neg_idx, neg_col in enumerate(negative_columns):
    for did, sample in enumerate(eval_dataset):
        eval_corpus[num_eval * (neg_idx + 1) + did] = sample[neg_col]
eval_relevant_docs = {idx: [idx] for idx in range(len(eval_dataset))}

eval_evaluator = InformationRetrievalEvaluator(
    queries=eval_queries,
    corpus=eval_corpus,
    relevant_docs=eval_relevant_docs,
    batch_size=1,
    show_progress_bar=True,
    name="vdr-eval-hard",
)
eval_evaluator(model)

# 6. Create a trainer & train
trainer = SentenceTransformerTrainer(
    model=model,
    args=args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    loss=loss,
    evaluator=eval_evaluator,
)
trainer.train()

# 7. (Optional) Evaluate at each Matryoshka dimension
eval_evaluator(model)
for dim in [2048, 1536, 1024, 512, 256, 128, 64]:
    dim_evaluator = InformationRetrievalEvaluator(
        queries=eval_queries,
        corpus=eval_corpus,
        relevant_docs=eval_relevant_docs,
        truncate_dim=dim,
        batch_size=1,
        show_progress_bar=True,
        name=f"vdr-eval-hard-{dim}d",
    )
    dim_evaluator(model)

# 8. Save the trained model
model.save_pretrained(f"models/{run_name}/final")

# 9. (Optional) Push it to the Hugging Face Hub
# This pushes to your personal namespace, e.g. {your_username}/Qwen3-VL-Embedding-2B-vdr
# Optional publication; review visibility and permissions before enabling:
# model.push_to_hub("Qwen3-VL-Embedding-2B-vdr")
这段流程与纯文本嵌入训练几乎相同。差异主要有三项:加载时增加精度、注意力实现和图像分辨率参数;使用缓存损失处理较大 VLM;评估语料库改为图像而查询仍为文本。Trainer、训练参数与数据加载的组织方式没有改变。
实验结果
模型规模与 NDCG@10
作者只训练了 1 个 epoch,在 300 条查询、1500 个候选文档、余弦相似度的评估设置下,报告微调模型 NDCG@10 为 0.947。下表完整保留原文对 20 个模型的比较;“更好”仅指这一评估集合与设置。
| 模型 | 参数规模 | NDCG@10 |
|---|---|---|
| tomaarsen/Qwen3-VL-Embedding-2B-vdr | 2.1B | 0.947 |
| Qwen/Qwen3-VL-Embedding-8B | 8.1B | 0.923 |
| nvidia/omni-embed-nemotron-3b | 4.7B | 0.915 |
| nvidia/llama-nemotron-embed-vl-1b-v2 | 1.7B | 0.912 |
| nomic-ai/nomic-embed-multimodal-7b | 8.3B | 0.912 |
| llamaindex/vdr-2b-multi-v1 | 2.2B | 0.912 |
| llamaindex/vdr-2b-v1 | 2.2B | 0.911 |
| nomic-ai/nomic-embed-multimodal-3b | 3.8B | 0.899 |
| Qwen/Qwen3-VL-Embedding-2B | 2.1B | 0.888 |
| LCO-Embedding/LCO-Embedding-Omni-7B | 8.9B | 0.888 |
| LCO-Embedding/LCO-Embedding-Omni-3B | 4.7B | 0.860 |
| BAAI/BGE-VL-v1.5-zs | 7.6B | 0.800 |
| BAAI/BGE-VL-v1.5-mmeb | 7.6B | 0.797 |
| BAAI/BGE-VL-MLLM-S2 | 7.6B | 0.792 |
| BidirLM/BidirLM-Omni-2.5B-Embedding | 2.5B | 0.775 |
| royokong/e5-v | 8.4B | 0.767 |
| BAAI/BGE-VL-MLLM-S1 | 7.6B | 0.710 |
| sentence-transformers/clip-ViT-L-14 | 428M | 0.611 |
| BAAI/BGE-VL-large | 428M | 0.467 |
| BAAI/BGE-VL-base | 150M | 0.335 |
在这组比较中,微调后的 2B 模型也领先于 8B 的 Qwen3-VL-Embedding。这说明,对于明确的领域任务,专门微调可以比单纯增加通用模型规模更有效。
Matryoshka 维度与 NDCG@10
原文将上一组比较描述为使用完整 2048 维嵌入。维度实验则显示,在部署时截短向量,可以用较小的空间代价保留大部分检索效果:
| 维度 | 基础模型 NDCG@10(相对完整维度) | 微调模型 NDCG@10(相对完整维度) |
|---|---|---|
| 2048 | 0.8961(100%) | 0.9480(100%) |
| 1536 | 0.8940(99.8%) | 0.9439(99.6%) |
| 1024 | 0.8941(99.8%) | 0.9464(99.8%) |
| 512 | 0.8760(97.8%) | 0.9451(99.7%) |
| 256 | 0.8347(93.2%) | 0.9372(98.9%) |
| 128 | 0.7888(88.0%) | 0.9058(95.5%) |
| 64 | 0.6852(76.5%) | 0.8758(92.4%) |
微调模型在完整 2048 维达到 0.9480;降至 512 维,向量小四倍,仍保留约 99.7% 的完整维度分数。到 64 维,向量小 32 倍,仍保留约 92.4%。作者认为 1024 维与 2048 维差距很小,因此在发布模型配置中设置 truncate_dim=1024。直接加载 SentenceTransformer("tomaarsen/Qwen3-VL-Embedding-2B-vdr") 默认生成 1024 维嵌入;需要其他维度时,可在加载时传入 truncate_dim=N 覆盖。
数据核对说明:原文模型比较表为基础模型 0.888、微调模型 0.947;维度表的 2048 维行则为 0.8961、0.9480。两处数值确实不同,正文没有说明差异来源。本文分别保留,不合并为同一次测量,也不自行补造实验条件。
训练多模态重排模型
同一套训练基础设施也支持多模态 Cross Encoder(重排模型)。主要变化是改用 CrossEncoderTrainer 和 Cross Encoder 专用损失。下面是基于 doodles 图文匹配脚本的简化示例;完整的数据准备和评估实现应参考 官方训练示例目录。
片段边界:下面是原文明确标为“简化示例”的代码。args、双向训练/评估数据集及评估器未在片段内定义,不能直接单独运行;args 应是重排训练所需的 CrossEncoderTrainingArguments,不能随意沿用上文嵌入训练参数对象。
from sentence_transformers.cross_encoder import CrossEncoder
from sentence_transformers.cross_encoder.losses import BinaryCrossEntropyLoss
from sentence_transformers.cross_encoder.modules import LogitScore, Transformer
from sentence_transformers.cross_encoder.trainer import CrossEncoderTrainer
from sentence_transformers.cross_encoder.training_args import CrossEncoderTrainingArguments

# 1. Build the model from modules
transformer = Transformer(
    "Qwen/Qwen3.5-0.8B",
    transformer_task="any-to-any",
    model_kwargs={"torch_dtype": "bfloat16", "device_map": "auto", "attn_implementation": "flash_attention_2"},
    processing_kwargs={"chat_template": {"add_generation_prompt": True}},
)

# Extend chat template to support "query" and "document" roles
transformer.processor.chat_template = transformer.processor.chat_template.replace(
    'message.role == "user"', 'message.role in ["user", "query", "document"]'
)

# LogitScore: score = log(P("1")) - log(P("0"))
score_head = LogitScore(
    true_token_id=transformer.tokenizer.convert_tokens_to_ids("1"),
    false_token_id=transformer.tokenizer.convert_tokens_to_ids("0"),
)

model = CrossEncoder(
    modules=[transformer, score_head],
    num_labels=1,
    prompts={
        "image_to_text": "Given the image, judge whether the text matches it. Respond with 1 if they match, 0 if they don't.",
        "text_to_image": "Given the text, judge whether the image matches it. Respond with 1 if they match, 0 if they don't.",
    },
)

# 2. Define the loss
loss = BinaryCrossEntropyLoss(model)

# 3. Multi-dataset training with separate directions
trainer = CrossEncoderTrainer(
    model=model,
    args=args,
    train_dataset={"image_to_text": train_image_to_text, "text_to_image": train_text_to_image},
    eval_dataset={"image_to_text": eval_image_to_text, "text_to_image": eval_text_to_image},
    loss=loss,
    evaluator=[image_to_text_evaluator, text_to_image_evaluator],
)
trainer.train()
多模态重排器有不止一种有效架构。第一种是 Any-to-Any 加 LogitScore,使用多模态语言模型对应“1”和“0”的概率,计算 log P("1") − log P("0") 作为匹配分数。第二种是 Feature Extraction 加 Pooling、Dense:只使用多模态基础模型,提取最后一个 token 的隐藏状态并投影成分数,省去语言建模输出头的计算。
官方两份示例分别展示这些路线。它们把数据分成图像到文本、文本到图像两个方向,为每个方向提供说明评分任务的提示词;随后给每个正例对补充随机采样的负例,使损失看到较平衡的匹配与不匹配样本。
静态核验补充:聊天模板通过字符串替换来增加 query 和 document 角色,这依赖所加载模板含有完全匹配的字符串;换模型后应验证替换确实生效,以及“1”“0”各自对应预期的 token。device_map="auto" 与分布式训练的兼容性依赖训练框架配置,本稿不把这个片段视为任何硬件上的通用部署方案。
更多示例与文档
Sentence Transformers 仓库提供了本文的 视觉文档检索完整训练脚本,以及 Any-to-Any + LogitScore、Feature Extraction + Pooling + Dense 两种重排训练示例。
配套文档包括:嵌入模型训练总览、嵌入损失总览、重排模型训练总览、重排损失总览、数据集总览及 API 参考。
原文推荐的相关阅读依次涵盖 多模态推理、纯文本嵌入训练、重排模型训练、稀疏嵌入训练、Matryoshka 原理、适合 CPU 的静态嵌入、二值与标量量化,以及介绍本文数据集的 多语言视觉文档检索。这些技术可以与多模态训练结合使用,但不是本篇要求合并的来源文章。
运行边界:本次只完成全文核对与静态代码审查,没有下载模型或数据、调用付费服务、启动 GPU 训练、计算分数或发布模型。原文没有提供完整软件版本锁文件或最低显存数值;实际运行需核对 Sentence Transformers、Transformers、PyTorch、FlashAttention 与 GPU 的兼容性。BF16 和 FlashAttention 2 需要相应硬件与安装支持。模型、数据与本地输出都应使用可追溯版本;图像 URL 和文件路径只应来自受信数据,避免训练进程访问非预期网络资源或本地文件。











暂无评论内容