


原作者:Andrei Kvapil(Ænix)、Timofei Larkin(Ænix)。原文于 2026 年 7 月 29 日发表于 Kubernetes Blog,页面标记最后修改时间为 2026 年 8 月 6 日。本文为获授权的完整中文翻译整理,核验日期为 2026 年 10 月 5 日。
原文修订声明:作者说明,文章在首次发表后已经修订,以纠正若干重要技术错误。本译稿依据当前修订正文;涉及版本和原文过度概括之处,另以“编辑核验”明确说明。文中的代码均为阅读和静态审查用途,本次没有在集群执行。
Kubernetes 早已成为分布式工作负载的常用平台。使用 Go、Kubebuilder 与 controller-runtime,几个小时就能搭出自己的控制器:项目骨架、类型定义与 Reconciler 都准备好了。典型场景下这些足够,但负载变大,或控制器行为出乎预料时,一整类边界情况就会出现。
很多问题都源于对 controller-runtime 内部机制的认识不完整。本文希望把这些零散现象连成一套清晰的模型,重点讨论生产集群里的内存、网络流量、读取一致性与调和行为。
常见误解是:Reconcile 中的 r.Get() 会直接查询 kube-apiserver;r.List() 返回实时的完整状态;调用 r.Update() 后立即重读,就能看到写入结果。实际上,通常的模型正好相反:controller-runtime 面向由 list + watch 维护的本地副本工作。读取很便宜,不会因每秒数百次缓存访问就向控制面发送同样数量的请求;代价则是内存占用、隐蔽的 O(n) 扫描,以及滞后读取。
先记住核心模型
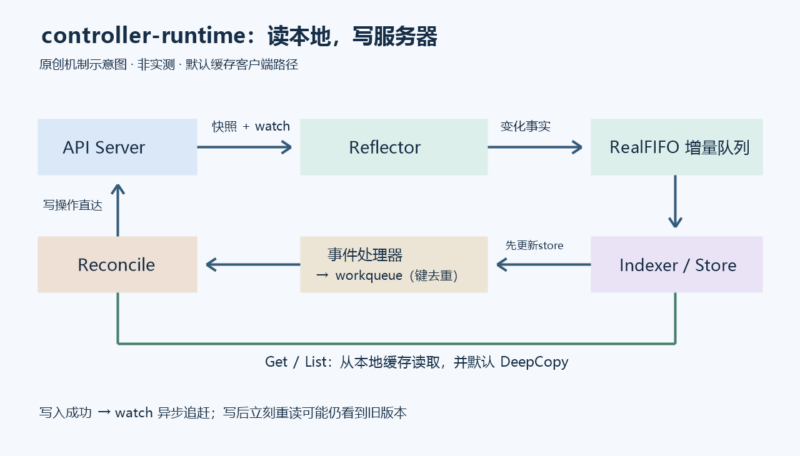
使用 manager 默认缓存客户端时,Reconciler 的 Get 和 List 通常从进程内存读取。manager 先获取快照,再通过 watch 跟踪变化。读操作便宜,但不保证写后立刻一致;写操作直接发给 API Server;缓存规模与索引数量决定内存开销;不合适的 List 会扫描数万对象;只有少数情形需要绕过缓存使用 APIReader。
调和循环从哪里获得状态
Kubernetes 控制器不断比较对象的期望状态与实际状态,并推动两者一致。典型过程是:用户或其他控制器修改对象,事件进入队列,Reconcile 读取当前状态,决定创建、更新或删除哪些资源,随后系统产生新事件,循环继续。
关键不是控制器“做了什么”,而是它从哪里得知变化、从哪里读取状态。在已有读取权限的测试集群中,可以用下列只读命令观察 watch:
kubectl get pods --watch
创建或删除 Pod 时,看到的并非一个孤立的“最终对象”,而是一连串状态:调度器分配节点,kubelet 更新状态,其他控制器继续修改。控制器采用事件流维护本地状态,而不是不停轮询全部对象。原文另附 调和循环可视化演讲;本文不把视频未核验内容当作正文证据。
为什么需要缓存
考虑这个最简单的 Reconciler 片段:
func (r *Reconciler) Reconcile(ctx context.Context, req ctrl.Request) (ctrl.Result, error) {
    var pod corev1.Pod
    if err := r.Get(ctx, req.NamespacedName, &pod); err != nil {
        return ctrl.Result{}, err
    }
    // ... meaningful logic ...
}
这是省略业务逻辑和最终返回值的骨架,不是可以直接编译运行的完整函数。如果每次 Get 都产生 HTTP 请求,十几个控制器每轮都 Get、List,再乘上每秒数百次调和,就会给 API Server 和 etcd 带来相当大的压力。
Kubernetes 从一开始就采用 watch 模型:客户端先取得自己关注范围的快照,再订阅变化,持续更新本地副本。这就是 list + watch。client-go 提供了基础机制,controller-runtime 则把 Reflector、增量队列与 Indexer 封装起来,省去开发者自行拼装的工作。因此,缓存不只是可有可无的优化,而是这种控制器的运行基础:从内存读、向 API Server 写、通过 watch 接收反馈。
几个术语
- GVK:Group、Version、Kind 的组合,例如
apps/v1/Deployment。controller-runtime 的多数接口以 GVK 区分类型,而不是 kubectl 中的复数资源名称。 - resourceVersion:API Server 跟踪的资源版本,存储为字符串。它参与乐观并发控制:Update 携带的版本过旧时,服务器返回
409 Conflict;也用于从已知位置继续 watch,相关机制见 watch bookmark。 - Manager:
ctrl.Manager,通常在 main.go 构造并通过mgr.Start(ctx)启动;它拥有共享缓存、构建客户端,启动控制器、webhook、healthz 与其他 runnable。一个进程通常有一个 manager,其中可以放多个控制器。 - Informer:client-go 中维护某类对象 watch、索引存储并通知订阅者的组件。注册 Watches 或首次对未缓存类型执行 Get/List 时,通常会请求或创建相应 informer。
- Store:informer 的内存对象存储;每个 informer 拥有自己的 store。
- ResourceEventHandler:包含 OnAdd、OnUpdate、OnDelete 三种方法。informer 先更新 store,再分发通知,因此处理器看到的 indexer 不会落后于自己正在处理的那条事件,但可能已经更靠后。
- workqueue:保存
namespace/name调和请求,支持去重和限速;worker 取出请求后交给 Reconcile。 - Predicate:控制器侧事件过滤器,决定是否让事件产生入队请求,例如只关心 spec 变化,忽略 status 变化。
编辑核验:原文将 resourceVersion 概括为单调计数器。当前 官方 API Concepts 已允许在同一 API group/resource type 内,把可解析的版本视为任意精度十进制整数进行比较,并指出相关要求自 Kubernetes 1.35 纳入一致性认证。不要跨资源类型比较,也不要用可能溢出的固定精度整数处理;扩展 API Server 还需确认格式。用于请求时仍应保留服务端返回的完整版本字符串。
缓存包下面有什么
sigs.k8s.io/controller-runtime/pkg/cache 是 k8s.io/client-go/tools/cache 之上的封装。其内部主要包含四个部分:
- Reflector:与 API Server 维持 watch,将变化记录成 delta,例如“对象 X 收到 Added/Updated/Deleted,这是它的新版本”。
- 增量队列:当前版本使用 RealFIFO,旧版 client-go 使用 DeltaFIFO,在 informer 处理前暂存变化。
- Indexer(Store):存放实际对象,并维护其索引。
- SharedIndexInformer:把上述组件连起来,再向控制器等订阅者分发事件。
Reflector 与 resourceVersion
在缓存内部,负责和 API Server 通信的是 Reflector:启动时取得初始快照,随后维持 watch。写操作和 APIReader 读取另外直连服务器,不经过它。
获取快照时,服务器同时返回对应 resourceVersion;Reflector 从那个版本开始 watch,接收快照之后的变化。这使快照与事件流能够衔接,避免在两者之间留下空档。较新的实现支持 streaming list:以 sendInitialEvents=true 打开 watch,先接收当前状态对应的合成 ADDED 事件,再继续接收实时变化;不支持时回退为单独的 list。尽管请求形式变化,“先快照,再增量”的模式仍然成立。
连接断开后,Reflector 从最后知道的 resourceVersion 重连。如果服务器返回 410 Gone,表示该版本已不在可用历史中,需要重新获取快照,也就是 relist。它不是按 resync 周期固定重拉全部对象。具体 streaming list 默认值与回退行为要以编译依赖和服务器支持情况为准。
增量队列:RealFIFO 与旧 DeltaFIFO 的区别
旧 DeltaFIFO 以 namespace/name 为键保存 delta 切片:同一对象的变化累积在同一个槽中,Pop 一次返回这一组变化,dedupDeltas 还会合并连续的 Deleted 记录。
当前修订稿介绍的 RealFIFO 更直接,内部保存按到达顺序排列的 delta:
type RealFIFO struct {
    // ...
    items []Delta
}
这里是省略其他成员的结构示意。RealFIFO 保留全局到达顺序,一次 Pop 取一条 delta,不以对象键合并,也没有对应的 dedupDeltas。PopBatch 可以批量取出多条变化以减少处理开销,但并不会把变化合并成一条。
原文将版本称为“client-go 1.35/1.36”。编辑核验:Go 模块的相应版本写法是 client-go v0.35/v0.36,对应 Kubernetes 1.35/1.36;决定队列实现的是控制器编译时使用的 client-go 版本,不只是连接到哪个集群。本文沿用当前修订稿关于 RealFIFO 的说明,旧版本不能直接套用。v0.36 特性定义表明 InOrderInformers 已进入 GA 并锁定开启,标准 shared informer 构造路径不能再通过关闭该特性切回 DeltaFIFO;但 DeltaFIFO 类型仍在库中,并不是被彻底删除。批量处理说明对应 v0.35 发布线。
假设 default/my-deploy 依次收到 Added(副本为 1)、Updated(变成 2)、Updated(变成 3)。RealFIFO 会依次交付三条变化;informer 调用一次 OnAdd 和两次 OnUpdate,分别对应 1→2、2→3。
store 总是在通知处理器之前更新,而通知通过每个订阅者自己的缓冲区异步交付。因此,在处理 1→2 的事件时,缓存 Get 已经可能读到 3,甚至因为对象被删除而返回 NotFound。不能把 store 当前值当作“我这条事件发生时的状态”。
去重仍然存在,但在上一层的 workqueue。每条事件被转换成对象键;如果相同键已经在队列里,再次插入会合并。Pod 在短时间内经历调度、Pending、ContainerCreating、Running、Ready 等状态时,事件处理器可能收到多条通知,但排队中的对象键可以只有一个。worker 取到它时,Reconcile 读取的可能已经是更新后的状态。
因此,两层职责不同:增量队列顺序交付变化事实;workqueue 对“需要重新调和哪个对象”去重。事件到达与worker执行交错时仍可能再次排队,不能由“去重”推断所有场景下永远只调和一次。
Indexer:集群状态的本地副本
Indexer 的底层 ThreadSafeStore 主要是以 namespace/name 为键的 map、一把 sync.RWMutex,以及注册的索引字典。无锁竞争时,Get 的主要工作是 map 查找加对象 DeepCopy。
大规模场景中,保护 store 和索引的锁尤其值得注意:读操作共享锁,更新 store 则需要写锁。List 枚举大量对象时会与更新发生竞争;在锁释放后复制对象的开销也可能很高。原文链接的 Kubernetes #130767 讨论了规模化瓶颈,新版 client-go 已缩短持有写锁的时间。
SharedIndexInformer:共享订阅
SharedIndexInformer 对外提供两类接口:从 indexer 读取对象,以及注册 ResourceEventHandler。控制器注册 Watches 时,相当于添加一个在变化发生后把对象键送入该控制器 workqueue 的处理器;worker 再逐一调用 Reconcile。
“Shared”表示同一个 manager 中关心相同缓存的控制器、webhook 和事件源可以共享 informer。典型情况下,一个 Pod informer 对外维持一组 list/watch,再把数据与事件分发给多个订阅者,不必每个 Reconciler 都创建一份。
编辑限定:“每个 GVK 一个 informer”是默认普通对象场景的简化描述;按 namespace 拆分的缓存,以及 typed、unstructured、metadata-only 等不同缓存路径,可能拥有独立 informer。下文的 metadata-only watch 本身就是需要注意的例子。
启动和第一次 Get 时发生什么
mgr.Start(ctx)启动已注册的 informer。- Reflector 获取每个类型在所选范围内的完整快照。
- 快照填入 store,索引建立并填充,informer 标记为已同步。
- 事件流从快照对应的版本继续。
- 控制器等待自己拥有的所有 source 同步,其中也包括事件处理器完成初始快照处理,然后才让 worker 消费队列并调用 Reconcile。
因此,正常注册的类型不会出现“Reconciler 已运行,但其启动快照还没加载”的情况。一个例外是临时 Get 未注册过 watch 的类型:默认行为可能在此时创建新 informer,并阻塞等待它预热。这会产生额外的内存、网络和权限需求。
var obj appsv1.Deployment
err := r.Get(ctx, req.NamespacedName, &obj)
对已预热类型,上面的 Get 内部大致等价于:
item, exists, err := indexer.GetByKey("default/my-deploy")
if !exists {
    return apierrors.NewNotFound(...)
}
// DeepCopy into obj
这个带省略号的片段只说明流程:没有 HTTP、TLS、protobuf 编解码或 etcd 访问,只有本地查找与深拷贝。即使是第一次 Get,只要类型已注册并完成预热,也是从缓存读。
这专指 mgr.GetClient() 的缓存读取。如果需要在 mgr.Start() 前读取对象,应使用 mgr.GetAPIReader();缓存客户端此时不会返回空数据,而会返回 ErrCacheNotStarted。获取客户端对象本身与用它执行尚未启动的缓存读取是两回事。
Client 不等于 Cache:读内存,写服务器
默认 client.Client 是组合客户端:Get、List 经缓存读;Create、Update、Patch、Apply、Delete 和 DeleteAllOf 直接发往 API Server。高频读取应该便宜,写操作则必须由服务器确认,不能先把本地对象当成写入成功,否则会出现本地认为成功、服务器实际拒绝的分歧。
缓存返回的对象携带 Reflector 上次观察到的 resourceVersion。修改对象后调用 Update,服务器检查 PUT 中的版本是否仍是当前版本;若已被其他调用更新,就返回 409 Conflict。并发写入不需要真正给对象加分布式锁,而是用版本检查阻止旧状态覆盖新状态。读取、修改、重试时必须考虑竞争,不应把409简单当作框架故障。
不带乐观锁的 Patch、Server-Side Apply 等写法有不同语义,不能假定它们都自动具备完全相同的版本保护。写入可见性路径是“client.Update → API Server → watch 事件 → 本地缓存”。从写入完成到缓存追上有一个异步窗口,通常很短,但没有通用的延迟上限;在这个窗口内再次缓存 Get,可能仍读到旧版本。
四个常见误区
误区一:以为写后马上可读
下面是原文刻意展示的错误预期,不是推荐写法。它把副本数改为5后立刻重读,可能仍看到3:
obj.Spec.Replicas = ptr.To(int32(5))
if err := r.Update(ctx, &obj); err != nil {
    return ctrl.Result{}, err
}

// re-read and confirm it is now 5
var fresh appsv1.Deployment
_ = r.Get(ctx, key, &fresh)
fmt.Println(*fresh.Spec.Replicas) // surprise: 3
缓存通过 watch 异步追赶,这是最终一致系统的性质。Reconcile 应当幂等:当前状态不符合目标,下次调和继续推进;额外调用一两次不应破坏结果。固定等待100毫秒或人为重复触发,并不能提供一致性保证。
如果滞后读取会造成真正的正确性问题,简单改成实时读取也不能消除读写之间的并发竞争。应参考 controller-runtime FAQ 中的控制器模式。静态审查:反例中的 Get 忽略错误且直接解引用 fresh.Spec.Replicas,还可能触发空指针错误;生产代码要检查错误与可空字段。本次未改变任何 Deployment 副本数。
误区二:没有弄清对象内存归谁
Watches 到 Reconcile 之间存在 Predicate 与 EventHandler 两层。Predicate 判断事件是否通过;EventHandler 把对象转换成一个或多个 ctrl.Request,例如 EnqueueRequestForObject 取其 namespace/name。
这些回调收到的是 informer 共享 store 中的对象。同一份 Pod 指针可能交给多个订阅者。如果在处理器里直接执行 pod.Labels["foo"] = "bar",修改的就是共享缓存,而不是独立工作副本。Go 没有不可变结构体来阻止你这么做;修改返回对象也可能破坏索引。
默认缓存客户端的 Get/List 会深拷贝,返回对象通常由调用者拥有;如果显式启用 UnsafeDisableDeepCopy,这一保护便不成立。事件路径则没有同样的自动拷贝保护,因此 Predicate/EventHandler 中若必须修改对象,应先调用 DeepCopy()。审查 UpdateFunc 或 EnqueueRequestsFromMapFunc 时,看到 SetLabels 或直接赋值 Status,应检查此前是否取得独立副本。
误区三:把 resync 当作 relist
cache.Options.SyncPeriod 的默认值在原文语境中为10小时,但它不表示每10小时重新从 API Server 拉一次完整资源列表。resync 会把 indexer 中已有对象重新送入通知流程,对每个对象产生 OnUpdate(old, old) 这样的更新。它本身不产生新的 API 读取流量。
这有助于定期核对 Kubernetes API 之外的状态,例如云资源,因为外部变化不会自动产生 Kubernetes watch 事件。编辑澄清:resync 是一种检查外部状态的手段,不是唯一手段;也可使用定时重排或外部事件源。若使用 GenerationChangedPredicate 之类比较新旧版本的过滤器,old与new相同的合成更新可能被丢弃。
relist 则是重新获取快照,例如 watch 的历史版本过期返回410,或重新创建 informer 时需要启动同步。具体故障和回退路径依赖 client-go 版本,不能把 resync 当成固定周期的全量同步。
误区四:用睡眠替代 RequeueAfter
如果外部 API 暂未准备好,需要稍后再试,不要用 time.Sleep 占住 worker,也不必自行创建 goroutine 管理计时器:
return ctrl.Result{RequeueAfter: 30 * time.Second}, nil
控制器会安排这个对象在30秒后重新入队。在此之前若收到真实事件,仍可以更早进入调和;队列会按键去重。这一机制表达的是延后再检查,不保证恰好30秒执行,也不阻止其他事件提前触发。
缓存加索引:像查询引擎一样使用
最直观的写法是列出全部 Pod,再在应用代码里筛选 nodeName:
var pods corev1.PodList
_ = r.List(ctx, &pods)
for _, p := range pods.Items {
    if p.Spec.NodeName == "node-1" {
        // do something
    }
}
上面是原文中的性能反例。当缓存有50,000个Pod,且每秒调和数百次时,每轮全量遍历与深拷贝都会变贵。枚举 store 的部分还会和写入争用锁。可以在启动时注册字段索引:
// Index by spec.nodeName for Pods
if err := mgr.GetFieldIndexer().IndexField(
    ctx,
    &corev1.Pod{},
    "spec.nodeName",
    func(obj client.Object) []string {
        pod := obj.(*corev1.Pod)
        if pod.Spec.NodeName == "" {
            return nil
        }
        return []string{pod.Spec.NodeName}
    },
); err != nil {
    return err
}
这里的 "spec.nodeName" 是索引名称,不会被当作 JSONPath 解析,也不会自动与 schema 对照;叫 by-node 也可以。唯一要求是查询 MatchingFields 时使用完全相同的名称。这种任意命名只适用于本地缓存索引,不能推导出 API Server 支持相同的 field selector。
索引值由回调计算,不一定是某个字段的原始文本。可以转成小写、拼接多个字段、按对象时间戳分桶,或者生成对象中没有直接出现的字符串。限制是:值必须从被索引对象推导出来。
它是倒排索引:键为字段值,值为满足条件的对象键集合,大致如下(这是数据结构示意,不是可执行 Go):
map["node-1"] = {"default/pod-a", "kube-system/pod-b", ...}
map["node-2"] = {"default/pod-c", ...}
对象加入、修改或删除时,Indexer 同步维护这些映射。若索引字段值变化,旧值集合移除对象键,新值集合加入;并不是等查询时才扫描重建。编辑澄清:原文用“Pod从node-1迁到node-2”解释索引迁移,但已绑定Pod通常不能直接修改nodeName迁移节点;这里应理解为一般对象索引值变化的抽象过程,而不是Pod迁移操作指南。
注册索引之后,可以直接查询目标键集合:
var pods corev1.PodList
_ = r.List(ctx, &pods,
    client.MatchingFields{"spec.nodeName": "node-1"},
)
它走的是“查倒排索引 → 取得对象键集合 → 取对应对象”的路径,不是全量列出后再过滤。
| SQL 类比 | controller-runtime |
|---|---|
CREATE INDEX idx_node ON pods(node_name) |
IndexField(&Pod{}, "spec.nodeName", fn) |
SELECT * FROM pods WHERE node_name = 'node-1' |
List(&pods, MatchingFields{"spec.nodeName": "node-1"}) |
SELECT * FROM obj WHERE owner_uid = $1 |
MatchingFields{"metadata.ownerReferences.uid": uid},但需要先为该名称注册IndexField。 |
MatchingFields 不会自动创建索引;缺少对应 IndexField 时,查询返回错误,而不是悄悄退化成全表扫描。上文原文 List 片段为简洁而忽略错误,实际代码必须检查返回值,否则可能把查询失败误认为对象不存在。
还应记住四个限制:
- 字段索引主要支持相等匹配,不是范围、LIKE、排序或聚合引擎。如果要找“五分钟前的对象”,可以List后过滤,或把对象自己的时间戳按五分钟取整建桶,再查询相应桶;不要用会随时钟改变、却不随对象事件更新的当前时间充当稳定索引值。
MatchingLabels不是独立的标签倒排索引。它仍需遍历候选对象,但在深拷贝之前判断标签,因此50,000个对象只有10个匹配时,是50,000次比较和10次复制,而不是50,000次复制。它优于复制全部对象后自行过滤,但不会自动降低遍历复杂度。- 命名空间索引或字段索引可以缩小候选集合;若根本不想将无关对象放入内存,应在缓存填充时用 ByObject.Label 或 DefaultLabelSelector 下推选择条件。
- 索引额外占用内存:它存值到对象键集合的映射,而不复制完整对象,但也不是零成本。只为实际查询需求建索引;不能按“关联PVC具有某标记”直接给Pod建索引,除非相关事实已存入Pod,或改为索引PVC。
索引注册并随初始快照填充,在首轮 Reconcile 运行时即可使用;不是第一次查询时才懒构建。Get 则直接按对象键查询,不用字段索引。
选择性缓存:别把整个集群搬进进程
默认 informer 通常缓存其范围内所有命名空间的同类对象。大型集群的Pod、Secret、ConfigMap和Event会带来意料之外的内存占用。Helm在Secret中保存发布状态,这类Secret可能很大;Node的 status.images 也可能较大;Event数量多,往往无须全部缓存。原文将Node镜像列表描述成“曾在节点出现过的所有镜像”,这里应按实际Node状态理解为kubelet报告的镜像信息,不是永久历史审计清单。
构造manager时,可通过 cache.Options 定义缓存策略:
mgr, err := ctrl.NewManager(cfg, ctrl.Options{
    Cache: cache.Options{
        ByObject: map[client.Object]cache.ByObject{
            // Cache Secrets only from your own namespace, and only by label
            &corev1.Secret{}: {
                Namespaces: map[string]cache.Config{
                    "my-controller": {},
                },
                Label: labels.SelectorFromSet(labels.Set{
                    "app.kubernetes.io/managed-by": "my-controller",
                }),
            },
            // Cache all Pods, but trim noise on the way into the store
            &corev1.Pod{}: {
                Transform: func(obj any) (any, error) {
                    pod := obj.(*corev1.Pod)
                    pod.ManagedFields = nil
                    return pod, nil
                },
            },
        },
    },
})
这是manager配置片段,调用者还需处理 NewManager 返回的错误。Secret只缓存 my-controller 命名空间中带指定标签的对象;Pod仍正常缓存,但进入store前去掉ManagedFields。
这个配置在manager范围生效,会影响同一进程内读取该类型的所有控制器。如果另一个控制器需要所有Secret,缩小共享缓存范围就会让它看不到部分对象,调整前必须核对所有读取者。
Namespaces限制可见命名空间。Label、Field成为服务端list/watch条件,减少传输和内存占用;服务端支持的字段选择器有其自身限制。Transform在对象写入store前运行,可以去掉确实不需要的ManagedFields等大字段。DefaultLabelSelector、DefaultNamespaces在需要统一范围时提供全局默认配置。
选择器限制的是“缓存里有什么”,不是“集群里存在什么”。一个Secret标签写错,不符合选择器,缓存Get/List就看不到它。不要把这种缺失直接解释为真实资源已删除。
编辑安全补充:Transform丢弃的是本地副本字段,本身不删除服务器数据;但若把裁剪后的对象当完整对象提交全量Update,可能覆盖或清空被裁剪字段。尤其不要随意丢弃Secret/ConfigMap的data或业务annotation,再用同一缓存对象全量回写。应明确字段所有权,使用合适的Patch、独立读取或其他写入策略,并在测试环境验证。官方PUT说明也提醒全量替换可能丢失客户端未保留的字段;DeepCopy不能恢复早已被Transform裁掉的内容。
只缓存元数据
有时只需知道对象存在,不需要spec或data。例如等待某个命名的Secret出现、按拓扑标签统计PersistentVolume,或只关心某命名空间内ConfigMap的名称变化。
PartialObjectMetadata 只包含ObjectMeta,没有spec、status、data。因此可使用labels、annotations、ownerReferences、finalizers、creationTimestamp等元信息,却不能在本地按Pod的nodeName或PV的storageClassName等spec字段过滤。
var list metav1.PartialObjectMetadataList
// controller-runtime infers the list shape from the variable type.
list.SetGroupVersionKind(schema.GroupVersionKind{
    Group:   "",
    Version: "v1",
    Kind:    "Secret",
})
if err := r.List(ctx, &list, client.InNamespace("my-ns")); err != nil {
    return err
}
这会使用请求元数据表示的独立watch,store不用保存完整Data、Spec或Status。对包含较大data的Secret,内存差距可能达到一个数量级;这是原文的经验性描述,不是对每个集群的保证。示例中List变量已表达列表形状,因此GVK的Kind设置为对象类型 Secret。
什么时候需要 APIReader
mgr.GetAPIReader() 返回直连API Server的client.Reader。常见用途有:
- 偶尔读一个没有维护informer的资源,不值得为一次操作建立长期watch。
- 在manager启动前初始化时读取;缓存客户端此时会报ErrCacheNotStarted。
- 通过
client.Continue分页遍历大型结果集。缓存客户端不支持真正Continue分页;Limit只是从缓存结果截取任意N个对象,不是稳定的“前N个”。
代价是真实网络请求和响应反序列化。绕过缓存不必然更便宜,应先测量。也不要设计成“缓存没有就悄悄回源”的混合逻辑:两种可见范围和不同时间点容易造成业务状态判断不一致。APIReader更不是消除所有滞后和并发竞争的万能开关。
为某类对象绕过客户端缓存读取
如果对象很大、读取很少,持续缓存并不划算,可以配置 client.Options.Cache.DisableFor:
mgr, err := ctrl.NewManager(cfg, ctrl.Options{
    Client: client.Options{
        Cache: &client.CacheOptions{
            DisableFor: []client.Object{
                &corev1.Secret{},
            },
        },
    },
})
此后,该manager客户端对Secret执行Get/List会直接请求API Server,避免因这些读取自动启用缓存。这比临时使用APIReader更全面,因为它改变了这类对象的常规读取路径。
重要编辑核验:原文将此概括为“整类禁用缓存、不会创建informer、没有事件”。准确边界是:DisableFor 控制客户端读取是否绕过缓存,不会自动取消已经显式注册的 Watches、Owns 或其他缓存使用者。如果仍显式监听Secret,相应informer和事件仍可能存在。只有不再有其他使用者时,才不会为了这些读取建立该类型的informer。若只需变更触发,可考虑metadata-only watch,同时用直连读取取得完整内容。边界可在v0.24客户端实现和Kind事件源实现中核对。
原文以external-secrets的Secret/ConfigMap缓存控制选项为实际例子。若完全不希望从API Server watch事件,还可以通过 WatchesRawSource、source.Channel 接入自己的事件源,例如内部队列、kubelet或自定义watch;这是较专门但有效的设计。
投入生产前逐项检查
- 用命名空间、标签和字段选择器限制缓存范围,尤其是Secret、ConfigMap、Event、Pod和Node等类型;确认所有共享使用者的可见范围需求。
- 对不需要的大字段使用Transform,同时审查裁剪后的对象是否会被全量回写。
- 每一个MatchingFields查询都应有对应IndexField,并处理查询错误。
- Predicate/EventHandler中修改对象前先DeepCopy;若关闭读路径的自动拷贝,也需承担相同责任。
- 让Reconcile保持幂等,即使连续多次收到相同状态也正确。
- 不要期待Update后缓存立即可读,也不要把一次实时读取当成完整并发控制。
- 初始化或刻意不缓存的读取采用APIReader或明确配置的直连路径;manager未启动时不要执行缓存读取。
- 只需元数据时考虑PartialObjectMetadata,避免保存不必要的spec/data/status。
- 延迟重试使用RequeueAfter,不占住worker等待。
把这些机制放回一张图里
Reflector、增量队列、Indexer构成缓存基础;Get/List通常读取内存,写操作直接发送到API Server,再由watch反馈。IndexField与MatchingFields以倒排索引降低查询成本;命名空间、选择器、metadata-only和Transform控制缓存规模。APIReader供那些缓存不适合服务的读取使用,但不代替一致性设计。
最值得记住的一点是:对已注册并预热的普通类型,Reconciler里的Get默认读取本地内存,第一次也一样。APIReader、DisableFor,以及特定的unstructured配置等是需要单独核对的例外。理解这些边界,才能判断控制器到底是在消耗本地内存、扫描时间,还是服务器的请求容量。
核验与执行边界:本稿覆盖原文所有正文段落、代码示例和SQL类比表,保留作者技术语境并明示上述补充。没有执行kubectl、编译控制器、创建资源、修改副本、裁剪实际对象或测试内存性能。代码中的省略号、忽略错误和反例均已标识;参数默认值应按实际锁定的controller-runtime/client-go版本核对。











暂无评论内容