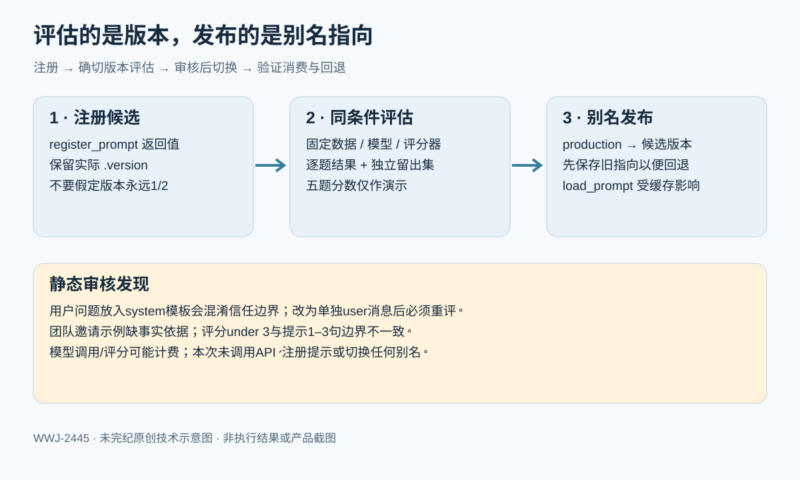



译自 MLflow 官方 Cookbook 的 Prompt Engineering Lifecycle,页面日期为 2026 年 3 月 18 日。源页没有可确认的个人作者,归属 MLflow Project。本文经授权完整整理注册、调用、评估、比较和别名发布流程,保留原代码与示例数据,再单列静态审查发现及修订。所有分数与回答均是源文示例,不是本次运行结果。
提示词不应只是一段散落在业务代码里的字符串。把它注册成不可混淆的版本,用相同数据集评价每次修改,再把通过验证的版本交给一个稳定别名,应用就能用同一引用加载不同候选,并在出现问题时明确回退目标。本例用虚构的 Acme Analytics 产品 FAQ 助手演示这个过程,问题涵盖账单、功能和故障排查。
准备依赖与实验环境
原文安装 MLflow 和 OpenAI Python SDK:
pip install mlflow openai这条命令没有固定版本。实际复现应在隔离环境选择彼此兼容的客户端与服务端版本,保存依赖记录,并确认本机 http://127.0.0.1:5000 已运行支持 Prompt Registry 的 MLflow 服务。示例没有启动服务的步骤;不能把设置 tracking URI 等同于已经拥有可用服务。远程服务还需配置 TLS、认证与权限,不应直接向外暴露演示端口。
模型调用需要用户自己的合法 API 权限;凭据应由 SDK 支持的安全配置方式读取,不能写进提示模板或文章。生成和评分都可能产生费用;模型名称和评分后端是否可用应按账户及所安装版本确认。本文没有安装依赖、读取真实密钥或调用模型。
注册最小提示词
先选定实验名称 prompt-engineering,将 FAQ 提示词注册为 product-faq-agent。模板只说明助手身份,并用双花括号声明问题变量;提交说明记录为什么新增该版本。
import mlflow
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mlflow.set_experiment("prompt-engineering")
prompt_v1 = mlflow.genai.register_prompt(
    name="product-faq-agent",
    template=(
        "You are a support agent for Acme Analytics, "
        "a SaaS platform for business intelligence.\n\n"
        "Answer the user's question: {{question}}"
    ),
    commit_message="Initial FAQ prompt — minimal instructions",
)
print(prompt_v1)
# PromptVersion(name=product-faq-agent, version=1,
#   template=You are a support agent for Acme Analytics...)
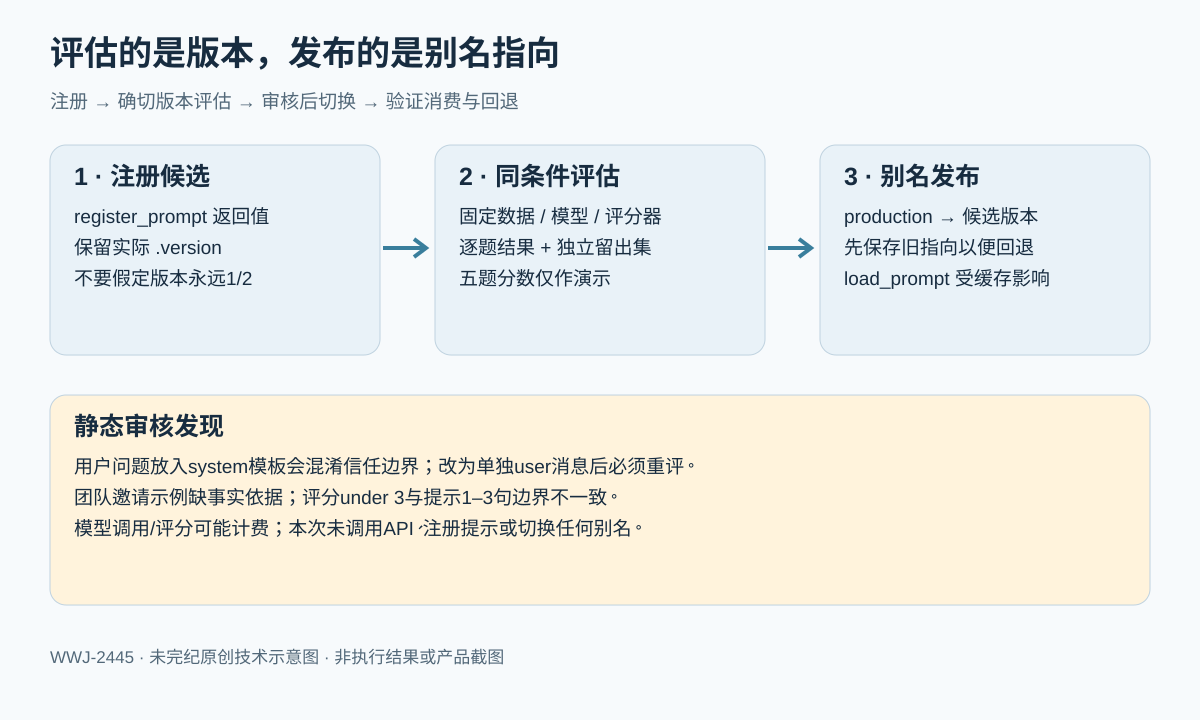
源文输出中的 version=1 假设此名称还没有其他版本。重复运行注册通常会产生新版本,已有项目更不一定从 1 开始。后文为了忠实呈现原流程保留源文的 1、2、3,但实际代码必须保存 register_prompt 返回的版本号,不能把章节顺序当作真实版本标识。
按版本加载并调用模型
原代码启用 OpenAI 自动日志,在函数上添加 MLflow trace,加载指定提示版本,然后用用户问题填充模板并调用聊天模型:
import openai
mlflow.openai.autolog()
oai_client = openai.OpenAI()
@mlflow.trace
def faq_agent(question: str) -> str:
    prompt = mlflow.genai.load_prompt(
        "product-faq-agent", version=1
    )
    system_message = prompt.format(question=question)
    response = oai_client.chat.completions.create(
        model="gpt-5.4-mini",
        messages=[
            {"role": "system", "content": system_message},
        ],
    )
    return response.choices[0].message.content
# Quick smoke test
print(faq_agent("How do I upgrade my plan?"))
原文使用 gpt-5.4-mini,本文保留该模型字符串以便对照,不声称已验证本账户访问权限。末尾的“快速冒烟测试”只是源代码中的调用,不是本文已经通过的测试。
静态风险:此时 question 被拼进 system 消息。来自用户的不可信内容因而与高优先级产品指令放在一起,增加提示注入风险。仅要求模型“忽略恶意输入”不足以证明安全;后文给出分离消息角色的编辑修订,并要求重新评估。
固定测试集和评分要求
测试集包含五个问题。每行在 inputs.question 中放输入,在 expectations.expected_response 中放参考回答。下面完整保留原题与英文参考文本,以免翻译参考答案时无意改变评价基准。
from mlflow.genai.scorers import (
    Correctness,
    RelevanceToQuery,
    Guidelines,
)
eval_data = [
    {
        "inputs": {"question": "How do I upgrade my plan?"},
        "expectations": {
            "expected_response": (
                "Go to Settings > Billing and click "
                "Change Plan to select a higher tier."
            ),
        },
    },
    {
        "inputs": {
            "question": "What's included in the Pro plan?"
        },
        "expectations": {
            "expected_response": (
                "The Pro plan includes unlimited dashboards, "
                "API access, and priority support."
            ),
        },
    },
    {
        "inputs": {
            "question": (
                "My dashboard is loading slowly. "
                "What should I do?"
            )
        },
        "expectations": {
            "expected_response": (
                "Try reducing the date range, removing "
                "unused widgets, or clearing browser cache."
            ),
        },
    },
    {
        "inputs": {
            "question": "Can I get a refund?"
        },
        "expectations": {
            "expected_response": (
                "Refunds are available within 14 days of "
                "purchase. Contact billing@acme-analytics.com."
            ),
        },
    },
    {
        "inputs": {
            "question": (
                "How do I connect a PostgreSQL data source?"
            )
        },
        "expectations": {
            "expected_response": (
                "Go to Data Sources > Add New, select "
                "PostgreSQL, and enter your connection string."
            ),
        },
    },
]
concise = Guidelines(
    name="concise",
    guidelines=[
        "Responses must be under 3 sentences.",
        "Do not include marketing language or upsells.",
    ],
)
def predict_fn(question: str) -> str:
    return faq_agent(question)
results_v1 = mlflow.genai.evaluate(
    data=eval_data,
    predict_fn=predict_fn,
    scorers=[Correctness(), RelevanceToQuery(), concise],
)
print(results_v1.metrics)
# Example:
# {'correctness/mean': 0.4,
#  'relevance_to_query/mean': 0.8,
#  'concise/mean': 0.6}
五题分别检查:如何在 Settings → Billing → Change Plan 升级;Pro 是否包含无限仪表盘、API 与优先支持;仪表盘慢时缩小日期范围、移除闲置组件或清浏览器缓存;购买后 14 天内的退款流程;以及通过 Data Sources → Add New 添加 PostgreSQL。这里的价格、功能、邮箱和政策都是示例产品事实,不应挪用于真实产品。
Correctness 参照预期答案评估正确性,RelevanceToQuery 关注与问题的相关性,自定义 Guidelines 要求简洁、避免营销或追加销售用语。源文列出的平均值 0.4、0.8、0.6 是标为 Example 的示例分数,不能当作本次或任何新环境必得的基线。
另一个细节值得修订:评分规则写 under 3 sentences,即少于三句,而稍后的提示词要求 1-3 sentences,允许三句。两者边界不同。应明确究竟允许两句还是三句,并同步修改提示和评分准则,不能让目标本身相互矛盾。
注册有产品知识和示例的第二版
第一版没有产品知识,所以容易给出含糊回答。原文第二版加入套餐、升级路径、退款政策、支持的数据源、添加流程和排障方法;要求只使用给定事实,不知道时转向支持邮箱;同时增加少量问答例子。
prompt_v2 = mlflow.genai.register_prompt(
    name="product-faq-agent",
    template=(
        "You are a support agent for Acme Analytics, "
        "a SaaS business intelligence platform.\n\n"
        "PRODUCT FACTS:\n"
        "- Plans: Free (2 dashboards), Pro ($49/mo, "
        "unlimited dashboards + API + priority support), "
        "Enterprise (custom pricing).\n"
        "- Upgrade path: Settings > Billing > "
        "Change Plan.\n"
        "- Refund policy: 14 days from purchase. "
        "Contact billing@acme-analytics.com.\n"
        "- Supported data sources: PostgreSQL, MySQL, "
        "BigQuery, Snowflake, CSV upload.\n"
        "- Adding a data source: Data Sources > "
        "Add New > select type > enter credentials.\n"
        "- Slow dashboards: reduce date range, "
        "remove unused widgets, clear browser cache.\n\n"
        "RULES:\n"
        "- Answer in 1-3 sentences.\n"
        "- Use only the product facts above.\n"
        "- If you don't know, say "
        '"I don\'t have that information. '
        'Please contact support@acme-analytics.com."\n\n'
        "EXAMPLES:\n"
        "Q: How do I add a team member?\n"
        "A: Go to Settings > Team > Invite Member "
        "and enter their email address.\n\n"
        "Q: Do you support Snowflake?\n"
        "A: Yes. Go to Data Sources > Add New and "
        "select Snowflake.\n\n"
        "Answer the user's question: {{question}}"
    ),
    commit_message=(
        "Add product facts, response rules, "
        "and few-shot examples"
    ),
)
print(prompt_v2.version)
# 2
产品事实将套餐写为 Free(两个仪表盘)、Pro(每月 49 美元,无限仪表盘、API 和优先支持)、Enterprise(定制价格)。支持 PostgreSQL、MySQL、BigQuery、Snowflake 与 CSV 导入。再次强调,这些是源文构造的演示资料,而非 MLflow 或任何真实 SaaS 的产品承诺。
few-shot 示例有一个来源一致性问题:“如何邀请团队成员”的操作路径没有列在上面的 PRODUCT FACTS 中,却作为正确答案出现,与“只使用产品事实”的规则存在冲突。真实项目应先向产品知识库核实,再把该事实明确补入,或删除这个例子;不能只因为示例写得流畅就当作事实。
使用同一评估集比较两个版本
接下来让新函数加载第二版,并重复相同的数据与评分器:
@mlflow.trace
def faq_agent_v2(question: str) -> str:
    prompt = mlflow.genai.load_prompt(
        "product-faq-agent", version=2
    )
    system_message = prompt.format(question=question)
    response = oai_client.chat.completions.create(
        model="gpt-5.4-mini",
        messages=[
            {"role": "system", "content": system_message},
        ],
    )
    return response.choices[0].message.content
def predict_fn_v2(question: str) -> str:
    return faq_agent_v2(question)
results_v2 = mlflow.genai.evaluate(
    data=eval_data,
    predict_fn=predict_fn_v2,
    scorers=[Correctness(), RelevanceToQuery(), concise],
)
print(results_v2.metrics)
# Example:
# {'correctness/mean': 0.8,
#  'relevance_to_query/mean': 1.0,
#  'concise/mean': 1.0}
原文示例分数为 correctness 0.8、relevance 1.0、concise 1.0。将两次运行结果放到同一表格,计算差值:
import pandas as pd
comparison = pd.DataFrame(
    {
        "v1": results_v1.metrics,
        "v2": results_v2.metrics,
    }
)
comparison["delta"] = comparison["v2"] - comparison["v1"]
print(comparison)
# Example:
#                            v1   v2  delta
# correctness/mean          0.4  0.8    0.4
# relevance_to_query/mean   0.8  1.0    0.2
# concise/mean              0.6  1.0    0.4
这张示例表相应给出 +0.4、+0.2、+0.4。比较时需要同时保留提示版本、模型及配置、评估集版本、评分器与运行 ID,否则相同列名也未必代表同样条件。五题只能用于演示流程,不能证明总体质量;反复用同一小集合调提示还可能过拟合。部署前应增加独立留出集、未知问题、恶意输入、错误产品事实和长上下文测试。
源文还建议到 http://127.0.0.1:5000 的 prompt-engineering 实验中,打开评估运行查看逐题分数与关联 trace。均值提升不代表每一题都改善;逐条检查有助于发现回归。trace 可能记录问题、提示词与模型输出,真实数据进入其中前应做好脱敏、访问控制和保留期限管理。
把评估通过的版本挂到稳定别名
原文将 production 别名指向第二版:
mlflow.genai.set_prompt_alias(
    name="product-faq-agent",
    alias="production",
    version=2,
)
这是会修改注册表状态并影响下游消费者的操作,不是只读查询,也不构成对任何生产环境的操作许可。本文只展示源文流程,没有执行该调用。实际发布前应保存旧指向、明确审批结果和回退版本,确认候选在预定评估条件下通过,再针对确切注册表修改。
应用通过 prompts:/name@alias 形式加载,从代码里移除硬编码版本号:
@mlflow.trace
def faq_agent_prod(question: str) -> str:
    prompt = mlflow.genai.load_prompt(
        "prompts:/product-faq-agent@production"
    )
    system_message = prompt.format(question=question)
    response = oai_client.chat.completions.create(
        model="gpt-5.4-mini",
        messages=[
            {"role": "system", "content": system_message},
        ],
    )
    return response.choices[0].message.content
# This always uses whichever version "production" points to
print(faq_agent_prod("Can I get a refund?"))
# "Refunds are available within 14 days of purchase.
#  Contact billing@acme-analytics.com."
原文说明别名更新后无需修改代码即可选用新版本。需要补上缓存边界:核查时的 MLflow load_prompt 文档支持 cache_ttl_seconds;别名默认缓存受 MLFLOW_ALIAS_PROMPT_CACHE_TTL_SECONDS 控制,当前文档默认 60 秒,设为 0 可绕过缓存。更早版本、应用持有对象的方式和额外缓存会影响刷新,因此不能承诺所有长期进程立即、原子地切换。发布时要验证实际消费到的版本,而不只看别名设置调用成功。
源文最后展示未来第三版经过注册和评估后,再用一次调用推广:
# After registering and evaluating v3...
mlflow.genai.set_prompt_alias(
    name="product-faq-agent",
    alias="production",
    version=3,
)
# faq_agent_prod() now serves v3 — no redeploy needed
这段以“After registering and evaluating v3…”为前提,文中没有给出第三版模板或评估结果。它只能说明未来发布动作的形式,不能解释成第三版已经存在、已经胜出或已经推广。
编者修订:隔离输入、使用返回版本,并保留回退
以下片段是对原代码的设计修订,不属于源文原样示例,也没有执行测试。它展示消息角色分离:把经过产品核验的固定事实放在系统模板,用户问题单独放在 user 消息。原 v2 模板必须先去掉末尾的用户插值,并修正团队邀请事实和句数规则;不能仅把原模板原封不动塞进这个函数。
# fixed_prompt 是另行注册、审核后的“只含固定系统内容”的提示词。
# 它不包含 {{question}},也不包含未经核实的产品事实。
def ask_with_fixed_prompt(question: str, fixed_prompt) -> str:
    response = oai_client.chat.completions.create(
        model="gpt-5.4-mini",  # 保留源例;使用前核实账户与模型权限
        messages=[
            {"role": "system", "content": fixed_prompt.template},
            {"role": "user", "content": question},
        ],
    )
    return response.choices[0].message.content or ""
角色分离减少了把不可信输入当系统指令的混淆,却不能单独阻止所有提示注入。对于可调用工具、检索或执行外部动作的应用,还需要明确权限与数据边界。本例只是 FAQ 回答流程,没有实现那些额外能力。
版本控制方面,应使用注册调用返回的对象,而不是猜测版本 1/2:
# prompt_v2 是前面 register_prompt 返回的真实对象
candidate_version = prompt_v2.version
candidate = mlflow.genai.load_prompt(
    "product-faq-agent", version=candidate_version
)
# 用 candidate 的确切版本完成评估,并保存运行ID和审批结果。
# 审批通过后,发布调用中的 version 应取 candidate_version。
# 回退同理应取发布前记录的旧版本,而不是硬编码“1”。
若将消息角色、产品事实或评分句数改动应用到实际代码,必须注册新的候选并重跑全部评价,不能继承源文旧分数。生产别名切换应是明确动作,旧版本指向与消费端缓存验证应一起记录。以上片段没有偷偷执行推广,也没有虚构“已批准”的状态。
后续阅读与版权
原文建议继续阅读 MLflow Cookbook 中的端到端 RAG 评估、内置评分器参考和 Prompt Registry 指南,把本例扩展到检索质量与生成质量的联合评估。正文全部十组代码和原文的示例输出均已保留;编辑增补与原例明确分开。
© 2025 MLflow Project, a Series of LF Projects, LLC. 原页未标个人作者;本稿不把项目开源许可证自动当作文章的授权依据,配图为原创示意图。审核仅限静态阅读,没有安装库、启动服务、注册提示、提交数据、调用模型、运行评分或改变别名;未发现其他问题不等于没有漏洞。











暂无评论内容