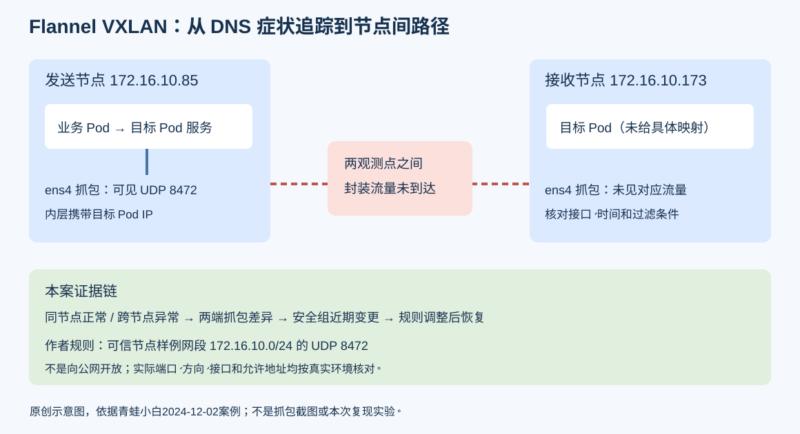



业务 Pod 无法解析 Service 域名,看起来像 DNS 故障,实际原因却可能位于节点之间的网络路径。青蛙小白在这篇案例中,先比较同节点和跨节点访问,再对 VXLAN 外层 UDP 流量进行两端抓包,最终结合安全组变更记录与恢复结果定位故障。
原作者:青蛙小白;原文发表于 2024-12-02,原文链接。以下保留案例完整排查过程、命令和观察结果,按 2026-10-05 核对到的正文整理。为避免把历史环境结论推广过度,文末单列编者技术校注;本次没有连接集群、抓取流量或修改规则。
问题:CoreDNS 在运行,域名却解析失败
作者接到用户反馈:集群中的业务 Pod 之间无法通信,在业务容器里对目标 Pod 的 Service 名称执行 nslookup 也无法解析。环境是 Kubernetes 1.29.2,容器网络为 Flannel,后端类型为 VXLAN。原文没有给出 Flannel 的具体版本。
用户检查过 CoreDNS Pod,均正常运行。作者先怀疑容器之间的网络存在问题,于是在业务 Pod 中绕过 DNS Service 地址,逐个直接向 CoreDNS 的 Pod IP 查询:
# foo-api.prod.svc.cluster.local 为目标 Service 名称
# 10.244.0.240 为其中一个 CoreDNS Pod IP
nslookup foo-api.prod.svc.cluster.local 10.244.0.240
逐一尝试各个 CoreDNS Pod IP 后仍无法解析。此时,“CoreDNS 进程正常”与“业务 Pod 能访问到 CoreDNS”还不是同一件事,排查于是转向节点间连通性。
用同节点对照缩小范围
为了验证跨节点网络的假设,作者在 10.244.0.240 这个 CoreDNS Pod 所在的主机节点上,手工启动了一个调试 Pod,并从该 Pod 发起相同查询:
nslookup foo-api.prod.svc.cluster.local 10.244.0.240这次得到以下结果:
Server:         10.244.0.240
Address:        10.244.0.240:53

Name:   foo-api.prod.svc.cluster.local
Address: 10.105.21.231
同节点能解析,说明这个 CoreDNS 实例确实能响应查询,故障更可能与跨节点的 Pod 通信有关。为进一步排除只影响 DNS 的可能,作者查看目标业务服务的所有 Endpoint:
kubectl get endpoints foo-api -n prod
NAME      ENDPOINTS                           AGE
foo-api   10.244.2.80:8080,10.244.3.47:8080     279d
在与目标 Pod 相同的主机节点上,直接访问其 Pod IP 与端口能够返回结果:
curl http://10.244.2.80:8080
<some response>
换到其他主机节点,则连接失败:
curl http://10.244.2.80:8080
curl: (7) Failed to connect to 10.244.2.80 port 8080: Couldn't connect to server
这里的 <some response> 是原文保留的响应占位说明,作者没有公开实际业务响应内容。两组对照共同表明,故障不仅表现为 Service 名称解析失败,直接访问跨节点业务 Pod 也受影响。
检查 Flannel 和节点本机规则
作者接着检查各节点的 Flannel Pod,发现它们均正常运行。该集群使用 VXLAN 后端,Pod 数据包经 UDP 封装后在节点之间传输;本案观察的端口是 UDP 8472。
再查看各节点 iptables 规则,没有发现针对 UDP 8472 的限制,于是怀疑节点外部的虚拟化平台安全组。原文用 OpenStack 举例说明这类平台,并未确认该用户一定使用 OpenStack,也没有说明具体云供应商。
在两端同时观察 VXLAN 外层数据包
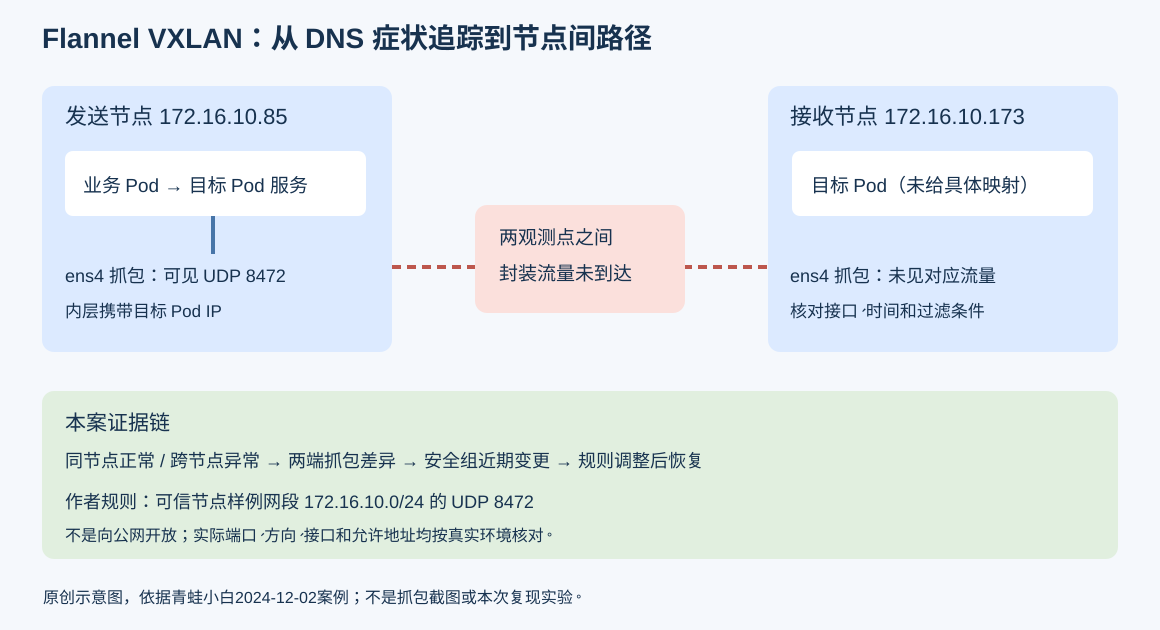
作者选取两台节点:172.16.10.173 与 172.16.10.85。首先在接收方向的节点 172.16.10.173 上,监听 Flannel 使用的 ens4 接口:
tcpdump -nn -i ens4 udp and port 8472 and dst host 172.16.10.173 -vvv这个过滤器限定 UDP、端口 8472,以及目的地址为本节点 172.16.10.173。-nn 避免把地址和端口转为名称,-vvv 输出较详细信息;接口名要以实际 Flannel 路由所走接口为准。
然后在发送节点 172.16.10.85 上执行原文的第二条抓包命令:
tcpdump -nn -i ens4 udp and dst host 172.16.10.173 -vvv编者校注:第二条命令只限定 UDP 与目的主机,没有 port 8472 条件。原文紧接着把它描述为抓取目的 8472 流量,并有 8472s 笔误;应以实际命令含义为准,在输出里核对外层目的端口确为 8472,以及内层目的 Pod IP 符合当前测试。不能把该过滤器捕获的所有 UDP 包都算作 VXLAN 证据。
接着,作者从 172.16.10.85 上的 Pod 发起请求,访问 172.16.10.173 上目标 Pod 的服务。原文将此处称作 HTTPS 服务,未给出这次请求的完整 URL;前面用作连通性对照的是 HTTP 8080 示例,两者不应被自动拼成同一个请求。
观测结果是:发送节点能捕获目的为 172.16.10.173:8472 的 UDP 数据包,封装内包含目标 Pod 的 IP;接收节点的 tcpdump 没有反应。原文没有给出实际 pcap 或逐包输出,因此本文不补造抓包截图、时戳或数据包字段。
结合变更记录与恢复结果确认安全组问题
两端的观测把故障范围缩小到所选发送与接收观测点之间。作者随后让用户检查虚拟化平台安全组,确认最近发生过规则调整,再加入一条允许 172.16.10.0/24 范围 UDP 8472 通信的规则。
原文报告,增加规则后跨节点 Pod 通信恢复正常。因此本案的结论建立在一组连贯证据上:同节点正常、跨节点异常;发送侧可见封装包、接收侧未见;近期有安全组变更;调整相应规则后恢复。不能只拿“这边有包、那边没包”这一项,就认定所有类似事件都是安全组引起。
将案例方法用到自己的环境时
第一,端口和后端必须核实。Flannel 上游后端文档 说明 VXLAN 的 Port 可配置,Linux 默认使用内核默认值(当前为 8472),Windows 必须使用 4789。本文的 8472 是本案 Linux Flannel VXLAN 环境的条件,不是所有 VXLAN 实现永远固定的端口。还要确认是否启用了影响封装路径的设置,例如同子网 DirectRouting。
第二,抓包结论只覆盖实际观测路径。接口选错、过滤器过窄、路由走了别的接口、时间窗口不一致或下层转发异常,都可能产生“一端看到、另一端没看到”的现象。应先确保两边观察的是同一次业务测试,再把节点路由、本机防火墙、虚拟交换和安全组等环节逐一纳入判断。本案的规则变更记录与修改后恢复,是定位到安全组的重要补充。
第三,172.16.10.0/24 只是作者的拓扑示例。实际允许范围应限制到可信 Kubernetes 节点地址,并按平台规则检查必要的双向流量;不要为了排错把 UDP 8472 面向公网或无关网段开放。创建调试 Pod、抓包和安全组修改都需要相应管理授权。详细抓包可能含业务地址和负载,留档与共享前应脱敏。
这次案例的价值在于逐层缩小问题范围:DNS 症状先用直连 CoreDNS 验证,再用同节点/跨节点业务 Pod 对照,最后观察外层隧道包并结合基础设施变更记录。本文保留的是原作者的历史观察和恢复结论;本次只做完整正文核对与静态审查,没有复现实验,也没有改变任何网络策略。











暂无评论内容