


原文:The scikit-learn developers,Test with permutations the significance of a classification score。本文按核验时显示的 scikit-learn 1.9.1 文档,经授权完整翻译整理;示例代码为 BSD-3-Clause,许可证随附。
一个分类器在交叉验证中取得了不错的分数,是否意味着它利用了特征与标签之间的真实关联?本例使用 permutation_test_score,通过反复置换标签,评估交叉验证分数的统计显著性。
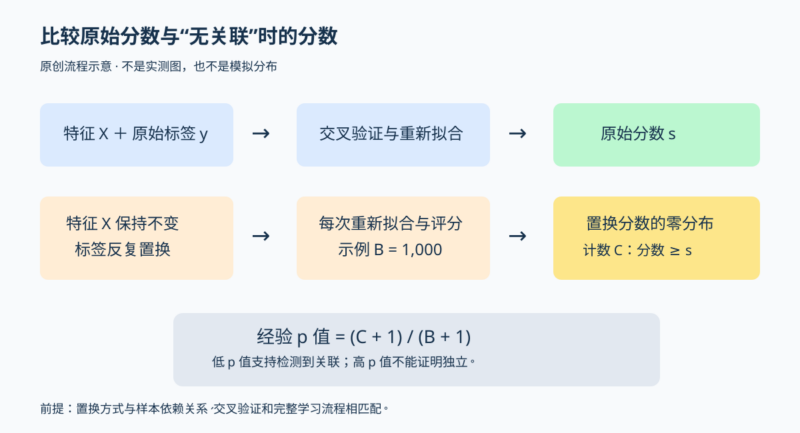
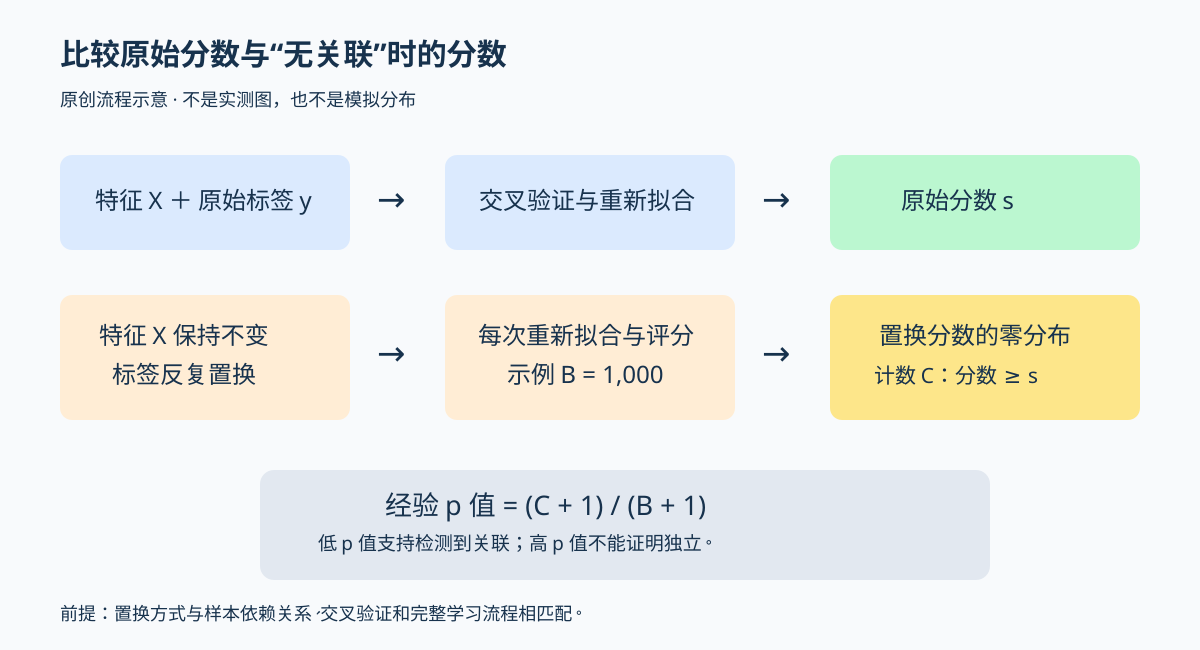
思路是固定特征、打乱标签,每次都重新训练和评估分类器。这样获得的分数构成零分布,用来描述“特征与标签没有关联”时,这套学习流程可能取得怎样的结果。再将未打乱标签时的原始分数与它比较,得到经验 p 值。
准备真实特征与随机特征
Iris 数据集包含三种鸢尾花的测量数据。本例用这些测量值预测花的类别:
# Authors: The scikit-learn developers
# SPDX-License-Identifier: BSD-3-Clause
from sklearn.datasets import load_iris

iris = load_iris()
X = iris.data
y = iris.target
为了对照,再生成 20 个随机特征。样本数与 Iris 相同,类别标签仍使用 y,但生成随机特征的过程不依赖类别:
import numpy as np

n_uncorrelated_features = 20
rng = np.random.RandomState(seed=0)
# 样本数与 Iris 相同,每个样本有 20 个随机特征。
X_rand = rng.normal(size=(X.shape[0], n_uncorrelated_features))
这形成两组对比:一组是真实的 Iris 特征与标签,二者存在较强关联;另一组是独立生成的随机特征与 Iris 标签,按生成机制预期不存在关联。有限样本中仍可能偶然出现看似可用的模式,这正是需要统计检验的原因。
构造置换分数的零分布
分类器使用线性核 SVC,每轮以准确率作为评价指标。交叉验证为打乱样本顺序的两折分层划分,每组数据做 1,000 次标签置换:
from sklearn.model_selection import StratifiedKFold, permutation_test_score
from sklearn.svm import SVC

clf = SVC(kernel="linear", random_state=7)
cv = StratifiedKFold(n_splits=2, shuffle=True, random_state=0)

score_iris, perm_scores_iris, pvalue_iris = permutation_test_score(
    clf, X, y, scoring="accuracy", cv=cv, n_permutations=1000
)

score_rand, perm_scores_rand, pvalue_rand = permutation_test_score(
    clf, X_rand, y, scoring="accuracy", cv=cv, n_permutations=1000
)
返回值分别是未置换标签时的交叉验证分数、每次置换后得到的分数数组,以及经验 p 值。在每次置换中,特征保持不变,只改变标签与样本的对应关系,然后重新拟合与评分。
按官方 API 的定义,若 C 次置换得到的分数大于或等于原始分数,置换次数为 B,则 p = (C + 1) / (B + 1)。这个加一修正意味着 1,000 次置换的最小可报告 p 值是 1 / 1001,而不是零。原文用“达到或超过原始分数的比例”作直观说明,此处补足实现采用的公式。
p 值很小,说明在此零假设及检验设计下,取得至少这么高分数的情况少见。它不是“零假设为真的概率”,也不是分类器预测正确的概率。
真实 Iris 数据:原始分数远离零分布
原文用直方图表示置换分数的分布,并用红色虚线标出原始数据的分数。纵轴采用概率密度,而非每个柱子的直接概率:
import matplotlib.pyplot as plt

fig, ax = plt.subplots()
ax.hist(perm_scores_iris, bins=20, density=True)
ax.axvline(score_iris, ls="--", color="r")
score_label = (
    f"Score on original\n iris data: {score_iris:.2f}\n(p-value: {pvalue_iris:.3f})"
)
ax.text(0.7, 10, score_label, fontsize=12)
ax.set_xlabel("Accuracy score")
_ = ax.set_ylabel("Probability density")
官方示例中,真实 Iris 数据的分数明显高于打乱标签后的分数,p 值因此很低。这个结果支持这样一种判断:数据中存在特征与标签之间的关联,而且所选分类器能够利用它。在适当的显著性阈值下,可以据此拒绝零假设。
这里引用的是原文对其图形的解释,本文没有重新运行示例,也没有把原文图上的数值伪装成本地实验结果。图中文字的位置是为原例手工设置的;如果更换数据,可能需要调整。
随机特征:原始分数落在常见范围内
对随机特征也绘制同样的图:
fig, ax = plt.subplots()
ax.hist(perm_scores_rand, bins=20, density=True)
ax.set_xlim(0.13)
ax.axvline(score_rand, ls="--", color="r")
score_label = (
    f"Score on original\n random data: {score_rand:.2f}\n(p-value: {pvalue_rand:.3f})"
)
ax.text(0.14, 7.5, score_label, fontsize=12)
ax.set_xlabel("Accuracy score")
ax.set_ylabel("Probability density")
plt.show()
原例的随机特征置换分数与真实 Iris 特征置换后的分数处在相近范围,因为打乱标签会破坏已有的特征—标签对应关系。但随机特征在未置换标签时的表现也很差,因此其原始分数并不突出,得到较大的 p 值。这与随机数据的生成方式一致:该学习流程没有检测到可利用的关联。
编辑说明:原文将这一结果描述为“确认不存在关联”,并说没有结构时所有分类器都会有高 p 值。统计检验本身不能给出这样的绝对保证:高 p 值不能证明独立,无关联时也可能偶然得到小 p 值。本文按研究页要求将其改为“没有检测到可利用的关联”,以保留正确的推断边界。
高 p 值还有另一种可能:数据确实有结构,但选定的分类器无法利用它。换一个更适合的学习流程,结论可能不同。因此检验结果始终与所用分类器、特征处理、评分指标和验证方案有关,不能把某一次没有拒绝零假设,当成所有模型都无能为力的证明。
反过来,小 p 值也不保证分类器具有实用价值。原文引用的研究指出,即使数据中只有很弱的结构,置换检验也可能得到很小的 p 值。统计显著性、实际准确率、收益与部署价值应分别评估。
把检验用于真实项目时的条件
以下是研究页要求保留的技术边界补充,不是原例已经实现的额外实验。任意打乱标签需要满足零假设下的可交换性;若样本来自同一受试者、同一设备,或具有时间依赖,不能简单把所有标签混在一起置换。应根据数据生成方式设计分组或受限置换,以及与之匹配的交叉验证。API 提供分组相关能力,但它不能代替对实验设计的判断。
如果先用全部数据筛选特征或调参,再只对最后的分类器置换,就可能遗漏选择过程带来的偏差。涉及标签的特征选择、调参等步骤应纳入每次置换的学习流程;需要从训练数据拟合的预处理也应在交叉验证训练折内完成。若比较很多模型并挑选最小 p 值,还需要考虑多重比较。
示例使用固定随机种子支持复现;种子只是实验控制参数,并非密码学随机数或秘密。原文的页面生成环境报告脚本运行约 14.120 秒,这不构成其他机器的运行时间承诺。1,000 次置换需要重复拟合模型,大规模数据应先评估计算预算。
本文保留官方示例的训练与绘图参数,只翻译注释、补充 p 值公式并收紧统计措辞。所有代码仅经静态审查,没有执行,没有生成或验证性能数据。
参考资料与许可证
Ojala 与 Garriga,Permutation Tests for Studying Classifier Performance,Journal of Machine Learning Research,2010,卷 11。另参见 permutation_test_score 官方 API。代码原作者为 The scikit-learn developers,采用 BSD-3-Clause;完整版权及许可条款见随附 sources/LICENSE-BSD-3-Clause.txt。
原始版权与许可全文
BSD 3-Clause License

Copyright (c) 2007-2026 The scikit-learn developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.
* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.
* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.











暂无评论内容