


Slurm 的 accounting 不只是月底导出用量。它把作业与步骤的资源统计、账户归属、服务质量和资源限额连接起来。正确配置时,管理员既能查询正在运行和已经结束的作业,也能按一段时间汇总使用情况,并让数据库中的账户与限额规则参与调度。
本文经授权翻译整理自 SchedMD 官方文档 Accounting and Resource Limits,完整涵盖该页的部署前提、配置、账户维护、归档与统计解释。原页没有可确认的个人作者或单独发布日期;核验日期为 2026 年 10 月 5 日。文中命令只做静态检查,没有在集群、数据库或本地执行。
先区分采集、存储和完成记录
sacct 查询运行中与已结束作业的记录,包括任务信息;sstat 只查看运行中的作业;sreport 按时间区间生成汇总报表。任务之间的统计差异可以帮助识别负载不均,但这些工具能显示什么,取决于相应插件是否采集并保存了数据。
| slurm.conf 参数 | 职责 |
|---|---|
| AccountingStorageType | 控制详细作业及步骤信息的存储方式,本文采用 accounting_storage/slurmdbd。 |
| JobAcctGatherType | 控制资源用量的采集机制,原页列出 jobacct_gather/linux、jobacct_gather/cgroup 与不采集的 jobacct_gather/none。 |
| JobCompType | 保存基本完成信息,例如作业名、用户、节点、开始与结束时间、退出状态;可用文本文件、MySQL 或 MariaDB 等后端。 |
查询作业记录需要配置存储,查询作业内资源消耗还需要配置采集;sreport 则依赖数据库中的数据。只需基本完成记录的站点可选择较轻量的 JobComp 路径。用 JobCompType=jobcomp/filetxt 和 JobCompLoc=/var/log/slurm/job_completions 可以指定文件。日志应轮转:原文要求移动文件后、压缩前向 slurmctld 发送 SIGUSR2,使其重新创建日志文件;信号目标必须核实,本文不执行该操作。
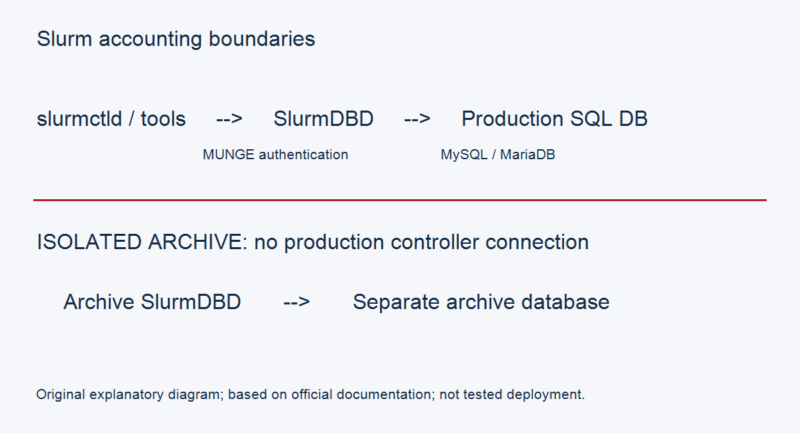
让 Slurm 命令直接连接数据库会使数据库用户名和密码需要暴露给控制器及相关查询工具,增加保护难度。SlurmDBD 作为中间服务,集中数据库访问,并通过缓存改善可用性和性能。它依赖 Slurm 的认证插件与 SQL 支持,但其所在机器不必同时运行其他 Slurm 守护进程;原页给出的 RPM 部署路径是在服务器安装 slurm 和 slurm-slurmdbd 包。
部署前先统一身份与认证
一个 SlurmDBD 可以收集多个集群的数据。计费记录按用户名归属,而通信认证依赖 UID,因此相同用户名应始终代表同一个人,需要认证的用户应在相关机器上保持一致的 UID。尤其是 SlurmUser,必须在所有集群中名称与 UID 一致;账户管理员也应保持一致。若启用了只允许用户查看自身记录的访问控制,所有用户都应满足这个条件。
默认只支持小写用户名;需要保留大写时,在 slurmdbd.conf 中配置 Parameters=PreserveCaseUser。SlurmDBD 还必须能解析用户名与 UID,可由本地用户数据库或 LDAP 等身份服务提供。缺少用户映射时,即使部署了 MUNGE,相关操作仍会认证失败。
官方推荐使用 MUNGE。单集群且 SlurmDBD 位于同一集群时,正常的 MUNGE 配置即可。跨集群时可以共用一个密钥,也可以让各集群使用各自的密钥,另设跨集群通信密钥。文档所述双密钥方案需要运行两个配置不同的 MUNGE 守护进程,分别用 --key-file 指定密钥、用 --socket 指定不同本地域套接字;这些套接字路径要在 Slurm 与 SlurmDBD 的配置中对应。
备用 SlurmDBD 通过 slurm.conf 的 AccountingStorageBackupHost 与 slurmdbd.conf 的 DbdBackupHost 配置。备用实例应位于另一台机器,访问同一个数据库,使用相同的 MUNGE 密钥,并具有一致的用户、UID 和 GID。这是服务接管方案,不等于历史数据归档方案。
数据库与编译条件
SlurmDBD 推荐连接 MySQL 或 MariaDB,并使用 InnoDB 支持事务回滚。构建 Slurm 时需要对应数据库的开发包。配置脚本通过 mysql_config 查找库和头文件,必要时用 --with-mysql_conf=/path/to/mysql_config 指定路径。原文展示的成功信息是发现 mysql_config,并成功构建 MySQL 测试程序;那是原文样例,并非本文构建结果。
第一次启动前,应按数据库版本和服务器资源检查下列参数:
| 参数 | 原文建议与条件 |
|---|---|
| innodb_buffer_pool_size | SQL 服务器可用内存的 5%–50%,且至少 4 GiB;过小可能影响大型数据库升级或旧记录清理。需结合整机资源配置。 |
| innodb_log_file_size | 建议为缓冲池大小的 25% 再除以 innodb_log_files_in_group;增大会增加异常关闭后的恢复时间。 |
| innodb_redo_log_capacity | MySQL 8.0.30 及以后使用此参数代替上述日志文件大小参数,建议为缓冲池的 25%。 |
| innodb_lock_wait_timeout | 900 秒,为可能较长的查询留出时间。 |
| max_allowed_packet | 至少 16M;若使用 AccountingStoreFlags=job_env,job_script,还必须大于 max_script_size。 |
| innodb_snapshot_isolation | 适用 MariaDB 时设为 OFF;MySQL 没有此变量。 |
MariaDB 在 10.6.18、10.11.8、11.0.6、11.1.5、11.2.4 和 11.4.2 相应分支引入了 innodb_snapshot_isolation,11.6.2 及以后默认开启。开启后,若其他事务改变了相关行,锁定读或写可能收到 ER_CHECKREAD,导致整个事务回滚,而 SlurmDBD 无法从这种失败中恢复并停止。因此原文明确要求关闭它。
原页的 my.cnf 示例使用 4096M 缓冲池、1024M 日志文件、900 秒锁等待和 16M 数据包,并在 [mariadbd] 段关闭快照隔离。不要把该示例整体复制到任意数据库版本:MySQL 8.0.30 之后的 redo 参数和日志文件数量都必须按上表处理。以下只读语句用于核对状态:
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';
SHOW VARIABLES LIKE 'innodb_default_row_format';
SHOW ENGINES;
SHOW TABLE STATUS IN slurm_acct_db;
SELECT default_collation_name
FROM information_schema.schemata
WHERE schema_name='slurm_acct_db';
SELECT table_name, column_name, collation_name
FROM information_schema.columns
WHERE table_schema='slurm_acct_db'
  AND collation_name NOT LIKE '%_ci';
MySQL 5.7 之前的默认行格式是 COMPACT,较新版本改为 DYNAMIC。某些情况下旧格式会让升级中的行过大,创建或转换表失败。原文建议出现相应 InnoDB 行大小错误时考虑把表调整为 DYNAMIC,并预留耗时;这不是本文已执行的修复。数据库与列的排序规则还必须不区分大小写,通常以 _ci 结尾;不支持改成大小写敏感规则,发现这种配置时 SlurmDBD 会在启动时报错。
配置 slurm.conf:记录数据与执行限额是两回事
本文采用 AccountingStorageType=accounting_storage/slurmdbd。把 AccountingStorageHost 指向 SlurmDBD,将 AccountingStoragePort 与其监听端口对齐,并为每个集群指定唯一 ClusterName。若使用另一套 MUNGE 服务,AccountingStoragePass 在这里表示其套接字路径,例如 /var/run/munge/global.socket.2,不是要求把 SQL 密码写进面向集群的公共配置。
AccountingStorageExternalHost 可以列出外部 SlurmDBD 的主机与可选端口,以便外部登记的集群通过 --cluster 或 -M 互相访问;未给端口时使用 AccountingStoragePort。缺失的集群会登记到外部服务;若那里已经存在同名的非 external 集群,则忽略该登记。
如果需要按与账户层级正交的标签统计工作负载,可设置 TrackWCKey,提交作业时用 --wckey 指定 Workload Characterization Key。是否严格执行数据库规则由 AccountingStorageEnforce 决定:
| 取值 | 行为 |
|---|---|
| associations | 拒绝没有合法关联的用户或账户运行作业。 |
| limits | 执行关联与 QOS 的资源限额,并隐含 associations;要限制谁能使用某个 QOS,还需 qos。 |
| qos | 要求作业显式或默认选择允许的 QOS,并隐含 associations;执行 QOS 限额仍需 limits。 |
| safe | 对设有 TRES-minutes 限额的关联或 QOS,仅在预期能完整运行时启动作业;隐含 associations 和 limits。避免因该用量限额在途中达到或随后变更而杀掉已启动作业,不是所有终止原因的豁免。 |
| nojobs | 不保存作业信息,并隐含 nosteps。 |
| nosteps | 不保存步骤信息,适用于关心限额但不关心利用率记录的环境。 |
| wckeys | 要求使用获准的 wckey,同时隐含 associations 并开启 TrackWCKey。 |
未设置此参数时,作业依各集群已有策略执行。仅把限额写入数据库不会自动生效;至少要启用 AccountingStorageEnforce=limits。更细的限制关系需参阅官方 Resource Limits。
配置 slurmdbd.conf:把数据库秘密留在受保护的一侧
slurmdbd.conf 只应存在于运行 SlurmDBD 的机器上,只允许该守护进程用户读取,因为它包含数据库登录信息。主要配置分成两组:
| 参数 | 含义 |
|---|---|
| AuthType / AuthInfo | 推荐 auth/munge;若用第二套 MUNGE,AuthInfo 指向该套接字。 |
| DbdHost / DbdPort | SlurmDBD 主机名及端口;主机名按原文用非完整域名的节点名。端口通常为 6819,须与 AccountingStoragePort 一致。 |
| LogFile / PluginDir | 日志绝对路径与以冒号分隔的插件目录;未设日志路径时使用 syslog。插件默认位于构建前缀下的 lib/slurm。 |
| SlurmUser | 守护进程运行用户。原页默认是 root,但建议明确使用专用非 root 用户,并保持跨集群身份一致。 |
| StorageHost / StoragePort | 数据库所在主机与端口,也可用 unix:/path/to/socket;大型系统建议数据库另机部署。 |
| StorageLoc | 数据库名,默认 slurm_acct_db;名字不能带 /,否则退回默认值。 |
| StorageType | 必须为 accounting_storage/mysql,适用于 MySQL 与 MariaDB。 |
| StorageUser / StoragePass | 数据库账号与密码,应与 SQL 端授权一致并受文件权限保护。 |
若 SlurmDBD 的非 root 运行用户不同于 slurmctld 的配置用户,原文要求将其加入 accounting,授予 AdminLevel=Admin,并重启 slurmctld。该权限很大,不能把它当作省略身份规划的通用捷径。
JobComp 路径与此独立。目前完成记录不通过 SlurmDBD 保存。使用 accounting storage 后,另外开启 JobComp 往往重复。若确有需要,JobCompHost、JobCompPort、JobCompUser、JobCompPass 面向数据库;JobCompLoc 面向文件;JobCompType 可选原页的 jobcomp/mysql 或 jobcomp/filetxt;JobCompParams 给插件传文本。由于直接数据库路径的密码保护困难,原文不推荐这种方式。
建立数据库账号并启动服务
Slurm 会创建需要的表,但管理员应先为它创建专用数据库与 SQL 用户,并赋予该数据库范围内的权限。原页保留了 MySQL 5.0.51a 的旧控制台记录,以及 GRANT ... IDENTIFIED BY ... WITH GRANT OPTION 写法;这些不是现代 MySQL 的通用配置方法。下面保留同页“先 CREATE USER、再 GRANT”的思路,并做明确编辑:由管理员先建库,避免全局 *.* 授权;将原文的弱示例密码替换成不能直接投入生产的占位文本,去掉转授权权限。
-- 仅为管理员配置示例;须先确认这是目标实例且对象尚未存在。
CREATE DATABASE slurm_acct_db;
CREATE USER 'slurm'@'localhost'
  IDENTIFIED BY '<由安全流程生成并替换的强密码>';
GRANT ALL ON slurm_acct_db.* TO 'slurm'@'localhost';
远程部署时,SQL 用户的 host 部分要匹配数据库实际看到的连接来源,不是机械替换为数据库服务器自身名称;相应用户也应先创建,再授权。不要复用原文的 password、some_pass,也不要把真实密码贴进工单、代码仓库或可被记录的共享终端。
确认 InnoDB、用户授权、数据库、MUNGE 与文件权限之后,才能启动 SlurmDBD 及其余 Slurm 服务。原文示例直接运行 /usr/sbin/slurmdbd,或使用旧式 /etc/init.d/slurmdbd start;实际应按安装包的服务管理方式操作,不应在已有实例旁重复启动。排错可提高 -v 的详细程度;经 slurmdbd 命令手册 核对,-D 表示前台运行并将日志复制到标准输出,本文修正了原文把它称为 daemon mode 的措辞。
从直接 MySQL 插件切换到 SlurmDBD 前,要核实集群已在数据库中登记。可用 sacctmgr list cluster 查看,缺失时添加。不要把插件切换与 Slurm 版本升级合并为一次变更。原文后段说明从 20.02 起 slurmctld 启动时可自动添加缺失集群,但账户关联仍需创建;显式检查仍然必要。
SlurmDBD 暂时不可用时,slurmctld 使用内部缓存,并在关闭时保存、启动时恢复本地缓存。已有账户与限额可依据最后一次通信的状态继续使用,作业与步骤记录也会排队等待回传。但首次启动没有缓存,必须能连接 SlurmDBD;停机过久、排队超过上限时,消息会开始丢弃,因此缓存不是无限的数据持久保证。
按集群、账户、用户的顺序建立关联
关联由 cluster、account、user,以及可选 partition 组成。创建顺序必须是先集群,再账户,最后用户。以下保留官方样例名;它们是说明用途的变更命令,并未执行。
sacctmgr add cluster snowflake
sacctmgr add account none,test Cluster=snowflake \
  Description="none" Organization="none"

sacctmgr add account science \
  Description="science accounts" Organization=science
sacctmgr add account chemistry,physics parent=science \
  Description="physical sciences" Organization=science

sacctmgr add user brian Account=physics
sacctmgr add user da DefaultAccount=test
账户可用逗号一次添加多个。若省略 Cluster,默认添加到全部已定义集群;也可列出多个集群。Parent 指向已存在的父账户,形成任意深度的层级;账户名必须唯一,不能在不同分支重复代表不同账户。Description 和 Organization 有助于后续报表,原文命令显式提供这两项;选项说明中 Description 默认账户名,Organization 默认继承父账户,父级为 root 时取账户名。
启用 associations 后,用户 da 可使用 test 以及以后显式为他建立的其他账户关联;不能理解为将来新建任何账户都会自动获得权限。不指定账户提交时采用 DefaultAccount。用户还可通过 Partition 建立分区特定的关联。
集群的基本选项是 Name。用户选项包括 Account、Cluster、DefaultAccount(创建时要求有默认值)、启用 wckey 时的 DefaultWCKey、Name、改名用的 NewName、Partition 与 AdminLevel。AdminLevel=None 表示普通用户;Operator 可添加、修改、删除数据库对象及其他 operator,并可在相应 slurmctld 上查看 PrivateData 限制的信息、管理 reservation;Admin 还可以像 Slurm 用户或 root 一样修改受其服务的 slurmctld。授予管理级别必须依据实际职责。
修改与删除:先确认筛选范围
sacctmgr 使用类似 SQL 的 set、where 结构。下例会把所有默认账户为 test 的用户改为 none;变更会发送给相关 Slurm 服务并即时可用。
# 批量变更示例:先核对命中用户与账户影响。
sacctmgr modify user set default=none where default=test
以下是有损管理示例,不能作为查询命令执行。 第一条删除所有默认账户为 test 的用户记录;第二条只移除 brian 在 physics 下的关联,其他账户关联仍保留。执行前必须确认筛选结果、保存必要的配置与数据库备份,并准备恢复方法。
# 删除示例,本文未执行。
sacctmgr remove user where default=test
sacctmgr remove user brian where account=physics
大多数删除会保留实体并标记为已删除;存在不到一天且未累计用量的实体可能被真正移除,用于清理录入错误。已有用量会汇总到父级。后来重建同名实体,不会因此自动找回原实体的用量。
尽早规划归档与清理
数据库应在启用 accounting 不久就确定保留周期,而不是等它过大后再追赶。Purge*After 会删除旧数据;配合 Archive* 可以在清理时生成以后可由 sacctmgr 加载的平面文件。单独 purge 并不自动保证有可恢复归档,设置前须确认备份、归档选项与恢复演练。
时间单位会影响清理节奏:PurgeJobsAfter=12months 在每月开始清理超过 12 个月的作业,PurgeJobsAfter=365days 则每天开始清理超过 365 天的作业。繁忙集群可通过合理节奏减少一次处理的数据量,但两者并非完全相同的时间定义。
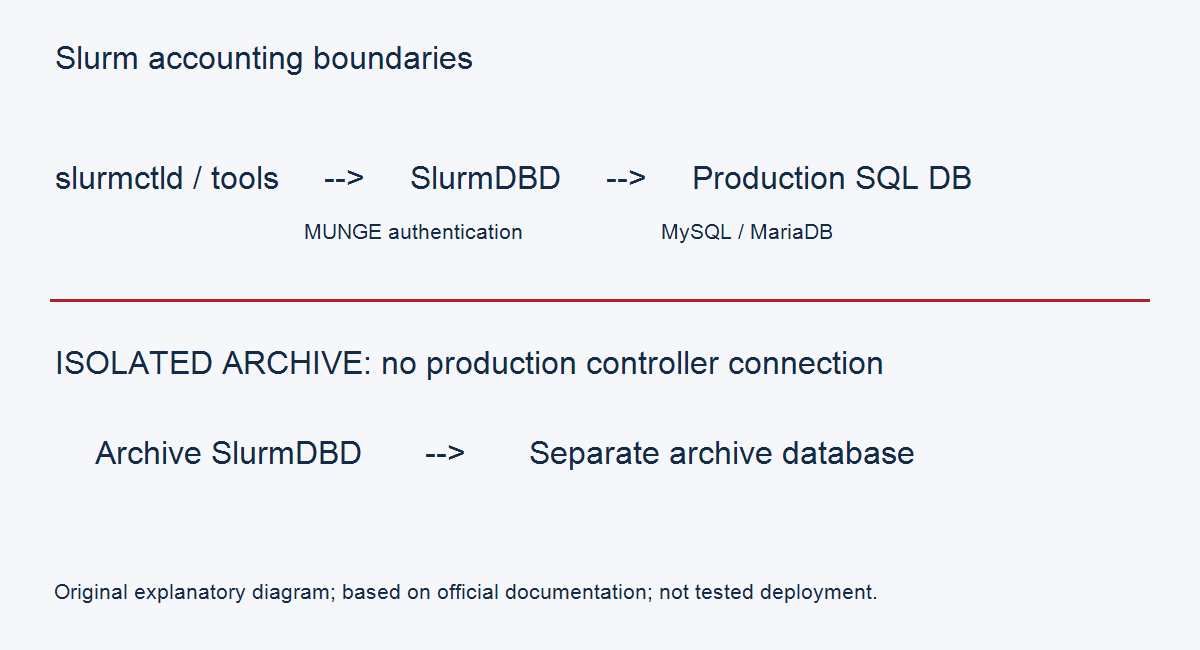
需要长期查询历史时,可设置独立的归档 SlurmDBD。它不能与生产服务器通信,理想情况下也使用单独的 MySQL/MariaDB 实例;生产 slurmctld 绝不能连接归档 SlurmDBD。为确保历史标识对应,官方要求用 mysqldump 迁移 Association、QOS 和 TRES 表:
# 占位符须替换;> 会覆盖同名输出文件,先确认目标文件路径。
mysqldump -u <slurm_user> -p <db_name> \
<cluster>_assoc_table qos_table tres_table > slurm.sql这条命令是元数据导出示例,-p 让客户端提示输入密码。不要把将由 Archive/Purge 产生的历史记录也用 mysqldump 混合迁移:两种方式的时间边界可能不同,后续加载归档时就可能缺记录或因重复记录而失败。导出的文件也包含集群元数据,应按敏感运维数据管理。
读懂统计值,避免把任务峰值相加当成同时用量
Slurm 面向并行计算,主要在 task 级采集。一个 job 包含 step,一个 step 又可能包含多个 task,每个 task 可包含一组用户进程。JobAcctGather 按 JobAcctGatherFrequency 或命令行 --acct-freq 的间隔采样 CPU、内存、能耗等 TRES;步骤开始与结束也会触发采样。不同指标会被直接记录或聚合计算。
运行时用 sstat 查询,若 5 个 task 各使用 1 GiB,TresUsageInTot 可显示 memory=5G;TresUsageInMax 表示步骤内某一 task 被观察到的最大内存峰值,此例为 memory=1G。TresUsageInMaxNode 和 TresUsageInMaxTask 指出节点与任务;内存也可通过 MaxRSS、MaxRSSNode、MaxRSSTask 查看。
作业完成、数据进入数据库后,用 sacct 查询时同名 TresUsage 字段的解释可能不同。内存的 TresUsageInTot 此时保存各 task 在各自任意时刻达到的峰值之和,这些峰值未必同时出现,不能直接解释为步骤某一时刻的总内存。它可用于求平均峰值 TresUsageInAve,再与最大值比较,发现异常高的任务。单任务时,该和等于 MaxRSS,可代表步骤被观测到的峰值。
能耗等指标可能按节点采集,无法精确归属单个 task;同节点的其他作业或进程也会影响数据。需要更多展示形式时可使用官方提到的 HDF5、InfluxDB profiling 插件。Grafana、InfluxDB 与 Prometheus 相关外部工具也可构建仪表盘,但原文明确说明这些第三方工具不由 SchedMD 维护或支持。
管理时由 sacct 查作业、sacctmgr 管集群与关联、sreport 做区间报表,三者通过 SlurmDBD 工作。把采集、身份、限额执行、保留策略和统计口径分别确认,才能让 accounting 数据成为可信的运维依据。











暂无评论内容