


原作者:Ceph authors and contributors。本文经授权合并整理官方 Basic Block Device Commands 与 Snapshots 全文。核验日期为 2026 年 10 月 5 日;两页均明确属于 Ceph 开发版文档。实际使用前须对照已部署发行版、客户端和镜像功能复核。
RBD 把块设备表示为 Ceph 集群中的镜像。通过 rbd,可以创建、列举、查看、调整和删除镜像,也能创建快照、回滚、克隆以及处理延迟删除。快照是镜像在某一时刻的只读逻辑副本;克隆则是在快照之上创建可写镜像,先共享父数据,发生写入后再记录自己的变化。
示例范围:以下命令仅用于理解操作语义,没有在本轮执行。所有操作均要求已有运行中的 Ceph 集群。为避免默认管理员和省略池名造成误操作,本文将大多数示例统一改为 --id qemu 及明确的 vms/镜像名;这是相对源文的编辑调整。实际账号、池、镜像和权限必须与自己的环境一致,示例不是可以顺序复制到生产环境的脚本。
先准备池与受限账号
块设备池需要先由管理员使用 ceph 创建,再初始化为 RBD 使用的池。创建池的详细参数取决于集群规划,原文指向池管理文档,而不是给出适用于所有集群的配置。初始化命令形式是:
rbd pool init <pool-name>未写池名时,rbd 默认使用名为 rbd 的池;未指定用户时,原文说明默认用户是 admin。日常操作应使用权限更少的块设备用户,把能力限制到所需池。
下面保留原文的账号授权示例:qemu 对 vms 有 OSD 读写能力,对 images 有 OSD 只读能力;其 manager capability 按原文限定在 images:
ceph auth get-or-create client.qemu mon 'profile rbd' osd 'profile rbd pool=vms, profile rbd-read-only pool=images' mgr 'profile rbd pool=images'该命令会创建或获取身份凭据,需要管理权限;输出包含 keyring,不应进入公开日志。管理员可将其保存到 /etc/ceph/ceph.client.qemu.keyring 等受控路径,并限制读取权限。上面的能力只是文档示例,不代表已经满足每种 manager 操作;需要按实际功能核对,不能为解决权限错误直接换回管理员。
启用默认的 CephX 认证时,可以明确指定用户和 keyring。--id qemu 与 --name client.qemu 是两种身份表达方式:
rbd --id qemu --keyring /path/to/secret [commands]
rbd --name client.qemu --keyring /path/to/secret [commands]
/path/to/secret 是凭据文件路径,不是凭据内容。原文也介绍通过 CEPH_ARGS 复用参数;使用时应避免把密钥本身写入可暴露的命令行或环境中。后文省略 keyring 路径,前提是客户端已能安全找到正确凭据。
创建、列举和查看镜像
在已经创建并初始化的池中建立容量为 1,024 MiB 的镜像:
rbd --id qemu create --size 1024 vms/foo
rbd --id qemu ls vms
rbd --id qemu info vms/foo
rbd --id qemu trash ls vms
ls 列举池中的镜像,info 查看指定镜像,trash ls 列举处于延迟删除状态的镜像。源文还展示 rbd ls、rbd info foo、rbd trash ls 等省略池名的形式,含义均是使用默认池。本文统一写出池名,是为了让目标更明确。
镜像命名还可能采用其他约定,例如名字里含有 userid/<uuid>,看起来容易与“池/镜像”混淆。实际操作前应根据列举与信息输出核对目标,不能只凭字符串外观判断。
扩容和缩容不是同一类风险
RBD 镜像采用精简配置。声明的逻辑最大容量,不等于立即占用相同数量的物理存储;物理数据会随写入分配。可用 resize 调整逻辑容量:
# 示例:将逻辑容量扩到 2,048 MiB。
rbd --id qemu resize --size 2048 vms/foo
扩容块设备之后,镜像内的分区、逻辑卷或文件系统是否扩展,仍需由相应工具处理,RBD 不会自动完成。
缩容会截断镜像末尾,可能永久丢失数据。只有在确认文件系统支持缩小、按正确顺序完成内部文件系统与分区调整、停用相关 I/O 并保留可恢复备份后,才考虑块设备缩容。下面是带风险标记的语法示例,不是本轮执行操作:
# 危险示例:仅在内部布局已安全缩小、当前镜像大于 1,024 MiB 时适用。
rbd --id qemu resize --size 1024 vms/foo --allow-shrink
原文扩容与缩容小节都写了 2,048;本文把缩容示例改为 1,024,并明确前置状态,避免把同一个目标大小误读为自动完成缩容流程。
快照首先要解决一致性
RBD 不理解镜像内部的文件系统。若没有与挂载它的操作系统和应用协调,快照通常只具有崩溃一致性,而不是应用一致性。数据库等应用可能还需要自己的刷盘或暂停机制。
官方建议在快照前暂停或停止 I/O,让文件系统处于内部一致状态。未静默写入的快照在重新挂载前可能需要文件系统检查。文件系统层可参考 fsfreeze,虚拟机可借助 qemu-guest-agent 协调冻结。冻结和解冻必须成对规划,并考虑失败后的恢复;此文没有把它们拼成未经验证的通用生产脚本。
除了 CLI,快照也可由 QEMU、libvirt、OpenStack、OpenNebula、CloudStack 等上层接口管理。具体一致性行为取决于所用接口和协调配置。
创建、列举、回滚与删除快照
快照名通过 @ 接在镜像名之后。以下示例先创建一个名为 snapname 的检查点,再列出镜像快照:
rbd --id qemu snap create vms/foo@snapname
rbd --id qemu snap ls vms/foo回滚会用快照覆盖镜像当前状态,快照之后的改动会丢失。先核对快照、停止相关写入并保存需要的当前数据,再考虑这条危险操作:
# 危险示例:覆盖当前镜像,不是创建新镜像。
rbd --id qemu snap rollback vms/foo@snapname
原文指出,回滚时间随镜像大小增加;从快照克隆通常更快,也是它推荐的返回既有状态的方法。克隆还能保留原镜像当前状态,但新克隆会继续依赖父快照,除非解除依赖。
删除某一个快照,或删除一个镜像的全部快照,分别使用:
# 危险示例:删除指定历史检查点;先核对依赖与保留策略。
rbd --id qemu snap rm vms/foo@snapname

# 危险示例:清除该镜像的全部快照,不是只删除一个。
rbd --id qemu snap purge vms/foo
受保护的快照不能直接删除,有克隆依赖的快照还必须先处理子镜像。快照删除后,OSD 的空间回收是异步的,过程称为 snaptrim,可在 ceph status 输出中体现。删除成功不意味着底层容量立即释放。
写时复制克隆与父子关系
Ceph 可以基于同一个只读快照创建多个写时复制(COW)克隆。比如先准备一个 Linux 虚拟机镜像,创建快照、保护快照,再为不同实例创建克隆。只读父快照提供稳定的起点,子镜像可以像其他 RBD 镜像一样读写、调整大小并继续派生。
文档中的“父”指被克隆的块设备快照,“子”指从该快照派生的镜像。子镜像记录父引用,其中包含池 ID、镜像 ID 和快照 ID,因此可以跨池克隆。共享依赖也意味着:不能把仍被子镜像使用的父快照随意删除。
源文限定克隆适用于 RBD format 2 镜像,并提到 Linux 内核客户端从 3.10 起支持克隆镜像。这些是功能出现的历史条件,不是对任意新旧客户端、镜像功能组合的兼容保证;实际集群应按发行版文档检查。
模板的四种用法
- 基础镜像模板:制作操作系统镜像并保存快照,例如 Ubuntu 22.04。后续更新镜像,再创建新的快照,用户可从不同历史版本派生。原文提及 apt 更新和升级命令作为例子;升级会改变来宾系统,应遵循自己的维护与回退流程。
- 扩展模板:从基础模板克隆后安装数据库、内容管理系统或分析软件,再对扩展镜像建立快照。扩展模板也可以持续更新。
- 模板池:把基础镜像和快照放在只读模板池中,允许用户读取并克隆到有写权限的工作池。模板池权限与子镜像所在池的权限分别配置。
- 迁移与恢复:利用跨池克隆关系组织镜像迁移或恢复;随后根据目标决定是否保留依赖或执行 flatten。
保护、克隆、检查子镜像、解除依赖
按照本文所核验的官方快照教程流程,先保护快照,再克隆:
rbd --id qemu snap protect vms/foo@snapname
rbd --id qemu clone vms/foo@snapname vms/bar
rbd --id qemu children vms/foo@snapname
children 用于列举依赖该快照的子镜像。跨池克隆时,源端仍使用父池、父镜像和快照,目标端填写另一个池及新的镜像名;相应读写权限必须同时满足。
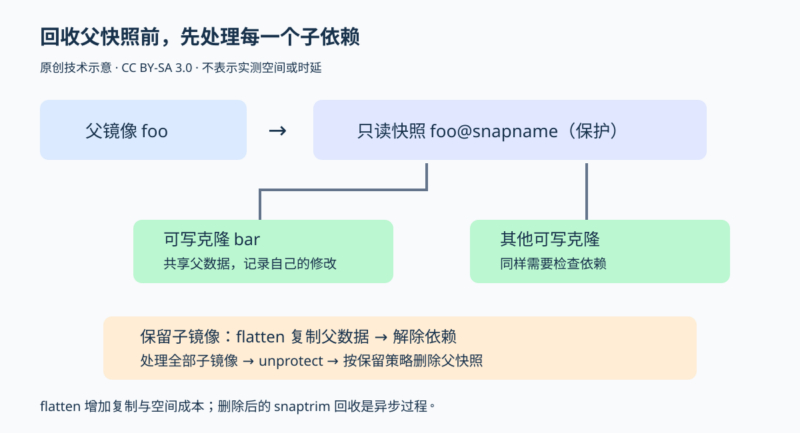
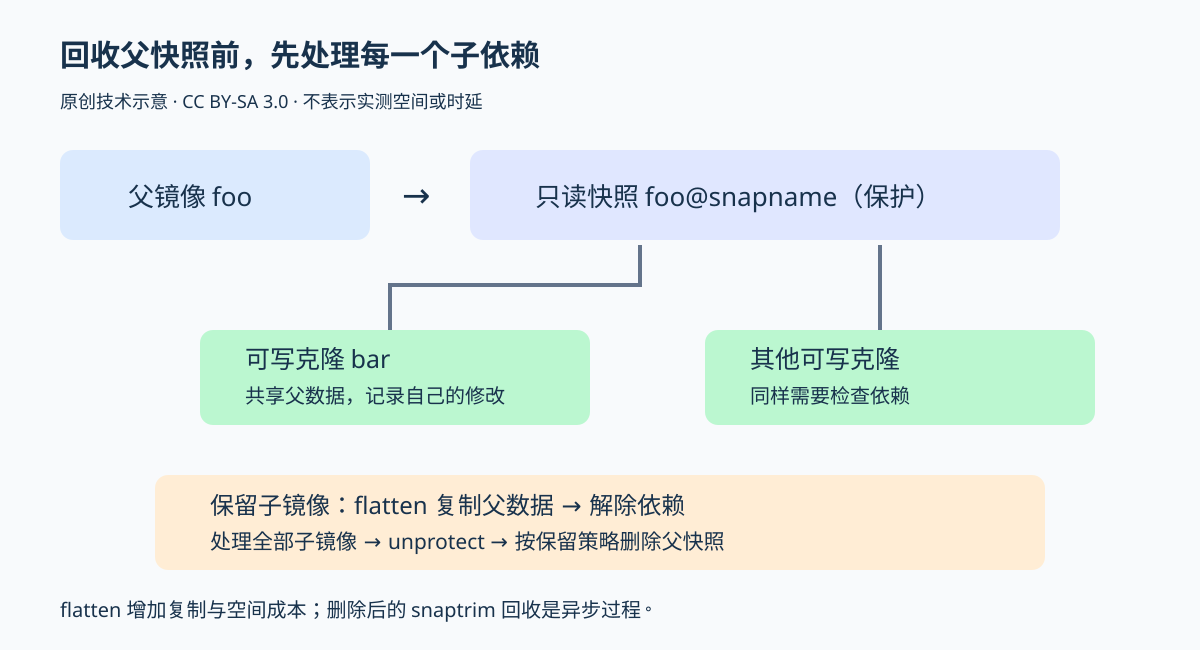
要删除父快照,需要先让每个子镜像摆脱依赖:要么删除不再需要的子镜像,要么对仍需要的子镜像执行 flatten。Flatten 会把父快照中所需的数据复制到子镜像,使其可以独立使用:
# 数据复制操作:预先评估耗时和额外空间。
rbd --id qemu flatten vms/bar
Flatten 的耗时随相关数据规模增长,完成后子镜像占用的空间通常比共享父数据时更多。要检查所有子镜像,不能只处理当前看到的一个。全部依赖解除后,才能取消保护,再按保留策略删除父快照:
# 仅在所有子依赖已解除并核验后执行。
rbd --id qemu snap unprotect vms/foo@snapname
# 危险示例:删除这个恢复点。
rbd --id qemu snap rm vms/foo@snapname
直接删除与延迟删除
不再需要的镜像可以直接删除。操作前应确认目标、消费者、快照和克隆依赖,并具备独立恢复手段:
# 危险示例:永久删除镜像。
rbd --id qemu rm vms/foo
如果希望延迟删除,可以先把镜像移入 trash:
rbd --id qemu trash mv vms/bar
rbd --id qemu trash ls vms
移入 trash 后,后续命令使用镜像 ID,而不是原来的镜像名。原文说明,即使镜像仍有快照或正被克隆引用,也可以移入 trash,但这些依赖未处理前不能从 trash 真正删除。
可以通过 --expires-at 指定允许删除的时间,默认是 now。到期前通常不能清除,--force 可以绕过时间限制;它不应该被当作日常回收选项,更不能据此推断它能安全绕过数据依赖。到期时间也不是对所有部署都有效的自动清理计划。
# 危险语法示例:把下列占位符替换为 trash ls 核对过的镜像 ID。
rbd --id qemu trash rm vms/<image-id>
Trash 只是同一存储系统里的延迟删除状态,不是独立备份。进入 trash 的镜像仍需容量与依赖管理,真正删除后不能把“恢复”命令当作撤销按钮。
恢复 trash 中的镜像
仍在 trash 中、尚未真正删除的镜像,可以按 ID 恢复到同一池,也可以在恢复时改名:
rbd --id qemu trash restore vms/<image-id>
rbd --id qemu trash restore vms/<image-id> --image new-name
源文还展示了省略池名前缀的恢复形式,它会针对默认池。无论哪一种,都应从 trash ls 核对 ID,并检查恢复名称是否符合预期。
一个稳妥的生命周期是:明确池与身份、核对镜像、协调一致性、创建快照、按需保护和克隆;回收时先梳理父子依赖与空间预算,再决定 flatten、删除子镜像、删除快照或延迟删除。回滚、缩容和永久删除会改变或丢失现有数据,不能与只读查询混在一起当作无风险操作。
版权:© 2016–2026 Ceph authors and contributors。原文采用 CC BY-SA 3.0;本中文整理稿及原创示意图同样按此许可提供,保留署名与相同方式共享要求。编辑改动包括合并两页、翻译整理、统一池与身份示例、修正缩容演示前置状态,以及补充一致性、凭据和数据丢失提示。本文未执行 Ceph 命令、未变更集群、未做恢复演练。











暂无评论内容