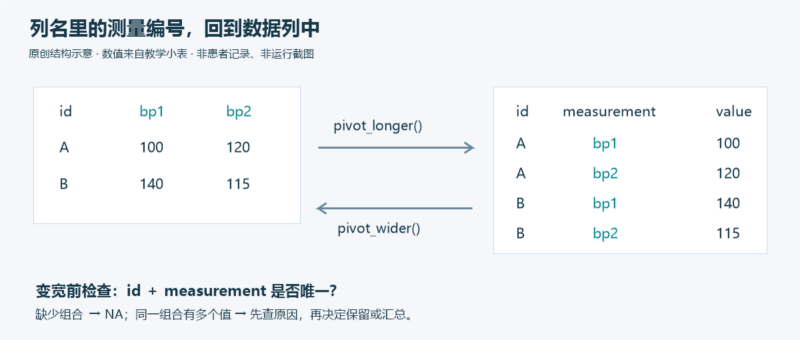



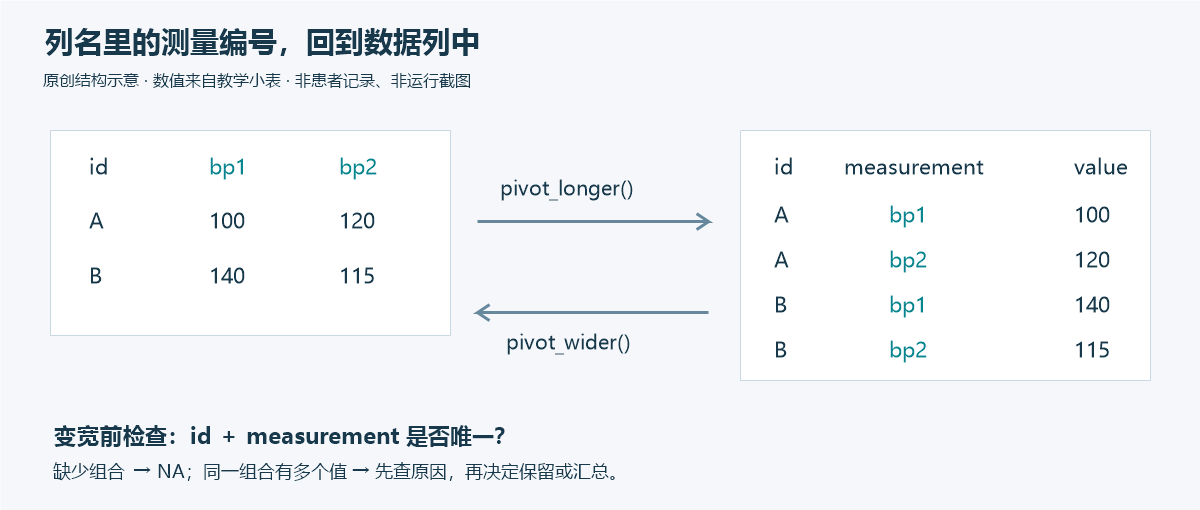
同一批数据可以有许多种摆放方式,但并非每一种都适合分析。把年份、周次或测量编号放进列名,很方便录入和展示;要分组、计算或画图时,这些信息往往需要回到普通列里。tidyr 的 pivot_longer() 和 pivot_wider() 就是用来完成这种重塑的工具。
本文完整整理自 R for Data Science 第二版第 5 章 Data tidying,作者为 Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund。原章未注明首次发表日期;本文于 2026 年 10 月 5 日核验滚动在线版。全书首页声明 CC BY-NC-ND 3.0;保留来源与作者归属。
整洁数据从观测单位开始
整洁数据(tidy data)的三个对应关系是:每个变量占一列,每个观测占一行,每个值占一个单元格。关键并不是表格看起来多长或多宽,而是先说清楚“变量”和“观测”分别是什么。
原章的 table1、table2 和 table3 都描述国家、年份、结核病记录病例数与人口。table1 直接把四个变量放在四列;table2 把病例数和人口放在同一个 count 列,再用 type 区分;table3 则把病例数和人口写成 745/19987071 这样的字符串。它们表达相同事实,分析成本却不同。
在 table1 中,一行是某国家某一年的观测。因为数值各在自己的列里,可以直接算比率、按年份求和,或画出时间变化。统一结构也让 dplyr、ggplot2 等工具更容易衔接:R 擅长对向量操作,而每一列恰好就是同类值组成的向量。
library(tidyverse)

table1 |>
  mutate(rate = cases / population * 10000)

table1 |>
  group_by(year) |>
  summarize(total_cases = sum(cases))

ggplot(table1, aes(x = year, y = cases)) +
  geom_line(aes(group = country), color = "grey50") +
  geom_point(aes(color = country, shape = country)) +
  scale_x_continuous(breaks = c(1999, 2000))
原章示例中,按年合计得到 1999 年 250740、2000 年 296920。这里的比率与病例数据只用于解释整理操作,并非医疗评价。若原始字段的含义不清楚,应询问数据生产者,不能只凭列名猜测。
可以先做两道练习:逐一说明三个样表中每行和每列代表什么;再设想如何对 table2 与 table3 计算相同比率。后一个任务至少要提取每国每年的病例数,找到对应人口,计算每万人比率,再把结果放回合适位置。即使尚未学会全部函数,也应先梳理这个过程。
列名本身是数据:把排行榜按周展开
billboard 包含 2000 年的歌曲榜单信息,共 317 行、79 列。artist、track、date.entered 描述歌曲;wk1 到 wk76 则把两个变量混在一起:列名记录周次,单元格记录排名。现在希望一行表示一首歌在某一周的排名。
billboard |>
  pivot_longer(
    cols = starts_with("wk"),
    names_to = "week",
    values_to = "rank"
  )
cols 选择需要展开的列,使用与 select() 相同的选择语法;这里也可选择除三个描述列之外的其他列。names_to 为原列名创建新变量 week,values_to 为原单元格值创建 rank。这两个新名字使用字符串,因为它们在输入数据中还不存在。
原章输出为 24092 行、5 列,即 317 首歌各对应 76 个周次。对仅在榜上停留数周的歌曲,宽表为了和其他歌曲共享相同列数,产生了许多 NA。原章将这里的这些值解释为表结构迫使出现的缺失,而不是排名尚未观测到。因此可以在转换时丢弃:
billboard_longer <- billboard |>
  pivot_longer(
    cols = starts_with("wk"),
    names_to = "week",
    values_to = "rank",
    values_drop_na = TRUE
  ) |>
  mutate(week = parse_number(week))

billboard_longer |>
  ggplot(aes(x = week, y = rank, group = track)) +
  geom_line(alpha = 0.25) +
  scale_y_reverse()
原章得到 5307 行。parse_number() 提取字符串中的第一个数值,让 wk1 变成数值 1;scale_y_reverse() 将较好的较小排名放在图的上方。原图显示,多数歌曲不会在榜上持续超过 20 周。
values_drop_na = TRUE 不是通用清洗开关。 如果 NA 表示真实观测缺失,删除行会改变数据含义。这里能够使用,是因为已经解释了该数据集的结构。原章正文按实际列列出 76 周,而脚注另写“最多跟踪 72 周”,两处不一致;本稿以可核对的列结构讲解转换,不据此推断歌曲完整在榜寿命。上面的分组也沿用原章 track,真实数据若有同名歌曲,应使用能唯一识别歌曲的组合标识。
理解变长过程中哪些内容被重复
用一个更小的教学表观察转换。A、B、C 各有两次血压测量,数值仅用于演示结构:
df <- tribble(
  ~id, ~bp1, ~bp2,
  "A", 100, 120,
  "B", 140, 115,
  "C", 120, 125
)

df |>
  pivot_longer(
    cols = bp1:bp2,
    names_to = "measurement",
    values_to = "value"
  )
转换后,A 对应 bp1 = 100 与 bp2 = 120 两行,B、C 同理,共 6 行。原本就是变量的 id 需要随着每个测量重复;bp1、bp2 两个列名成为 measurement 的值,并对每位对象重复;六个测量数值则逐行展开到 value,数值本身没有凭空增加或丢失。
一个列名含多个变量:同时拆出诊断、类别和年龄
世界卫生组织的 who2 示例有 7240 行、58 列,前两列为 country 和 year,其后 56 个列名类似 sp_m_014。列名以三个部分记录诊断分类、数据中的二元性别类别以及年龄范围;例如 014 表示 0–14 岁。单元格记录该组合的病例数,因此一共涉及六类信息。
who_longer <- who2 |>
  pivot_longer(
    cols = !(country:year),
    names_to = c("diagnosis", "gender", "age"),
    names_sep = "_",
    values_to = "count"
  )
names_to 现在提供三个列名,names_sep 指定分隔符。原章结果为 405440 行、6 列,并保留 count 中的缺失。age 保持类别编码;不要把 014 转成普通数字 14 后丢失其区间含义。
可以把它想成“先变长,再拆列名”,但 tidyr 能在一次调用中完成。如果列名没有稳定分隔符,names_pattern 可用正则表达式提取多个部分;使用前仍需核对所有列名是否符合模式,不能仅靠某一个示例推断全部命名规则。
列名同时包含变量名和取值:使用 .value
household 有 5 个家庭,列为 family、dob_child1、dob_child2、name_child1、name_child2。这里的 dob 与 name 是两个变量,而 child1、child2 是孩子编号。若硬把所有单元格塞进一个 value,日期与姓名就会被混合。
household |>
  pivot_longer(
    cols = !family,
    names_to = c(".value", "child"),
    names_sep = "_",
    values_drop_na = TRUE
  )
".value" 是特殊标记:对应的列名片段决定输出的值列名称,从而代替通常的 values_to。结果保留独立的 dob 与 name,另有 family 和 child,原章得到 9 行。child 的值仍是 child1、child2,并没有自动变成整数。
只有一个孩子的家庭在原宽表中也必须占有第二个孩子的列,因此本例删除的是这种结构性空位。多个值列的情形下,不能把其中一个字段缺失等同于该孩子不存在;应保留部分信息仍存在的观测,结合实际数据语义判断。
一项观测散落在多行:把指标展开成列
cms_patient_experience 示例记录机构的患者体验,输入为 500 行、5 列。研究单位是机构,但各类指标各占一行。可以先用 distinct(measure_cd, measure_title) 查看六类指标代码及说明。代码较短但不够直观,说明则太长;原章选择指标代码作为列名,实际分析可以另做简短易懂的名称映射。
cms_patient_experience |>
  distinct(measure_cd, measure_title)

# 先观察默认标识列的后果:
cms_patient_experience |>
  pivot_wider(
    names_from = measure_cd,
    values_from = prf_rate
  )
pivot_wider() 从已有列中取新列名和新单元格值,因此参数是 names_from 和 values_from。上面的结果仍有 500 行:没有指定 id_cols 时,未被用于新列名或值的列都会参与标识,随指标变化的 measure_title 也被保留,导致同一机构仍然分散在多行。
cms_wider <- cms_patient_experience |>
  pivot_wider(
    id_cols = starts_with("org"),
    names_from = measure_cd,
    values_from = prf_rate
  )
明确使用机构字段后,原章输出变为 95 行、8 列。这里的列选择依赖已知输入结构;若生产数据新增以 org 开头的描述字段,应重新核对它是否属于标识。id_cols 是对观测单位的声明,不是用于凑出预期行数的参数。
变宽怎样产生缺失,又怎样暴露重复键
下面的教学小表中,A 有三次测量,B 只有两次:
df <- tribble(
  ~id, ~measurement, ~value,
  "A", "bp1", 100,
  "B", "bp1", 140,
  "B", "bp2", 115,
  "A", "bp2", 120,
  "A", "bp3", 105
)

df |>
  pivot_wider(
    id_cols = id,
    names_from = measurement,
    values_from = value
  )
输出的列名来自 measurement 的不同值:bp1、bp2、bp3。输出行来自不同的 id。函数可以理解为先确定行与列,建立空表,再把已有值填入;B 没有第三次测量,所以 bp3 保持 NA。这说明变宽本身就可能把隐含缺失显式化。
反过来,若 A 的 bp1 在输入中有 100 和 102 两行,一个输出单元格就对应多个值。此时 tidyr 会给出警告并产生列表列。原章提示可以使用 values_fn = list 接受列表,或用汇总函数聚合;但这两者都不能替代对重复原因的调查。先定位冲突:
df_duplicates <- tribble(
  ~id, ~measurement, ~value,
  "A", "bp1", 100,
  "A", "bp1", 102,
  "A", "bp2", 120,
  "B", "bp1", 140,
  "B", "bp2", 115
)

df_duplicates |>
  group_by(id, measurement) |>
  summarize(n = n(), .groups = "drop") |>
  filter(n > 1)
本例会定位到 A 的 bp1,出现次数为 2。之后应判断是录入错误、漏了测量时间等标识,还是确实需要按某种业务规则汇总。不能为了消除警告随意取第一条或求平均;聚合会改变信息,必须有依据。
把转换结果当成需要验收的新数据
完成一次重塑后,至少核对观测单位、标识组合、行列数量、字段类型、缺失含义与数值是否按预期保留。检查病例数、排名和家庭示例的目的是验证结构,不是给现实对象作医学或质量结论。本文没有安装 R 包或执行任何示例,列出的尺寸和输出来自原章。
长表与宽表没有永远正确的一方。同一数据的“变量”定义可能随着分析任务变化;遇到难以表达的计算,先转换、计算,再重新整理也是合理做法。对于更复杂的重塑,可继续阅读 tidyr 的 Pivoting 文档;若关心理论背景,可参考 Hadley Wickham 的 Tidy Data 论文。











暂无评论内容