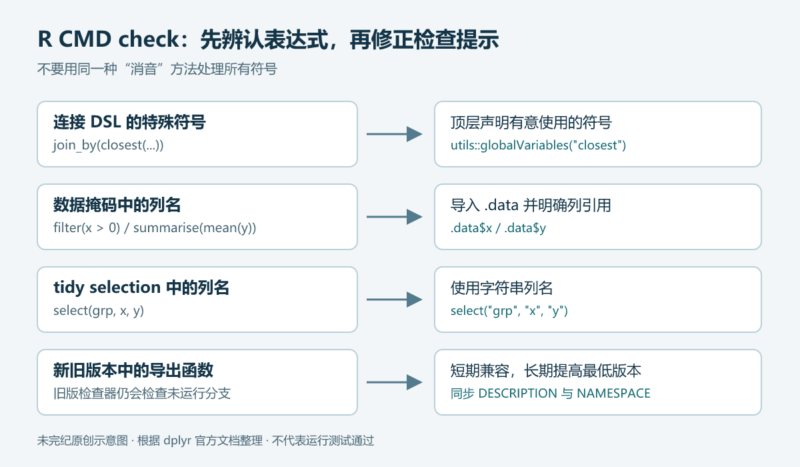



原文:dplyr 官方文档 Using dplyr in packages,源文件为 vignettes/in-packages.Rmd。页面未单独署名;项目开发者列有 Hadley Wickham、Romain François、Lionel Henry、Kirill Müller、Davis Vaughan。本文为获授权的中文翻译整理,译编:未完纪。
在交互式分析中写得很顺手的 dplyr 代码,放进 R 包后,可能收到 R CMD check 的 NOTE 或 WARNING。这不一定表示代码在运行时找不到列,而可能是静态检查器无法识别 dplyr 的数据掩码、列选择或连接表达式。另一个维护难点来自依赖升级:新旧版函数的接口不同,即使旧环境不会走到新代码分支,静态检查仍可能发现不存在的函数。
这篇文章面向在自己的 R 包中使用 dplyr 的作者,依次解释连接辅助符号、列名引用、多版本兼容、弃用接口和数据框子类扩展。核对日期为 2026 年 10 月 5 日;源站导航显示 dplyr 1.2.1。正文中的 0.5.0、0.7.0、1.0.0、1.0.10 和 1.1.0 是历史迁移节点,并非建议今天安装这些旧版本。
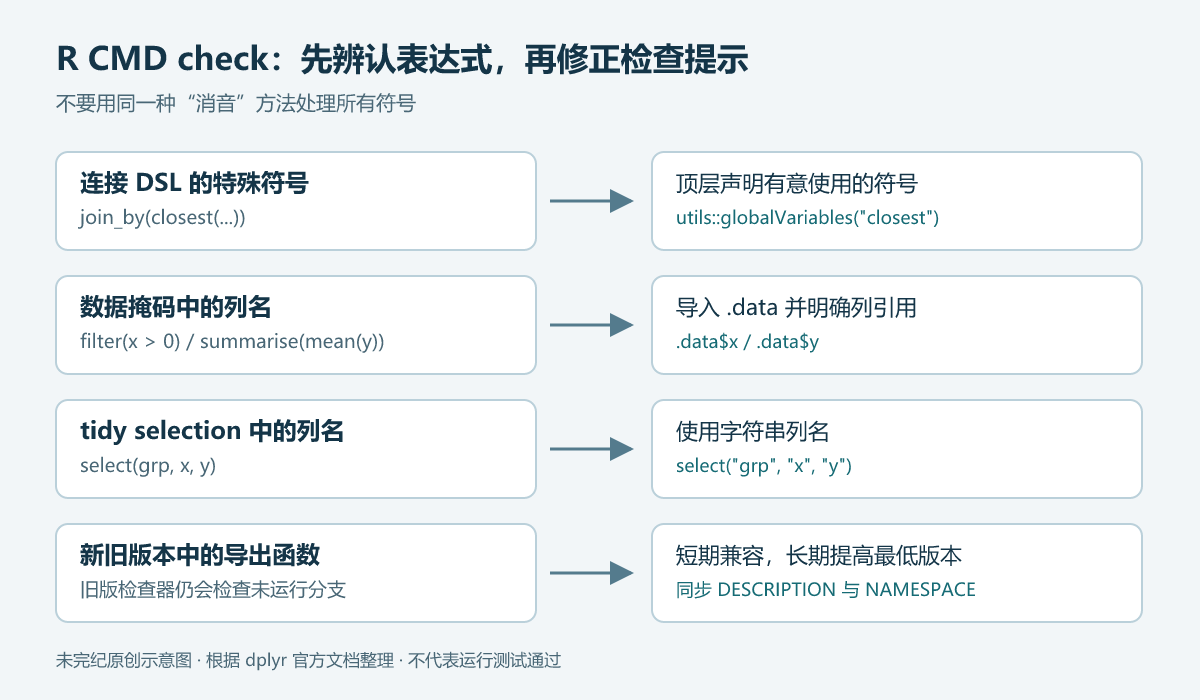
连接辅助符号:先分清 DSL 与普通函数
dplyr 1.1.0 引入了 join_by(),并支持 closest()、between()、within() 和 overlaps() 四种连接辅助表达式。join_by() 实现了一套描述连接条件的领域专用语言(DSL),会在内部解释这些调用。
其中,dplyr::closest() 并不是 dplyr 导出的普通函数。dplyr::between() 和 base::within() 恰好也是已有函数,但这不改变它们在连接 DSL 中的特殊含义。若在包内直接写 closest(),静态检查可能提示使用了一个不属于任何包的符号。
原文建议把下列声明放在包的一个 R 源文件顶层,即任何函数定义之外:
utils::globalVariables("closest")这项声明告诉检查器该符号是有意使用的,并不会创建或导出一个 closest() 函数。dbplyr 对 SQL 函数也采用类似做法,可参考原文链接的 dbplyr 符号声明示例。即使 utils 随 R 一同提供,包也可能仍需在 Imports 中声明它;可以使用:
usethis::use_package("utils")编辑说明:上面的 usethis 调用会修改包的依赖配置,应在自己的包项目内使用。不要把所有未定义符号一并登记来掩盖拼写错误;这个方法针对的是确实由 DSL 解释的符号。
数据掩码与列选择使用不同写法
下面是原文给出的函数。它选择三个列,过滤 x 为正数的行,按 grp 分组,然后计算 y 的均值和行数:
my_summary_function <- function(data) {
  data |>
    select(grp, x, y) |>
    filter(x > 0) |>
    group_by(grp) |>
    summarise(y = mean(y), n = n())
}
R CMD check 不知道这些 dplyr 函数采用 tidy evaluation,因而可能出现下列提示。此处转录的是原文的说明性输出,本次没有运行检查命令:
N  checking R code for possible problems
   my_summary_function: no visible binding for global variable ‘grp’, ‘x’, ‘y’
   Undefined global functions or variables:
     grp x y
解决时需要区分两种语义:在数据掩码表达式中,从 rlang 导入 .data,再用 .data$列名;在 tidy selection 表达式中,使用字符串列名。修订后是:
#' @importFrom rlang .data
my_summary_function <- function(data) {
  data |>
    select("grp", "x", "y") |>
    filter(.data$x > 0) |>
    group_by(.data$grp) |>
    summarise(y = mean(.data$y), n = n())
}
select() 负责选列,因此使用 "grp" 等字符串;filter()、group_by() 和 summarise() 的列引用则通过 .data 表达。@importFrom 是交给 roxygen2 处理的导入声明,实际包还需要正确声明 rlang 与 dplyr 依赖,并导入所用 dplyr 函数或使用明确的命名空间。
编辑说明:这些改写主要消除列引用的歧义,并没有改变缺失值处理。示例的 mean(.data$y) 仍使用默认 na.rm = FALSE。也不要在数据掩码里简单把所有裸列名换成字符串,否则可能改变运算含义。更完整的编程规则见 Programming with dplyr。
在破坏性变更期间同时支持两个版本
dplyr 尽量避免不向后兼容的变化,但有时需要通过接口调整简化实现或支持新能力。维护者理想的过渡方式,是让依赖包同时兼容已发布版本与开发版本。这样用户不必统一升级,CRAN 也无需协调大批包在同一时间发布。原文说明,dplyr 团队通常会在可能破坏下游兼容性的版本发布前提交修补 PR;如果补丁支持旧版,依赖包可先接受修补并发布。
最简单的兼容工具是版本条件分支。以下是原文保留的历史示例:
if (utils::packageVersion("dplyr") > "0.5.0") {
  # 新版本代码
} else {
  # 旧版本代码
}
在“当前发布版—下一个开发版”的过渡场景中,原文建议使用 > 当前版本,而不是 >= 下一个发布版本。例如当前发布版为 0.5.0 时,开发版可能是 0.5.0.9000。前一种比较能让开发版提前走到新分支。这里使用的是 packageVersion() 的版本比较,不应改写成普通字符串的字典序比较。
当新分支只是增加参数或处理不同返回值时,这往往足够;若新分支调用了旧版尚未导出的函数,情况就不同。例如:
if (utils::packageVersion("dplyr") > "1.0.10") {
  dplyr::reframe(df, x = unique(x))
} else {
  dplyr::summarise(df, x = unique(x))
}
用 dplyr 1.0.10 检查包时,检查器仍会看见 dplyr::reframe() 这个不存在的导出函数,即使那个分支不会运行。原文用间接取得函数的方式跨过这段过渡期:
if (utils::packageVersion("dplyr") > "1.0.10") {
  utils::getFromNamespace("reframe", "dplyr")(df, x = unique(x))
} else {
  dplyr::summarise(df, x = unique(x))
}
这属于版本迁移技巧,不是鼓励长期依赖未公开接口。原文紧接着强调:新版本已经进入 CRAN 后,可以删除临时分支,直接使用 reframe(),同时在 DESCRIPTION 中要求 dplyr (>= 1.1.0)。为更新依赖包而升级 dplyr,通常也能让用户得到相关修复和新功能。
导入对象换了包:条件 NAMESPACE
有时不能完全回避 @importFrom,例如为了定义方法而导入一个泛型,而这个泛型在版本间移动到了另一个包。NAMESPACE 支持原始 if 语句,roxygen2 可以通过 @rawNamespace 写入它:
#' @rawNamespace
#' if (utils::packageVersion("dplyr") > "0.5.0") {
#'   importFrom("dbplyr", "build_sql")
#' } else {
#'   importFrom("dplyr", "build_sql")
#' }
这里的 build_sql 与版本阈值同样是历史案例。使用这种方法时,需要让实际依赖声明与两个分支一致,并在提高最低支持版本后清理旧导入。单纯消除检查提示,并不能证明两个分支在语义上相同。
将按列变体迁移到 across()
mutate_each() 和 summarise_each() 在 dplyr 0.7.0 中被弃用;mutate_all()、summarise_all()、mutate_if()、summarise_if()、mutate_at() 和 summarise_at() 在 1.0.0 中被更现代的接口取代(superseded)。原文把这些接口统一迁移到 mutate() 或 summarise() 与 1.0.0 引入的 across() 组合。
如果原先没有提供列选择,则用 across(everything()):
# 历史写法
starwars |> mutate_each(funs(as.character))
starwars |> mutate_all(funs(as.character))

# 迁移后
starwars |> mutate(across(everything(), as.character))
如果原先通过 mutate_at() 或 mutate_each() 选择特定列,则把选择放进 across():
# 历史写法
starwars |> mutate_each(funs(as.character), height, mass)
starwars |> mutate_at(vars(height, mass), as.character)

# 迁移后
starwars |> mutate(across(c(height, mass), as.character))
如果原先以 mutate_if() 的谓词挑选列,则配合 where():
# 历史写法
starwars |> mutate_if(is.factor, as.character)

# 迁移后
starwars |> mutate(across(where(is.factor), as.character))
这些示例展示迁移关系,因此同时列出旧接口和新接口。把它们放进包内时,仍要应用前文的列选择、导入与最低版本规则;示例中的裸列名不是对包级检查要求的例外。
扩展数据框子类,以及检查的边界
如果你的包定义了新的数据框子类,并希望让 dplyr 动词支持它,原文建议阅读 dplyr_extending。这份参考说明如何用尽可能少的扩展泛型获得较广的动词兼容性。
本文仅静态审阅了原文代码,没有运行 R、安装包或执行 R CMD check。代码中未发现硬编码凭据、命令执行或网络写入;但 globalVariables() 和间接命名空间查找能隐藏部分静态检查信号,不能作为正确性或无漏洞的证据。真正发布一个 R 包前,还应在所声明的最低依赖版本、当前稳定版本及计划支持的开发版本上验证实际行为。
版权与许可:保留 dplyr 文档及贡献者归属。项目主页标示的软件许可为 MIT + file LICENSE;本稿不据此推定所有网站文档具有相同转载许可。本文对示例增加中文注释和静态审查说明,未声称执行验证。
dplyr 项目代码许可声明
以下保留相关项目代码的版权与许可,不改变前文对文章转载依据的区分。来源:dplyr 官方 MIT 许可及版权字段。
MIT License

Copyright (c) 2026 dplyr authors

Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.











暂无评论内容