


把 Slurm 节点从 cgroup v1 迁移到 v2,需要同时满足内核层级规则、systemd 的委派规则,以及 Slurm 插件自己的配置约束。仅把 CgroupPlugin 改成 cgroup/v2,并不会完成节点迁移。先确定系统正在使用统一层级,再调整 Slurm 配置和启动方式,才有可靠的诊断起点。
本文根据 SchedMD 官方《Control Group v2 plugin》完整翻译整理。维护及发布方为 SchedMD Slurm,原页没有可确认的个人作者署名;本文不把项目软件许可证推定成页面转载许可。文中的迁移、服务及容器操作仅静态核对,没有在任何节点执行。
先认识参与者和版本边界
cgroup/v2 是 Slurm 的内部插件接口,被 proctrack/cgroup、task/cgroup、jobacctgather/cgroup 等插件调用。它负责建立资源限制和统计所需的层级。理解它时,最好把 内核 cgroup v2 文档与 systemd cgroup 委派文档一起看;设备限制在 v2 中还涉及 eBPF。
官方网页是随版本更新的文档。所读页面已经提到 26.05 前后的作业目录命名差异,但保留了来自 2022 年及 23.11 候选版本的日志示例。这些输出用来说明结构,不能作为当前集群必须逐字匹配的验收结果。开始迁移前,应记录节点的 Slurm、systemd、内核及发行版版本,核对相应版本的手册,并安排维护窗口、排空作业及回退路径。
从系统层面确认 cgroup v2
原文要求 systemd 版本低于 252,或者 /proc/1/cgroup 出现多行/非零层级编号时,检查并按需要调整 systemd 启动配置。v1 可能出现类似 12:cpuset:/、11:hugetlb:/ 的多行记录;统一 v2 层级的示例是:
0::/init.scope可先用以下只读命令检查系统。这些命令在本文制作过程中也没有运行:
systemd --version
cat /proc/1/cgroup
cat /proc/self/cgroup
cat /proc/cmdline
findmnt -t cgroup,cgroup2
原文给出的 v2 引导参数为:
systemd.unified_cgroup_hierarchy=1 systemd.legacy_systemd_cgroup_controller=0 cgroup_no_v1=all安全修订:原文的 Debian 示例先注释原 GRUB_CMDLINE_LINUX,再写入只包含这三个参数的新值。这会丢掉磁盘解密、控制台、IOMMU 或其他原有启动参数,不能直接照抄到生产节点。应先备份并审阅引导配置,将需要的参数合并进原有值,保留其他必要选项,再按发行版流程重新生成引导配置。Red Hat 系的原文示例使用 grubby --update-kernel=ALL --args=...,会影响全部匹配内核,也应先确认变更范围和恢复入口。
完成经过审核的引导变更后,需在维护窗口重启节点。验收不仅要检查 /proc/cmdline 是否包含预期选项,还要确认没有 v1 控制器或混合层级。原文用下面的筛查寻找非零层级记录:
grep -v '^0:' /proc/self/cgroup预期应没有 v1 记录。如果重启后仍出现 net_cls、name=systemd 等旧层级,需要查明哪个进程又挂载了 v1,纠正它的配置。不能把没有看到某一条日志当作迁移完成,也不能只更改 Slurm 插件名来掩盖混合模式。
转换 Slurm 配置
在所用版本确认需要迁移的 cgroup.conf 中,按原文移除旧的 CgroupAutomount=、CgroupMountpoint= 项,移除强制 CgroupPlugin=cgroup/v1 的设置,并使用:
CgroupPlugin=autodetect随后按站点正常流程重启 Slurm 守护进程并检查启动日志。这不是让所有节点盲目同时重启的命令清单。Slurm 支持集群中的不同计算节点分别运行 v1 或 v2 插件,同一个作业也可以涉及这样的不同节点;但同一个节点不支持把两种控制器版本混在一个运行配置里。从 v1 切到 v2 仍需正确配置节点并重启,不能在运行中单靠切换配置字段完成。
为什么层级不能随意创建
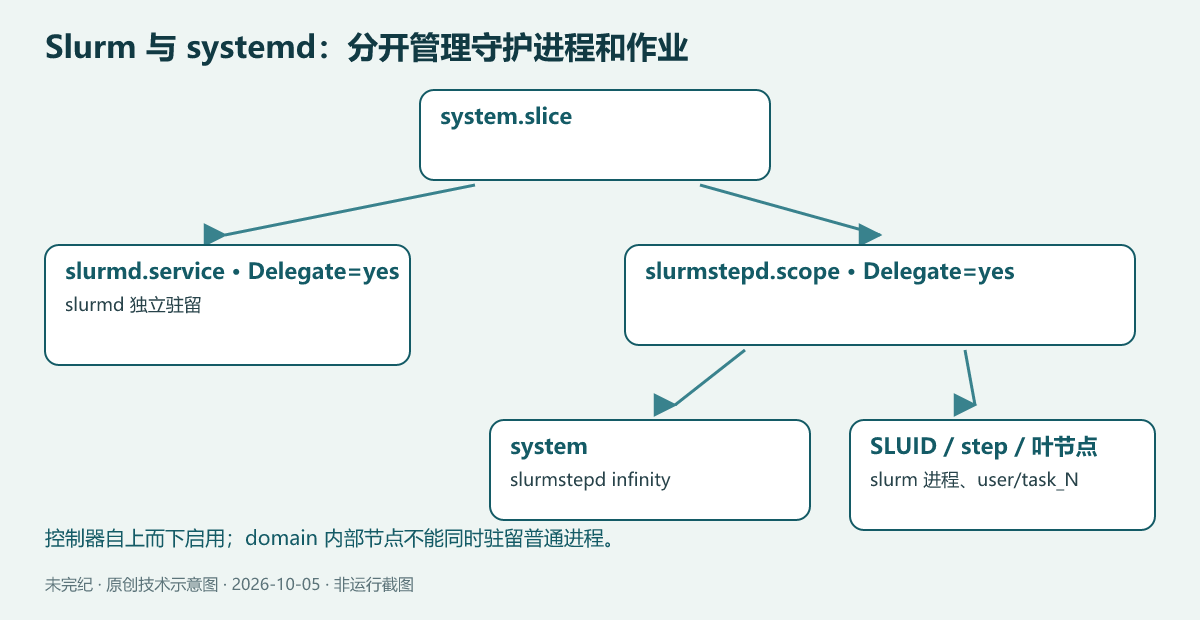
cgroup v2 有两条直接影响 Slurm 的规则。第一条是自上而下的控制器约束:某控制器只有在父节点的 cgroup.controllers 中可用,并在父节点的 cgroup.subtree_control 中启用,才可向下分配。子树仍在使用的控制器,也不能随意从上层关闭。
第二条是 domain 层级的“无内部进程”约束。除根 cgroup 等规定的例外之外,普通 domain cgroup 若要为子组启用资源控制器,就不应在自身层级保留进程;应先把这些 PID 放到叶节点。本文解释的是 Slurm 使用的 domain 层级,并不把它推广到 cgroup v2 的所有特殊模式。
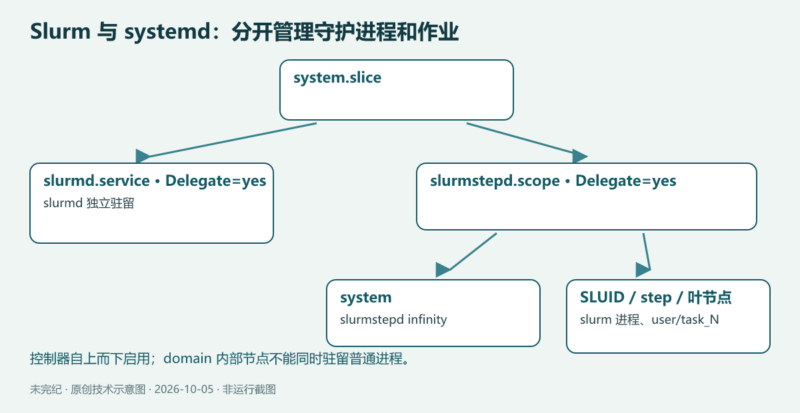
systemd 还要求单一写入者:它管理的 cgroup 不能让其他软件绕开其登记直接创建目录、搬动 PID 和改控制器。Slurm 应在 systemd 单元中获得 Delegate=yes,随后只管理委派给自己的子树。这样 systemd 知道这部分层级由 Slurm负责,不会按照自己的内部数据库擅自整理它。
slurmd 和 slurmstepd 为什么要分开
如果把所有作业层级都建在 slurmd 自己的 cgroup 下面,首次启动可能正常。重启时,systemd 却会把新的 slurmd 放回原单元根目录,而那里已有子目录并承担 domain 控制器职责,于是碰上无内部进程约束。
Slurm 的设计把两部分分离:slurmd.service 单独驻留守护进程;另建带 Delegate=yes 的 slurmstepd.scope,容纳 stepd 与用户作业。scope 接收一个已存在进程的 PID,由 systemd 创建并登记相应 cgroup;它不像普通服务那样负责启动可执行文件。
scope 需要有进程存活才能维持。因此 Slurm 创建 slurmstepd infinity 保活进程,让它留在 scope 内的 system 叶节点。原文讨论过把 RemainAfterExit 扩展用于 scope 的设想,但那不是可依赖的现成替代。不要因为看到一个长期存在的 infinity 进程,就把它当作作业泄漏后随手杀掉。
官方还记录了绕过 systemd 的后果:在它们自己的测试中,当所有委派单元停止后,一次重新加载或清除失败状态可能使手工子树中的 cpuset 控制器消失。这是源文作者的测试观察,不是本文复现结论。IgnoreSystemd 和 IgnoreSystemdOnFailure 因而被定位为开发/测试选项,不是运行 systemd 的生产节点上的通用解决办法。无 systemd 的发行版在原文中不属于支持范围,虽然具备依赖并手工创建层级后可能运行。
启动、重启和回收的实际路径
首次启动时,依赖 cgroup 的插件初始化会让 slurmd 经 libdbus 调用 systemd 的 startTransientUnit,创建作业 scope。默认位置在 system.slice 下;使用 --enable-multiple-slurmd 构建时,scope 名会加节点名前缀。所读文档还允许通过服务单元的 Slice= 和 cgroup.conf 的 CgroupSlice 协调更改所属 slice,具体支持以本地版本为准。
创建 scope 的调用是异步的。slurmd 发出请求后等待目录出现,超时则失败;成功后建立 system 区域、移入保活进程,并为子树启用所需控制器。若配置了系统资源专用保留,slurmd 自身的内存或 CPU 限制也会在自己的层级设置。可以检查 scope 状态和委派属性,但不要直接编辑 /run/systemd/transient/ 下由程序生成的单元文件。
systemctl status slurmd.service
systemctl status slurmstepd.scope
systemctl cat slurmd.service
systemctl cat slurmstepd.scope
节点名前缀或自定义 slice 存在时,应替换成实际单元名。原文示例的 cgroup.controllers 包括 cpuset cpu io memory pids,而 cgroup.subtree_control 为子组启用了 cpuset cpu memory;这展示了“可用”与“已向下启用”的区别,不能把示例列表当成所有机器都相同。
slurmd 重启时会检查 scope 是否已存在,存在则复用,不存在才重建。新 step 的 slurmstepd 先由 slurmd 派生,迅速迁移到 scope 的等待区域,再建立作业与 step 层级,移到对应叶节点,用户进程随后进入 task 目录。
作业结束时,slurmstepd 清理为作业创建的目录;Slurm 不会因此停止整个 slurmstepd.scope 或杀掉其 infinity 进程。slurmd 正常结束后,它自己的 cgroup 则由 systemd 收尾。两类生命周期分离,正是为了允许守护进程重启而不破坏已有作业层级。
手动启动时,INVOCATION_ID 可能误导判断
从终端直接启动 slurmd,进程最初会继承终端所在的 cgroup。Slurm 利用 INVOCATION_ID 判断自己是否已由 systemd 放进专用单元:没有该变量时,会尝试把自己移入作业 scope 下的专用子目录;有该变量时,则认为已经位于自己的 cgroup。
问题在于终端或自定义脚本也可能继承这个变量。若手动启动的 slurmd 误以为共享终端 cgroup 是自己的,MemSpecLimit 或 CoreSpecLimit 就可能一起限制终端及同组进程,甚至触发 OOM。原文建议在确实手动启动的受控诊断场景中先取消继承的 INVOCATION_ID;生产部署优先采用随 Slurm 提供的服务单元。
终端常位于 user.slice,控制器也可能不齐全,于是日志会出现 Controller cpuset is not enabled!、cpu cgroup controller is not available 或初始化 jobacct_gather/cgroup 失败。加上 EnableControllers=yes 或许能绕过缺少控制器,但它会从根层级起改动控制器启用状态,也不能解决错误共享 cgroup 的问题。应先纠正启动路径,而不是先堆叠放宽选项。
按证据诊断启动失败
可在经过审核的诊断配置里临时设置:
DebugFlags=cgroup
SlurmdDebug=debug
接着依次看三类证据:服务日志说明哪里失败,进程 cgroup 说明它究竟在哪里,上级目录的控制器文件说明资源控制器是否逐级可用。不要一次修改多项设置后只观察“能否启动”,否则难以确定真正原因。
先从 systemctl show slurmd.service -p MainPID 获取实际主进程 PID,再读取其 /proc/<PID>/cgroup。不要在存在多个 slurmd 时,盲目把 pidof 的多个结果拼进单一路径。由 systemd 正常启动的典型结果是 0::/system.slice/slurmd.service;正确处理过的手动启动可能位于 slurmstepd.scope/slurmd。如果仍在图形终端的 user.slice/.../app-*.scope,应优先检查启动方式和继承环境。
原文还读取 /proc/<PID>/environ 检查 INVOCATION_ID。环境文件可能含访问令牌,诊断时只检查需要的变量是否存在,避免把整份内容输出到工单或公开日志。修复后降低调试日志级别,并保存本次具体配置与验收结果;本文没有代替现场产生这些结果。
task、设备控制器与版本相关路径
jobacctgather/cgroup 和 task/cgroup 分别在 task 层统计及限制资源;proctrack/cgroup 主要在 step 层跟踪进程。为统一不同插件的层级,暂未分配到具体 task 的 PID 会进入 task_special,以后由知道 task 归属的插件迁移出去。
v2 不再通过 v1 那样的 devices 控制文件管理设备。slurmstepd 动态构建 BPF_PROG_TYPE_CGROUP_DEVICE 程序,经 bpf 系统调用挂到相应 cgroup 上,规定作业、step 和 task 可访问的设备。原文说明所管理的是 gres.conf 中描述的设备,系统审计日志可能显示 BPF 的 LOAD 和 UNLOAD 事件。这不是把所有设备自动纳入保护的保证。
所读页面默认使用 SLUID 命名作业级目录。CgroupJobIdPaths=yes 可恢复以数字作业 ID 命名的、26.05 之前的布局,例如 job_123,默认值为 no。已有监控或运维脚本若硬编码旧路径,应明确迁移,而不是把目录变化误诊为作业不存在。原页文字和旧日志中还混用不同 step 子目录名,现场应以所用版本生成的层级为准。
配置、构建与容器条件
| 参数或条件 | 需要理解的影响 |
|---|---|
CgroupPlugin |
可为 autodetect、cgroup/v1、cgroup/v2;原文建议自动探测 |
IgnoreSystemd |
绕过 D-Bus,直接建目录;不支持用于运行 systemd 的生产系统 |
IgnoreSystemdOnFailure |
D-Bus 失败时回退到手工方式,同样须了解单一写入者风险 |
EnableControllers |
递归启用从根到 slurmd 的可用控制器,老 systemd 或部分容器可能需要,影响范围广 |
CgroupMountPoint |
v2 通常只有 /sys/fs/cgroup,一般不应另设 |
MemorySwappiness |
v2 没有对应接口,该参数被忽略 |
构建时需要 eBPF 头文件 include/linux/bpf.h,原文列出的 kernel-headers 条件为至少 5.7,可用 --with-bpf= 指定;还需要 D-Bus 头文件 dbus-1.0/dbus/dbus.h,原文列出 dbus-devel 至少 1.11.16。应看 config.log 确认实际检测结果。即使运行目标不使用 systemd,原文仍要求相关构建依赖;这些头文件条件不等同于宣称目标运行内核最低版本一律为 5.7。
容器里还要有正确的 cgroup、mount、PID 名称空间及相应挂载。原文报告其测试中的 Kubernetes 默认配置兼容,这是源作者测试范围内的观察。Docker 可使用宿主 cgroup 名称空间,或者 --cgroupns=private;宿主方式还应通过 --cgroup-parent 放在合适子组。原文为写 cgroup 提到 --privileged,但这会大幅放宽隔离,不能包装成通用安全默认值;应在受控节点评估权限与运行时约束。
PAM 接管与统计上的差异
pam_slurm_adopt 在 v1 中某些情况下按 cgroup 创建时间选择要接管 SSH 进程的作业。v2 路径去掉了对具体文件系统层级的这项依赖,改用作业 ID 选择;按原文,这保证选最大作业 ID,不保证它一定是时间上最新的作业。
v2 插件只能提供内核 cgroup 接口已有的 CPU 和内存统计。虚拟内存指标不在其中,因此 AveVMSize、MaxVMSize、相关节点/task 字段以及 TRESUsageInTot 的 vmem 可能为 0,不能把这个 0 解读成应用真的不使用虚拟内存。
内存用量采用 memory.current,其定义不等同于 procfs 的 RSS;原文把 “RSS” 展开为 real stack size 并不准确,通常应理解为 resident set size(常驻集大小)。文件缓存可能计入 Slurm 报出的 RSS/MaxRSS,除非启用 JobAcctGatherParams=no_file_cache。该选项又使 MaxRSS 不再直接依赖 memory.peak,采样间隔之间的短暂尖峰可能漏掉。因此比较迁移前后的内存报表时,要一起记录统计口径与采样频率。
RHEL 8/Rocky 8 使用带回移特性的 4.18 内核和较老 systemd;原文提醒其支持范围应向发行版确认。systemd 244 之前不支持 cpuset 接口,某些旧环境还需 DefaultCpuAccounting=yes 或 EnableControllers=yes。它们是具体版本的补救条件,而不是所有新系统都应添加的标准配置。
本文核对日期:2026-10-05。中文整理、自绘配图及安全注释由未完纪制作。迁移是否成功必须由目标节点在维护窗口取得证据;本文的静态审核不代表已完成现场测试或完整安全审计。











暂无评论内容