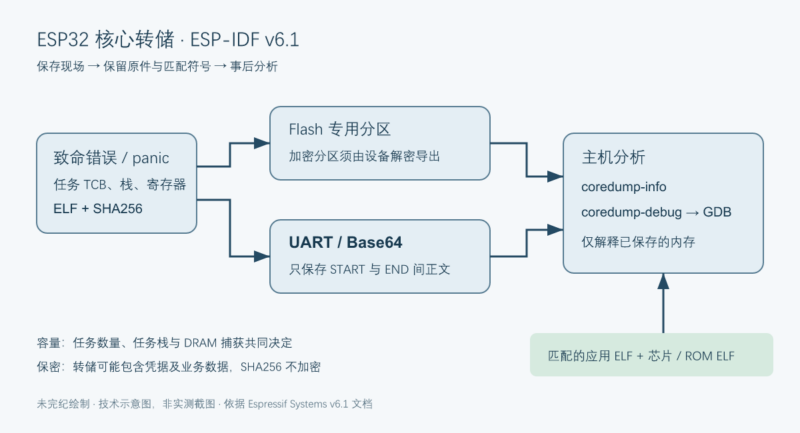



核心转储是在致命错误发生时,由 ESP-IDF 的 panic 处理程序保存的软件状态。它能把故障时的任务、寄存器和调用栈留到设备重启之后,帮助我们回答:哪个任务崩溃了,停在什么指令,以及此前经过了哪些函数。
本文依据 Espressif Systems 的《ESP-IDF 编程指南 v6.1》ESP32“核心转储”章节整理。配置名、ELF 格式与 SHA256 校验均以这一版本为准;不要将旧版本采用其他转储格式的操作直接混入。文中的终端输出来自官方示例,本次仅做正文核对与代码静态审查,没有安装 SDK、连接硬件、烧录固件或触发崩溃。
转储保存了什么,也没有保存什么
每个任务快照包含任务控制块(TCB)和栈。崩溃任务的寄存器与栈总会被保存;其他任务受 CONFIG_ESP_COREDUMP_MAX_TASKS_NUM 控制,按照优先级顺序收集,从处于就绪状态且优先级最高的任务开始。因此,“系统中所有任务的快照”是功能描述,并不意味着任意配置下都能容纳全部任务。
v6.1 生成 ELF 核心转储,并附有 SHA256 校验和,用于发现文件损坏。校验和不等同于保密措施,也不能代替可信来源验证。转储默认主要包含 CPU 寄存器、任务数据与 panic 原因;启用 CONFIG_ESP_COREDUMP_CAPTURE_DRAM 后,还会保存 .bss、.data 和堆数据。这样更利于调试,同时会增加文件大小。
外部 RAM 有明确限制:除崩溃任务的 TCB 和栈外,位于外部 RAM 的数据不在转储范围内,其中包括使用 EXT_RAM_BSS_ATTR、EXT_RAM_NOINIT_ATTR 声明的变量和 extram_bss 段中的数据。一个地址在 GDB 中可见,不代表相应故障时内容已经保存。没有转储到的数据不能用来推断崩溃现场。
先把组件依赖和转储配置接起来
只有构建包含 espcoredump 组件,配置菜单中才会出现 Core dump 选项。在现有组件的 idf_component_register 调用中,通过 REQUIRES 或 PRIV_REQUIRES 声明依赖。下面是根据原文要求补充的最小写法,文件名应与自己的工程一致,不要用它覆盖其他既有依赖:
idf_component_register(
    SRCS "main.c"
    INCLUDE_DIRS "."
    PRIV_REQUIRES espcoredump
)
CONFIG_ESP_COREDUMP_TO_FLASH_OR_UART 负责启用或禁用功能,并选择将转储写入 Flash 还是通过 UART 发给主机。CONFIG_ESP_COREDUMP_STACK_SIZE 设置转储例程使用的栈大小:设为 0 时使用 ISR 栈,设为大于 0 时使用独立栈。官方建议独立栈大于 1300 字节,以免负责保存现场的例程自己又发生栈溢出。
准备调试工程时,应同时保留本次固件对应的应用 ELF、构建配置和芯片目标信息。解析地址依赖匹配的符号与布局;拿另一版固件的 ELF 解读转储,得到的源码行和变量解释可能失真。这是编辑补充的证据管理要求。
路径一:写入 Flash 专用分区
官方默认分区表会在相应配置下声明核心转储分区。自定义分区表则必须包含类型为 data、子类型为 coredump 的分区;名称可以自行选择。原文示例如下:
# Name,   Type, SubType, Offset,  Size
# 若增加了 bootloader 大小,必须核对偏移,避免分区重叠
nvs,      data, nvs,     0x9000,  0x6000
phy_init, data, phy,     0xf000,  0x1000
factory,  app,  factory, 0x10000, 1M
coredump, data, coredump,,        64K
64K 只是该示例的大小,不是普遍足够的配置。原文给出的基础容量下限为:
20 + 最大任务数 × (12 + TCB 大小 + 最大任务栈大小) 字节其中 20 字节是固定开销,12 字节是每个任务的附加开销,不包括 TCB 和任务栈本身。启用完整 DRAM 捕获后,还要考虑新增的数据段和堆内容,不能仅用这一基础公式认定分区足够。修改分区表和重新烧录会改变设备存储布局,须先核对实际 Flash 容量及保留数据;本文没有执行这些操作。
对没有加密的适用分区,官方提供的常用入口是:
idf.py coredump-info
idf.py coredump-debug
前者打印崩溃任务寄存器、调用栈、可用任务列表、内存区域及已保存的 TCB 和栈内容;后者把核心转储保存为 ELF 并启动 GDB 会话,用来进一步检查变量和任务状态。两个命令都是 esp-coredump 工具在 ESP-IDF 中的封装。
启用 Flash 加密时的区别
设备使用 Flash 加密时,官方要求给转储分区加上 encrypted 标志:
coredump, data, coredump,, 64K, encrypted不能用普通的 Flash 读取路径直接取得可分析的明文转储。应由 ESP 设备侧读取并解密分区,将转储导出到主机,再交给工具分析。
编辑澄清:中文和英文原文均把“设备侧读取、解密、发送”与 idf.py coredump-info -c <path-to-core-dump> 放在同一段。这里的 -c 指向已有的核心转储文件,并不凭这一选项完成设备端导出。具体导出机制需要应用实现或采用对应官方组件接口;本文没有提供或测试自动导出程序,也不建议以关闭 Flash 加密来绕过这个流程。
路径二:通过 UART 输出 Base64
UART 路径把转储编码为 Base64 文本。CONFIG_ESP_COREDUMP_DECODE 决定 ESP-IDF 监视器是自动解码,还是保留编码结果留待处理。自动解码会把函数地址映射到源码行,并显示现场信息。CONFIG_ESP_COREDUMP_UART_DELAY 则允许在发送转储前增加延迟。
官方自动解码示例包含以下几类栏目;地址、源码行号和任务句柄仅属于原站示例:
Crashed task handle: 0x3ffafba0, name: 'main'
Panic reason: abort() was called at PC 0x400d66b9 on core 0
CURRENT THREAD REGISTERS
CURRENT THREAD STACK
THREADS INFO
THREAD 1 (TCB: 0x3ffafba0, name: 'main')
THREAD 2 (TCB: 0x3ffafcf8, name: 'IDLE0')
ALL MEMORY REGIONS
阅读时,先定位崩溃任务与 panic 原因,再查看寄存器、当前调用栈和其他任务。官方输出在当前线程和任务 1 的栈中显示 panic_abort、esp_system_abort 等帧;内存区域列表包含 .iram0.vectors、.iram0.text、.dram0.data 等。只看到 panic 框架函数还不足以归因,应继续检查触发它的应用调用链。
手动处理时,UART 会在 CORE DUMP START 与 CORE DUMP END 两行之间输出 Base64 正文。保存文件时只取中间的编码内容,不包含这两行标记,也不混入普通串口日志。原中文示意块有一句“将 Base64 内容解码并保存”的描述;结合本节后文与英文原文,交给下面命令的输入应当是保存下来的 Base64 文本,无须先自行解码一次:
idf.py coredump-info -c "/path/to/saved/base64/text"
idf.py coredump-debug -c "/path/to/saved/base64/text"
这里为路径加了引号,替换了原文尖括号式占位写法,避免把占位符当成 shell 重定向。将路径换为真实文件;两个命令按所需用途选择使用。
GDB 为什么还需要 ROM ELF
调用栈可能进入 ROM 函数,而 ROM 并不属于应用 ELF。GDB 回溯时需要分析函数序言,缺少 ROM 信息可能导致它在第一个 ROM 函数处中断解析。ESP-IDF 监视器会按照芯片目标及其修订版自动加载乐鑫提供的 ROM ELF。排查断裂的回溯时,应一并核对应用 ELF、芯片型号、芯片修订与 ROM ELF,而不是立刻把无法解析的栈帧认定为栈损坏。
更多命令选项可查阅:
idf.py coredump-info --help
idf.py coredump-debug --help
esp-coredump --help
其中包含把读取结果存成文件的方法,可避免每次分析都重新访问设备。需要额外参数或自定义 ELF 时,可以直接使用 esp-coredump;工具版本仍应与当前 ESP-IDF 环境匹配。
按需保存一个关键变量
若只想观察少量关键状态,可为全局变量增加转储属性。COREDUMP_DRAM_ATTR 将其放入会被转储的 DRAM 区域;COREDUMP_RTC_ATTR 和 COREDUMP_RTC_FAST_ATTR 分别面向 RTC 与 RTC_FAST 区域。原文以一个字节变量为例:
COREDUMP_DRAM_ATTR uint8_t global_var;官方实验步骤是在配置中启用写入 Flash,把变量设成 25,再故意用断言触发崩溃:
/* 仅为说明官方故障注入步骤;不要加入生产固件。 */
global_var = 25;
assert(0);
这是会使应用中止的故障注入代码,不是修复代码。本次没有执行;如需复现实验,只能放在无生产职责的隔离测试设备和专用测试构建里,并保留恢复固件。可以以同版本的 hello_world 工程为起点,补齐组件依赖、声明所需头文件及以上片段,不能把这两段片段当作完整应用。
原文随后在目标设备构建、烧录并运行应用,等待生成转储,再进入 idf.py coredump-debug,在 GDB 输入:
(gdb) p global_var
$1 = 25 '\031'
这是作者给出的预期输出,展示十进制 25 及其字符转义形式,并非本次验证结果。对未显式捕获的全局变量、外部 RAM 或其他未保存内存,不能照此推断其崩溃时值。
把转储当作敏感诊断材料保存
静态审查没有在展示片段中发现硬编码密钥或拼接外部输入的执行命令,但这不等于代码或工具不存在漏洞。转储可能包含任务栈、堆、会话数据、凭据和业务内容;开启更广的 DRAM 捕获也扩大了泄露面。应限制串口日志和转储文件的访问权限,分享前检查敏感信息,保留原件用于诊断时不要把它公开上传。SHA256 能辅助发现损坏,却不会隐藏这些内容。
完整的排障闭环是:构建时纳入组件并规划存储,崩溃时得到可校验的转储,分析时使用匹配的符号文件,最后只对确实保存的现场下结论。本文完成的是文档与静态核验,设备端写入、分区容量、解密导出和变量读取仍需在具体硬件上验证。











暂无评论内容