


原文:SciPy 文档贡献者,Kernel density estimation。本稿根据 2026-10-05 读取的 SciPy 1.18.0 在线教程翻译、整理;示例代码中的可复现性改动另行标明。文档页脚署名为 © 2008 The SciPy community,项目与代码采用 BSD 3-Clause,完整声明全文列于下方。
给定一组样本,如何估计随机变量的概率密度函数(PDF)?这就是密度估计。直方图容易理解,适合快速观察数据;核密度估计(KDE)则把每个样本附近的局部贡献平滑叠加,得到连续的密度曲线。SciPy 的 scipy.stats.gaussian_kde 可处理单变量和多变量样本,对于单峰数据通常更适用。
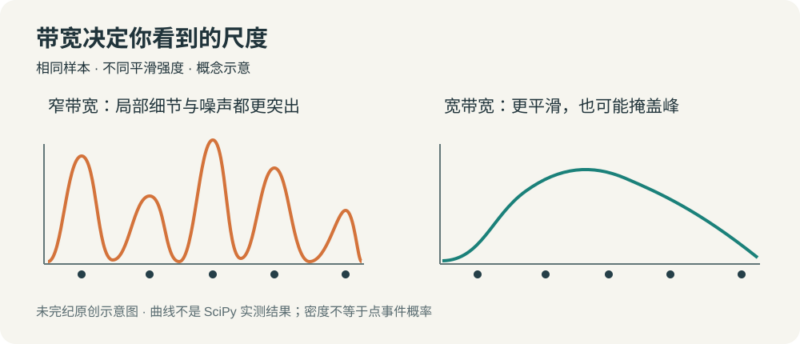
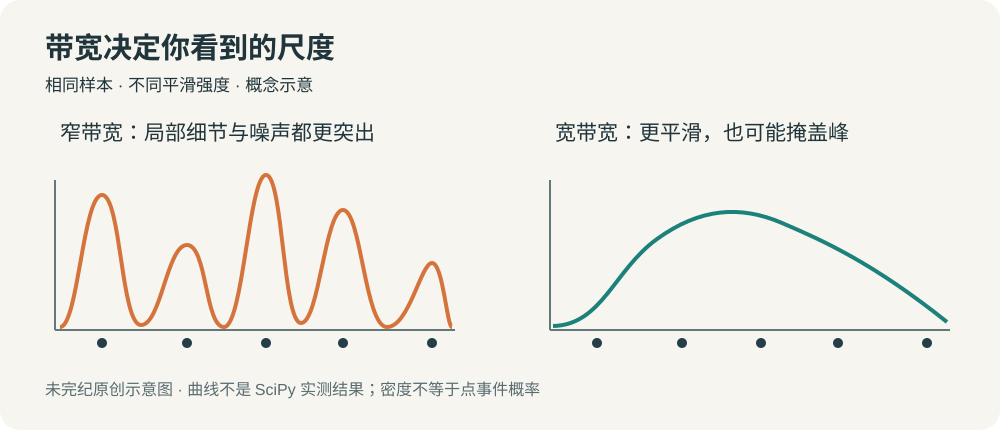
这里最关键的选择不是曲线颜色,而是带宽:带宽太大,细节会被抹掉;带宽太小,随机波动会被突出。下面沿用原教程的四组实验,逐步观察这种权衡。所有代码仅作静态审查,本次未执行,也没有产生或宣称新的数值实验结果。
一、用五个样本理解带宽
先取五个一维样本,在图底部用加号画出它们的位置,这种贴着坐标轴显示样本位置的方式称为 rug plot。省略 bw_method 时使用 Scott 规则;指定 'silverman' 则使用 Silverman 规则。估计器本身可以像函数一样调用,传入需要计算密度的位置。
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

x1 = np.array([-7, -5, 1, 4, 5], dtype=np.float64)
kde1 = stats.gaussian_kde(x1)
kde2 = stats.gaussian_kde(x1, bw_method="silverman")
x_eval = np.linspace(-10, 10, num=200)

fig, ax = plt.subplots()
ax.plot(x1, np.zeros(x1.shape), "b+", ms=20)
ax.plot(x_eval, kde1(x_eval), "k-", label="Scott's Rule")
ax.plot(x_eval, kde2(x_eval), "r-", label="Silverman's Rule")
ax.set_xlabel("x")
ax.set_ylabel("Density")
ax.legend()
plt.show()
原教程的图显示,两种规则在这个小样本中差别很小,但平滑程度可能过强。我们可以提供一个带宽函数,把 Scott 因子乘以常数。下面仍使用原文给出的表达式;其中 obj.n 是样本数量,obj.d 是维数。
def my_kde_bandwidth(obj, fac=1.0 / 5):
    """将原教程的 Scott 因子乘以 fac。"""
    return np.power(obj.n, -1.0 / (obj.d + 4)) * fac

kde3 = stats.gaussian_kde(x1, bw_method=my_kde_bandwidth)
fig, ax = plt.subplots()
ax.plot(x1, np.zeros(x1.shape), "b+", ms=20)
ax.plot(x_eval, kde3(x_eval), "g-", label="With smaller BW")
ax.set_xlabel("x")
ax.set_ylabel("Density")
ax.legend()
plt.show()
当带宽非常窄时,估计曲线会接近围绕每个样本叠加的高斯峰。看见更鲜明的峰不代表发现了更多真实结构,也可能只是把五个样本各自的存在放大了。
编者补充:bw_method 返回的是相对于样本协方差的缩放因子,不应直接理解为以横轴单位表示的核标准差。上面的自定义函数忠实沿用无权样本写法;如果加入样本权重,应核对 gaussian_kde API 关于有效样本数与带宽的定义,而不是机械套用 obj.n。
二、比较正态分布和 Student t 分布
Scott 与 Silverman 两种规则常用于接近正态的分布,也可用于一些明显偏离正态的单峰分布。原教程选择标准正态分布和自由度为 5 的 Student t 分布各生成 200 个样本,再把估计曲线与已知的真实 PDF 对照。由于样本由我们指定的模型产生,这里才有可供比较的“真实 PDF”。
下面把原文的随机生成统一为同一个带种子的 Generator;这是为了便于后续复现所作的改动。它会改变原网页图中的具体样本和曲线,不能将网页原图当作这段修订代码的输出。
rng = np.random.default_rng(20261005)

x_normal = rng.normal(size=200)
x_student = stats.t.rvs(5, size=200, random_state=rng)
fig, axes = plt.subplots(2, 1, figsize=(8, 6))

for ax, data, true_pdf, title in [
    (axes[0], x_normal, stats.norm.pdf, "Normal"),
    (axes[1], x_student, lambda x: stats.t.pdf(x, 5), "Student t, df=5"),
]:
    xs = np.linspace(data.min() - 1, data.max() + 1, 200)
    scott = stats.gaussian_kde(data)
    silverman = stats.gaussian_kde(data, bw_method="silverman")
    ax.plot(data, np.zeros(data.shape), "b+", ms=12)
    ax.plot(xs, scott(xs), "k-", label="Scott's Rule")
    ax.plot(xs, silverman(xs), "b-", label="Silverman's Rule")
    ax.plot(xs, true_pdf(xs), "r--", label="True PDF")
    ax.set(xlabel="x", ylabel="Density", title=title)
    ax.legend()
fig.tight_layout()
plt.show()
读图时应比较整体形状、峰值附近的偏差和尾部,而不要只看两条估计曲线是否彼此接近。两个规则得出相似曲线,只能说明它们给出了相近的平滑尺度,不能证明估计已经接近真实分布。重复抽样也会改变结果。
三、宽峰与窄峰并存时,全局带宽会遇到困难
接下来构造一个双峰混合分布:第一个正态成分均值为 −2、标准差为 1,抽取 175 个样本;第二个成分均值为 2、标准差为 0.2,抽取 50 个样本。两个峰的尺度很不一样,一个统一带宽很难同时照顾它们。
真实混合密度按两组样本所占比例加权,即 175/225 与 50/225,而不是把两条密度曲线直接相加。以下代码继续使用前一节的 rng 和第一节的 my_kde_bandwidth。
from functools import partial

loc1, scale1, size1 = -2, 1, 175
loc2, scale2, size2 = 2, 0.2, 50
x2 = np.concatenate([
    rng.normal(loc=loc1, scale=scale1, size=size1),
    rng.normal(loc=loc2, scale=scale2, size=size2),
])
x_eval = np.linspace(x2.min() - 1, x2.max() + 1, 500)

kde = stats.gaussian_kde(x2)
kde2 = stats.gaussian_kde(x2, bw_method="silverman")
kde3 = stats.gaussian_kde(
    x2, bw_method=partial(my_kde_bandwidth, fac=0.2)
)
kde4 = stats.gaussian_kde(
    x2, bw_method=partial(my_kde_bandwidth, fac=0.5)
)
bimodal_pdf = (
    stats.norm.pdf(x_eval, loc=loc1, scale=scale1) * size1 / x2.size
    + stats.norm.pdf(x_eval, loc=loc2, scale=scale2) * size2 / x2.size
)

fig, ax = plt.subplots(figsize=(8, 6))
ax.plot(x2, np.zeros(x2.shape), "b+", ms=12)
for estimator, style, label in [
    (kde, "k-", "Scott's Rule"),
    (kde2, "b-", "Silverman's Rule"),
    (kde3, "g-", "Scott * 0.2"),
    (kde4, "c-", "Scott * 0.5"),
]:
    ax.plot(x_eval, estimator(x_eval), style, label=label)
ax.plot(x_eval, bimodal_pdf, "r--", label="Actual PDF")
ax.set(xlim=(x_eval.min(), x_eval.max()), xlabel="x", ylabel="Density")
ax.legend(loc=2)
plt.show()
原教程的结论是:默认 KDE 难以同时拟合宽峰与窄峰;把 Scott 带宽减半能有所改善,缩到五分之一又平滑不足。这个例子更需要非均匀、可随位置调整的自适应带宽。原教程没有实现自适应 KDE,上述四条曲线也都仍使用单一的全局带宽。原文对其随机样本的观察不是对所有双峰数据的保证。
四、把核密度估计扩展到二维
多变量估计的核心输入形状是“维数 × 样本数”。下面先生成两个独立的正态分量,再返回它们的和与差,使两项观测具有相关性。和与差共享第一个随机分量,因此它们不是独立数据。
def measure(n, rng):
    """返回两组相互关联的模拟观测。"""
    first = rng.normal(size=n)
    second = rng.normal(scale=0.5, size=n)
    return first + second, first - second

m1, m2 = measure(2000, rng)
xmin, xmax = m1.min(), m1.max()
ymin, ymax = m2.min(), m2.max()

X, Y = np.mgrid[xmin:xmax:100j, ymin:ymax:100j]
positions = np.vstack([X.ravel(), Y.ravel()])
values = np.vstack([m1, m2])
kernel = stats.gaussian_kde(values)
Z = kernel.evaluate(positions).reshape(X.shape)

fig, ax = plt.subplots(figsize=(8, 6))
ax.imshow(
    np.rot90(Z), cmap=plt.cm.gist_earth_r,
    extent=[xmin, xmax, ymin, ymax]
)
ax.plot(m1, m2, "k.", markersize=2)
ax.set(xlim=(xmin, xmax), ylim=(ymin, ymax), xlabel="m1", ylabel="m2")
plt.show()
100j 让 mgrid 沿每个轴产生 100 个网格位置;positions 的形状为 (2, 10000),values 的形状为 (2, 2000)。估计器在展平后的网格上求值,再把结果恢复成二维数组。旋转数组与设置 extent 是原教程采用的图像坐标对齐方式,最后叠加样本点帮助检查方向是否对应。
与原文的差异:把旧式 np.random.normal 改为显式传入同一个 rng;将网页显示的网格写法规范化为合法 Python 的 100j;去掉对一维求值数组无实际影响的转置;补充坐标标签。这些都是代码整理,不是已验证的运行结论。
读图之外,还要检查什么
- 纵轴是密度,不是“变量恰好等于某个数”的概率;区间概率对应密度在该区间上的积分。密度值也不必小于 1。
- 高斯核会向整个实数空间延伸。如果数据只能为正数或限制在某个区间,边界附近可能出现偏差;原教程没有解决边界修正。
- 多维估计随维数增加更需要数据。二维图好看不代表高维估计可靠;样本完全共线或协方差退化时,还应检查是否需要降维。
- 曲线和热图不是置信带,不说明估计误差范围。这里的“真实 PDF”仅用于已知生成机制的模拟实验,不是对现实样本作出的真值判断。
- 计算量随样本数、求值点数和维数增加。不要在未知大小的数据上无上限生成高维网格。
静态代码审查未发现这些数学示例中存在网络访问、命令注入、硬编码凭据或破坏性文件操作。已识别的问题主要是随机性未固定、二维数组形状易误用,以及全局带宽的统计适用性。没有执行测试,也不把“未发现”解释为没有漏洞。
中文整理与示意图:未完纪。原始项目声明见 SciPy BSD 3-Clause License;原作者未对本文改写作背书。
原始版权与许可全文
Copyright (c) 2001-2002 Enthought, Inc. 2003, SciPy Developers.
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions
are met:

1. Redistributions of source code must retain the above copyright
   notice, this list of conditions and the following disclaimer.

2. Redistributions in binary form must reproduce the above
   copyright notice, this list of conditions and the following
   disclaimer in the documentation and/or other materials provided
   with the distribution.

3. Neither the name of the copyright holder nor the names of its
   contributors may be used to endorse or promote products derived
   from this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS
"AS IS" AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT
LIMITED TO, THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR
A PARTICULAR PURPOSE ARE DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT
OWNER OR CONTRIBUTORS BE LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL,
SPECIAL, EXEMPLARY, OR CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT
LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR SERVICES; LOSS OF USE,
DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER CAUSED AND ON ANY
THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY, OR TORT
(INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.











暂无评论内容