


普通多对多关系只回答“谁与谁有关”:例如用户加入了哪个项目。如果还需要记录加入日期、角色或关系备注,这些值既不属于用户本身,也不属于项目本身,而属于两者之间的那一条关系。SQLAlchemy 的关联对象模式,就是把这条关系作为一个有自己字段和生命周期的 ORM 对象。
本文依据 SQLAlchemy 官方 Basic Relationship Patterns 的 Association Object 及紧随其后的混用警告整理。范围覆盖带附加字段的映射、双向访问、事务写入、读取以及与直接多对多关系的冲突;基础一对多等其他章节不作整章翻译。2026-10-05 实读 2.0.54 文档,站点标示该系列为 legacy/maintenance,并另列 2.1。本文不是对 2.1 或其他版本的兼容承诺。
什么时候该把中间表映射成类
普通多对多可以把中间表作为 relationship(secondary=...) 的参数。向集合里加入一个子对象时,ORM 会插入中间表行;从集合中移除关系时,ORM 会在 flush 时删除相应中间表行。应用代码通常不直接操作这些中间行。
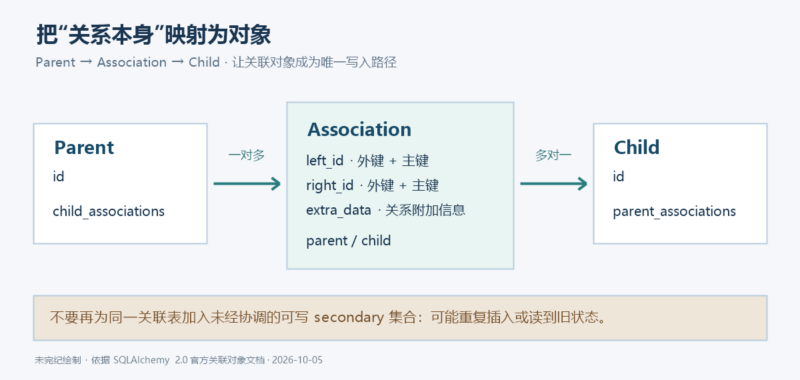
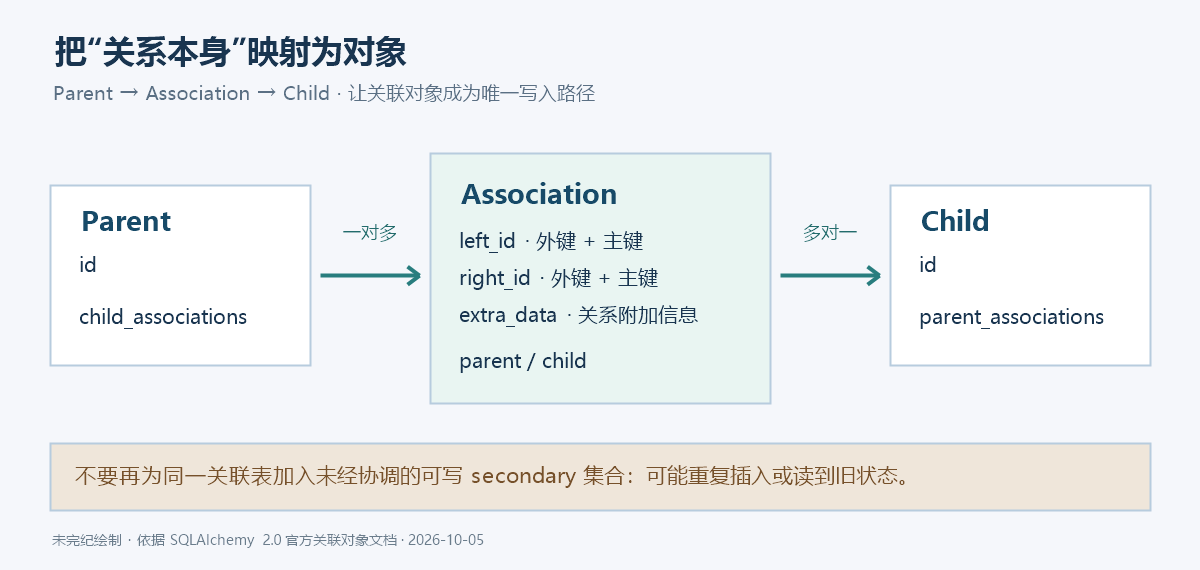
当中间表多出 extra_data 等业务字段时,关联对象模式改为给它定义独立映射类。此时不再用 secondary 管理同一条写入链路,而是串起两个普通关系:Parent → Association 为一对多,Association → Child 为多对一。单向访问需要两个 relationship;若父、子和关联对象都要双向访问,完整结构有四个。
原文采用 left_table、right_table 与 association_table。关联表的 left_id 和 right_id 都是外键,并共同构成主键,意味着同一父子组合只能对应一条关联记录。extra_data: Mapped[Optional[str]] 允许没有附加说明。若业务要求角色或日期必填,应明确建模为非空字段,并设计迁移及输入校验;不能指望 Optional 字段自动验证业务规则。
把四条关系命名清楚
父对象的集合装的是 Association,不是 Child。原文最简示例使用 Parent.children 存放关联对象,读者容易把它与普通的子对象集合混淆。下面将这两个集合分别命名为 child_associations 和 parent_associations,从名字就能看出访问需要经过中间对象。
| 属性 | 实际内容 | 反向属性 |
|---|---|---|
| Parent.child_associations | 该父对象对应的 Association 列表 | Association.parent |
| Association.parent | 一个 Parent | Parent.child_associations |
| Association.child | 一个 Child | Child.parent_associations |
| Child.parent_associations | 引用该子对象的 Association 列表 | Association.child |
back_populates 明确声明每一对关系的对应属性,让 ORM 在对象层面协调双向关系。它不是额外的数据库字段,也不会取代外键、主键或唯一约束。
完整映射与一次事务写入
下段代码保留原文的三张表、复合主键和可空附加字段,补充了可独立阅读的内存数据库示例。使用 list[...] 与延迟注解表达类型,避免从文档上下文单独复制时遗漏 List 导入。构造关系时先创建 Association,再把它加入父对象的关联集合;需要访问子对象时,沿 association.child 取得它。
相对原文,集合名称、事务与查询部分是本稿的教学整理;数据库使用进程内 SQLite,没有真实连接信息。session.begin() 正常退出时提交,异常时回滚;flush() 先发送待处理写入以获得生成的 id,并不等同于提交。此段只做过静态检查,没有执行。
# Based on SQLAlchemy documentation; MIT license.
# Editorial adaptation: explicit association names and a local transaction example.
from __future__ import annotations
from typing import Optional

from sqlalchemy import ForeignKey, create_engine, select
from sqlalchemy.orm import (
    DeclarativeBase, Mapped, Session,
    mapped_column, relationship, selectinload,
)

class Base(DeclarativeBase):
    pass

class Association(Base):
    __tablename__ = "association_table"

    left_id: Mapped[int] = mapped_column(
        ForeignKey("left_table.id"), primary_key=True
    )
    right_id: Mapped[int] = mapped_column(
        ForeignKey("right_table.id"), primary_key=True
    )
    extra_data: Mapped[Optional[str]]
    parent: Mapped[Parent] = relationship(back_populates="child_associations")
    child: Mapped[Child] = relationship(back_populates="parent_associations")

class Parent(Base):
    __tablename__ = "left_table"

    id: Mapped[int] = mapped_column(primary_key=True)
    child_associations: Mapped[list[Association]] = relationship(
        back_populates="parent"
    )

class Child(Base):
    __tablename__ = "right_table"

    id: Mapped[int] = mapped_column(primary_key=True)
    parent_associations: Mapped[list[Association]] = relationship(
        back_populates="child"
    )

def main():
    # 仅本进程的内存数据库。不要替换为生产连接后直接照搬建表。
    engine = create_engine("sqlite+pysqlite:///:memory:")
    Base.metadata.create_all(engine)

    with Session(engine) as session:
        with session.begin():
            parent = Parent()
            child = Child()
            association = Association(extra_data="该关系的附加说明", child=child)
            parent.child_associations.append(association)
            session.add(parent)
            session.flush()
            parent_id = parent.id

    # 在新的会话中读取,避免把尚未持久化的内存对象当作数据库结果。
    with Session(engine) as session:
        statement = (
            select(Parent)
            .where(Parent.id == parent_id)
            .options(
                selectinload(Parent.child_associations)
                .selectinload(Association.child)
            )
        )
        saved_parent = session.scalars(statement).one()
        for association in saved_parent.child_associations:
            print(association.extra_data, association.child.id)

if __name__ == "__main__":
    main()
调用 session.add(parent) 后,默认的 save-update 级联会把关联对象以及它引用的新子对象纳入会话的待持久化状态。读取部分换用一个新 Session,通过 selectinload 预加载两段关系,再在会话内逐项访问。这是为了让读者清楚地区分对象已经链接、写入已经 flush、事务已经 commit,以及下一次查询这几个阶段。
内存 SQLite 示例适合解释事务和对象图,并不能验证生产数据库的所有外键、并发和删除行为。代码没有显式开启 SQLite 的外键强制检查,因此尤其不能用它证明外键约束在目标环境生效。部署时应检查实际数据库与驱动设置,并用迁移管理已有表结构,不要直接把内存连接字符串替换成生产连接后盲目建表。
避免为同一张关联表开两个写入入口
官方文档特别警告:关联对象模式不会自动与同表上的普通多对多写入保持一致。假设同时定义了可写的 Parent.children(通过 secondary 直接访问 Child)和 Parent.child_associations(显式访问 Association),那么它们在 Python 中是两套集合,不会因为底层对应同一张表就自动即时同步。
最直接的冲突是:同一个 Child 一次被加入 Parent.children,另一次又被包装为 Association 加入关联集合。flush 时,两条路径都可能尝试插入同一父子键,触发重复插入与完整性错误。另一个问题是,直接向 secondary 集合加入 Child 时,没有提供额外列的值,extra_data 将写入 NULL;在要求非空的实际模型中,这会失败,允许空值时则可能悄悄丢失业务信息。
也不要用“提交后再看看”掩盖两套模型的语义。文档指出,一个集合中的变更不一定立刻出现在另一个集合里;会话过期、重新载入后才能反映数据库状态,默认 commit 后通常会过期。改过 expire_on_commit 等会话行为的应用还需按自己的配置判断。
需要直达 Child 时,先考虑代理或只读视图
最清楚的默认设计,是让关联对象承担唯一的写入路径。如果只是希望调用代码更简洁,官方建议考虑 Association Proxy:由代理把从父对象到关联对象、再到目标属性的两跳访问包装成一跳,并仍经由关联对象维护关系。这里不展开代理的 creator 与附加字段默认值配置;带必填业务字段时,必须明确新关联对象如何获得这些值。
如果确实需要保留基于 secondary 的直接查询集合,文档给出的缓解方式是在对应关系两端都加 viewonly=True,例如将 Parent.children 声明为 relationship(secondary="association_table", back_populates="parents", viewonly=True),反向的 Child.parents 也设为 viewonly。这是对额外查询属性的说明,不是让读者在上面的唯一写入示例里直接加入第二套可写关系。
viewonly 不会把该集合里的改动持久化,因此能避免冲突写入和缺失附加列的插入;但它不保证即时读一致性。同一会话内修改关联对象后,之前已加载的只读集合可能仍是旧值。需要有计划地 flush 与刷新、过期或重新查询;使用 Session.expire() 前还应注意未刷新变更的处理,不能把它当作随意清理状态的按钮。
删除关系与删除实体是不同的操作
普通 secondary 集合中移除 Child,会自动维护中间表。显式映射成 Association 后,关联行成为独立实体,删除规则要围绕这个实体设计。不能假定从列表中移除一个 Association,就一定按业务期望删除它;本稿沿用原文基本映射,没有配置 delete-orphan,也没有配置数据库 ON DELETE CASCADE。
对于当前映射,如果只想删除一条关系,可以在事务中定位并显式删除对应的 Association,而保留 Parent 和 Child。若要删除父实体、子实体或大量关系,应先决定哪一端拥有关系、是否允许共享子对象,以及 ORM 级联与数据库级联怎样协作,再添加相应配置。在未设计删除规则前,直接删除父子对象可能受到非空复合主键和外键约束阻止;不要通过去掉约束来“解决”这个问题。
复合主键可以防止同一父子键重复,无法代替权限校验。使用来自请求的 id 建立关系之前,应用仍必须检查调用者是否有权访问两端实体,以及 extra_data 是否符合长度、内容和业务要求。发生约束异常时应回滚事务,再决定重试或向调用者返回明确的冲突错误。
静态代码审核:字符串配置不能接用户输入
本示例使用固定的表名、外键和关系名称,没有拼接 SQL、硬编码秘密或连接生产数据库。紧接本文来源章节的官方说明还提醒:部分延迟求值的 relationship 字符串参数,例如用于连接条件或排序的表达式,会使用 Python 的 eval()。这些映射配置必须由开发者控制,不能接收请求参数或其他不可信文本。普通的类名引用也不应被设计成让外部用户任意指定模型的接口。
本次未执行建表、事务、查询或删除测试。代码结构与源文逐项核对,不等于目标数据库已经通过完整性、并发或安全验证。文章的范围是把“关系自身有字段”这件事建模正确,并明确容易导致冲突的边界。
原作:SQLAlchemy authors and contributors。SQLAlchemy 及其文档采用 MIT 许可,版权告知为 Copyright (c) 2005–2026 Michael Bayer and contributors;网页另署 © 2007–2026 SQLAlchemy authors and contributors。示意图与标注的教学补充由未完纪制作。完整许可见下方,来源副本为 LICENSE-SQLAlchemy.txt。
来源核对:Basic Relationship Patterns、ORM Quick Start、Overview、Copyright Appendix。
版权与许可全文
MIT License

Copyright (c) 2005-2026 Michael Bayer and contributors.
SQLAlchemy is a trademark of Michael Bayer.

Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.

Source: https://docs.sqlalchemy.org/en/20/copyright.html











暂无评论内容