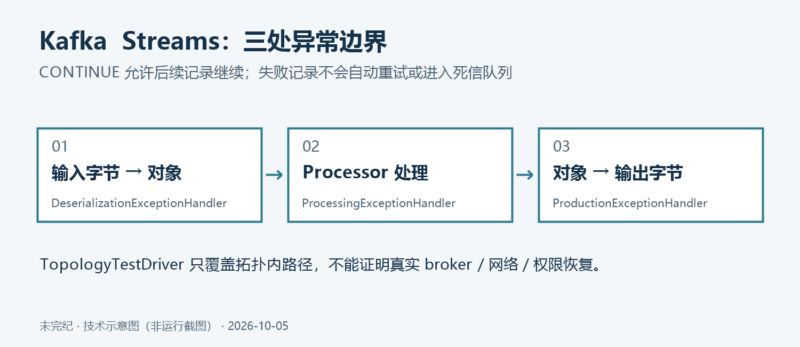



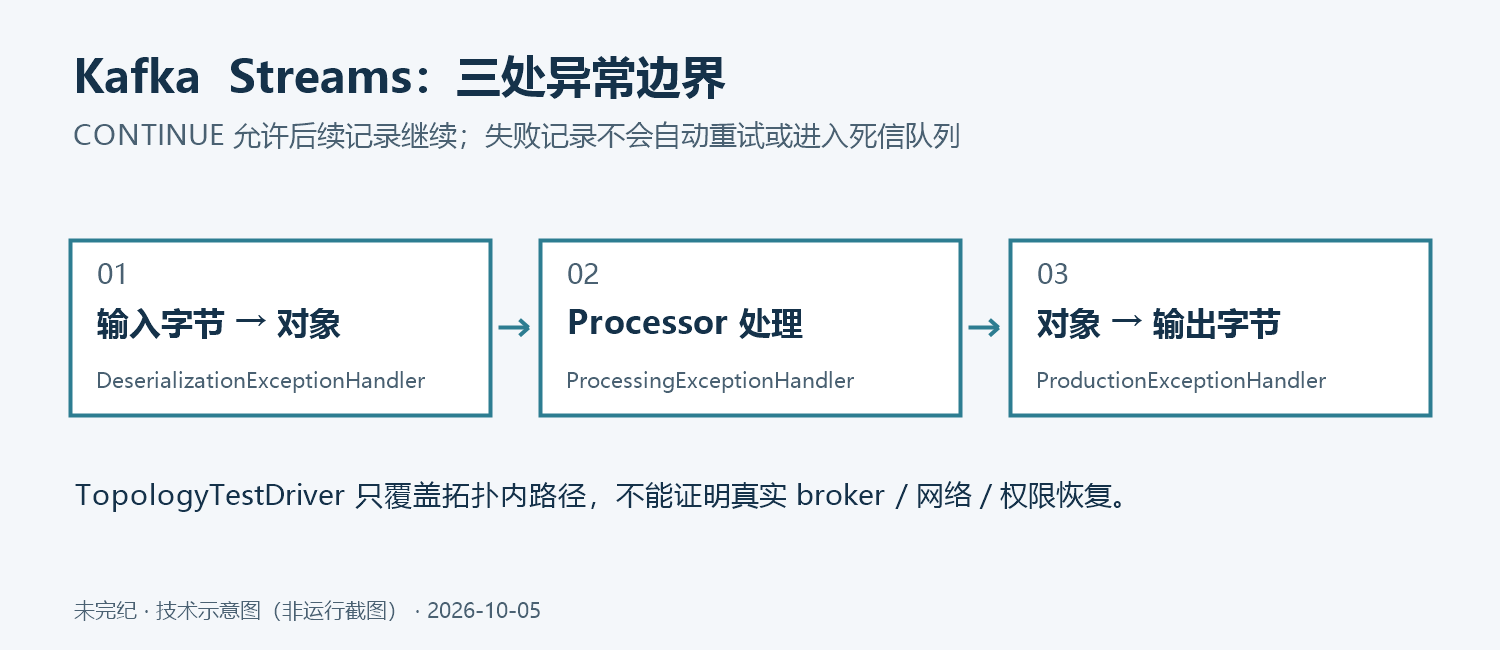
一条 Kafka Streams 记录要经历反序列化、拓扑处理和向 Kafka 输出三个阶段。任何一个阶段出错,都需要明确回答:让任务失败,还是放弃这一条记录并继续?Confluent 的这篇教程用一个故意出错的拓扑展示三种异常处理器,让我们看清处理器究竟接住了哪一类错误。
本文按原教程的完整技术流程译编,并补核了随文应用、序列化器和测试源码。原作者为 Confluent Developer 文档贡献者,页面无个人署名。核验日期为 2026 年 10 月 5 日;文中代码仅作静态审阅,没有执行 Gradle、启动 Kafka 或连接云服务。
准备与版本边界
原教程要求 Java 17 或更高版本,并从 confluentinc/tutorials 仓库运行示例。读取时仓库的 build.gradle使用 Java 17,Kafka Streams、Kafka clients 和测试工具依赖均为 4.3.1。这里记录的是抓取到的主分支状态,不能据此推断旧教程最初使用的版本,也不意味着任意旧版 Kafka 都接受同样的接口签名。
git clone https://github.com/confluentinc/tutorials.git
cd tutorials
./gradlew kafka-streams-exception-handlers:kstreams:test
以上为原教程命令的 HTTPS 克隆变体,便于不配置 SSH 密钥的读者使用;没有在本次编辑中执行。复现时应先固定审阅过的提交,确认 Java 与 Gradle wrapper 兼容。该测试使用 TopologyTestDriver,不要求真实 broker 或云账户;首次构建仍可能从 Maven 仓库下载依赖。
原文展示的日志包括 ProcessingExceptionHandler triggered、ProductionExceptionHandler.handleSerializationException triggered 和 DeserializationExceptionHandler triggered。它们是教程提供的示例输出,不是本次实测结果。
先把三种处理器接到配置上
测试将自定义处理器的类名注册到 StreamsConfig。这三处配置分别决定输入字节无法解码、用户处理逻辑抛错和输出记录发生生产异常时采用什么策略:
var properties = new Properties();
properties.put(StreamsConfig.DESERIALIZATION_EXCEPTION_HANDLER_CLASS_CONFIG,
        ContinuingDeserializationExceptionHandler.class.getCanonicalName());
properties.put(StreamsConfig.PROCESSING_EXCEPTION_HANDLER_CLASS_CONFIG,
        ContinuingProcessingExceptionHandler.class.getCanonicalName());
properties.put(StreamsConfig.PRODUCTION_EXCEPTION_HANDLER_CLASS_CONFIG,
        ContinuingProductionExceptionHandler.class.getCanonicalName());
对应的配置名是 deserialization.exception.handler、processing.exception.handler 和 production.exception.handler。本文保留原文使用的 ErrorHandlerContext 签名。若项目锁定的 Kafka 版本不同,应以该版本 API 为准,不能只替换配置名就假定可以编译。
输入阶段:无法按约定反序列化
Kafka 中存放的是字节。创建 KStream、KTable 或 GlobalKTable 时,通常通过 Consumed.with指定如何恢复键和值。本例约定键为整数、值为字符串:
builder.stream("input-topic",
        Consumed.with(Serdes.Integer(), Serdes.String()));
如果输入 topic 的真实编码与这个约定不一致,就可能在数据进入拓扑前失败。Kafka 提供 LogAndContinueExceptionHandler 与 LogAndFailExceptionHandler;自定义实现则实现 DeserializationExceptionHandler。原教程的实现只打印固定日志并选择继续:
public class ContinuingDeserializationExceptionHandler
        implements DeserializationExceptionHandler {
    @Override
    public DeserializationHandlerResponse handle(
            final ErrorHandlerContext context,
            final ConsumerRecord<byte[], byte[]> record,
            final Exception exception) {
        System.out.println("DeserializationExceptionHandler triggered");
        return DeserializationHandlerResponse.CONTINUE;
    }

    @Override
    public void configure(Map<String, ?> configs) {
    }
}
测试通过字符串序列化器写入键 "1",而读取方仍使用整数反序列化器,故意制造不匹配:
TestInputTopic<String, String> badInputTopic =
        driver.createInputTopic("input-topic",
                stringSerde.serializer(), stringSerde.serializer());
badInputTopic.pipeInput("1", "foo");CONTINUE的意思是允许应用继续处理后续输入,而不是修好这条坏消息。处理器没有把原始字节写到另一个 topic,也没有建立重试队列。需要追踪丢弃记录的系统,必须另外设计计数、告警、脱敏后的上下文记录和受控的补偿流程。
处理阶段:用户逻辑抛出异常
KIP-1033为消息处理阶段引入了插件式异常处理机制。内置实现包括 LogAndContinueProcessingExceptionHandler与 LogAndFailProcessingExceptionHandler,也可以实现 ProcessingExceptionHandler:
public class ContinuingProcessingExceptionHandler
        implements ProcessingExceptionHandler {
    @Override
    public ProcessingHandlerResponse handle(
            final ErrorHandlerContext context,
            final Record<?, ?> record,
            final Exception exception) {
        System.out.println("ProcessingExceptionHandler triggered");
        return ProcessingHandlerResponse.CONTINUE;
    }

    @Override
    public void configure(Map<String, ?> configs) {
    }
}
原拓扑通过 KStream.process接入一个随机失败的 Processor。没有抛错时它只将记录向后转发;抛错时,context.forward不会执行:
@Override
public void process(Record record) {
    if (Math.random() < 0.5) {
        throw new RuntimeException("fail!!");
    }
    context.forward(record);
}
这是演示用的故障注入。实际业务不能把“吞掉异常后程序仍在运行”当作正确性保证。尤其当处理器在抛错前已经更新状态或执行外部副作用时,跳过记录的业务后果需要单独分析;这个无状态、仅转发的例子没有验证这些情形。
输出阶段:序列化与生产异常
KIP-210引入生产异常处理机制,KIP-399将其扩展到序列化异常。原文列举认证或授权错误、topic 配置错误和网络问题等可能来源,但本教程实际构造的是输出序列化失败。
public class ContinuingProductionExceptionHandler
        implements ProductionExceptionHandler {
    @Override
    public ProductionExceptionHandlerResponse handle(
            final ErrorHandlerContext context,
            final ProducerRecord<byte[], byte[]> record,
            final Exception exception) {
        System.out.println("ProductionExceptionHandler.handle triggered");
        return ProductionExceptionHandlerResponse.CONTINUE;
    }

    @Override
    public ProductionExceptionHandlerResponse handleSerializationException(
            final ErrorHandlerContext context,
            final ProducerRecord record,
            final Exception exception,
            final SerializationExceptionOrigin origin) {
        System.out.println(
                "ProductionExceptionHandler.handleSerializationException triggered");
        return ProductionExceptionHandlerResponse.CONTINUE;
    }

    @Override
    public void configure(Map<String, ?> configs) {
    }
}
自定义 RandomlyFailingSerializer以约 50% 的概率抛出 SerializationException,其他情况下将非空字符串转换为 UTF-8 字节,并保留空值为 null。拓扑把它与普通字符串反序列化器组合成 Serde,再交给输出端:
Serde<String> randomlyFailingStringSerde = Serdes.serdeFrom(
        new RandomlyFailingSerializer(),
        Serdes.String().deserializer());

builder.stream("input-topic", Consumed.with(Serdes.Integer(), Serdes.String()))
        .process(new RandomlyFailingProcessorSupplier())
        .to("output-topic",
                Produced.with(Serdes.Integer(), randomlyFailingStringSerde));
这里的两个随机故障点相互叠加。因此,成功通过输入反序列化的 100 条记录,也不会全部进入输出。原文处理器仅返回继续,不包含将失败消息持久化的实现。
读懂测试能证明什么
随文测试先输入 100 条整数键记录,再输入一条错误的字符串键记录,最后读取输出值列表,并断言:
int numRecordProduced = outputTopic.readValuesToList().size();
assertTrue(numRecordProduced > 0 && numRecordProduced < 100);
它展示了发生随机失败时,仍可能有记录通过拓扑。但随机条件意味着结果并非严格确定;这个数量断言既不能精确证明每一种处理器的调用次数,也不能证明所有应当被丢弃的记录都被正确识别。静态审阅还发现,测试输出 topic 使用字符串键反序列化器,而拓扑输出键是整数;当前测试只调用 readValuesToList()并统计值,因而没有验证键语义。若增加键断言,应改为与拓扑匹配的整数键反序列化器。
编辑建议,与原文不同:把随机故障替换为按指定键值触发的故障;为三种阶段各建一个确定性用例;精确断言输出键和值、失败记录身份、处理器调用次数以及故障后的下一条记录。另增真实 broker 的集成测试,分别覆盖权限失败、不可达服务和重试行为。这些建议没有实现或执行,不能写成“已通过测试”。
采用继续策略前的静态审查结论
已审阅的片段中没有发现硬编码真实凭据,也没有把输入拼成 shell 命令的注入路径;这不是对应用无漏洞的证明。实际问题集中在异常一律继续、失败记录没有保存、随机故障导致测试不确定,以及日志只显示处理器类型而没有可定位的记录上下文。补充日志时也不应直接输出完整消息体、认证信息或个人数据。
这篇教程适合用于理解异常分层和建立测试起点。要让它成为可运维的异常策略,还需要把“允许跳过哪些记录、如何发现跳过、如何重新处理”写成业务规则,再用相应测试验证。
原文:How to handle exceptions in Kafka Streams applications,Confluent Developer 文档贡献者。Copyright © Confluent, Inc. 2014–2026。中文译编与补充审阅:未完纪,2026-10-05。原教程及所列示例未另行声明开放许可证。Apache、Kafka 等名称归各商标权利人所有。











暂无评论内容