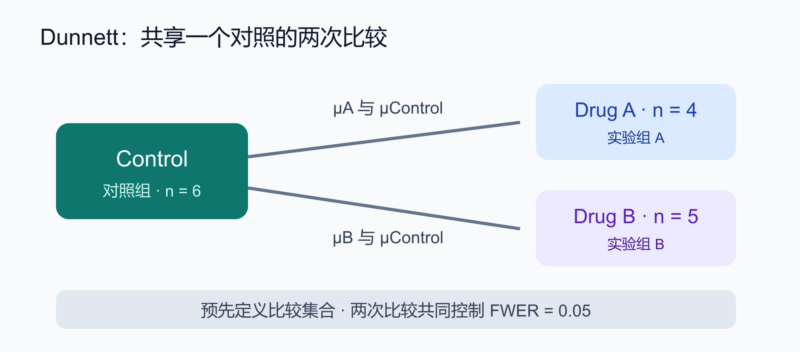



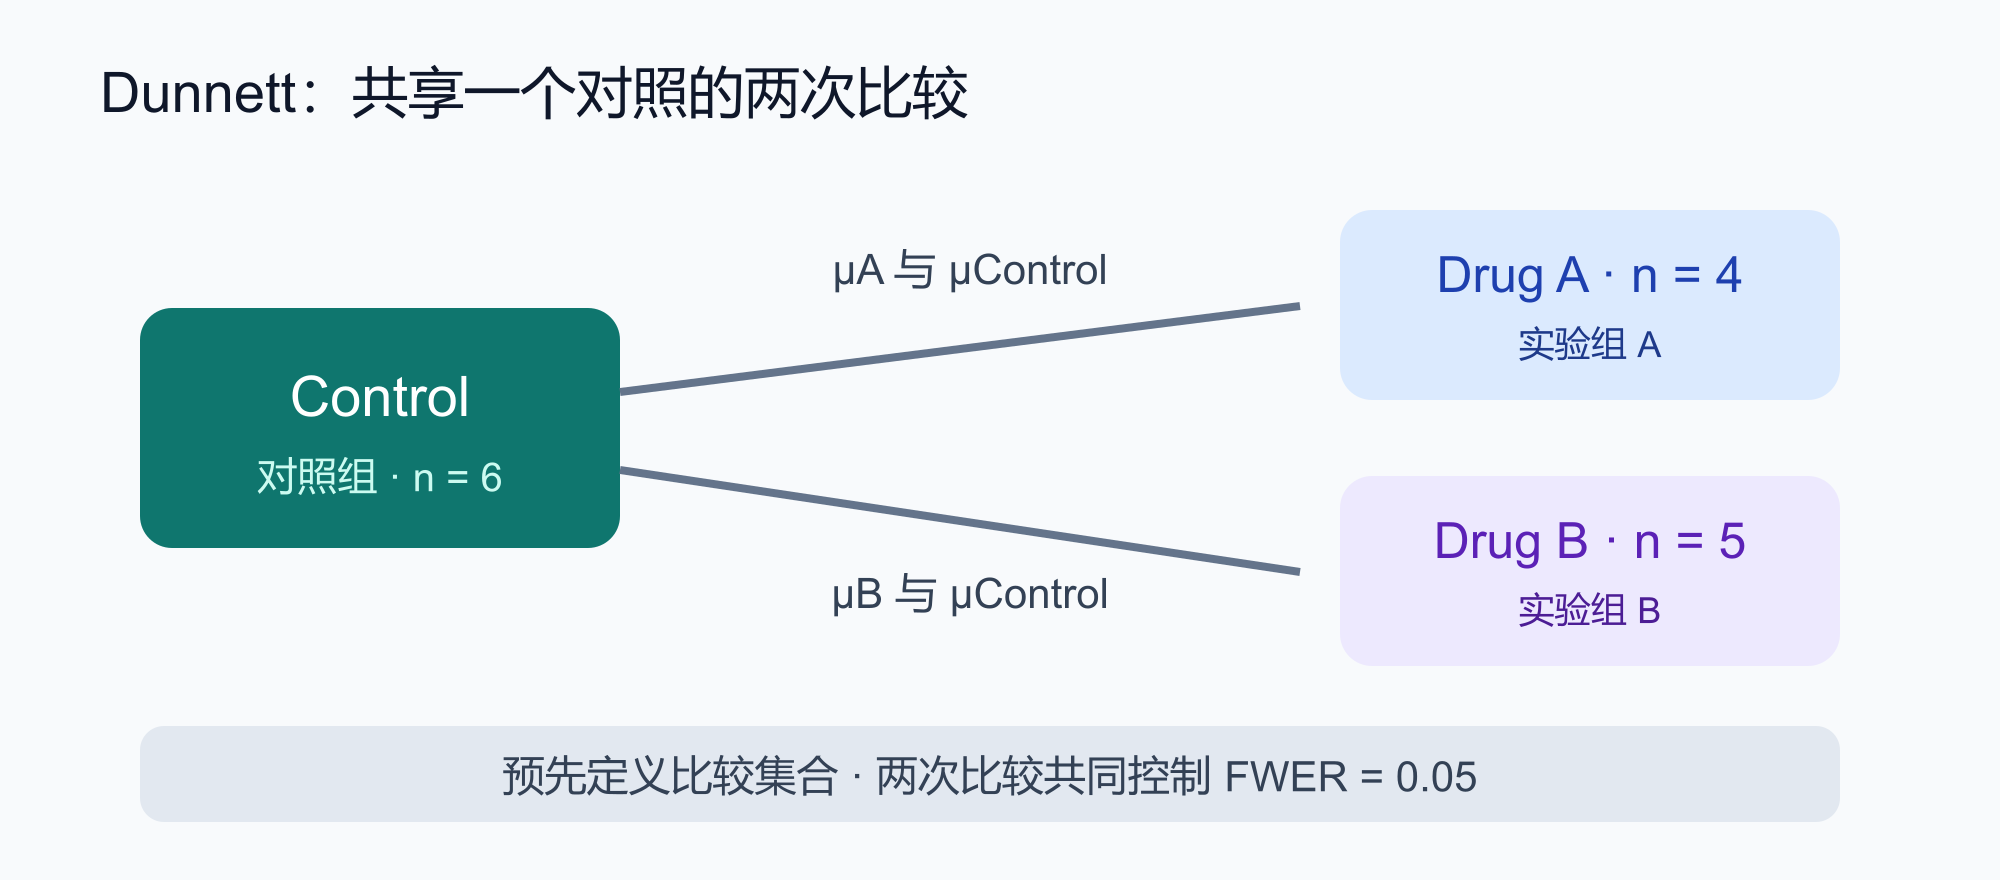
实验里有一个对照组、几个接受不同处理的实验组,我们关心的是每种处理相对于对照有没有差异。这是一个“多对一”的比较问题。Dunnett 检验专门处理这种情形:一次比较多个实验组的总体均值与同一个对照组的总体均值,并控制整组比较的家族错误率。
本文根据 SciPy 官方教程完整译写,保留原始教学数据、作图步骤、检验结果和参考文献,并补充官方 API 文档中的适用假设与版本说明。原文作者为 SciPy 文档贡献者,页面没有个人署名;核对版本为 SciPy 1.18.0。下列输出来自官方文档,本次仅做静态审查,没有运行 Python 示例。
先把比较问题说清楚
Dunnett 在 1955 年的论文中讨论了多个处理与一个对照之间的比较。官方教程采用其中一个历史动物实验:两组动物分别接受不同药物,另有一组作为对照,记录血细胞计数,单位为每立方毫米百万个细胞。这些数组用于解释统计方法,不能据此给出现代用药或健康结论。
import numpy as np

control = np.array([7.40, 8.50, 7.20, 8.24, 9.84, 8.32])
drug_a = np.array([9.76, 8.80, 7.68, 9.36])
drug_b = np.array([12.80, 9.68, 12.16, 9.20, 10.55])
三个数组分别有 6、4、5 个观测值。这里要回答两个问题:A 组与对照组的总体均值是否相同,B 组与对照组的总体均值是否相同。A 与 B 之间的比较不属于本次预先定义的比较集合。如果目标变成所有组之间的两两比较,就应该重新选择对应的方法;SciPy 的 tukey_hsd 是官方文档给出的另一种多重比较工具。
画箱线图,先认识数据
正式检验前,先把三组观测值画出来。箱线图可以帮助观察分布位置、四分位范围和离散程度,发现明显异常,但不能仅凭箱体是否重叠判定统计显著性。
import matplotlib.pyplot as plt

fig, ax = plt.subplots(1, 1)
ax.boxplot([control, drug_a, drug_b])
ax.set_xticks([1, 2, 3])
ax.set_xticklabels(["Control", "Drug A", "Drug B"])
ax.set_ylabel("Blood count (million cells/mm³)")
plt.show()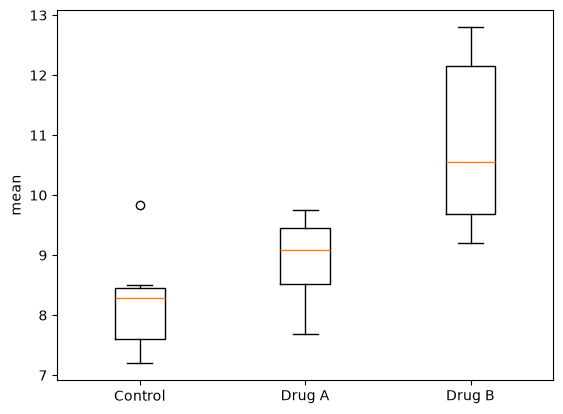
原文图中,A 组和对照组的四分位范围有重叠,B 组与对照组则看起来分开得更明显。接下来要用正式检验判断,样本所呈现的差异是否构成反对零假设的证据。
与原文的差异:原代码把纵轴写成 mean,但箱线图展示的是各组原始观测的分布,不是一张均值图。这里改成血细胞计数及其单位,并显式设置三个刻度位置后再设置刻度标签。数组和绘图对象没有改变。
为什么不能简单做两次 t 检验
对每个实验组分别做一次显著性水平为 0.05 的独立样本 t 检验,并不等于把整个比较集合的错误率控制在 0.05。比较次数增加时,至少错误拒绝一个真实零假设的概率通常也会增加。这种“在一组比较中至少出现一次假阳性”的概率,就是家族错误率,简称 FWER。
Dunnett 检验同时处理多个实验组对同一对照的比较,并利用这些比较共享对照组的关系来控制 FWER。官方 API 实现的是 Dunnett 原始的单步检验。只需要实验组对照比较时,与把不需要的实验组两两比较也纳入分析相比,Dunnett 通常具有更高的检验功效。
在看结果之前,先确定比较集合、备择假设和阈值。本例采用双侧检验:每个零假设分别是“该实验组的总体均值等于对照组总体均值”,对应的备择假设是“两者不相等”。接受的家族错误率为 5%,因此将 0.05 作为调整后 p 值的判断阈值。
调用 dunnett,并逐一解释结果
from scipy.stats import dunnett

res = dunnett(drug_a, drug_b, control=control)
res.pvalue
原文展示的输出为:
array([0.62014638, 0.00593493])返回数组的顺序与实验组参数的顺序一致:第一个 p 值对应 A 与对照,第二个对应 B 与对照。这些是该多重比较检验给出的 p 值,可直接与事先选定的 0.05 比较。
| 比较 | 原文 p 值 | 在本例阈值下的解释 |
|---|---|---|
| A 与对照 | 约 0.6201 | 大于 0.05,不拒绝该比较的零假设。 |
| B 与对照 | 约 0.00593 | 小于 0.05,结果提供反对该比较零假设的证据,支持总体均值不同的双侧备择假设。 |
“不拒绝 A 的零假设”不表示已经证明 A 与对照完全相同,也不表示做了等效性检验。对于 B,双侧检验的结论是存在均值差异的统计证据;不能把一个小 p 值直接解释成实际效果有多大,更不能将统计显著性等同于临床重要性。若要报告差异的大小,应另外报告样本均值差和适当的不确定性区间。
官方返回对象还包含 statistic,以及计算实验组减对照组均值差置信区间的 confidence_interval() 方法。例如可以写成下面的补充代码;本次未运行,也没有为它编造输出:
res.statistic
res.confidence_interval(confidence_level=0.95)
使用前要成立的条件,以及版本差异
SciPy 官方说明列出三项假设:组内和组间观测相互独立;各组观测来自正态总体;各总体具有相同且有限的方差。箱线图本身不能证明这些假设,尤其本例样本量很小。配对测量、同一对象的重复观测或明显不等方差的数据,不能未经判断直接套用本例。
dunnett 默认采用 alternative="two-sided",也支持 "less" 和 "greater"。单侧方向应由研究问题预先决定,不能看到数据后为了降低 p 值再切换方向。这里保留原文的双侧设置。
p 值涉及数值计算中的随机性,不同运行的末位数字可能略有变化,原文的长小数不是逐位一致的验收标准。SciPy 1.15.0 起,随机数参数从 random_state 转向 rng;在本文核对的 1.18.0 API 中,新代码宜使用 rng,不要同时传入两个参数。需要固定随机数输入时,可以把调用改成:
res = dunnett(
    drug_a,
    drug_b,
    control=control,
    alternative="two-sided",
    rng=np.random.default_rng(20261005),
)
这是针对当前 API 的补充示例,不是原教程中的调用;种子改变后不应期望得到原文完全相同的末位输出。即使固定种子,跨库版本复现时也应记录 SciPy 和 NumPy 版本。
本例完成的是一个明确的小范围分析:以两个实验组对同一对照的均值差异为问题,先看分布,再一次性做 Dunnett 检验,最后在预设的 5% 家族错误率下分别解释结果。比较范围、假设条件和结论措辞,与那行函数调用同样重要。
来源与署名
原文:SciPy 文档贡献者,Dunnett’s test,SciPy 1.18.0 Manual;技术补充核对 scipy.stats.dunnett API。页面未注明个人作者与首次发布日期,本文不作推定。原站版权标注为 The SciPy community。
参考文献:Dunnett, Charles W. (1955). “A Multiple Comparison Procedure for Comparing Several Treatments with a Control.” Journal of the American Statistical Association, 50:272, 1096–1121. doi:10.1080/01621459.1955.10501294。
中文译写、解释补充和示意图均已与原文署名区分;未将软件许可证当作文档转载授权。











暂无评论内容