


原作者/来源:Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund(R for Data Science 第二版作者)。原文:10 Exploratory data analysis — R for Data Science (2e)。本文为经授权的中文译稿;技术核验日期:2026-10-05。
10.1 用可视化与变换探索数据
本章介绍如何系统地用可视化与数据变换探索数据。统计学家把这项工作称为探索性数据分析,简称 EDA。它是一个不断循环的过程:
- 围绕数据提出问题。
- 通过可视化、变换和建模寻找答案。
- 根据得到的认识细化原问题,或者提出新问题。
EDA 不是一套严格按规则执行的正式程序,更像一种思考方式。初期可以自由检查脑中出现的每个想法;有的会带来收获,有的会走入死胡同。随着探索深入,你会逐渐集中到少数特别有价值的发现,并最终把它们整理出来,向他人说明。
即使别人已经把主要研究问题交给你,EDA 仍是分析不可缺少的一部分,因为你始终需要调查数据质量。数据清理只是 EDA 的一种应用:你在追问数据是否符合预期。完成清理同样需要可视化、变换和建模这些工具。
10.1.1 前提
本章将结合 dplyr 和 ggplot2:交互地提问,用数据回答,再提出新的问题。
library(tidyverse)10.2 让问题带着分析前进
没有例行公事的统计问题,只有值得质疑的统计惯例。
对正确的问题给出近似答案,即使那个问题常常模糊不清,也远胜于对错误的问题给出精确答案,因为错误的问题总能被说得十分精确。
EDA 的目标是理解数据。最容易的办法,就是把问题当作引导调查的工具。一个问题会把注意力聚焦到数据的特定部分,并帮助你选择要画什么图、拟合什么模型、进行什么变换。
EDA 本质上是创造性过程。和多数创造性工作一样,提出好问题的关键在于先产生足够多的问题。分析刚开始时,你还不知道数据能揭示什么,因此很难立即提出一针见血的问题。可是,每一个新问题都会让你接触数据的另一个方面,也就增加了发现的机会。沿着每次发现继续追问,就能很快深入最有意思的部分,并形成一组值得思考的问题。
没有规则规定必须问什么,但以下两类问题几乎总能带来发现:
- 我的变量内部存在什么样的变化?
- 变量之间存在什么样的共同变化?
接下来先解释变化与共同变化,再介绍回答这两类问题的方法。
10.3 变化:一个变量的取值如何分布
变化是指同一个变量的值在不同测量中会改变。日常生活中很容易看到它:一个连续变量测量两次,结果通常不同。即便测量的是光速这样恒定的量,每次测量也会带有不同的微小误差。
测量对象不同,例如不同人的眼睛颜色,或者测量时间不同,例如电子在不同时刻的能量,变量的值也会变化。每个变量都有自己的变化模式,能够告诉我们同一观测单位的重复测量、以及不同观测之间有哪些差异。
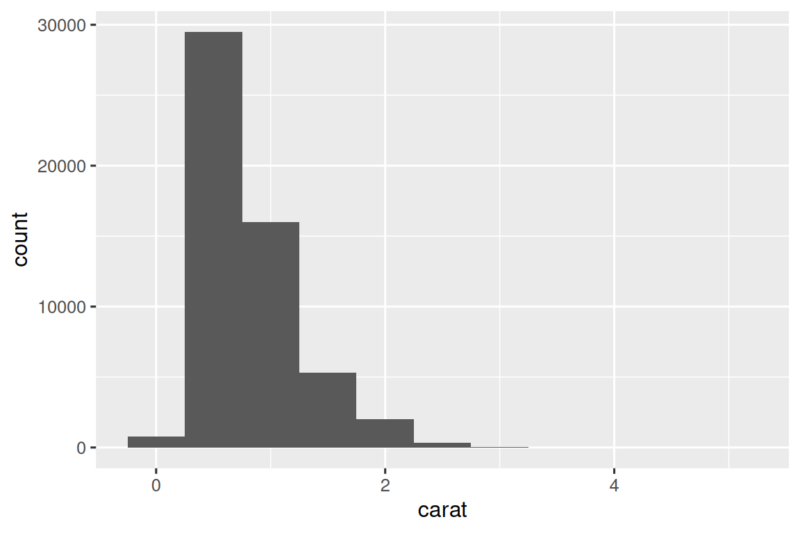
理解这种模式的最好办法,是画出变量取值的分布;这在第 1 章已有介绍。先观察 diamonds 中约 54,000 颗钻石的重量 carat。它是数值变量,因此可以画直方图:
ggplot(diamonds, aes(x = carat)) +
  geom_histogram(binwidth = 0.5)
会画图之后,应该看什么,又应追问什么?下面列出图形中常见的有用信息和后续问题。关键是同时保持好奇与怀疑:你还想知道什么?眼前的图又可能怎样误导你?
10.3.1 常见值
条形图和直方图里的高柱表示常见取值,矮柱表示较少出现的取值,没有柱的地方则表示数据里没有出现那些值。留意与预期不符的地方,可以把这些信息变成有用的问题:
- 哪些值最常见?为什么?
- 哪些值很少出现?为什么?这符合预期吗?
- 是否存在不寻常的模式?可能是什么原因?
把范围缩小到较小的钻石,再观察 carat 分布:
smaller <- diamonds |>
  filter(carat < 3)

ggplot(smaller, aes(x = carat)) +
  geom_histogram(binwidth = 0.01)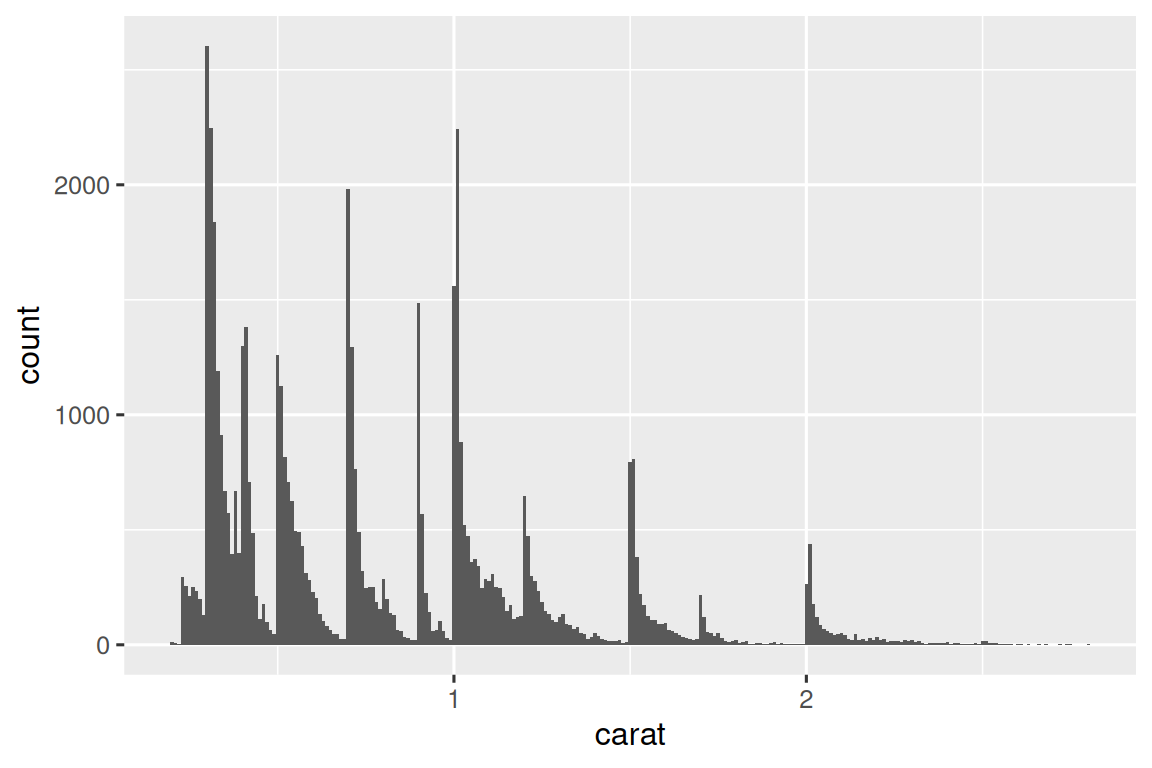
这张图引出两个有意思的问题:为什么整克拉和常见分数克拉处的钻石更多?为什么每个峰右侧的钻石数量又比紧邻左侧更多?
可视化还可能揭示聚类,提示数据中存在子群。理解这些子群时,可以问:每个子群内的观测有什么相似之处?不同群之间有什么差异?怎样解释或描述这些群?看到的聚类又为什么可能是误导性的?
有些问题能用现有数据回答,有些则需要领域知识。许多问题会进一步引导你检查变量间的关系,例如一个变量能否解释另一个变量的行为;我们很快就会讨论。
10.3.2 不寻常的值
离群值是不符合整体模式的观测。有时是录入错误,有时只是这次采集恰好出现的极端值,也可能暗示重要的新发现。数据很多时,直方图中的离群值并不容易看见。例如,观察 diamonds 的 y:
ggplot(diamonds, aes(x = y)) +
  geom_histogram(binwidth = 0.5)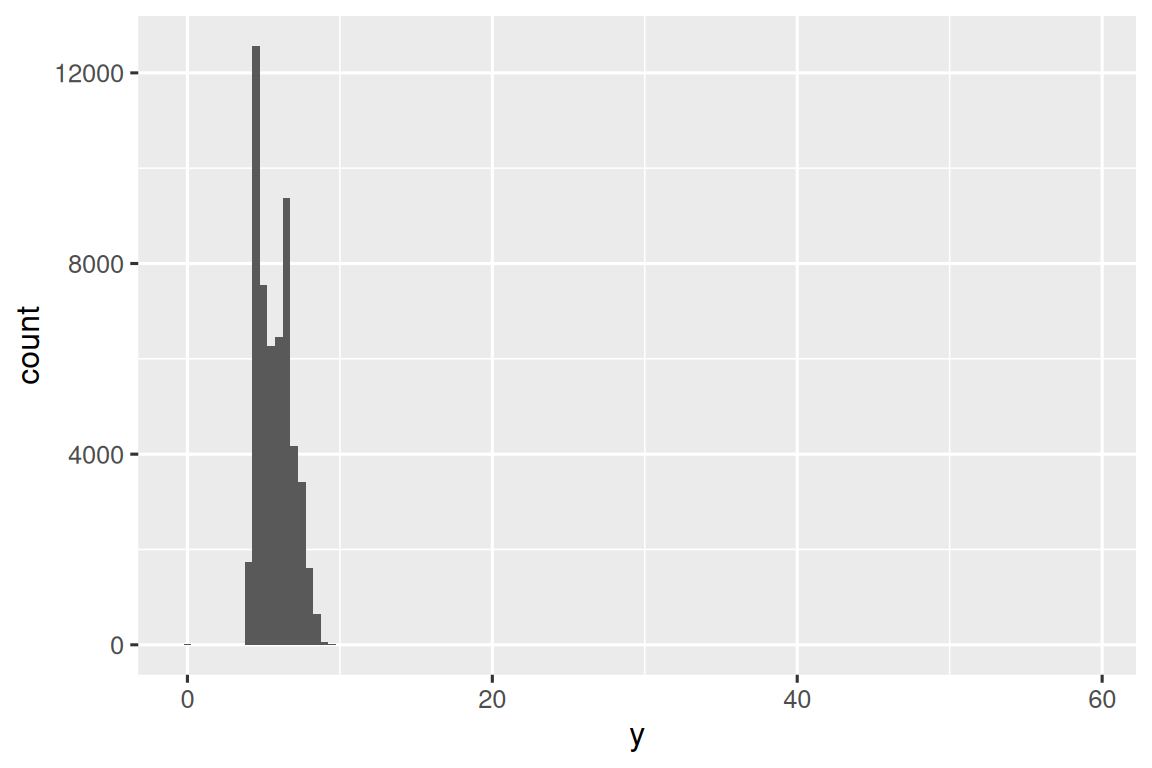
常见箱中的观测太多,稀有箱的柱子就显得极矮,几乎看不见;认真看 0 附近也许能发现一点。用 coord_cartesian() 放大纵轴较小的数值区间,就容易观察异常:
ggplot(diamonds, aes(x = y)) +
  geom_histogram(binwidth = 0.5) +
  coord_cartesian(ylim = c(0, 50))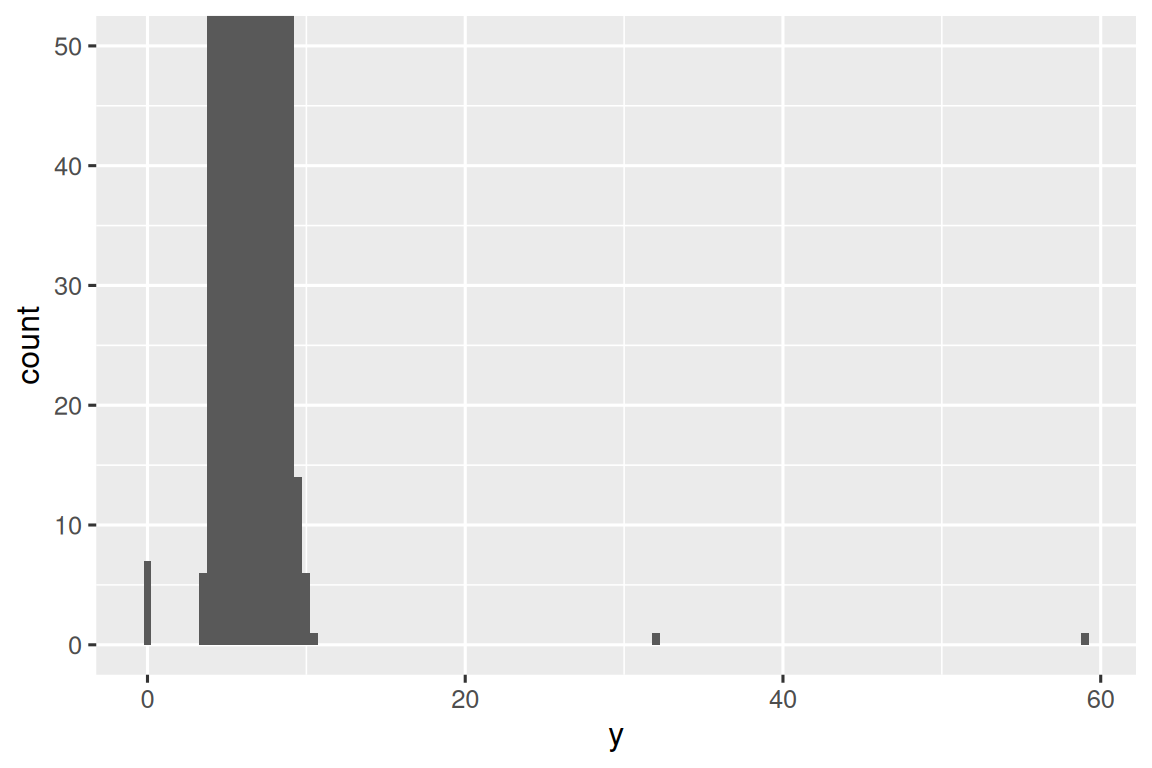
coord_cartesian() 也接受 xlim 参数,可放大横轴。ggplot2 另有 xlim() 和 ylim() 函数,但行为不同:它们会丢弃限制范围之外的数据,而不仅仅改变观看区域。
现在能看到 0、约 30 和约 60 这三类不寻常的取值。用 dplyr 把相应记录取出来:
unusual <- diamonds |>
  filter(y < 3 | y > 20) |>
  select(price, x, y, z) |>
  arrange(y)
unusual
#> # A tibble: 9 × 4
#>   price     x     y     z
#>   <int> <dbl> <dbl> <dbl>
#> 1  5139  0      0    0
#> 2  6381  0      0    0
#> 3 12800  0      0    0
#> 4 15686  0      0    0
#> 5 18034  0      0    0
#> 6  2130  0      0    0
#> 7  2130  0      0    0
#> 8  2075  5.15  31.8  5.12
#> 9 12210  8.09  58.9  8.06
y 是钻石三维尺寸之一,单位为毫米。钻石宽度不可能为 0,因此这些值必定不正确。EDA 发现了被编码成 0 的缺失数据;如果只搜索 NA,就不会发现它们。为了避免误导性计算,接下来可以把这些值改记为 NA。
32 毫米和 59 毫米的尺寸也值得怀疑:这样的钻石已经超过一英寸长,价格却并非数十万美元。
一个好习惯是分别在包含与不包含离群值时重复分析。如果它们对结果影响很小,又无法查明来源,省略它们后继续分析可能是合理选择。但如果影响很大,就不能无缘无故地删除。必须查明原因,例如录入错误,并在报告中说明删除了哪些观测。
10.3.3 练习
- 探索
diamonds中x、y、z各自的分布。有什么发现?想象一颗钻石,怎样决定哪一维是长、宽和深? - 探索
price的分布。有不寻常或出乎意料的地方吗?提示:认真考虑binwidth,尝试较宽范围的取值。 - 有多少颗钻石恰好为 0.99 克拉?多少颗为 1 克拉?你认为差异源于什么?
- 比较直方图缩放时
coord_cartesian()与xlim()、ylim()的区别。不设置binwidth会怎样?只让某个柱显示一半又会怎样?
10.4 如何处理不寻常的值
如果已经发现异常值,又想继续其余分析,通常有两种选择。第一种是删除包含异常值的整行:
diamonds2 <- diamonds |>
  filter(between(y, 3, 20))
作者不推荐这样做,因为一个值无效,并不意味着这一观测的其他值也无效。如果数据质量较差,对每个变量都采用整行删除,最后甚至可能所剩无几。
第二种、更推荐的办法,是只把不寻常的值改成缺失值。用 mutate() 创建变量的修改版,并通过 if_else() 将异常字段替换为 NA:
diamonds2 <- diamonds |>
  mutate(y = if_else(y < 3 | y > 20, NA, y))
缺失值没有明确的位置可供绘制,因此 ggplot2 不把它们画进图里,同时警告哪些行被移除了:
ggplot(diamonds2, aes(x = x, y = y)) +
  geom_point()
#> Warning: Removed 9 rows containing missing values or values outside the scale range
#> (`geom_point()`).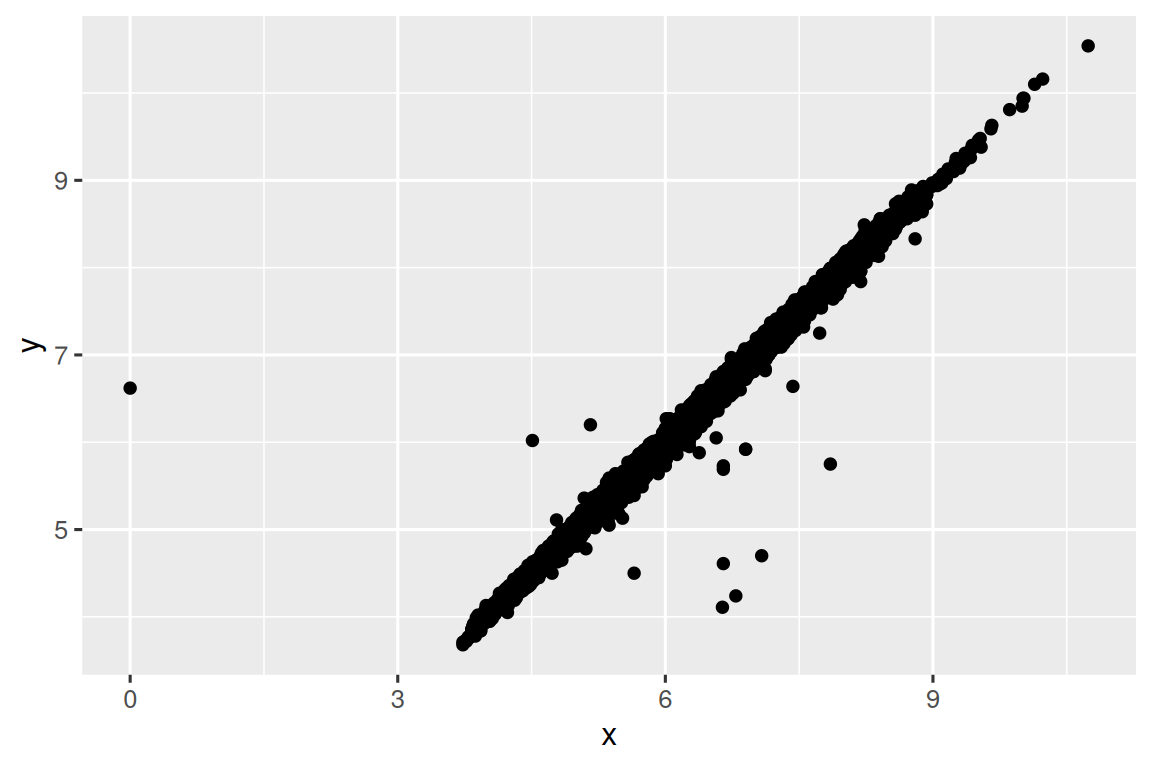
如果不想显示这条警告,可设置 na.rm = TRUE:
ggplot(diamonds2, aes(x = x, y = y)) +
geom_point(na.rm = TRUE)有时,问题本身就是:存在缺失值的观测,与数据完整的观测有什么不同?在 nycflights13::flights 中,dep_time 缺失表示航班取消。于是我们可以比较取消和未取消航班的计划起飞时间。先用 is.na() 检查实际起飞时间,再生成新变量:
nycflights13::flights |>
  mutate(
    cancelled = is.na(dep_time),
    sched_hour = sched_dep_time %/% 100,
    sched_min = sched_dep_time %% 100,
    sched_dep_time = sched_hour + (sched_min / 60)
  ) |>
  ggplot(aes(x = sched_dep_time)) +
  geom_freqpoly(aes(color = cancelled), binwidth = 1/4)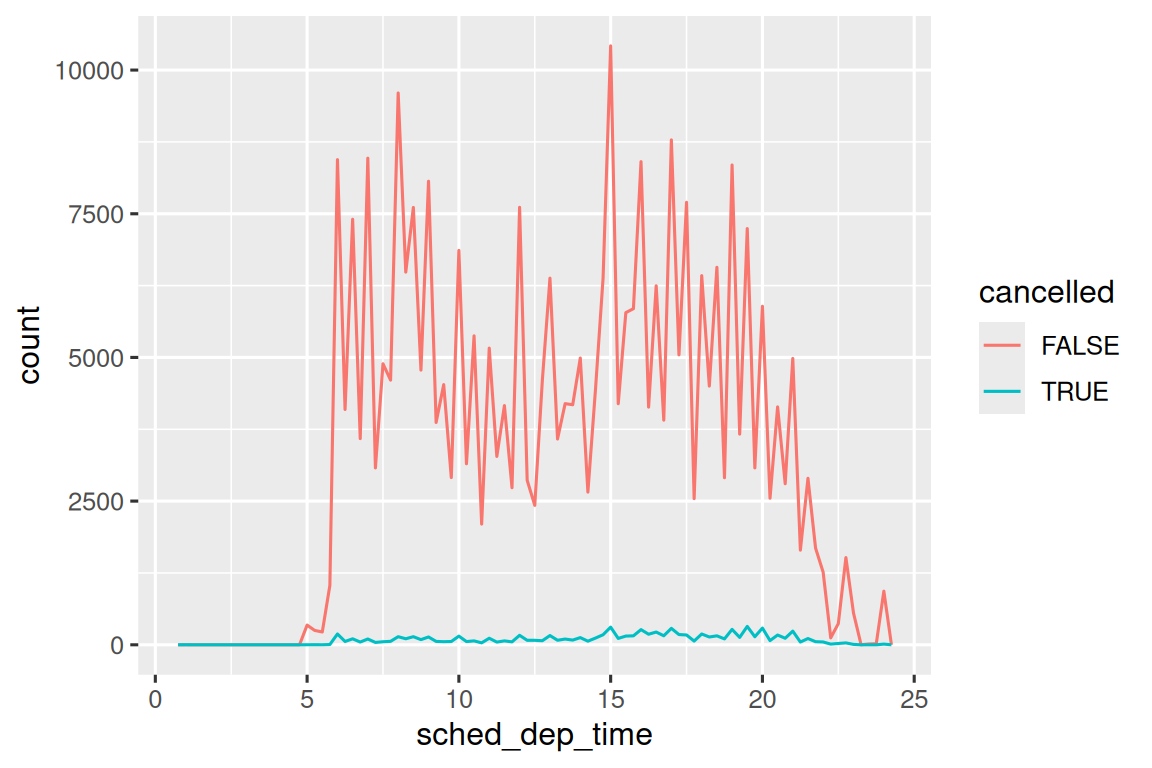
这张图不太好用,因为未取消航班比取消航班多得多。下一节会介绍改善比较的方法。
10.4.1 练习
- 直方图怎样处理缺失值?条形图呢?为什么两者不同?
mean()和sum()中的na.rm = TRUE做什么?- 重画按航班是否取消着色的计划起飞时间频数图,再按
cancelled分面。尝试分面函数中不同的scales设置,减轻未取消航班数量较多带来的影响。原文练习写作scheduled_dep_time,实际数据列及前文代码使用sched_dep_time。
10.5 共同变化:变量之间怎样一起改变
如果变化描述变量内部的行为,共同变化描述的就是变量之间的行为。共同变化是指两个或多个变量以某种相关方式一起改变;最好的发现方法,是把它们之间的关系画出来。
10.5.1 一个类别变量与一个数值变量
先用 geom_freqpoly() 探索钻石价格如何随品质变化;这里的品质用切工 cut 表示:
ggplot(diamonds, aes(x = price)) +
  geom_freqpoly(aes(color = cut), binwidth = 500, linewidth = 0.75)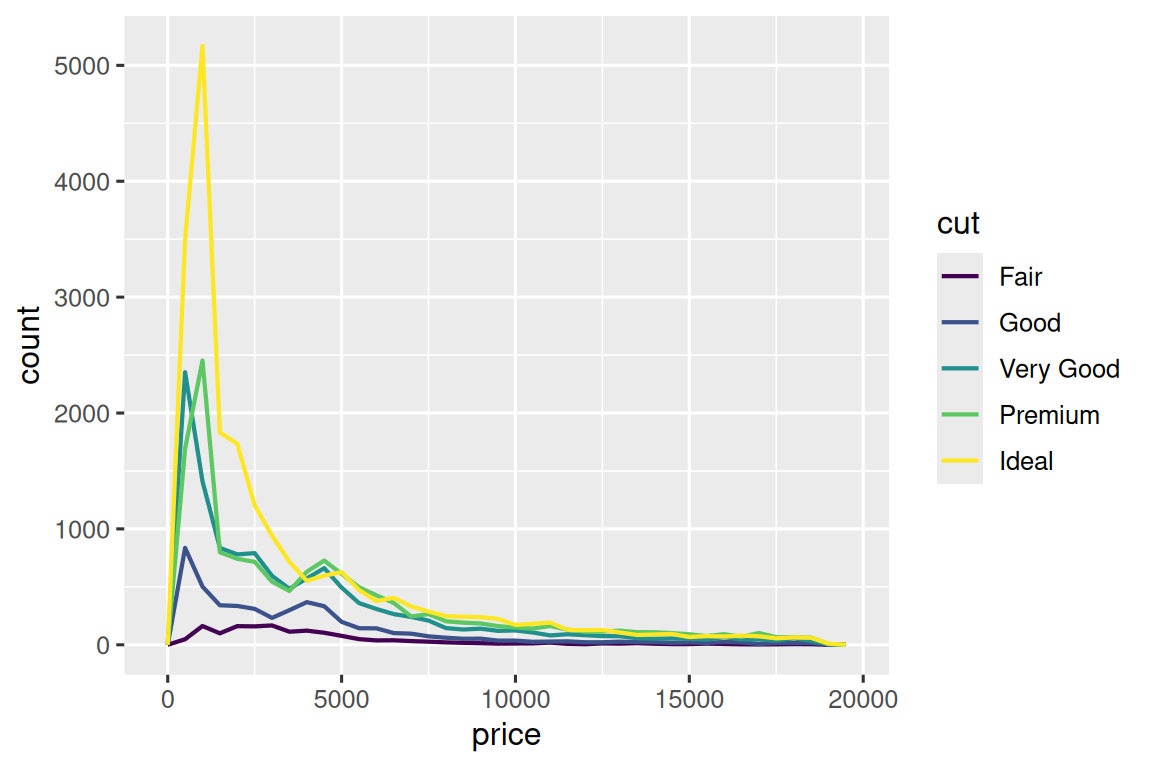
ggplot2 为 cut 使用有序色标,因为这个变量在数据中定义为有序因子,详见第 16 章。默认的频数折线在这里不太有用:各切工组的观测总数差很多,曲线高度也就差很多,掩盖了分布形状的不同。
要更容易比较,应把纵轴从计数换成密度,也就是把各组标准化,使每条频数折线下的面积等于 1:
ggplot(diamonds, aes(x = price, y = after_stat(density))) +
  geom_freqpoly(aes(color = cut), binwidth = 500, linewidth = 0.75)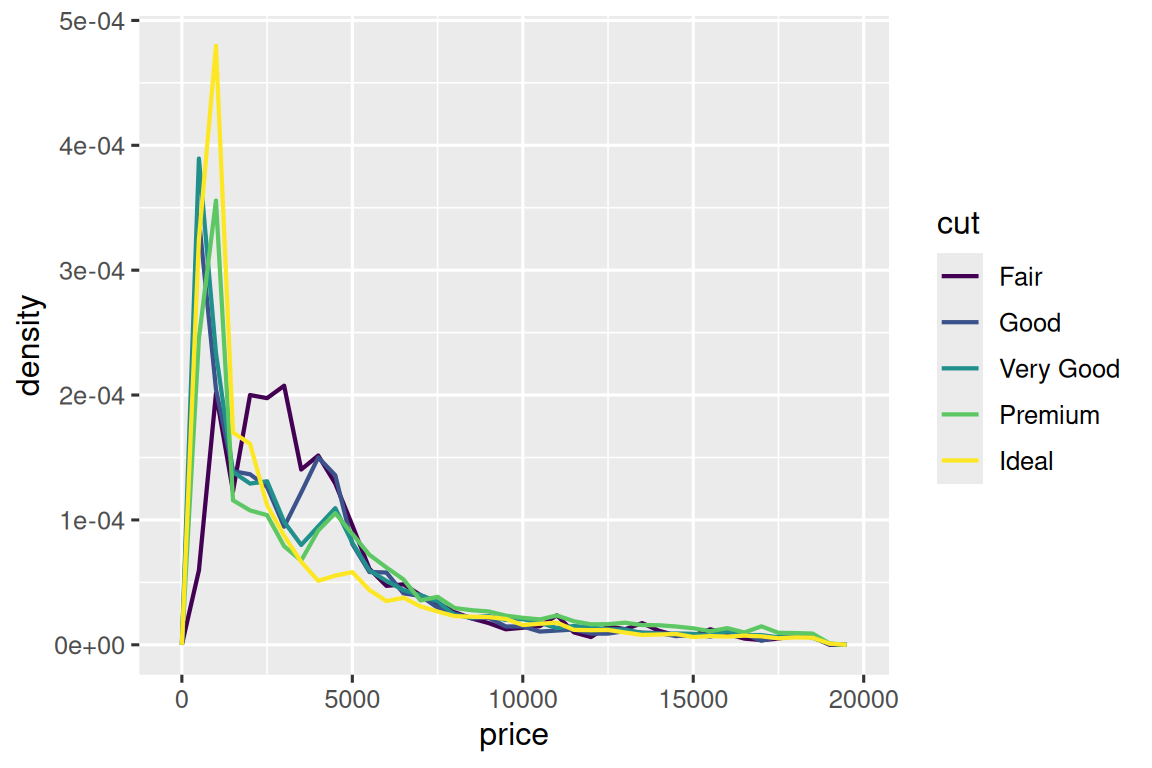
density 不是 diamonds 的原始变量,而是需要由统计变换计算的量,所以用 after_stat() 取得它。
图中出现了出乎意料的现象:切工最差的 Fair 组,平均价格似乎最高!也许是频数折线太复杂,很多线重叠,不容易解释。并排箱线图提供了更简单的视图:
ggplot(diamonds, aes(x = cut, y = price)) +
  geom_boxplot()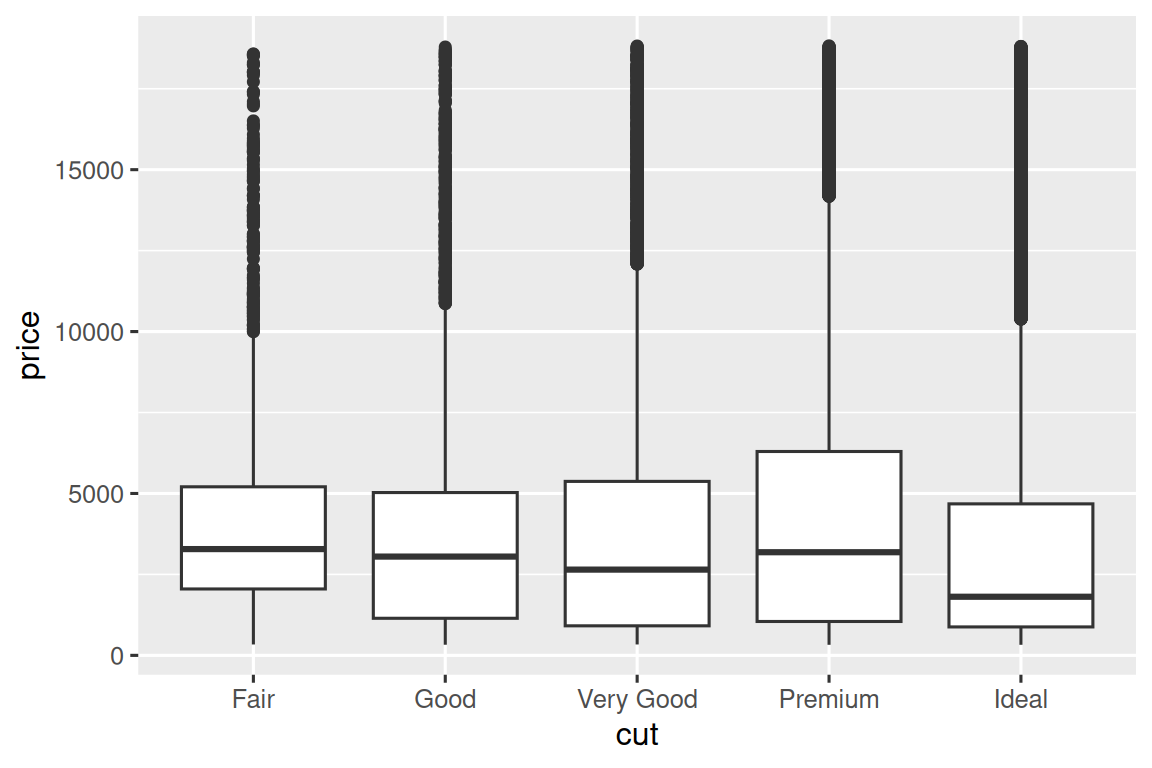
箱线图展示的分布细节更少,但结构紧凑,容易比较,也可以在一张图中放入更多组。它再次支持“切工更好的钻石通常反而更便宜”这个反直觉观察;练习会要求你调查原因。
cut 有固有顺序:Fair 比 Good 差,Good 比 Very Good 差,依此类推。许多类别变量没有这种天然次序,可以通过重新排序让图形更有信息量。fct_reorder() 就能做到,详细介绍见第 16.4 节。这里先看 mpg 中的 class,比较不同车型的高速公路燃油效率:
ggplot(mpg, aes(x = class, y = hwy)) +
  geom_boxplot()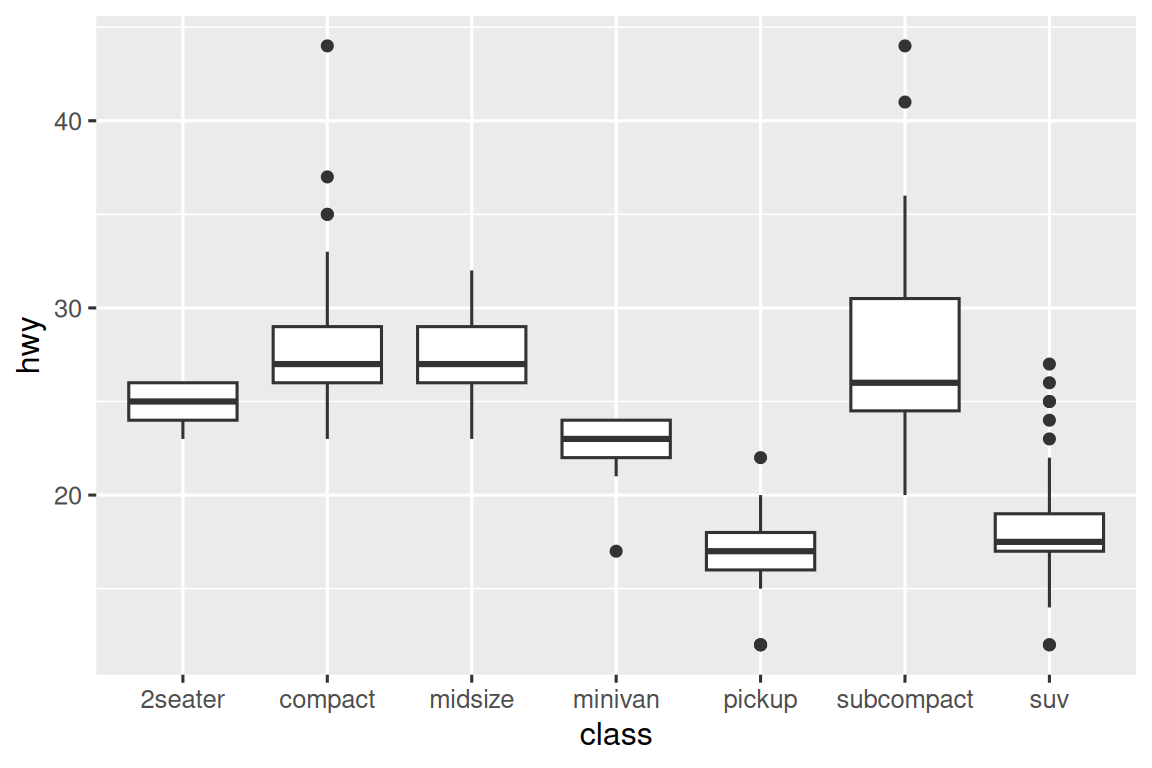
按 hwy 的中位数重排 class,趋势会更容易看见:
ggplot(mpg, aes(x = fct_reorder(class, hwy, median), y = hwy)) +
  geom_boxplot()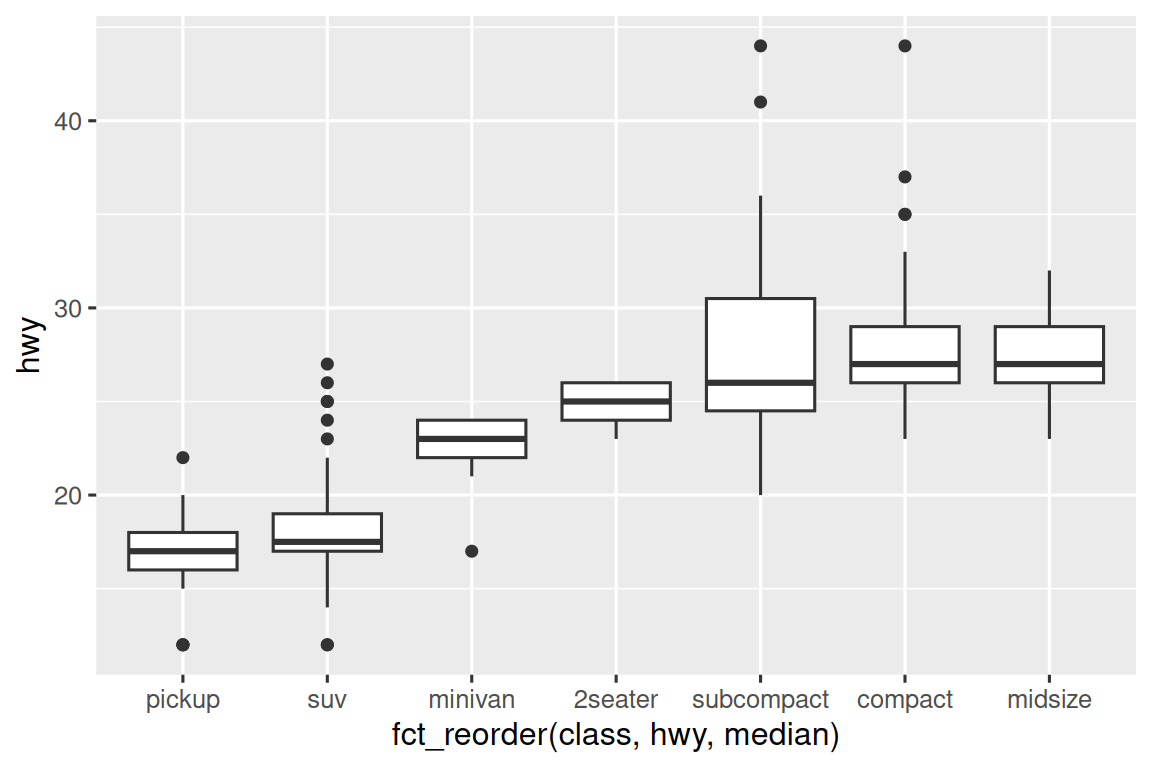
类别名称较长时,横向箱线图更好读。交换 x 与 y 的映射,就相当于把图转过 90 度:
ggplot(mpg, aes(x = hwy, y = fct_reorder(class, hwy, median))) +
  geom_boxplot()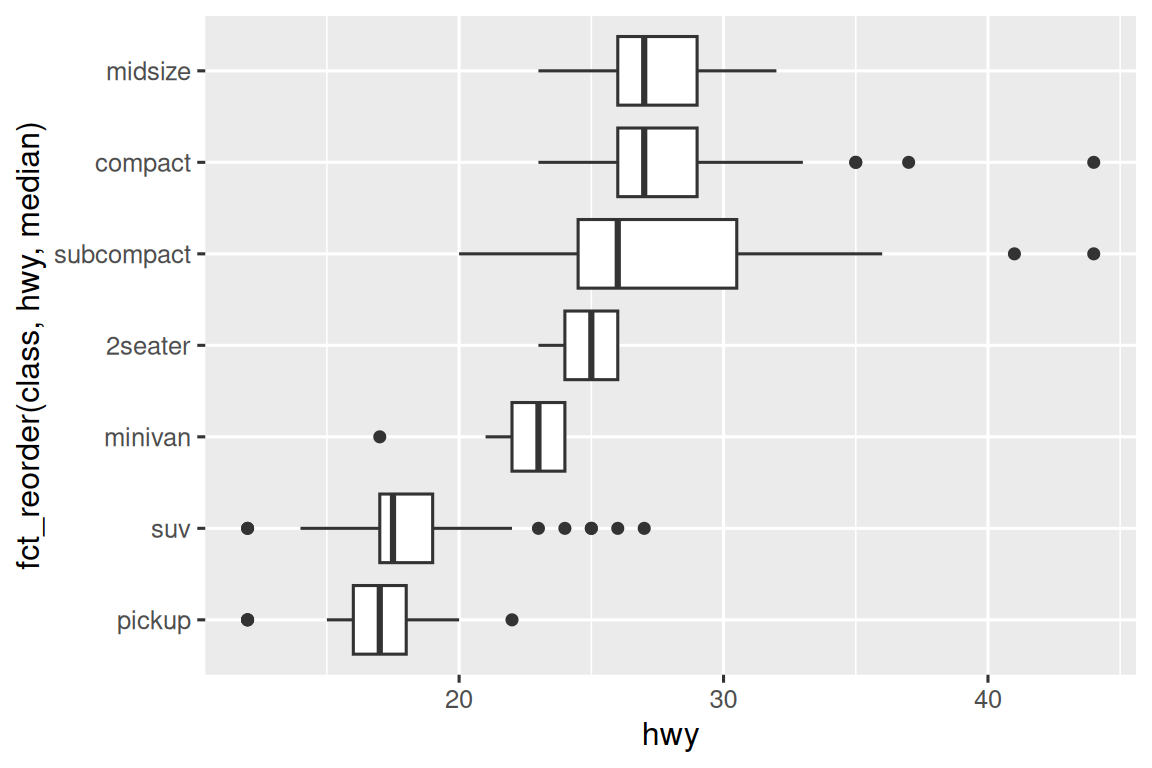
10.5.1.1 练习
- 使用刚学到的方法,改善取消与未取消航班计划起飞时间的比较图。
- 根据 EDA,
diamonds中哪个变量最有助于预测价格?它与cut有什么关系?这两种关系为什么会让低切工组显得更贵? - 不交换 x、y,而是在纵向箱线图后加一层
coord_flip(),产生横向图。两种方式有什么异同? - 箱线图诞生于数据量小得多的年代,在大数据中可能显示多得令人难以阅读的“离群点”。字母值图是一种替代。安装 lvplot,尝试用
geom_lv()展示不同切工的价格分布。你学到了什么,怎样解释这些图? - 分别用
geom_violin()、分面的geom_histogram()、着色的geom_freqpoly()、着色的geom_density(),展示价格与某个类别变量的关系。比较四种图:用类别分组比较数值分布时,它们各有什么优缺点? - 小数据集可以用
geom_jitter()缓解重叠,观察连续变量与类别变量的关系。ggbeeswarm 提供了类似的方法,请列出并简述各自作用。
10.5.2 两个类别变量
要画两个类别变量的共同变化,先要统计每种类别组合有多少观测。一种办法是使用内置的 geom_count():
ggplot(diamonds, aes(x = cut, y = color)) +
  geom_count()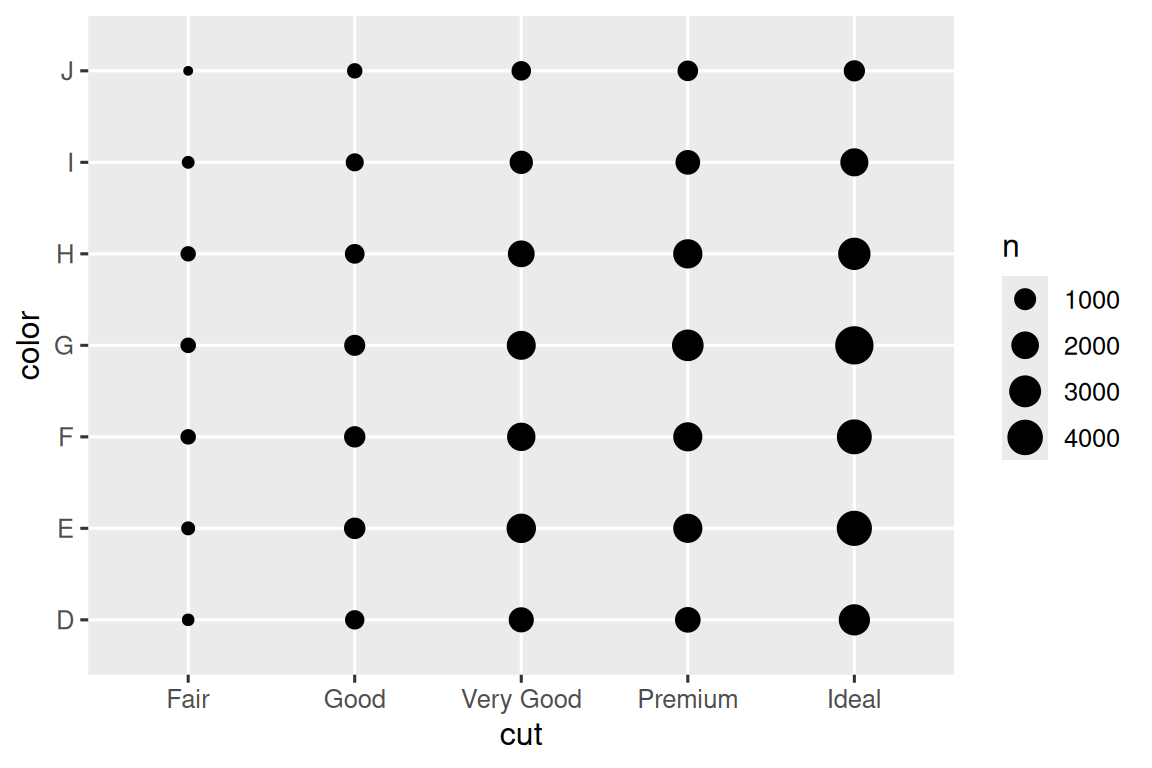
圆的大小表示相应组合出现的次数。如果某些 x 类别和某些 y 类别特别经常一起出现,就能看到共同变化。另一种方法是先用 dplyr 计数:
diamonds |>
  count(color, cut)
#> # A tibble: 35 × 3
#>   color cut           n
#>   <ord> <ord>     <int>
#> 1 D     Fair        163
#> 2 D     Good        662
#> 3 D     Very Good  1513
#> 4 D     Premium    1603
#> 5 D     Ideal      2834
#> 6 E     Fair        224
#> # ℹ 29 more rows
再用 geom_tile() 和填充色展示:
diamonds |>
  count(color, cut) |>
  ggplot(aes(x = color, y = cut)) +
  geom_tile(aes(fill = n))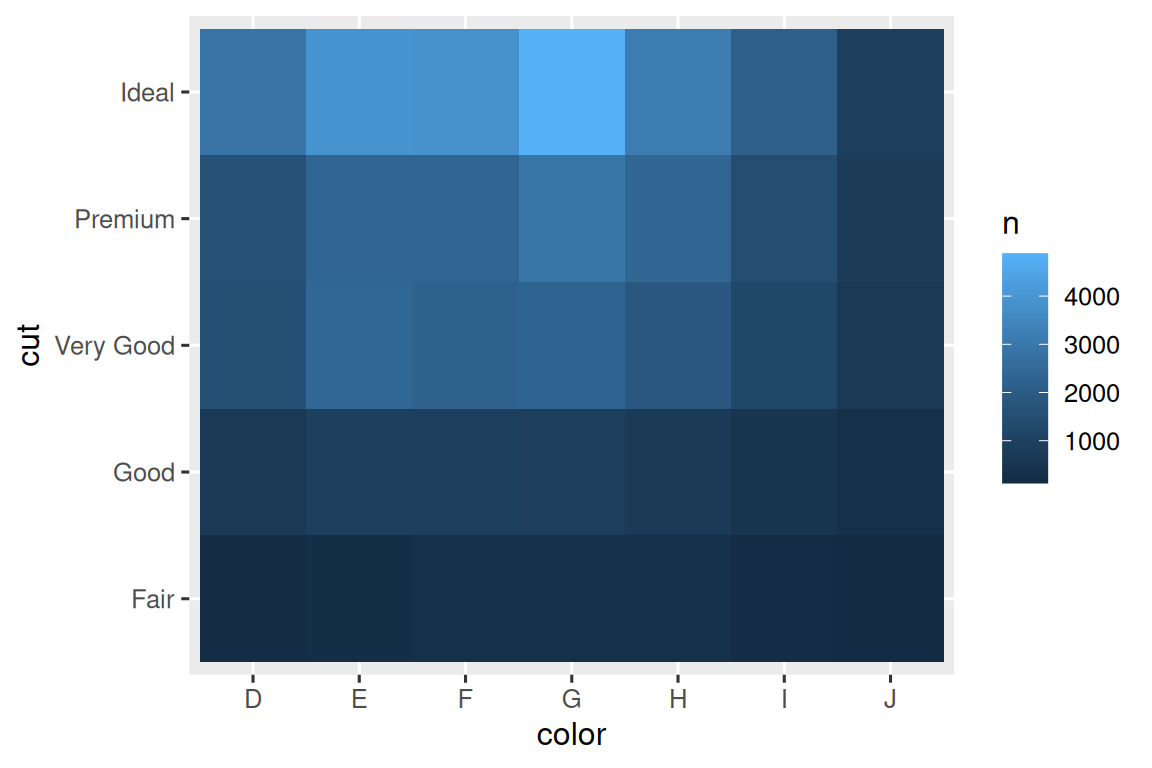
若类别没有固有顺序,可以尝试 seriation,同时重新排列行列,使模式更清楚。较大的图还可以尝试 heatmaply,制作交互式图形。
10.5.2.1 练习
- 怎样重新缩放上面的计数数据,使图更清楚地显示每种颜色内部的切工分布,或每种切工内部的颜色分布?
- 把
color映射到 x,把cut映射到 fill,画分段条形图,能得到哪些不同认识?计算每一段的观测数。 - 结合 dplyr 与
geom_tile(),探索平均起飞延误如何随目的地与月份变化。图为什么难读?怎样改善?
10.5.3 两个数值变量
geom_point() 散点图是观察两个数值变量共同变化的好方法。点的排列会形成模式。例如,钻石的克拉数与价格呈正向关系:克拉数越大,价格一般越高,图形呈明显的非线性上升。原文将这一形态称为 exponential;这里的图本身并没有确定唯一的函数形式。
ggplot(smaller, aes(x = carat, y = price)) +
  geom_point()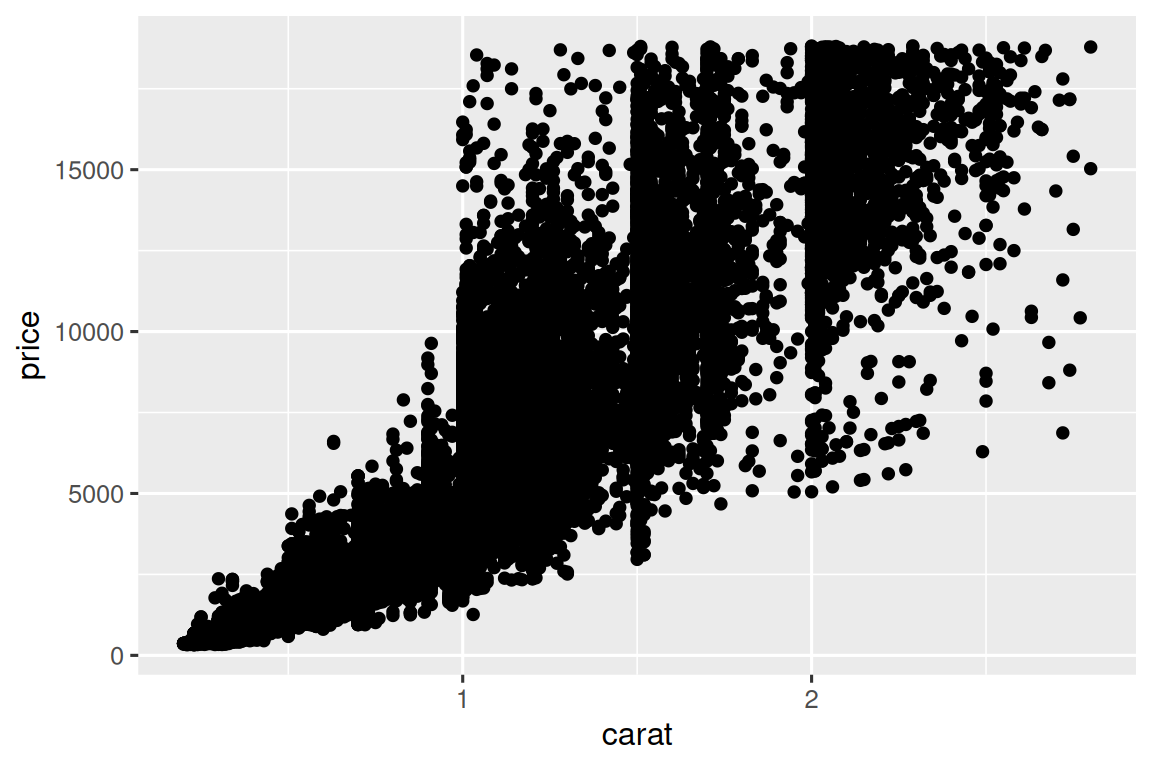
这一节使用 smaller,专注于占主体的小于 3 克拉的钻石。数据量增加后,散点不断重叠,最终堆成均匀的黑块,既难以判断二维密度差异,也难以看清趋势。一个办法是用 alpha 添加透明度:
ggplot(smaller, aes(x = carat, y = price)) +
  geom_point(alpha = 1 / 100)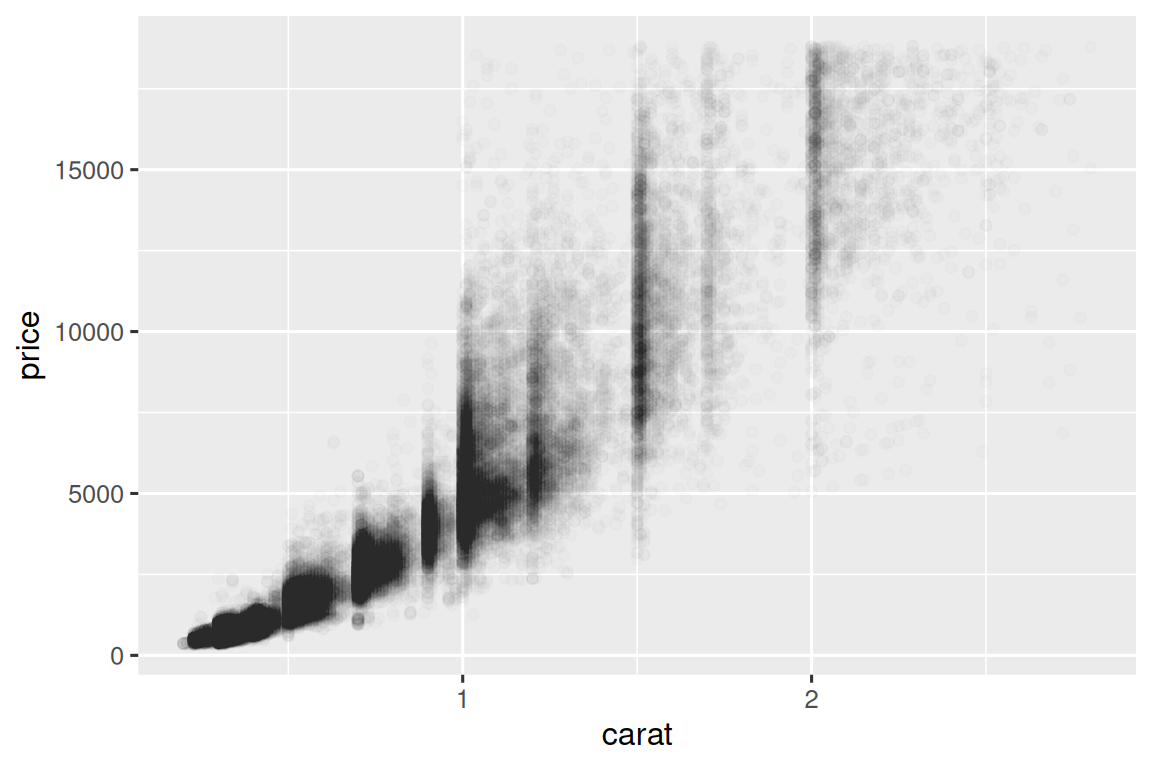
但面对很大的数据,透明度仍可能不够。另一种办法是分箱:前面的直方图与频数折线在一维分箱,现在可以用 geom_bin2d() 和 geom_hex() 在二维平面上分箱。前者使用矩形,后者使用六边形,再用填充色表示每个箱内的点数。使用 geom_hex() 需要安装 hexbin 包。
ggplot(smaller, aes(x = carat, y = price)) +
  geom_bin2d()
#> `stat_bin2d()` using `bins = 30`. Pick better value `binwidth`.

# install.packages("hexbin")
ggplot(smaller, aes(x = carat, y = price)) +
  geom_hex()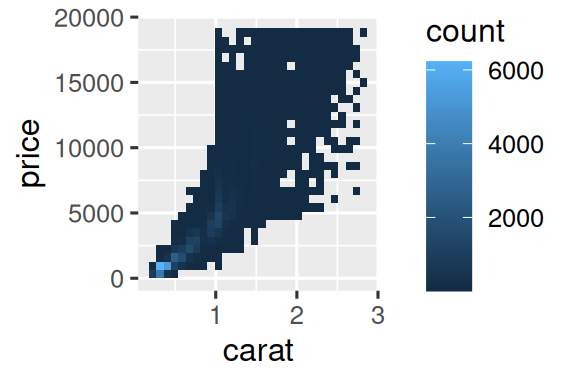
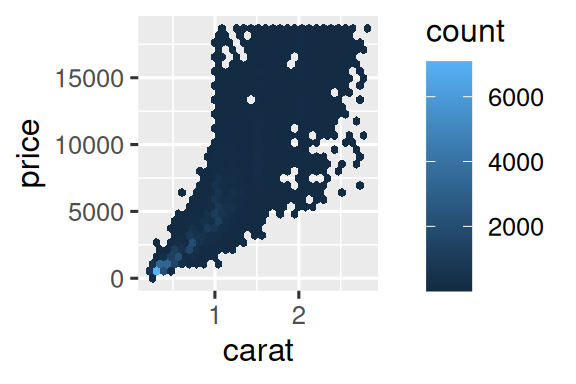
也可以只给一个连续变量分箱,把它当成类别变量,然后使用前面“类别加数值”的方法。比如给 carat 分箱,再为每组画一个箱线图:
ggplot(smaller, aes(x = carat, y = price)) +
  geom_boxplot(aes(group = cut_width(carat, 0.1)))
#> Warning: Orientation is not uniquely specified when both the x and y aesthetics are
#> continuous. Picking default orientation 'x'.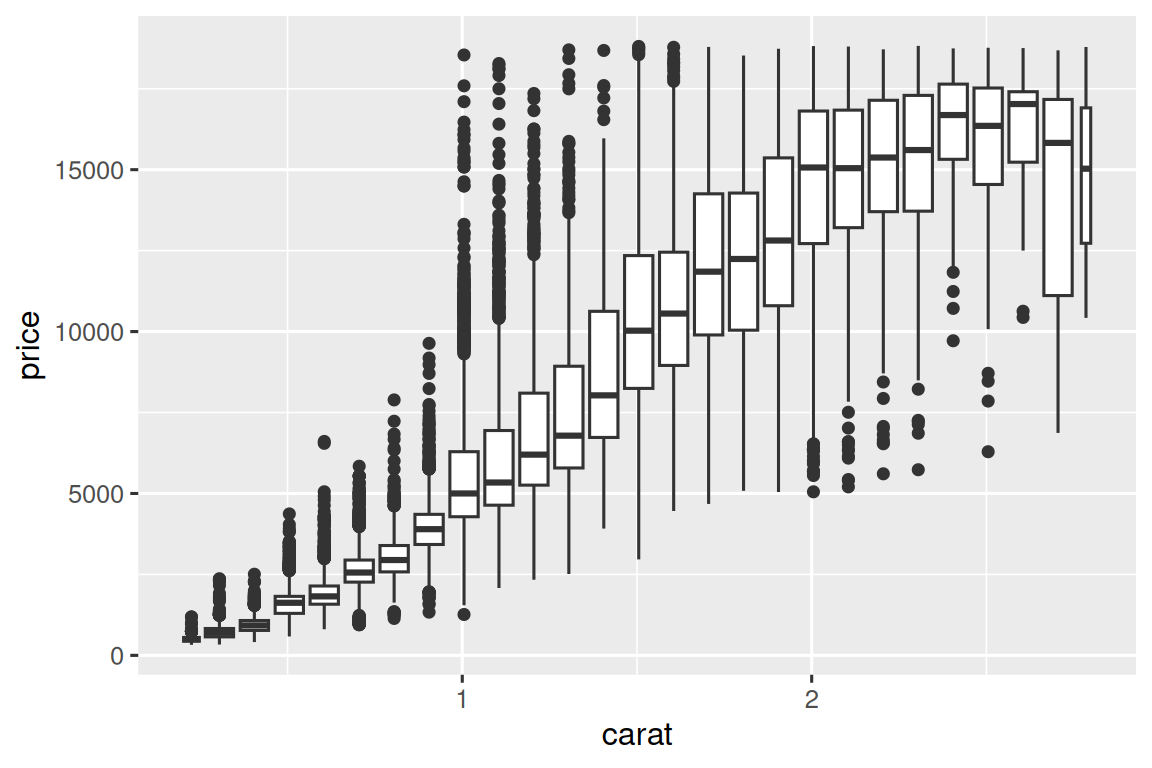
cut_width(x, width) 把 x 切分成指定宽度的箱。默认箱线图不会清楚显示每组包含多少点,各组箱体看起来差不多,主要区别可能只是离群点的多少。设置 varwidth = TRUE 可用箱宽表达组大小。
10.5.3.1 练习
- 除了箱线图,还可以用频数折线概括条件分布。使用
cut_width()与cut_number()时分别要考虑什么?这会怎样影响carat与price二维分布的显示? - 按价格分组,画出克拉数的分布。
- 很大的钻石与小钻石,价格分布有什么不同?符合预期,还是让你意外?
- 结合两种已学方法,同时展示
cut、carat与price的联合分布。 - 二维图可以揭示一维图看不到的离群点。例如,下面某些观测的 x、y 单独看都正常,组合起来却不寻常。为什么这时散点图比二维分箱图更适合?
diamonds |>
  filter(x >= 4) |>
  ggplot(aes(x = x, y = y)) +
  geom_point() +
coord_cartesian(xlim = c(4, 11), ylim = c(4, 11))- 不用
cut_width()生成等宽箱,改用cut_number()生成包含大致相同点数的箱,有什么优点与缺点?
ggplot(smaller, aes(x = carat, y = price)) +
  geom_boxplot(aes(group = cut_number(carat, 20)))
10.6 模式与模型
如果两个变量存在系统性关系,它就会在数据中形成模式。发现模式时,可以问:
- 它是否只是巧合,也就是随机偶然?
- 怎样描述它暗示的关系?
- 这种关系有多强?
- 哪些其他变量可能影响它?
- 分别观察各个子群时,关系是否改变?
模式给出关系的线索,也就是共同变化。如果说变化带来不确定性,那么共同变化可以减少不确定性:一个变量的值能帮助更好地预测另一个变量。只有在关系确实是因果关系这一特殊情形下,才可能通过控制一个变量来控制另一个;单凭探索图不能证明因果。
模型是从数据中提取模式的工具。钻石的切工与价格不容易直接理解,因为切工与克拉数、克拉数与价格都紧密相关。我们可以先用模型去除价格与克拉数之间很强的关系,再探索余下的细节。
以下代码先对 price 和 carat 取对数,用克拉数预测价格,再计算残差。随后对残差取指数,以观察相对于模型所预测价格的差异:
library(tidymodels)

diamonds <- diamonds |>
  mutate(
    log_price = log(price),
    log_carat = log(carat)
  )

diamonds_fit <- linear_reg() |>
  fit(log_price ~ log_carat, data = diamonds)

diamonds_aug <- augment(diamonds_fit, new_data = diamonds) |>
  mutate(.resid = exp(.resid))

ggplot(diamonds_aug, aes(x = carat, y = .resid)) +
  geom_point()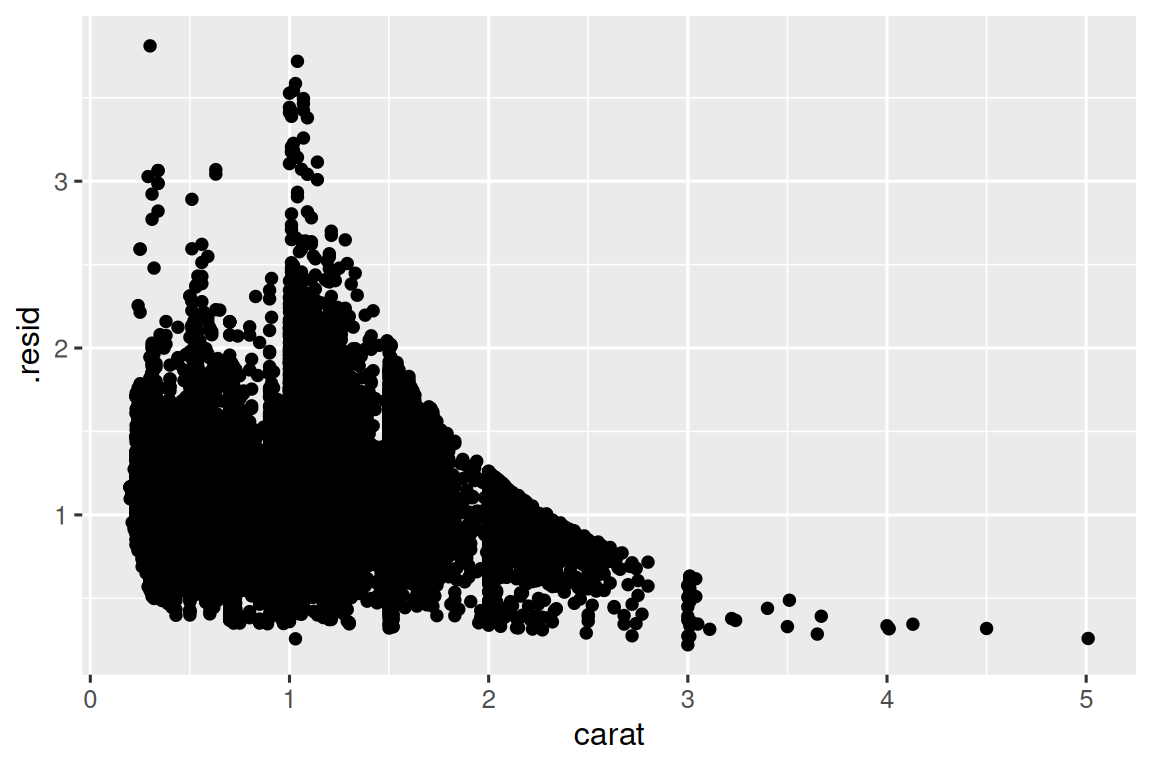
移除价格与克拉数之间的强关系后,切工与相对价格之间出现了符合预期的趋势:对于相似重量的钻石,切工更好通常也更贵。
ggplot(diamonds_aug, aes(x = cut, y = .resid)) +
  geom_boxplot()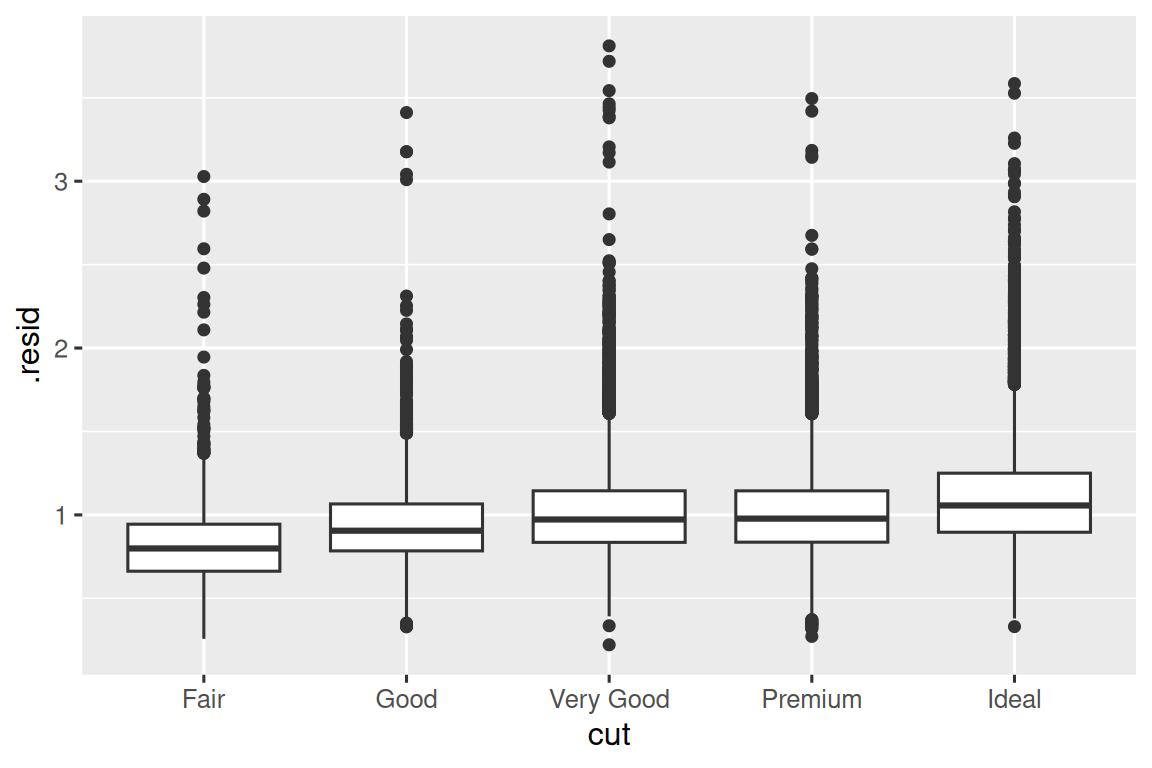
本书不继续展开建模。掌握数据整理和编程工具以后,再理解模型是什么、怎样工作会更容易。
10.7 本章小结
本章介绍了多种理解数据变化的工具,既包括一次处理一个变量的方法,也包括处理两个变量的方法。如果数据有几十甚至几百个变量,这样的范围可能显得受限,但它们正是其他技术的基础。下一章将讨论如何把分析结果传达给别人。
原文脚注:需要明确说明函数或数据集来自哪个包时,使用 package::function() 或 package::dataset 这一形式。
来源与权利说明:全书首页声明 CC BY-NC-ND 3.0(https://creativecommons.org/licenses/by-nc-nd/3.0/)。本次中文翻译属于改编,不把公开 CC 的 ND 条款理解为自动允许翻译。











暂无评论内容