


原作者:Kitson Kelly|原文发表于 2025 年 3 月 18 日|来源:Deno Blog。中文翻译与技术审校:未完纪,2026 年 10 月 5 日。
编者说明:本文为原文完整译稿,保留全部示例代码及示例输出的含义;代码来自 2025 年的实验,未在本次审校中运行。依赖、模型行为与接口可能随版本变化,文末列出静态审查发现。本文是 Deno 大模型系列第二篇,前置文章为 The Dino, the Llama, and the Whale,已完整核对。
在上一篇文章中,我演示了如何通过 Deno 与本地大语言模型交互。这一次,我们再向前走一步,构建一个检索增强生成(RAG)AI 智能体。RAG 智能体把检索方法和生成模型结合起来,使查询的回答更准确,也更贴合上下文。
原文同时提供配套的 YouTube 教程。
正如上一篇所说,我现在的日常工作是向投资者、董事会和企业高管提供技术影响方面的建议。尤其是在企业投资过程中,我们会开展大量技术尽职调查,需要在很短的时间内阅读、分析许多高度机密的文档。为了弄清 AI 能否以可证明安全的方式成为辅助工具,我开始尝试 RAG 智能体。
这篇文章会完成以下工作:
- 获取并预处理几篇博客文章,供 AI 智能体使用。
- 创建智能体:它可以查询数据库中的文章、判断检索文档与问题是否相关,并在必要时改写问题。
- 最后根据收集到的信息生成回答。
开始之前
本文承接上一篇,假设你已经在本机安装较新版本的 Deno 和 Ollama。
上一篇通过 Ollama 使用的是 80 亿参数的 DeepSeek R1(deepseek-r1:8b)。这次仍由它生成最终输出,但还会使用两个针对特定任务的模型:
- Mixedbread 的嵌入模型
mxbai-embed-large:把文本转换成更容易被 AI 系统搜索的表示。 - Meta 的 30 亿参数模型
llama3.2:3b:支持工具调用,使模型能够调用工具或函数来执行额外操作。
原作者提醒:Ollama 中有不少模型理论上支持工具调用,但在大小适合本地运行的模型里,当时只有 Llama 3.2 能在他的实验中正常工作。这是作者当时的经验,不是对其他模型当前能力的判断。
确保这两个模型已下载到本地:
ollama pull mxbai-embed-large
ollama pull llama3.2:3b前置步骤补充(来自第一篇):还需要 ollama pull deepseek-r1:8b,并确认 Ollama 服务运行在本地 11434 端口;可用 ollama list 检查。模型下载需要网络、磁盘空间和足够的内存。第一篇使用 VS Code、Deno 扩展和 Jupyter Notebook:创建项目目录,启用 Deno,创建 Notebook 并选择 Deno 内核。
开始之前,先告诉 Deno 如何处理动态导入的 npm 依赖。在项目目录建立最小的 deno.json:
{
  "nodeModulesDir": "auto"
}
将 nodeModulesDir 设为 auto,能使这里的 Jupyter Notebook 模块解析正常工作;也可能不加这一项也能运行。本文有些示例专为 Deno Jupyter Notebook 编写,例如显示智能体结构图的代码。新建 Notebook 的步骤见前一篇。
收集文档
第一步是为智能体获取、处理文档:从 Deno 博客抓取几篇文章,将其处理后保存到内存向量存储,再创建访问该存储的检索器。
我们使用 Cheerio 获取并解析 HTML,然后使用递归文本切分器把博客拆成更小的文档,方便智能体处理。最后把文档转成智能体可以搜索和管理的形式。
也可以用其他向量存储持久化数据。原作者建议本地场景考虑 Chroma:通过 Docker 容器部署比较容易,LangChain 也提供支持。
Notebook 单元格 1
import { OllamaEmbeddings } from "npm:@langchain/ollama";

const embeddings = new OllamaEmbeddings({
  model: "mxbai-embed-large",
});

import "npm:cheerio";
import { CheerioWebBaseLoader } from "npm:@langchain/community/document_loaders/web/cheerio";

const urls = [
  "https://deno.com/blog/not-using-npm-specifiers-doing-it-wrong",
  "https://deno.com/blog/v2.1",
  "https://deno.com/blog/build-database-app-drizzle",
];
const docs = await Promise.all(
  urls.map((url) => new CheerioWebBaseLoader(url).load()),
);
const docsList = docs.flat();

import { RecursiveCharacterTextSplitter } from "npm:@langchain/textsplitters";

const splitter = new RecursiveCharacterTextSplitter({
  chunkSize: 500,
  chunkOverlap: 50,
});
const allSplits = await splitter.splitDocuments(docsList);
console.log(`Split blog posts into ${allSplits.length} sub-documents.`);
import { MemoryVectorStore } from "npm:langchain/vectorstores/memory";

const vectorStore = await MemoryVectorStore.fromDocuments(
  allSplits,
  embeddings,
);

const retriever = vectorStore.asRetriever();
原文单元格输出:
Split blog posts into 170 sub-documents.这样,我们就为智能体获取、解析、切分并保存了三篇 Deno 博客。170 是作者运行时的结果,网页内容变化后,切分数量也可能变化。
图与状态
在 RAG 智能体中,“图”通常指一种结构化的信息表示,用来支持智能体在决策或生成过程中进行检索、推理和上下文管理。这里的图要处理用户问题,只需要简单的状态。先定义它,也方便后续通过它的类型构建系统的其他部分。
Notebook 单元格 2
import { Annotation } from "npm:@langchain/langgraph";
import { BaseMessage } from "npm:@langchain/core/messages";

const GraphState = Annotation.Root({
  messages: Annotation<BaseMessage[]>({
    reducer: (x, y) => x.concat(y),
    default: () => [],
  }),
});
把检索器变成工具
现在已经有了用于搜索、访问文档的检索器接口,还需要把它包装成能够交给智能体使用的工具。
Notebook 单元格 3
import { createRetrieverTool } from "npm:langchain/tools/retriever";
import { ToolNode } from "npm:@langchain/langgraph/prebuilt";

const tool = createRetrieverTool(
  retriever,
  {
    name: "retrieve_blog_posts",
    description:
      "Search and return information about Deno from various blog posts.",
  },
);
const tools = [tool];

const toolNode = new ToolNode<typeof GraphState.State>(tools);
智能体工作流的组成部分
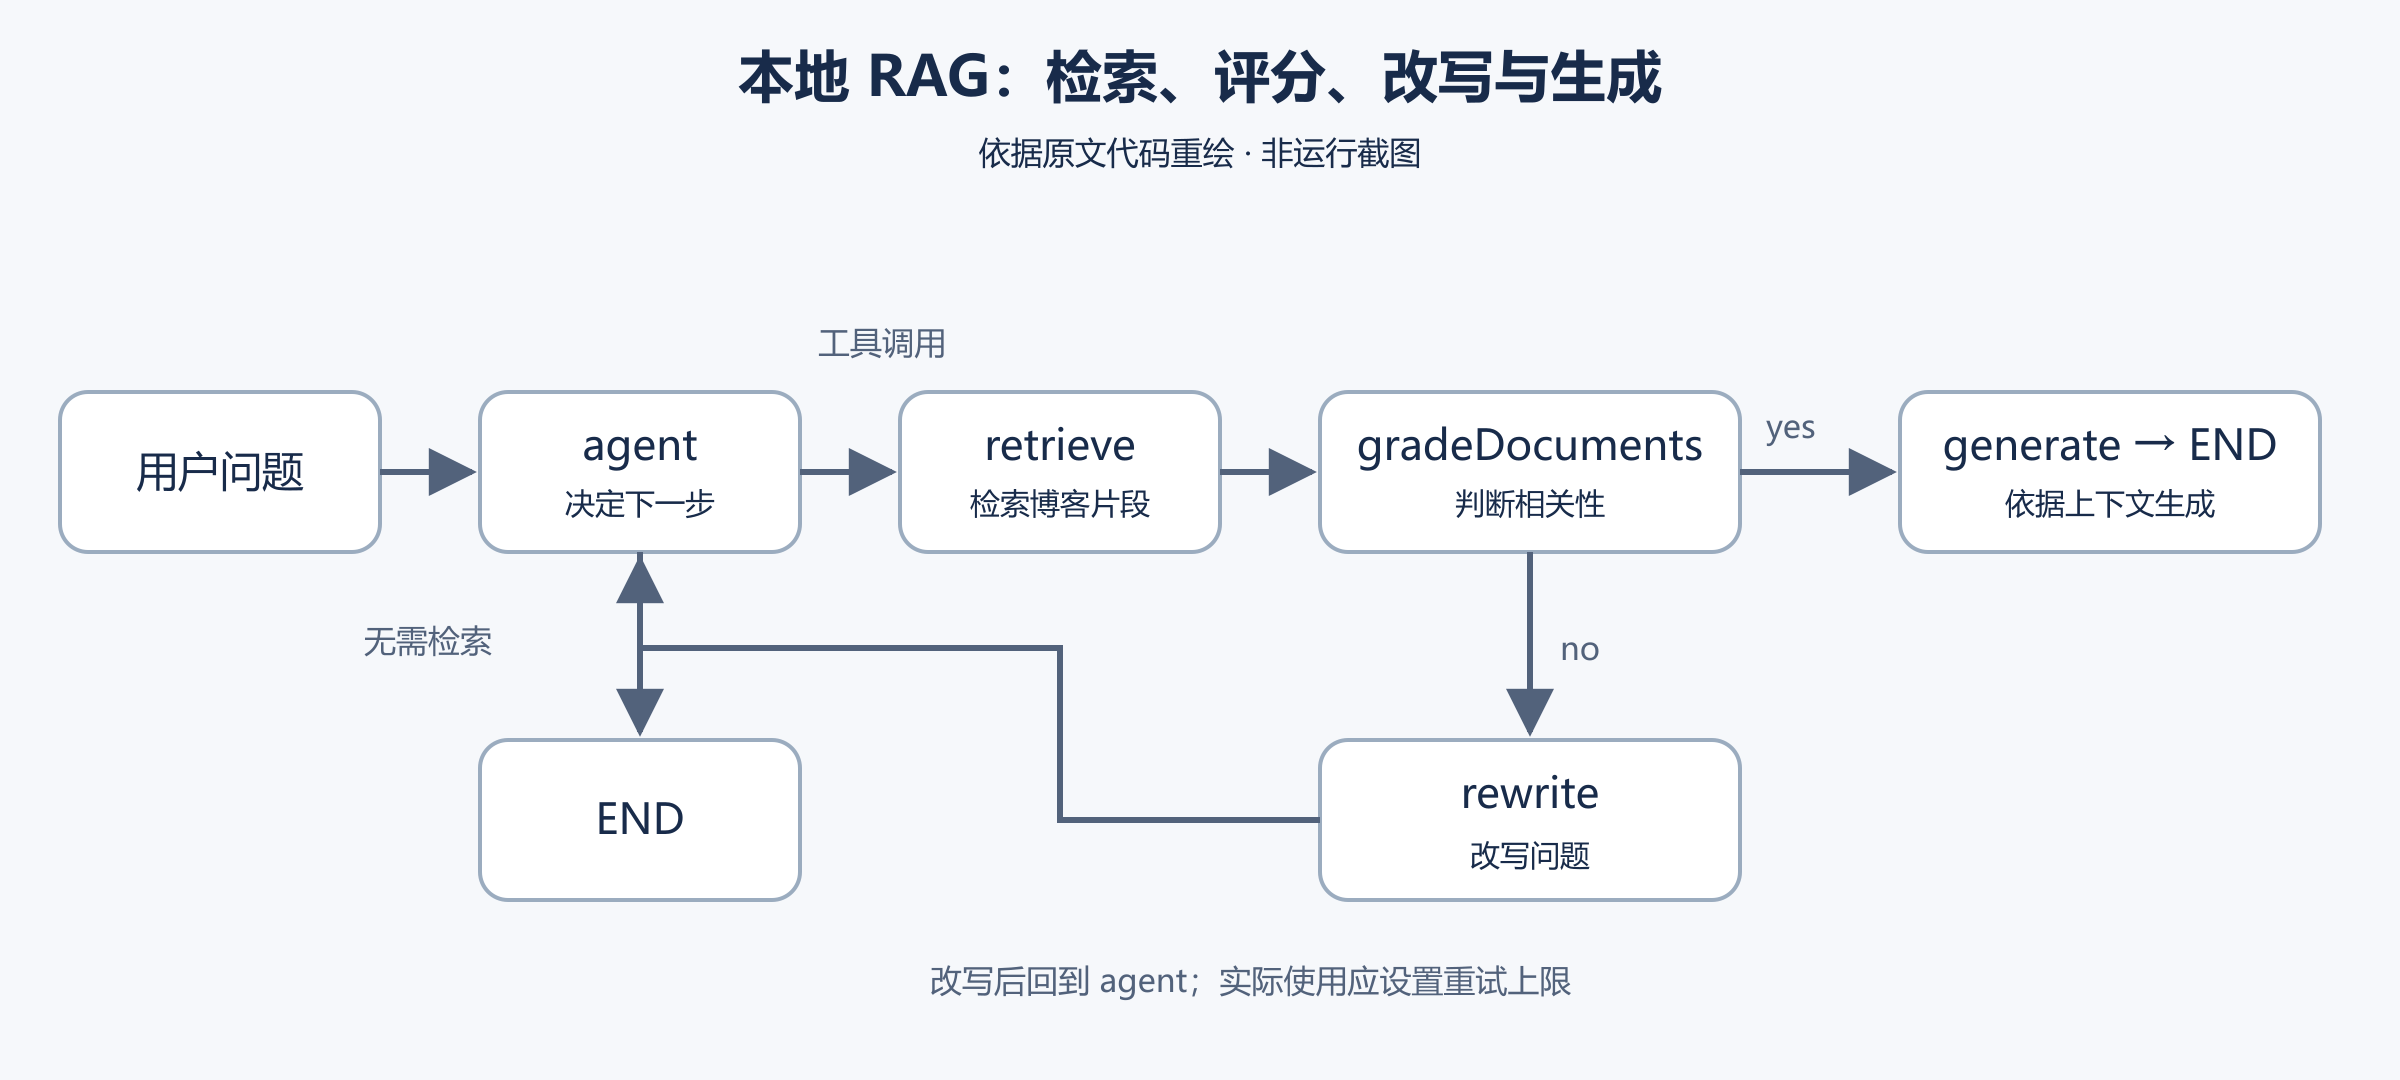
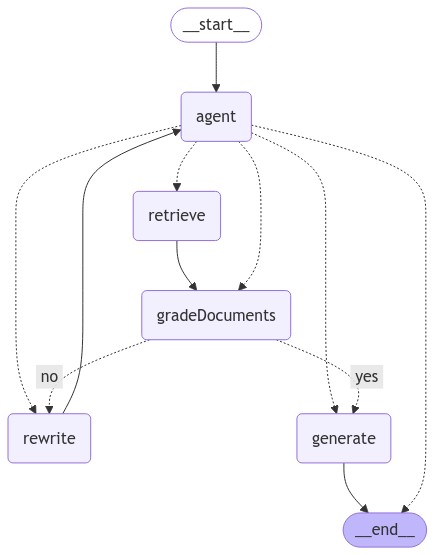
接下来创建几个节点(函数),分别承担工作流中的独立任务:
shouldRetrieve():决定是否需要从数据库检索文档。gradeDocuments():判断文档是否相关。checkRelevance():处理相关性评分并选择分支。agent():决定下一步动作的核心智能体。rewrite():改写查询,尝试找到相关文档。generate():根据问题和找到的文档生成输出。
这些节点读取图状态,返回消息更新或路由结果。原文概括为“每个节点读取状态并返回消息”,但其中两个路由函数实际返回字符串。
Notebook 单元格 4
为便于复核与复现,代码中的提示词保留英文。评分提示词要求模型判断文档是否与问题相关,只输出 yes/no;改写提示词要求理解问题的语义意图并给出改进后的问题;生成提示词要求依据检索上下文作答,不知道就直说,回答最多三句话。
import { ChatPromptTemplate } from "npm:@langchain/core/prompts";
import { ChatOllama } from "npm:@langchain/ollama";
import { isAIMessage, isToolMessage } from "npm:@langchain/core/messages";
import { END } from "npm:@langchain/langgraph";
import { z } from "npm:zod";

function shouldRetrieve(state: typeof GraphState.State): string {
  console.log("---DECIDE TO RETRIEVE---");
  const { messages } = state;
  const lastMessage = messages[messages.length - 1];

  if (isAIMessage(lastMessage) && lastMessage.tool_calls?.length) {
    console.log("---DECISION: RETRIEVE---");
    return "retrieve";
  }

  return END;
}

async function gradeDocuments(
  state: typeof GraphState.State,
): Promise<Partial<typeof GraphState.State>> {
  console.log("---GET RELEVANCE---");

  const tool = {
    name: "give_relevance_score",
    description: "Give a relevance score to the retrieved documents.",
    schema: z.object({
      binaryScore: z.string().describe("Relevance score 'yes' or 'no'"),
    }),
  };

  const prompt = ChatPromptTemplate.fromTemplate(
    `You are a grader assessing relevance of retrieved docs to a user question.
  Here are the retrieved docs:

  -------

  {context}

  -------

  Here is the user question: {question}
  If the content of the docs are relevant to the users question, score them as relevant.
  Give a binary score 'yes' or 'no' score to indicate whether the docs are relevant to the question.
  Yes: The docs are relevant to the question.
  No: The docs are not relevant to the question.`,
  );

  const model = new ChatOllama({
    model: "llama3.2:3b",
    temperature: 0,
  }).bindTools([tool]);

  const { messages } = state;
  const firstMessage = messages[0];
  const lastMessage = messages[messages.length - 1];

  const chain = prompt.pipe(model);

  const score = await chain.invoke({
    question: firstMessage.content as string,
    context: lastMessage.content as string,
  });

  return {
    messages: [score],
  };
}

function checkRelevance(state: typeof GraphState.State): "yes" | "no" {
  console.log("---CHECK RELEVANCE---");
  const { messages } = state;
  const lastMessage = messages[messages.length - 1];
  if (!isAIMessage(lastMessage)) {
    throw new Error(
      "The 'checkRelevance' node requires the most recent message to be an AI message.",
    );
  }

  const { tool_calls: toolCalls } = lastMessage;
  if (!toolCalls || !toolCalls.length) {
    throw new Error(
      "The 'checkRelevance' node requires the most recent message to contain tool calls.",
    );
  }

  if (toolCalls[0].args.binaryScore === "yes") {
    console.log("---DECISION: DOCS RELEVANT---");
    return "yes";
  }
  console.log("---DECISION: DOCS NOT RELEVANT---");
  return "no";
}

async function agent(
  state: typeof GraphState.State,
): Promise<Partial<typeof GraphState.State>> {
  console.log("---CALL AGENT---");

  const { messages } = state;
  const filteredMessages = messages.filter((message) => {
    if (isAIMessage(message) && message.tool_calls?.length) {
      return message.tool_calls[0].name !== "give_relevance_score";
    }
    return true;
  });

  const model = new ChatOllama({
    model: "llama3.2:3b",
    temperature: 0,
    streaming: true,
  }).bindTools(tools);

  const response = await model.invoke(filteredMessages);
  return {
    messages: [response],
  };
}

async function rewrite(
  state: typeof GraphState.State,
): Promise<Partial<typeof GraphState.State>> {
  console.log("---TRANSFORM QUERY---");

  const { messages } = state;
  const question = messages[0].content as string;
  const prompt = ChatPromptTemplate.fromTemplate(
    `Look at the input and try to reason about the underlying semantic intent / meaning.

Here is the initial question:

-------

{question}

-------

Formulate an improved question:`,
  );

  // Grader
  const model = new ChatOllama({
    model: "deepseek-r1:8b",
    temperature: 0,
    streaming: true,
  });
  const response = await prompt.pipe(model).invoke({ question });
  return {
    messages: [response],
  };
}

async function generate(
  state: typeof GraphState.State,
): Promise<Partial<typeof GraphState.State>> {
  console.log("---GENERATE---");

  const { messages } = state;
  const question = messages[0].content as string;
  // Extract the most recent ToolMessage
  const lastToolMessage = messages.slice().reverse().find((msg) =>
    isToolMessage(msg)
  );
  if (!lastToolMessage) {
    throw new Error("No tool message found in the conversation history");
  }

  const context = lastToolMessage.content as string;

  const prompt = ChatPromptTemplate.fromTemplate(
    `You are an assistant for question-answering tasks. Use the following pieces of retrieved context to answer the question. If you don't know the answer, just say that you don't know. Use three sentences maximum and keep the answer concise.

Here is the initial question:

-------

{question}

-------

Here is the context that you should use to answer the question:

-------

{context}

-------

Answer:`,
  );
  const llm = new ChatOllama({
    model: "deepseek-r1:8b",
    temperature: 0,
    streaming: true,
  });

  const ragChain = prompt.pipe(llm);

  const response = await ragChain.invoke({
    context,
    question,
  });

  return {
    messages: [response],
  };
}
生成工作流
现在把节点加入工作流:
Notebook 单元格 5
import { StateGraph } from "npm:@langchain/langgraph";

const workflow = new StateGraph(GraphState)
  .addNode("agent", agent)
  .addNode("retrieve", toolNode)
  .addNode("gradeDocuments", gradeDocuments)
  .addNode("rewrite", rewrite)
  .addNode("generate", generate);
再明确节点之间的关系,并编译工作流:
Notebook 单元格 6
import { START } from "npm:@langchain/langgraph";

// Call agent node to decide to retrieve or not
workflow.addEdge(START, "agent");

// Decide whether to retrieve
workflow.addConditionalEdges(
  "agent",
  // Assess agent decision
  shouldRetrieve,
);

workflow.addEdge("retrieve", "gradeDocuments");

// Edges taken after the `action` node is called.
workflow.addConditionalEdges(
  "gradeDocuments",
  // Assess agent decision
  checkRelevance,
  {
    // Call tool node
    yes: "generate",
    no: "rewrite", // placeholder
  },
);

workflow.addEdge("generate", END);
workflow.addEdge("rewrite", "agent");

// Compile
const app = workflow.compile();

// If running in a Jupyter notebook, display the graph visually
Deno.jupyter.image(
  await (await (await app.getGraphAsync()).drawMermaidPng()).bytes(),
);
Deno.jupyter.image 会显示工作流。下图是根据原文代码重新绘制的技术示意图,并非程序运行截图。
向智能体提问
终于可以使用智能体了。我们问它:“Deno 2.1 有哪些新功能?”看看它如何回答。
Notebook 单元格 7
import { HumanMessage } from "npm:@langchain/core/messages";

const inputs = {
  messages: [
    new HumanMessage("What are some new features of Deno 2.1?"),
  ],
};

let finalState;
for await (const output of await app.stream(inputs)) {
  for (const [key, value] of Object.entries(output)) {
    console.log(`${key} -->`);
    finalState = value;
  }
}
const lastMessage = finalState.messages[finalState.messages.length - 1];
const content = lastMessage.content
  .replace("<think>", "<details><summary>Thinking...</summary>")
  .replace("</think>", "</details>");

Deno.jupyter.md`Generated output from agent:

${content}`;
以下是原文展示的模型生成结果的中文翻译。这是来源文章中的示例记录,不是本次实测结果,也不是编辑者对相关功能的重新验证。
思考中……好,我需要根据给出的上下文弄清 Deno 2.1 的新功能。先仔细读一下上下文。
首先提到 Deno 2.1 支持 Wasm 导入。这是一个重要功能,因为它能更好地集成 WebAssembly,从而提升性能和功能。
接着是使用
deno compile编译时嵌入资源文件。这可能意味着用户能够更容易地加入图片或 CSS 之类的静态资源,而不需要额外设置。然后提到了权限提示中的堆栈跟踪。我不完全确定具体含义,但它可能通过在权限被拒绝或运行出错时提供详细信息来改善调试。
deno task被称为得到“大幅增强”,这说明任务执行可能经过性能和效率优化,运行起来更快、更顺畅。还有 Node.js 和 npm 兼容性改进。这可能意味着 Deno 与现有 Node.js 项目的配合更好,迁移或集成现有配置更容易。
列表中包括
--allow-env通配符功能,可能使用户能指定多个环境文件,或更灵活地处理环境变量。格式化和代码检查也有改进,开发者可以获得更好的代码质量检查和建议。
在 Jupyter Notebook 中显示图片,说明 Deno 现在支持直接在 Notebook 中渲染图片,这对数据可视化和教学很有用。
通过
deno publish发布时覆盖版本,使用户能够进一步控制包如何分发,也许能支持特定版本管理策略。LSP 改进意味着语言服务器得到增强,让 Deno 在 VS Code 等代码编辑环境中更好用。
性能与使用体验改进是很宽泛的类别,但说明 Deno 2.1 致力于让工具整体更高效、更好用。
最后还提到 V8 13.0,应该是升级后的 V8 引擎,能为 Deno 的运行提供更好的性能与功能。
综合来看,Deno 2.1 的重要改进主要面向开发效率、兼容性和性能。
最终回答:Deno 2.1 的新功能包括一等 WebAssembly(Wasm)支持、编译时嵌入资源文件、权限提示中的堆栈跟踪、增强的
deno task、更好的 Node.js/npm 兼容性、环境文件通配符支持、格式化与代码检查改进、Jupyter 图片显示、版本覆盖选项、LSP 改进、性能提升及 V8 引擎更新。
译者纠错:上述模型输出把 --allow-env 说成了“环境文件通配符”,这个表述不准确;该参数处理的是环境变量访问权限,不能据此理解为匹配环境文件。这里保留其原始含义并指出错误,以免把示例模型回答当作准确的产品说明。
最后
我一直认为大语言模型会成为辅助工具。对 RAG 智能体的实验不仅验证了这一点,也让我看到在本地能够实现多少功能。使用 Deno 和 LangChain 这样的框架,可以很快开展实验并进行调整。
能够创建完全由自己掌控的 AI 智能体,使把 AI 加入解决方案成为切实可行的选项。我会继续为工作探索 RAG 系统,它的应用空间十分广泛:数据处理和分析、图像生成和理解、测试生成,以及对安全假设的检查。
技术审校:运行前需要处理的问题
审查范围:仅做静态阅读和官方文档核对,未安装模型、未运行 Notebook、未执行任何示例。
- 依赖未固定:所有
npm:导入均不带版本。将它们锁定到一组经过验证的兼容版本,并保存锁文件;本文没有把 2025 年导入路径宣称为 2026 年最新接口。 - 评分结构约束偏弱:
binaryScore是任意字符串,之后只把精确的"yes"视为相关。建议改为z.enum(["yes", "no"]),验证工具名称、工具调用数量与参数。仅调用bindTools不保证模型必定调用工具,原代码会在未调用时抛错;应增加明确的失败处理。 - 重写没有独立状态:
rewrite()一直读取首条消息,改写结果又以 AIMessage 加入历史;没有单独维护当前检索问题和重试次数。建议显式保存 originalQuestion/currentQuery,记录重写次数,达到阈值后返回“资料不足”。图可能循环到框架递归上限,应处理该异常。参见 LangGraph 官方说明。 - 最后一条工具消息不等于全部检索结果:
generate()只取最近的 ToolMessage;若模型一次调用多个检索工具,较早结果可能丢失。应按当前轮次、工具名称和调用 ID 收集、去重并限制上下文大小。 - 输出类型与空结果:
finalState未检查是否存在,content也被直接当字符串调用replace;需要防空并处理内容块。把模型文本直接送到 Markdown 渲染器之前,应按前端信任边界做清理,或只显示纯文本;两次字符串替换不是 HTML 安全过滤。 - 本地运行不自动等于隔离安全:网页抓取、模型下载、包下载与某些图形渲染方式可能访问网络,应核对实际配置与数据流。Deno 官方文档明确说明 Jupyter 内核目前以
--allow-all运行,不应把它视为默认权限沙箱。机密文档实验应使用受控环境。
改动记录:原代码逐段保留,没有静默改写 API;补充前置模型步骤,修正文中对路由返回值的概括,并对模型错误与风险加注。上述修订建议未经执行验证。
版权与来源:原文及原代码归 Kitson Kelly / Deno Land Inc. 等相应权利人所有。原站页脚 © 2026 Deno Land Inc.,保留所有权利;不额外推定开放许可证。原创示意图与原文工作流图区分标明。











暂无评论内容