


原作者:Costin Leau;原文发表于 2025 年 4 月 15 日,来源:Elastic Search Labs。本文为经授权的中文译写,保留原文的示例和执行原理,并明确区分历史版本说明与编辑补充。
版本说明:原文介绍的是 Elasticsearch 8.18 中处于技术预览阶段的 LOOKUP JOIN。“当前限制”“正在开发”和“未来计划”均指原文发表时。2026 年 10 月 5 日核验时,官方滚动文档已列出更丰富的连接条件;不能拿新版文档中的语法直接套用到 8.18,也不能把本文的历史路线图当成新版能力清单。
在查询时把两个索引关联起来
LOOKUP JOIN 是 ES|QL 新增的命令,用左连接完成数据富化。它根据指定的匹配条件,将一个索引中的文档与第二个索引中的文档关联起来,整个过程原生发生在 Elasticsearch 内部。跨索引的关联在查询时动态完成,因此一些原先需要重复存储的关联信息可以单独维护。
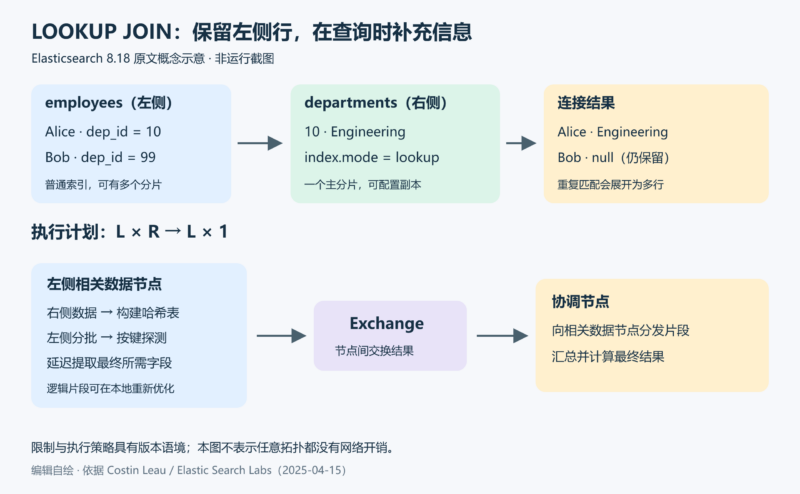
例如,员工信息放在 employees 索引中,部门信息放在 departments 索引中。两个索引共有 dep_id 字段,下面的查询就可以把员工与对应部门连接起来:
FROM employees
| LOOKUP JOIN departments ON dep_id
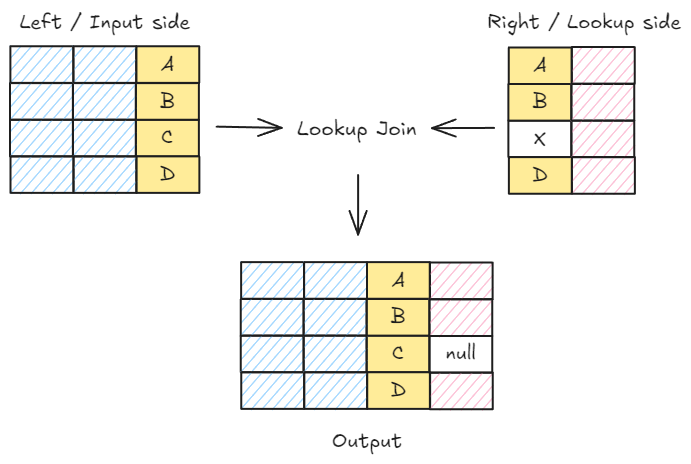
这里的普通索引 employees 位于左侧,lookup 索引 departments 位于右侧。LOOKUP JOIN 执行左外连接:左侧的每一行都会保留下来;如果右侧存在匹配文档,就补入其字段。没有匹配时,右侧新增字段为 null。右侧有多条匹配文档时会产生多行匹配结果,因此“保留所有左侧行”并不意味着输出行数恒等于左侧行数。
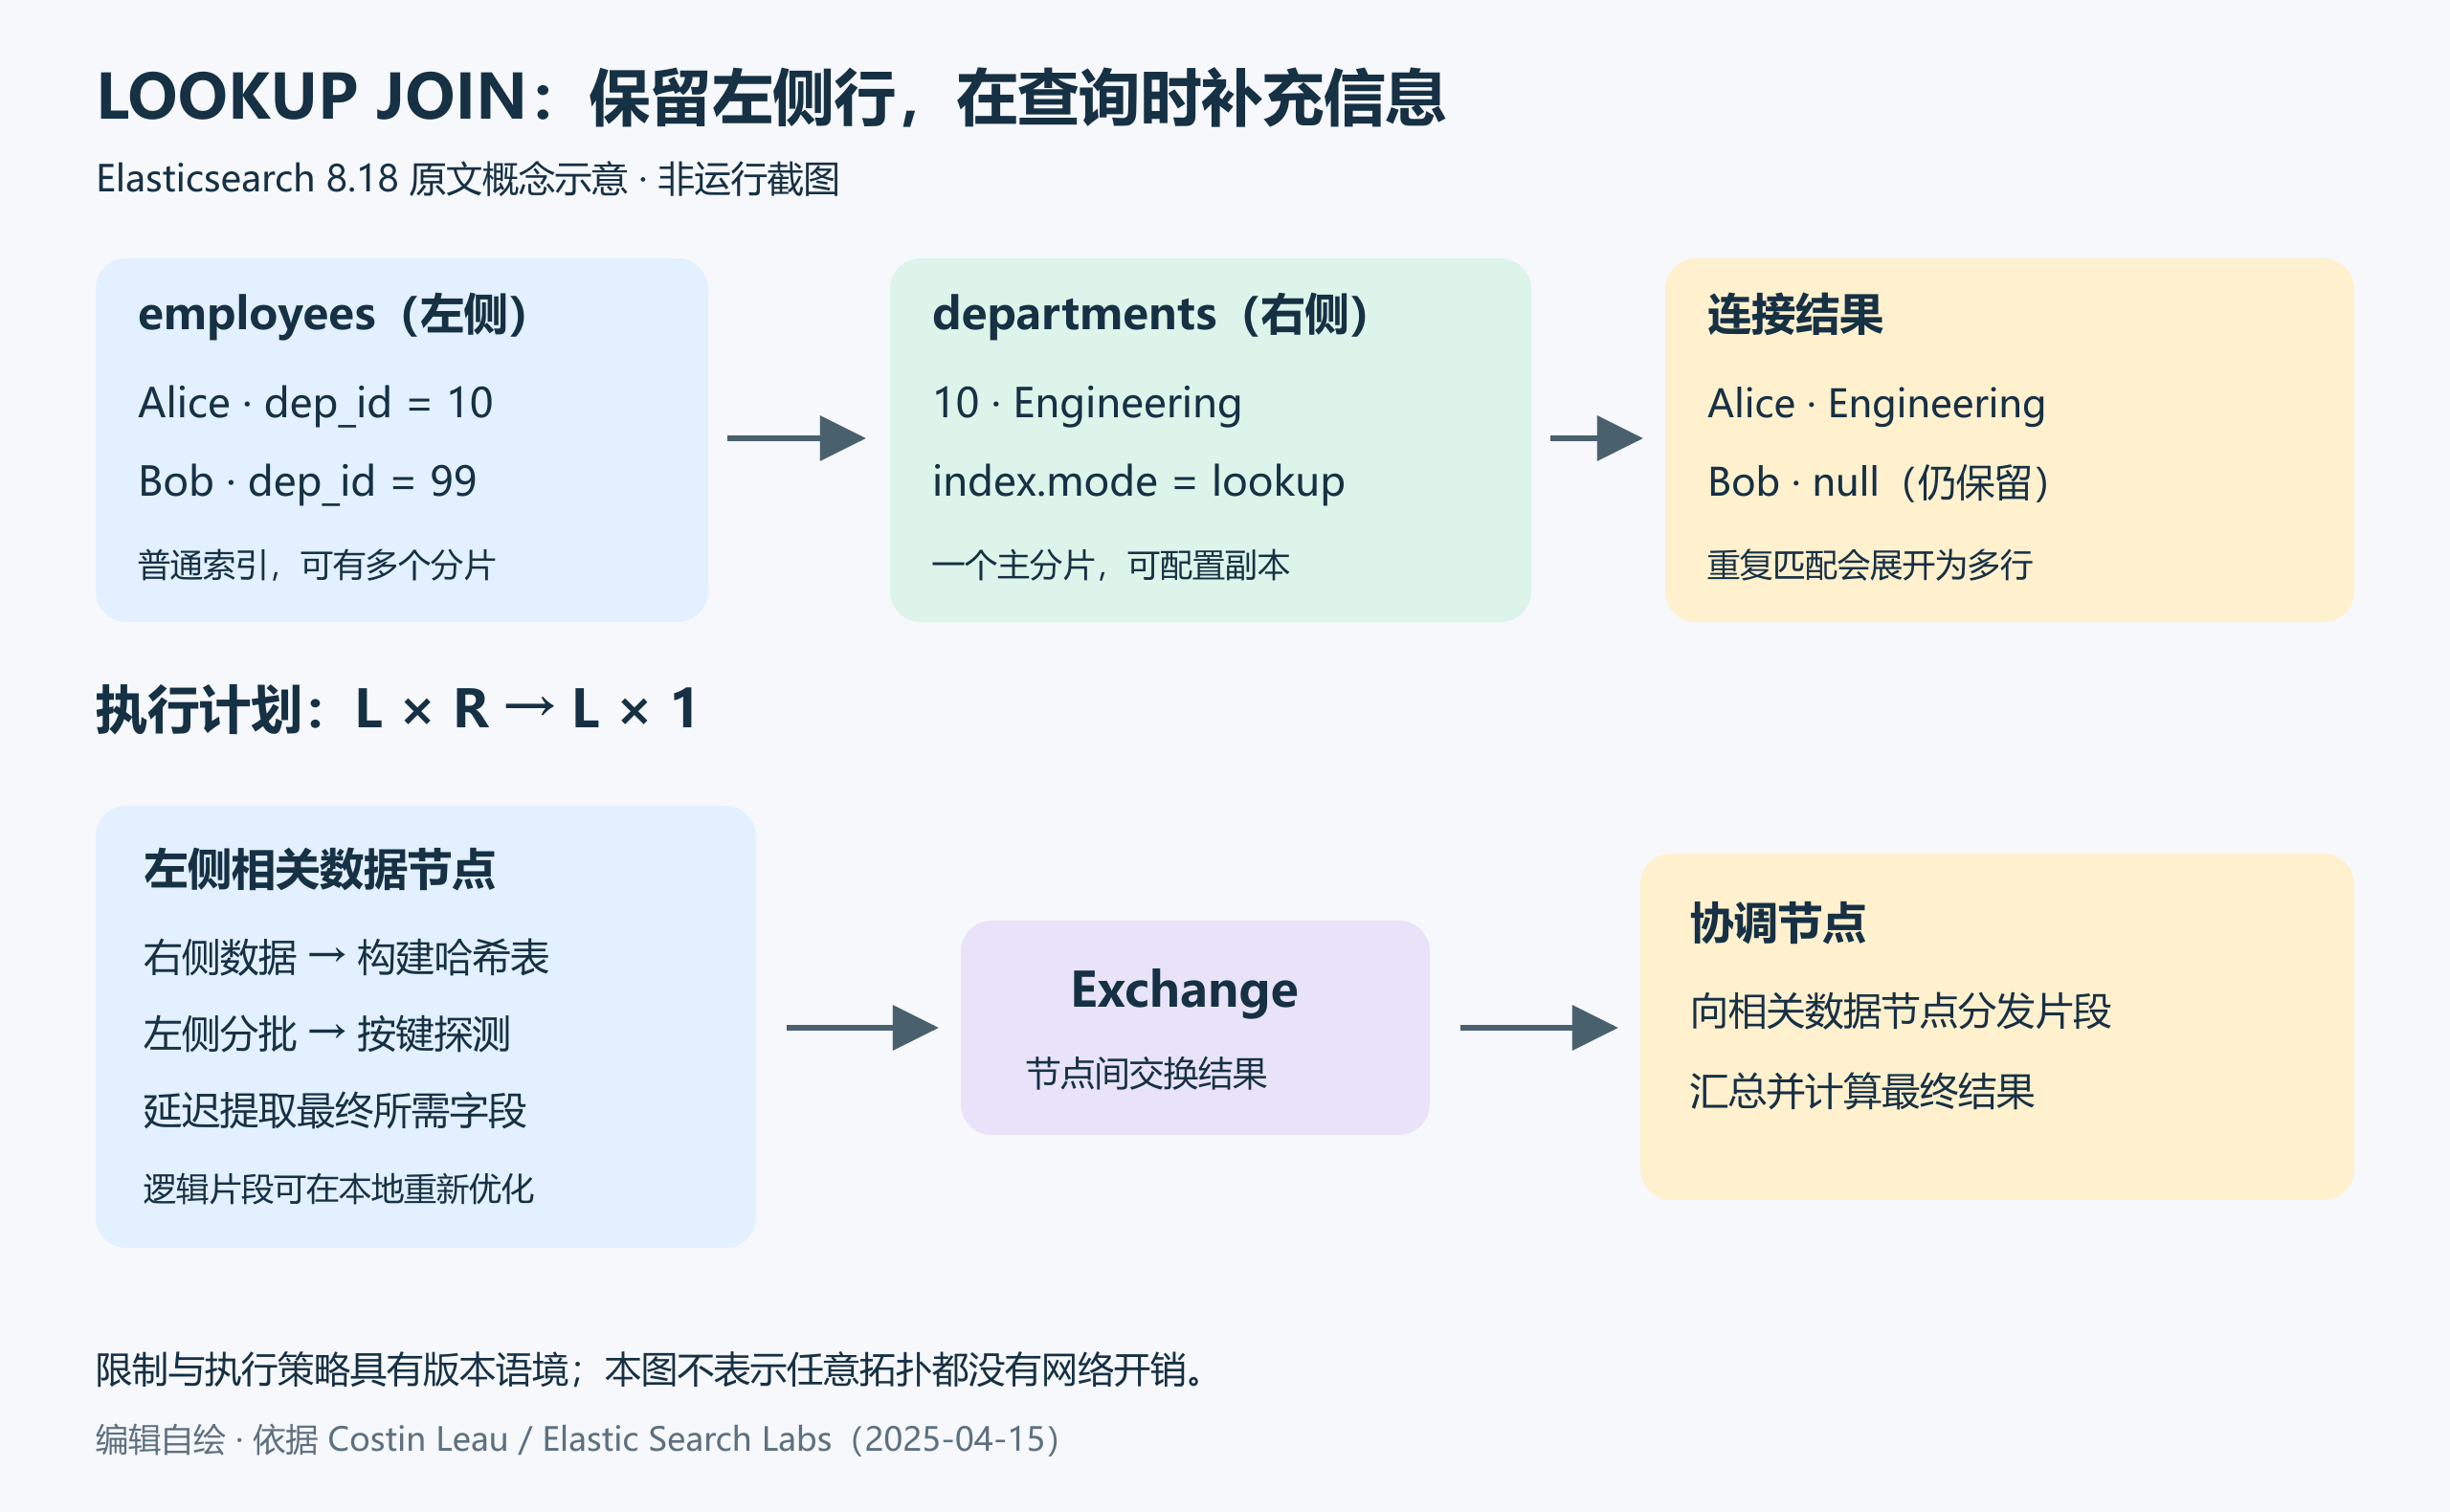
原文要求右侧索引的 index.mode 设置为 lookup。这种索引只允许一个主分片;副本数仍由索引设置决定,原文给出的默认副本数为 1。这一约束用来控制连接一侧的规模,并简化分布式连接中的数据移动问题。这里的“单分片”不是“完全没有副本”。
原文强调,除 lookup 索引模式外,这种用法无需额外预先构建富化数据,也可与其他 ES|QL 命令组合。应把这句话理解为当时的操作体验说明,不能推导成任意字段类型、任意多值字段和任意数据规模都不受限制。
过滤、聚合与连续连接
过滤既可以放在连接之前,也可以放在连接之后。例如,先筛选过去一年入职的员工,再连接部门信息,随后只保留美国部门,并按部门名称排序:
// 关联过去一年入职、所在部门位于美国的员工,并按部门名称排序
FROM employees
| WHERE hire_date > now() - 1 year
| LOOKUP JOIN departments ON dep_id
| WHERE dep_location == "US"
| KEEP last_name, dep_name, dep_location
| SORT dep_name
注意,第二个 WHERE 会去掉 dep_location 不符合条件的行,也包括部门未匹配而使该字段为 null 的行。因此,整条管道的最终结果不再包含每一个原始员工,左连接的保留语义只描述连接步骤本身。
连接也可以接在聚合之后。下面先按国家代码计算员工人数,再查出国家名称:
// 统计每个国家的员工人数
FROM employees
| STATS c = COUNT(*) BY country_code
| LOOKUP JOIN countries ON country_code
| KEEP c, country_name
| SORT country_name
还可以连续执行多个连接。原文用错误代码查找错误描述,再通过源 IP 查找主机名称,最后只输出过去一小时的错误日志:
// 查找过去一小时的错误日志,并补充主机名称与错误描述
FROM logs
| WHERE message_type : "error"
| LOOKUP JOIN message_types ON err_code
| LOOKUP JOIN host_to_ips ON src_ip
| WHERE log_date > now() - 1 hour
| KEEP log_date, log_type, err_description, host_name示例边界:这些索引名称、字段和数据集来自原文的说明场景,并不是一套包含建索引、映射和装载数据的完整脚本。message_type 用于过滤而 log_type 用于输出,二者名称在原文中不同;使用自己的数据时,应核对映射是否同时存在这两个字段,不宜自行认定它们是同一字段。
LOOKUP JOIN 是怎样执行的
为集中讨论执行阶段,先看一条不带过滤等其他命令的查询:
FROM employees
| LOOKUP JOIN departments ON dep_id
| KEEP last_name, dep_name, dep_location
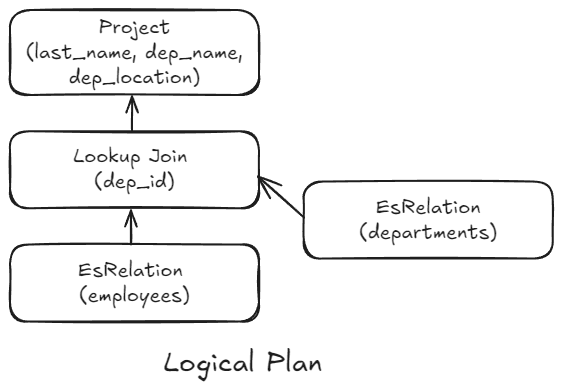
查询首先被翻译为逻辑计划。逻辑计划是一棵树,用来表达数据流和必要的转换,关注的是“这条查询意味着什么”:从员工数据读取行,与部门数据按 dep_id 左连接,再保留选定字段。
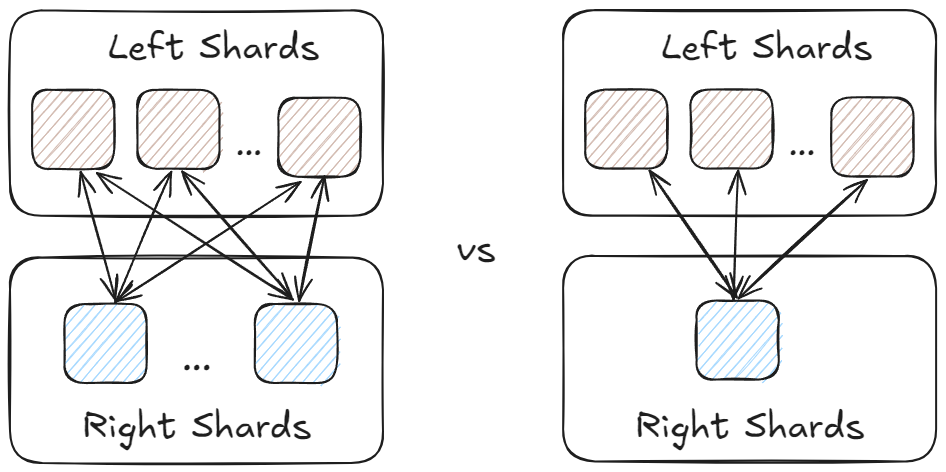
为了横向扩展,普通 Elasticsearch 索引会划分为多个分片,并分布在集群中。如果连接左右两侧都分片,假设左侧有 L 个分片、右侧有 R 个分片,就会出现 L × R 的分片配对问题。把负责补充信息的右侧限制为一个主分片,可以把这一关系缩小为 L × 1,也就是 L。原文将这种设计与 enrich 索引作了类比;两者并不是同一个功能。
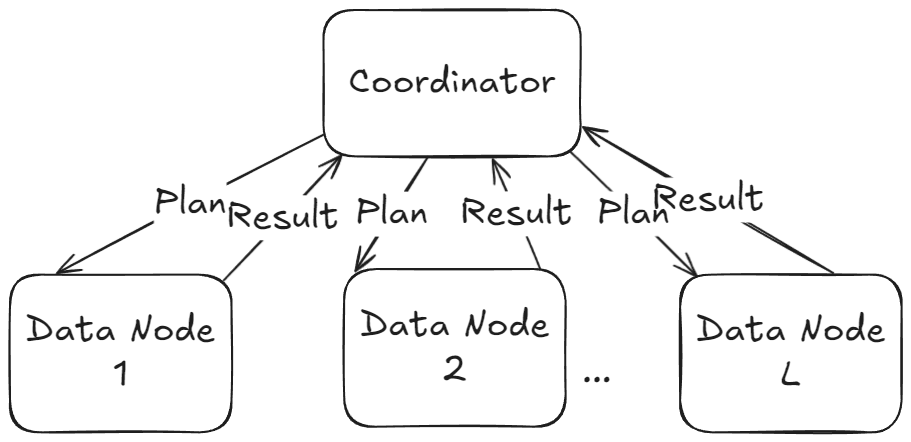
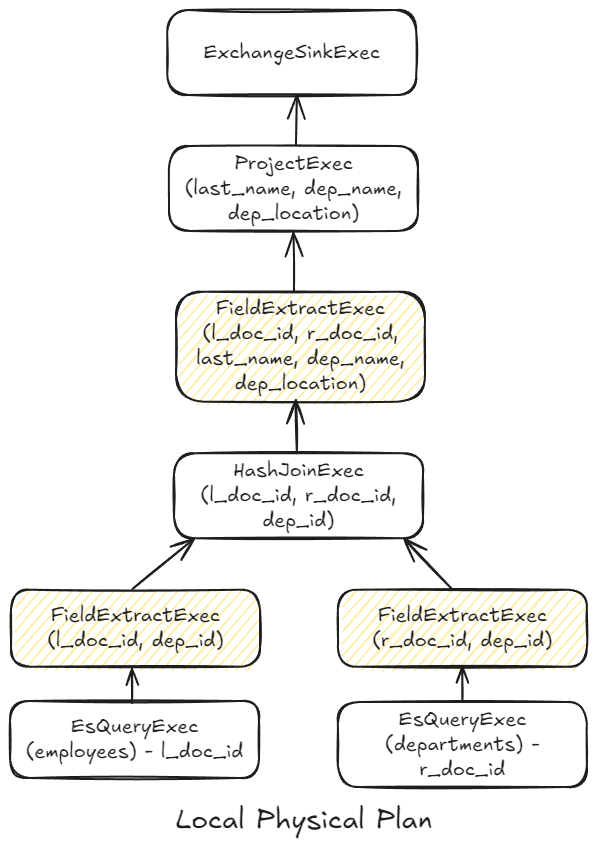
协调节点因此只需把执行片段分发给左侧相关的数据节点。本地执行采用哈希连接:利用右侧 lookup 索引的数据构建哈希表,再分批读入左侧数据,以连接键探测哈希表中的匹配项。原文的图示是在解释执行拓扑,并不承诺任意集群布局下所有网络读取都会消失。
协调节点与数据节点各做什么
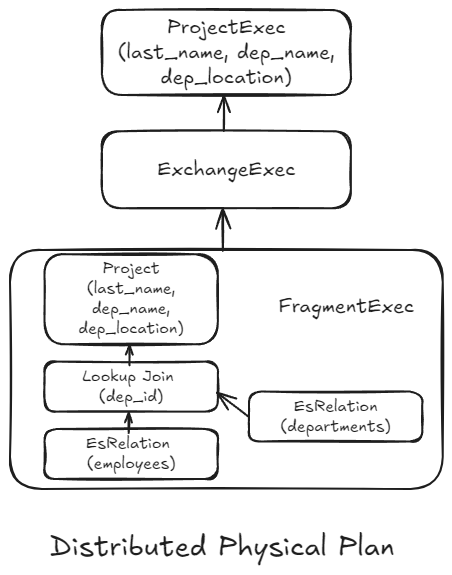
分布式物理计划由两部分组成。一部分在协调节点上执行,通常就是接收查询并负责完成查询的节点;另一部分是发送到持有数据的数据节点上的计划片段。协调节点本身不持有本次所需的全部数据,因此让相关数据节点完成本地处理,再收回结果并产生最终输出。
计划中的 Exchange 表示这两类节点之间的数据交换。在这一简单查询中,大部分处理已由数据节点完成,协调节点的工作较少。
发送给数据节点的片段还封装了逻辑子计划。这让数据节点有机会根据各自分片的特征重新优化,例如哪些字段缺失、局部最小值和最大值是什么。原文还指出,这种本地重新规划有助于处理节点之间、或节点与协调节点之间的代码差异,例如集群滚动升级期间的差异;这不是绕过官方混合版本兼容规则的许可。
延迟加载字段,减少 I/O
本地物理计划的另一项重点是尽量减少数据读取。计划树底部的两路数据源先输出 Elasticsearch 文档引用,也就是 doc_id,而不是立刻把所有字段或整份文档读出来。真正取字段的工作推迟到专门的提取节点。
在原文展示的计划中,两侧的连接键会在执行哈希连接前才被加载;最终投影需要的字段,则在数据离开节点前、最终投影之前,基于连接结果再提取。先确定需要哪些行,再读取这些行上的所需列,是这种延迟加载思路的核心。
原文提出的后续工作
字段限定符
在 8.18 的原文语境中,连接键需要在两侧使用相同名称,类似一些 SQL 方言的 JOIN USING。遇到两侧名称不同,可以先用 RENAME 或 EVAL 对齐名称:
FROM employees_new
| RENAME dep AS dep_id  // 对齐连接键名称
| LOOKUP JOIN departments ON dep_id
作者认为这一步不够方便,提出通过数据源限定符改善语法,并给出了下面的开发中草案:
# 原文路线图中的语法草案;不是 Elasticsearch 8.18 可直接执行的示例
FROM employees_new e
| LOOKUP JOIN departments ON e.dep == departments.dep_id
这个草案把同名连接键改写为等值比较,并用字段名前的限定符区分来源:departments 是隐式的数据源名,e 是显式别名。本文保留它是为了完整呈现原文思路,不将其标成已实现的命令。
更多连接类型与性能优化
作者当时还在研究如何更好地利用数据拓扑,并结合 Lucene 的搜索结构和统计信息跳过不需要读取的数据。更长期的方向包括内连接和全外连接:前者只保留两侧匹配的文档组合;后者在保留匹配组合的同时,也保留任一侧未匹配的行。原文用交集、并集帮助理解,但这不是 SQL 集合运算的严格等价定义。
从早期关联方案到 ES|QL
Elasticsearch 对原生 JOIN 的探索可以追溯到 0.90。早期有 nested 与 _parent 字段类型,后者在 2.0 重写、5.0 弃用,并在 6.0 由 join 字段替代。
之后出现的 Transforms(7.3)和 Enrich 摄取管道(7.5)也覆盖了部分需要关联数据的场景。生态中的 Logstash,以及通过 ES-Hadoop 连接器接入的 Apache Spark,提供了另外一些解决办法。6.3.0 引入的 Elasticsearch SQL 虽然支持很多 SQL 功能,但原文指出,它仍没有提供这种原生 JOIN 能力。
这些方案各有用途。作者在发表时表示它们仍然有效并继续受到支持,同时认为 ES|QL 的查询语言和执行引擎显著简化了使用体验。文章以邀请读者试用 Elasticsearch 8.18 与 Elastic Cloud 中免费提供的技术预览功能,并反馈使用体验作结。
读者常问与编辑核验
LOOKUP JOIN 是什么?它是 ES|QL 的查询时数据富化命令。本文介绍的是 8.18 技术预览中的左连接形式。
它用于什么?按连接条件将一个索引中的结果行与另一个 lookup 索引中的文档关联,把第二个索引的信息添加到查询结果中。
今天使用时应再查什么?请对应实际部署版本查阅官方 LOOKUP JOIN 命令参考。核验时的滚动参考已列出字段列表和表达式连接条件,明确列出可连接字段类型,并说明多值键、右侧重复匹配等行为。这些变化足以说明:原文的“同名单键限制”和路线图必须保留日期语境。
静态审查说明:本文未创建索引、写入数据或运行任何 ES|QL 查询。所有代码仅作静态核对。示例中的查询本身是读取操作;若自行补建或重建 lookup 索引,需单独评估写入、迁移和删除数据的影响。右侧重复键会放大输出,右侧规模会影响内存与执行成本,应在自己的数据和版本上验证,不能由本文推导性能保证。
出处与许可:原文作者 Costin Leau,来源 Elastic Search Labs。原文及原图版权 © Elasticsearch B.V.,保留所有权利。编辑自绘示意图与来源原图区分标注;技术说明保留原文 8.18 时期的版本边界。











暂无评论内容