


单元测试通常把预期结果写成代码。这样既能发现意外变化,也能告诉维护者函数应该怎样工作。但当输出是一大段带引号、换行和缩进的文本,或是一张图时,把正确结果硬编码在断言里就很难读,也很难维护。
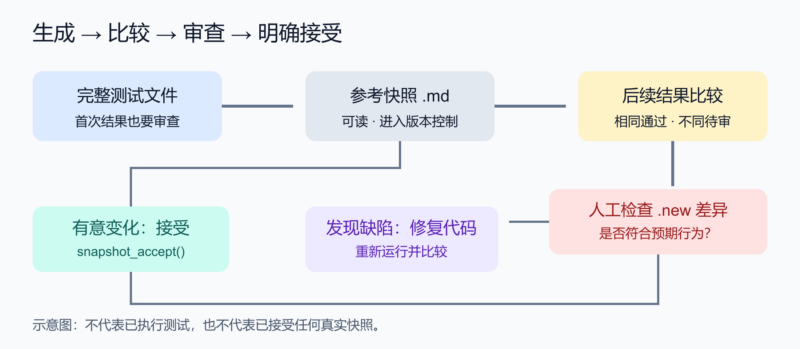
testthat 的快照测试把结果放在单独的文件中,由人审查,再在之后的运行中比较差异。快照也称 golden tests。官方文章提到,其设计主要受到 Jest 启发,并受益于与 Joe Cheng 的讨论。快照的价值不在于自动宣布当前输出正确,而在于把变化变成可以阅读、讨论和接受的记录。
本文根据 testthat 官方 Snapshot tests 完整译写,并补充运行前提和静态审查发现。核对版本为 3.3.2;文章没有个人署名,项目网站署名开发者 Hadley Wickham。所有代码均未在本次执行;文中原文结果与本文补充方案明确区分。
先让测试处在正确的环境中
快照依赖当前测试文件及测试名称来决定保存位置,因此不要把控制台里临时运行一个表达式当成已建立回归测试。应在完整测试文件中运行,例如 tests/testthat/test-bullets.R。
本文补充 testthat 第三版语义的配置。对 R 包,在 DESCRIPTION 中加入下面这一行:
Config/testthat/edition: 3局部示例也可以在测试文件中载入包并设置 edition:
library(testthat)
local_edition(3)
这与安装的 testthat 包版本是两个概念:包升级并不意味着已有项目一定切换了 edition。后文的 cli、withr 例子还要求相应包可用;原文的 \(lines) 匿名函数语法要求 R 4.1 或更新版本。本文把它写成兼容更早语法的 function(lines),逻辑不变。
从一个 HTML 列表函数开始
官方文章用生成 HTML 无序列表的小函数演示。它接收文本向量,并允许提供一个可选的 id,使其他位置可以链接到这个列表:
bullets <- function(text, id = NULL) {
  paste0(
    "<ul", if (!is.null(id)) paste0(" id=\"", id, "\""), ">\n",
    paste0("  <li>", text, "</li>\n", collapse = ""),
    "</ul>\n"
  )
}

cat(bullets("a", id = "x"))
原文展示的文本输出如下。这里把 HTML 当作代码展示,不作为正文执行:
<ul id="x">
  <li>a</li>
</ul>
用普通断言也可以测试,但必须小心写出引号和换行转义,日后阅读时也不容易看清目标:
test_that("bullets", {
  expect_equal(
    bullets("a"),
    "<ul>\n  <li>a</li>\n</ul>\n"
  )
  expect_equal(
    bullets("a", id = "x"),
    "<ul id=\"x\">\n  <li>a</li>\n</ul>\n"
  )
})
改成快照时,把 expect_equal() 换成 expect_snapshot(),并用 cat() 输出字符串,避免 R 默认打印字符串时附带的 [1] 和额外转义:
test_that("bullets", {
  expect_snapshot(cat(bullets("a")))
  expect_snapshot(cat(bullets("a", id = "x")))
})示例一致性调整:原文部分快照调用写成 bullets("a", "b"),第二个位置参数实际是 id,不是第二个列表项;其他示例又使用 id="x"。本文统一为显式的 id = "x",避免把参数意义和快照中的属性值混淆。
首次生成基准,之后检查差异
首次在完整测试文件环境中运行时,testthat 会生成参考输出并显示 “Adding new snapshot” 提示,让你检查输出是否正确。文件名来自测试文件:test-bullets.R 的参考快照位于 tests/testthat/_snaps/bullets.md。原文用 test-pizza.R 举例,对应的文件就是 _snaps/pizza.md。
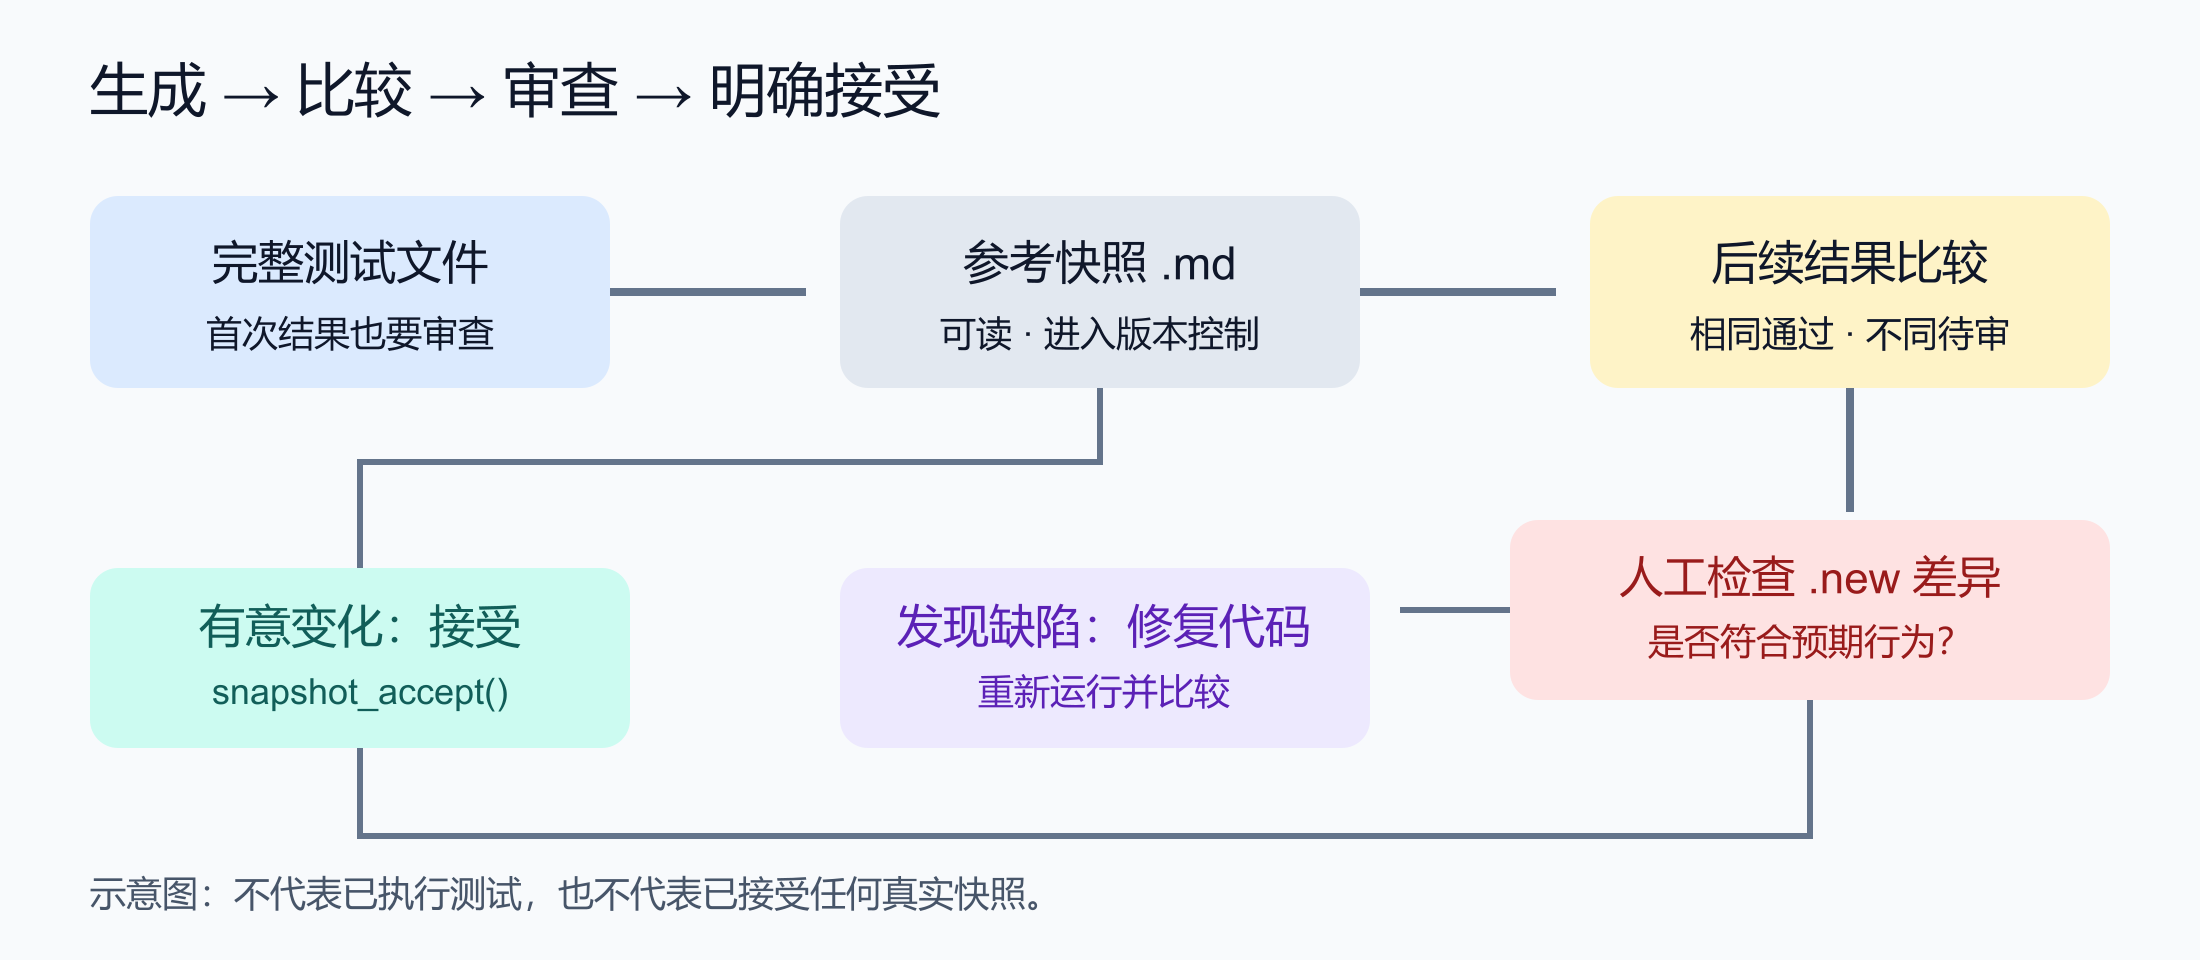
当前 API 文档明确要求审阅这些 Markdown 文件,并将它们纳入版本控制。第一次生成基准没有失败,并不能证明被测函数的结果正确;你仍要逐行核对它是否记录了真正关心的行为。在相同输出下再次运行,比较才会通过。
例如,把函数中每个 <li> 前的两个空格删掉:
# 原本是:
paste0("  <li>", text, "</li>\n", collapse = "")

# 有意修改成:
paste0("<li>", text, "</li>\n", collapse = "")
原文演示中,两处快照都会失败,差异集中在列表项缩进。既有快照保持为参考,新输出保存为 _snaps/bullets.new.md。下一步要判断这是预期改动还是缺陷。如果只是格式调整且符合约定,可以审查并接受;如果是错误,就修复实现,再运行测试。
# 在项目根目录中,针对示例测试文件审查
testthat::snapshot_review("bullets")

# 仅在确认差异符合预期后接受
testthat::snapshot_accept("bullets")
这两行会读取或更新快照基准,不属于只读检查。本次没有调用它们。省略文件参数的 snapshot_accept() 可以接受所有文件的变化,原文提及了这个入口;实际审查中应避免为了消除红灯就批量接受尚未阅读的差异。
删除某个测试后,下一次运行测试会移除对应快照;若某快照文件里的所有快照都已删除,运行全部测试时会清理整个文件。因此,重命名、删除测试和跳过测试时,也要留意基准的生命周期。
Markdown 快照为什么适合代码审查
快照用 Markdown 的一个子集保存。每个测试以 # 测试名称 作为一级标题,同一测试中的各个快照按代码块缩进,并用 --- 分隔。原文提供的是格式说明示例;当前 expect_snapshot() 通常还保留 Code、Output、Condition 等区段,使人能够看出哪条表达式产生了哪段结果。
# bullets

    Code
      cat(bullets("a"))
    Output
      <ul>
        <li>a</li>
      </ul>

---

    Code
      cat(bullets("a", id = "x"))
    Output
      <ul id="x">
        <li>a</li>
      </ul>
上面是根据本文统一后的调用整理的格式示意,不是本次生成的文件。人们在审查拉取请求时不一定运行代码,仍然需要通过差异判断错误提示是否有帮助、输出是否漏了关键内容。这就是快照应该可读、应当和实现变更一起接受审查的原因。
如果在交互控制台直接调用快照断言,testthat 无法从完整测试上下文推断基准路径,通常只显示当前值供人工查看。要建立或比较文件基准,应使用 test_file()、test_dir() 或项目的测试入口执行完整文件。
错误消息必须明确声明为预期
expect_snapshot() 可以捕获控制台输出、消息、警告和错误,但默认遇到错误仍会使测试失败。这是一个保护:不能因为快照机制把意外出错也保存下来,就把坏掉的代码当成新基准。
test_that("you can't add a number and a letter", {
  expect_snapshot(1 + "a")
})
原文这里失败,原因是非数值对象参与二元运算。若目标就是审查该错误,必须显式设置 error = TRUE:
test_that("you can't add a number and a letter", {
  expect_snapshot(1 + "a", error = TRUE)
})
表达式较多时,原文把这个开关放在前面,便于阅读:
test_that("you can't add weird things", {
  expect_snapshot(error = TRUE, {
    1 + "a"
    mtcars + iris
    Sys.Date() + factor()
  })
})这里有一个重要边界:error = TRUE 只要求这组表达式中至少有一个抛出错误,并不要求每个表达式都抛错。原文的第三句产生的是不兼容方法的警告和 numeric(0),不是错误。如果你的需求是“每次调用都必须报错”,应把它们拆成各自的错误断言或各自的快照,而不是依赖这个联合块。
让错误提示本身成为可审查的接口
复杂错误消息尤其适合快照。原文的 check_unnamed() 要求 ... 中所有参数不带名称;出现名称时,通过 cli 生成提示,列出哪些参数有问题:
check_unnamed <- function(..., call = parent.frame()) {
  names <- ...names()
  has_name <- names != ""
  if (!any(has_name)) {
    return(invisible())
  }

  named <- names[has_name]
  cli::cli_abort(
    c(
      "All elements of {.arg ...} must be unnamed.",
      i = "You supplied argument{?s} {.arg {named}}."
    ),
    call = call
  )
}

test_that("no errors if all arguments unnamed", {
  expect_no_error(check_unnamed())
  expect_no_error(check_unnamed(1, 2, 3))
})

test_that("actionable feedback if some or all arguments named", {
  expect_snapshot(error = TRUE, {
    check_unnamed(x = 1, 2)
    check_unnamed(x = 1, y = 2)
  })
})
第一个测试验证正常调用不报错;第二个保留可读的错误消息。原文展示的差异包括单数 argument 与复数 arguments,并分别指出 x,或 x 与 y。这比只检查“发生了错误”更能保护面向用户的反馈质量,但仍不能让错误路径覆盖测试取代正常行为测试。
把随机路径等无关变化归一化
有些输出每次都不同,例如临时文件路径。若这些变化与要保护的行为无关,可以用模拟固定输入,也可以通过 transform 对输出做最小范围的替换。它接收由文本行组成的字符向量,返回修改后的向量。
原文用一个要求显式同意覆盖的写文件函数说明问题:
safe_write_lines <- function(lines, path, overwrite = FALSE) {
  if (file.exists(path) && !overwrite) {
    cli::cli_abort(c(
      "{.path {path}} already exists.",
      i = "Set {.code overwrite = TRUE} to overwrite"
    ))
  }

  writeLines(lines, path)
}
下面的临时文件已经存在,所以预期得到“文件已存在”的错误。路径每次生成都可能不同,直接做快照会因路径变化而失败:
test_that("generates actionable error message", {
  path <- withr::local_tempfile(lines = "")
  expect_snapshot(
    safe_write_lines(letters, path),
    error = TRUE
  )
})
只替换这个实际路径,就能保留其他提示内容:
test_that("generates actionable error message", {
  path <- withr::local_tempfile(lines = "")
  expect_snapshot(
    safe_write_lines(letters, path),
    error = TRUE,
    transform = function(lines) {
      gsub(path, "<path>", lines, fixed = TRUE)
    }
  )
})
fixed = TRUE 表示将路径作为字面字符串匹配,避免反斜杠或句点被解释成正则表达式。原文归一化后的核心文本是 '<path>' already exists.,同时保留 overwrite = TRUE 的操作建议。不要把整条错误信息或所有数字都抹掉,否则测试也失去了发现真实退化的能力。
静态审查补充:这里的 “safe” 指避免无意覆盖的教学接口,不是并发文件系统上的原子安全保证。file.exists() 和 writeLines() 之间可能发生文件变化,函数也没有建立并发排他机制。需要并发保证时,应使用适合目标存储的原子创建或协调机制,不能仅靠先检查再写入。本文没有执行任何文件写入示例。
稳定输出,不等于把所有差异隐藏掉
testthat 默认通过可复现输出设置减少环境噪声:控制台宽度设为 80,抑制 cli 的 ANSI 颜色与超链接,并抑制相关 Unicode 输出。这些设置减少不同环境之间无关的格式变化。若测试目标本身就是不同宽度、颜色转义或 Unicode 字符,则可通过 local_reproducible_output() 调整,审查时应知道自己覆盖了哪些默认值。
当前 API 文档还说明,快照默认 cran = FALSE,因为依赖包的细小差异容易让快照脆弱;不要把某个 CRAN 环境没有比较快照误解为快照已经通过验证。需要处理操作系统、R 或关键依赖版本差异时,可以使用 variant,但必须设计好各变体的测试覆盖和失效基准清理策略。这两项为本文根据 API 补充的边界。
文本、返回值、图形和整文件各有入口
最常用的 expect_snapshot() 记录表达式及其打印输出、消息、警告、错误。如果关心的是返回值本身,应考虑 expect_snapshot_value()。它提供不同序列化方式,在保真程度和可读性之间取舍。原文的小列表示例是:
test_that("can snapshot a simple list", {
  x <- list(
    a = list(1, 5, 10),
    b = list("elephant", "banana")
  )
  expect_snapshot_value(x)
})
原文展示为可读的 JSON 风格文本,分别包含数值列表和单词列表。选择快照方式时要看被保护的约定:打印方法的排版、返回值的结构和图形的视觉结果,是不同测试目标。
图形测试方面,原文建议使用 vdiffr,它也用于 ggplot2 的图形测试,集中处理已有的图形比较经验。图形依然可能受到平台、字体和依赖版本影响,不能假定使用快照就天然跨平台一致。
expect_snapshot()、expect_snapshot_output()、expect_snapshot_error() 和 expect_snapshot_value() 通常每个测试文件共用一个快照文件。对图片等整文件结果,则可用 expect_snapshot_file(),每个断言产生一个单独文件。原文给出的概念调用为:
# 示意:这里的函数名是占位符,需替换成实际生成文件的代码
expect_snapshot_file(
  code_that_returns_path_to_file(),
  "toppings.png"
)
假设它位于 test-burger.R,参考文件会保存到 tests/testthat/_snaps/burger/toppings.png;变化后的文件是同目录的 toppings.new.png。这个示意中的 code_that_returns_path_to_file() 并非 testthat 自带函数,不能直接运行。
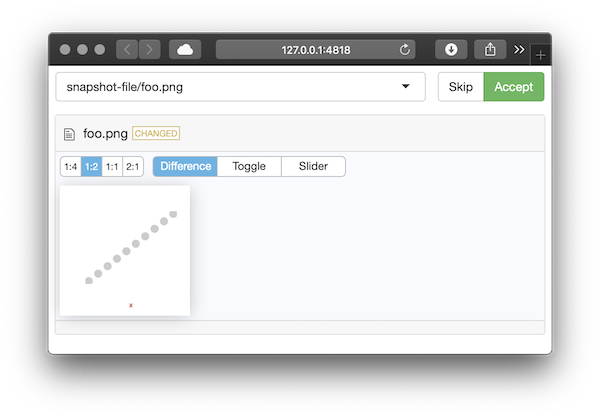
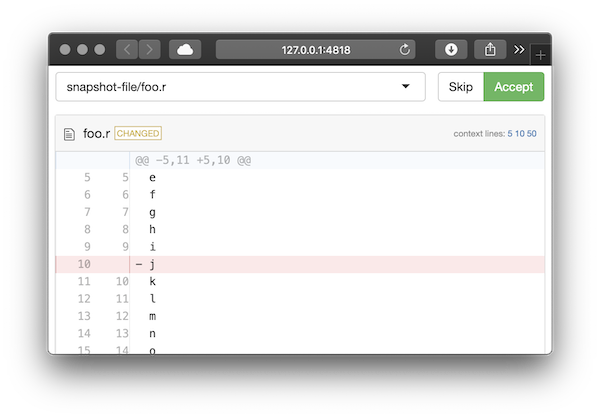
整文件快照失败时,不能像文本那样自动给出所有格式的差异。snapshot_review() 会启动 Shiny 审查界面,按文件类型显示内容,让人决定是否接受;原文说明支持文本、常见图片和 CSV。如果差异发生在非交互 CI 或 R CMD check 环境,可把 .new 文件取回本地、放到相应目录再审查。在 GitHub 上,testthat 提供 gh_download_artifact() 辅助取回产物。
多数项目更适合通过封装函数使用 expect_snapshot_file():封装层可以在平台或依赖版本不支持稳定结果时合理跳过,并通常应调用 announce_snapshot_file(),避免相应基准被错误清理。不要只解决“如何保存文件”,却忘记基准何时应保留。
教学 HTML 函数的输入边界
开头的 bullets() 直接拼接 text 与 id,没有 HTML 转义。它适合原文固定的可信教学字符串;若直接拿去输出用户输入,可能让输入改变 HTML 结构。快照即使完全一致,也不会自动替你发现或阻止这种问题。
一个明确的修正方向是在进入原函数前分别进行文本及属性转义。下面是本文新增的保护性包装,要求额外安装 htmltools;输出规范会因此变化,必须增加含引号、尖括号、与号的测试并人工审查新快照:
bullets_safe <- function(text, id = NULL) {
  text <- htmltools::htmlEscape(as.character(text))
  if (!is.null(id)) {
    stopifnot(is.character(id), length(id) == 1L, !is.na(id))
    id <- htmltools::htmlEscape(id, attribute = TRUE)
  }
  bullets(text, id = id)
}
这段包装是静态改进建议,未进行运行验证,也没有把原始函数悄悄替换掉。对于真正的网页生成任务,还可以选用成熟的 HTML 构造工具,让转义规则成为接口的一部分。
为什么新流程优于旧的参考输出接口
testthat 以前已有参考输出工具。原文指出,verify_output() 需要手工指定路径,交互与测试环境之间管理路径很麻烦;它还总是覆盖旧结果,等于自动假设变化正确,必须依赖 Git 才能复查,而且粒度偏粗,测试文件容易越写越大。
expect_known_output() 粒度更细,却要求每个断言单独取文件名;expect_known_value() 与 expect_known_hash() 除了这些问题,还产生难以在拉取请求中直接审查的二进制结果。第三版文档已把这些旧接口列为弃用。现代快照流程把命名、比较和候选结果管理交给工具,把“这个变化是否正确”的决定保留给审查者。
一份有用的快照应当足够小,能看出它保护什么;足够稳定,避免随机路径淹没真实变化;也足够忠实,不因过度归一化而忽略缺陷。首次建立和以后更新基准,都属于测试设计的一部分。
来源与署名
原文:Snapshot tests,testthat 官方文档,源码位置为 vignettes/snapshotting.Rmd;页面未列个人作者,项目网站列开发者 Hadley Wickham。补充核对 expect_snapshot API 和 testthat 3e。页面显示版本 3.3.2,未将网站构建信息当作首次发布日期。
中文译写、自绘流程图、示例一致性修正和额外静态审查意见均已说明;项目软件许可不自动等同于文章许可。文中没有任何由本次实际运行产生的测试通过声明。











暂无评论内容