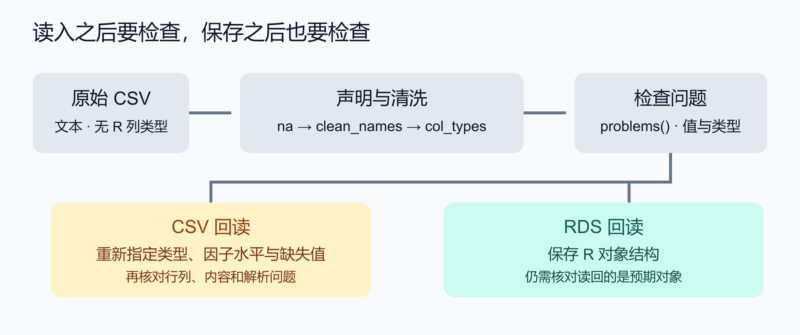



把 CSV 读成一个数据框,只是数据导入的开始。接下来还要确认:列名是否便于使用,缺失值有没有被当成普通文本,年龄这样的数值列为何成了字符,以及保存后的文件重新读入时是否仍保留所需的类型。
本文完整译写《R for Data Science》第二版第 7 章的技术内容,围绕这些问题展开,并保留其他分隔格式、多文件导入、手工录入和练习。原作者为 Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund。核对的是 2026-10-05 可读的在线章节;该页已出现 readr 2.2.0 的字面数据警告,本文据此统一调整内联 CSV 的写法。下列代码仅静态审查,未在本次执行。
从一份看得见原始内容的 CSV 开始
CSV 是逗号分隔值文件,通常第一行是列名,之后每行是一条记录。readr 属于 tidyverse 的核心包,可用 library(tidyverse) 载入;下文还使用 dplyr 与 tibble。janitor 是额外的包,并不随 tidyverse 一同附加,使用其函数前需保证它已安装。
原书的学生示例包含五列、六行数据。为了让练习不依赖外部下载,下面把原文完整的 CSV 内容放在字符串中;这只改变了输入方式,字段和数据保持原样。
library(tidyverse)

students_csv <- "Student ID,Full Name,favourite.food,mealPlan,AGE
1,Sunil Huffmann,Strawberry yoghurt,Lunch only,4
2,Barclay Lynn,French fries,Lunch only,5
3,Jayendra Lyne,N/A,Breakfast and lunch,7
4,Leon Rossini,Anchovies,Lunch only,
5,Chidiegwu Dunkel,Pizza,Breakfast and lunch,five
6,Güvenç Attila,Ice cream,Lunch only,6"

students_raw <- read_csv(I(students_csv))
students_raw
I() 明确告诉 readr:这里传入的是字面数据,而不是文件名。原章节的部分内联示例没有加它,页面自身展示了 readr 2.2.0 起应使用 I() 的警告,所以本文对所有字面 CSV 做相同修正。真正的文件路径不需要这样包装。
# 使用项目里已有的文件时,原书的写法是:
students <- read_csv("data/students.csv")
该相对路径要求当前项目里存在 data/students.csv。原书还提供了示例下载链接,并说明 read_csv() 可以直接接收 URL。本文练习使用上面的内联数据,本次没有读取该外链数据文件。
原书读入提示为 6 行、5 列,分隔符是逗号;Student ID 被推断为双精度数值,其他四列都是字符。提示还告诉你可用 spec() 查看完整列规范,或用 show_col_types = FALSE 隐藏类型提示。先检查再决定是否隐藏:年龄列成为字符正是需要关注的信号。
统一缺失编码、列名和业务类型
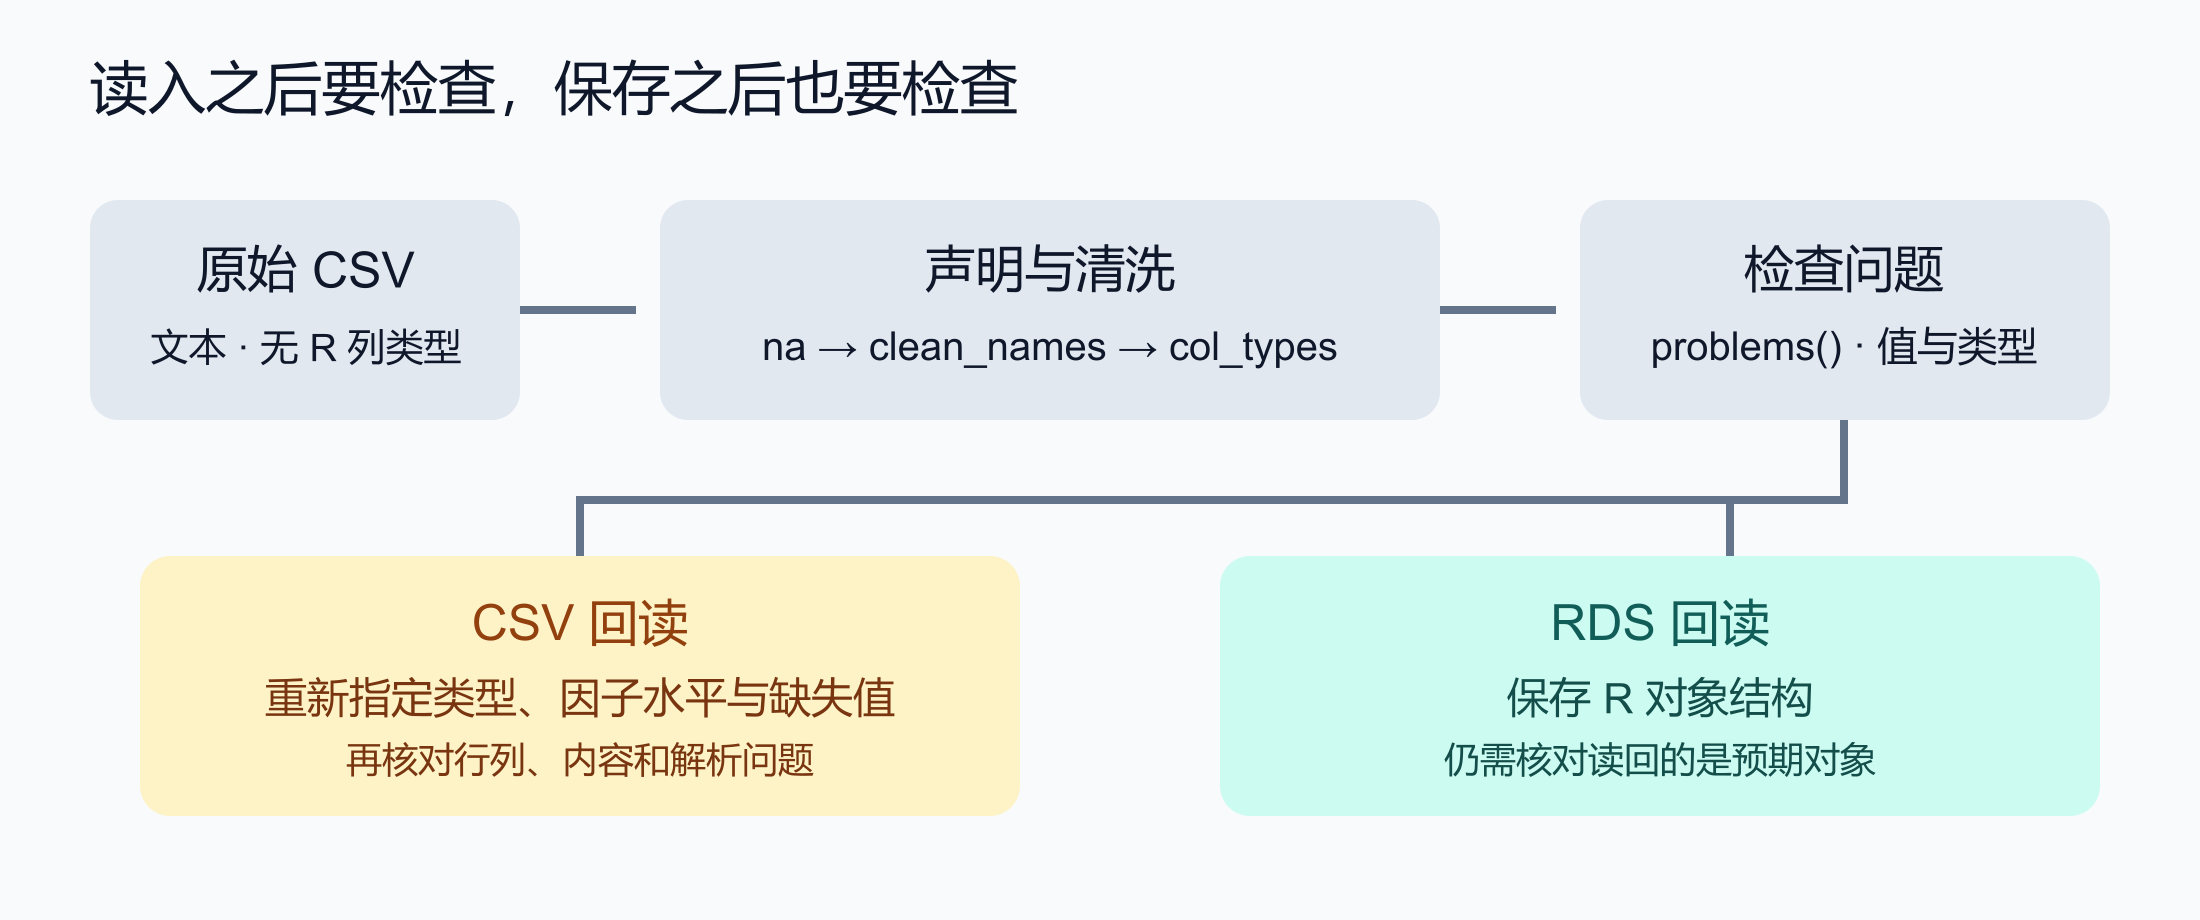
favourite.food 中的 N/A 表示缺失,却被读成了普通字符串;第 4 行年龄的空白则已经是缺失值。用 na 明确声明这份文件的缺失编码:
students <- read_csv(
  I(students_csv),
  na = c("N/A", "")
)
现在第 3 行食物和第 4 行年龄都会是 R 的 NA。注意,显式传入 na 是指定一个新的标记集合;若真实文件也用字面字符串 "NA" 表示缺失,应把它一并写入,例如 na = c("", "NA", "N/A")。不要把“这份示例里只有空白被默认识别”误写成 readr 的默认值只包含空白。
列名 Student ID 与 Full Name 中有空格,不符合 R 通常的语法名称规则,引用时要加反引号。可以手工重命名:
students |>
  rename(
    student_id = `Student ID`,
    full_name = `Full Name`
  )
这段管道只返回重命名后的结果,不会自动修改原对象。若要继续使用改名结果,需要赋值。另一种办法是 janitor::clean_names(),它用启发式规则统一成小写蛇形命名;本例五个列名会变成 student_id、full_name、favourite_food、meal_plan 和 age。
meal_plan 是已知类别的变量,可以转成因子。显示值仍是原来的字符串,列类型会从 <chr> 变为 <fct>。年龄列出现英文单词 five,导致整列成为字符;在这个已知教学输入中,把它明确改成 "5" 后再解析为数值:
students <- students |>
  janitor::clean_names() |>
  mutate(
    meal_plan = factor(meal_plan),
    age = parse_number(if_else(age == "five", "5", age))
  )
if_else() 的第一个位置参数给出条件,条件为真时取第二个参数,否则取第三个;这里就是只替换精确等于 "five" 的值。按原文数据,清理后的年龄应为 4, 5, 7, NA, 5, 6,食物列仍有一个缺失值。这是对原文数据和展示结果的说明,不是本次运行报告。
静态审查补充:原书使用的 parse_number() 很宽松,会忽略数值周围的非数值部分,适合货币等文本,却不等于严格的年龄验证。对于必须是纯数字的年龄字段,可以在完成有依据的替换后改用 parse_double(),并检查解析问题及允许的年龄范围。也不能未经业务确认就把所有英文数字或异常文本自动改掉。原文用来解释位置参数的 “test/yes/no” 不是建议照抄的命名参数;dplyr 的正式参数名是 condition、true、false。
表头、注释和分隔格式
有些 CSV 顶部带有说明行,可以用 skip 跳过;有些带有注释标记,可以用 comment 指定。下面保留原文的两种情形,并加上 I():
read_csv(
  I("The first line of metadata
The second line of metadata
x,y,z
1,2,3"),
  skip = 2
)

read_csv(
  I("# A comment I want to skip
x,y,z
1,2,3"),
  comment = "#"
)
两者都意在得到列名 x, y, z 和一行数值。若数据本身会包含 #,不要在未检查文件格式时随意把它设为注释字符,否则可能丢弃本来需要的内容。
没有表头时,指定 col_names = FALSE,readr 会生成 X1、X2 等列名;也可以直接提供列名向量。指定列名后,第一行会作为数据读入:
read_csv(I("1,2,3\n4,5,6"), col_names = FALSE)
read_csv(
  I("1,2,3\n4,5,6"),
  col_names = c("x", "y", "z")
)
掌握 read_csv() 后,其他平面文本格式主要是选择合适的入口函数:
| 格式 | readr 函数 | 要点 |
|---|---|---|
| 分号分隔、常用逗号作小数点 | read_csv2() |
适合这种地区性 CSV 约定。 |
| 制表符分隔 | read_tsv() |
字段之间用制表符。 |
| 其他分隔符 | read_delim() |
可显式设置 delim;未指定时会尝试推断。 |
| 定宽文本 | read_fwf() |
用 fwf_widths() 指定宽度,或 fwf_positions() 指定位置。 |
| 空白分隔的表格文本 | read_table() |
适合以空白分开字段的常见表格。 |
| Apache 风格日志 | read_log() |
针对这种日志格式。 |
类型推断是便利工具,也需要复核
CSV 不保存“这是逻辑值”“这是因子”这样的 R 类型信息。readr 采用启发式推断:原章节说明,它默认从首行到末行均匀抽取至多 1,000 行的值,忽略缺失值后判断类型;可用 guess_max 调整抽样数量。
如果一列只有 F、T、FALSE、TRUE,且不区分大小写,就推断为逻辑值;如果都是 1、-4.5、5e6、Inf 这样的数字,就推断为数值;符合相应 ISO 8601 格式的值可能被推断为日期或日期时间;否则通常成为字符串。
read_csv(I("logical,numeric,date,string
TRUE,1,2021-01-15,abc
false,4.5,2021-02-15,def
T,Inf,2021-02-16,ghi"))
原文此例的四列分别为逻辑、双精度、日期和字符。干净的小样例容易判断,大文件中的异常值却可能没有进入抽样。因此,类型提示和后续解析警告都值得查看;增加 guess_max 也不能代替明确的数据规范。
先让问题暴露,再决定如何修正
最常见的推断失败之一,是数值列混入了意外字符串。例如某份文件用句点表示缺失:
simple_csv <- "x
10
.
20
30"

read_csv(I(simple_csv))
此时 x 会成为字符列。只有四行时一眼就能发现句点;几千行中只有几个这样的值时,可以先要求它按数值解析,让 readr 报告不符合约定的位置:
df <- read_csv(
  I(simple_csv),
  col_types = list(x = col_double())
)
problems(df)
原文示例报告第 3 行、第 1 列的问题:期望 a double,实际读到 .。这里的行号包含表头,因此对应第二条数据;file 字段可能显示内部临时文件路径,不必把该随机路径视为数据内容。强制类型使异常值变成解析失败,不代表异常已经被正确处理。
在确认这份文件确实以句点表示缺失之后,再把它声明为缺失标记:
read_csv(I(simple_csv), na = ".")原文结果此时为数值列 10, NA, 20, 30。这段代码刻意只指定句点;真实文件若还有空白或 NA 等缺失编码,应按实际规则把它们一起列入。不能为了消除警告,把所有读不懂的内容都列成缺失值。
明确指定列类型,或先按字符保留原貌
原章介绍的列规格包括:col_logical()、col_double()、col_integer()、col_character()、col_factor()、col_date()、col_datetime()、宽松的 col_number(),以及跳过某列的 col_skip()。
整数在适用范围内比双精度数值节省存储空间,但数据语义更重要。电话号码、信用卡号或其他长数字标识符通常应该是字符:它们不适合算术运算,前导零也不应丢失。col_skip() 可以避免读入不需要的大列。
当推断结果混乱时,可以先将所有列按字符读取,再逐列处理。这能保留原始文本,并且把清洗决定写在代码里:
another_csv <- "x,y,z
1,2,3"

read_csv(
  I(another_csv),
  col_types = cols(.default = col_character())
)

# 只读指定列,其余列跳过
read_csv(
  I(another_csv),
  col_types = cols_only(x = col_character())
)
cols(.default = ...) 与只列出几个例外的 list(...) 不同:它明确改变其他列的默认处理方式。cols_only() 则只保留列出的字段。无论采用哪种方案,都应核对行数、列名、类型以及 problems(),再进入分析。
多份文件合并时保留来源
月度销售数据常拆成多个文件。如果这些文件结构兼容,可以把路径向量传给 read_csv(),把各文件按行堆叠:
# 前提:这些是项目中已存在、结构兼容的文件
sales_files <- c(
  "data/01-sales.csv",
  "data/02-sales.csv",
  "data/03-sales.csv"
)
sales <- read_csv(sales_files, id = "file")
id = "file" 增加一个来源列,记录每行来自哪个文件。原书示例合并成 19 行、6 列,包含来源、月份、年份、品牌、商品和数量;这一规模来自原文,本文没有下载或运行这组文件。原文对应的三个来源为 一月、二月、三月,也可以把这些 URL 放入同样的路径向量。
文件很多时可以用 list.files() 筛选:
sales_files <- list.files(
  "data",
  pattern = "sales\\.csv$",
  full.names = TRUE
)
sales_files
正则里的 \\. 匹配字面句点,$ 限定文件名结尾;full.names = TRUE 返回带目录的路径。先检查这个列表是否为空、是否混入旧导出文件,再读取。若各月同名字段的业务含义或类型发生变化,应先解决这些差异,不能以“成功合并”代替数据核对。
保存后,读回来再检查
write_csv() 和 write_tsv() 把数据框写回文本文件,主要参数是对象 x 和路径 file;na 控制缺失值写法,append 控制是否追加。写文件会产生磁盘副作用,默认写入同名目标可能覆盖已有文件,因此下列回读练习改用新的临时文件路径。这是相对原文固定文件名示例的保护性调整,本次未执行。
csv_path <- tempfile(fileext = ".csv")
write_csv(students, csv_path)
csv_back <- read_csv(csv_path)

class(students$meal_plan)
class(csv_back$meal_plan)
problems(csv_back)
原书展示:写出前 meal_plan 是因子,直接回读 CSV 后成为字符。显示的值可能一样,但因子水平及类型信息没有保存在 CSV 中。CSV 适合文本交换,却不能保证保存任意 R 对象的完整结构。
若需要重建该因子,应在回读时显式给出类型。下面是本文补充的可审查回读检查,预期检查内容写在代码中,不把它冒充已经通过的测试:
csv_back <- read_csv(
  csv_path,
  na = c("", "NA"),
  col_types = cols(
    student_id = col_double(),
    full_name = col_character(),
    favourite_food = col_character(),
    meal_plan = col_factor(levels = levels(students$meal_plan)),
    age = col_double()
  )
)

stopifnot(
  nrow(problems(csv_back)) == 0L,
  identical(names(csv_back), names(students)),
  nrow(csv_back) == nrow(students),
  identical(levels(csv_back$meal_plan), levels(students$meal_plan)),
  identical(as.list(csv_back), as.list(students))
)
这里比较各列的内容与属性,避开 readr 返回对象中解析规格等附加元数据造成的无关差异。该检查针对本例这几个简单列;金额精度、时区、字符编码等问题仍应依各自数据规范补充检查。
若只是在 R 内缓存中间结果,可以使用 RDS。readr 的 write_rds() 和 read_rds() 分别封装 base R 的 saveRDS() 与 readRDS(),以 R 的二进制序列化格式保存对象结构。原书回读示例保留了因子类型。
rds_path <- tempfile(fileext = ".rds")
write_rds(students, rds_path)
rds_back <- read_rds(rds_path)

# 本文补充;未执行的回读检查
stopifnot(
  identical(as.list(rds_back), as.list(students)),
  identical(class(rds_back), class(students))
)
跨语言交换还可以考虑 Arrow 支持的 Parquet。原书用 write_parquet()、read_parquet() 演示,并指出它在许多情形下比 RDS 更快,但需要额外的 arrow 包。性能取决于实际数据和环境,本文没有做基准测试;跨语言处理 R 特有类型时,也应核对对应元数据。
# 需要已安装 arrow;此示例同样未执行
parquet_path <- tempfile(fileext = ".parquet")
arrow::write_parquet(students, parquet_path)
parquet_back <- arrow::read_parquet(parquet_path)
少量数据也可以直接录入代码
为了写示例、最小复现或小型查找表,不一定需要另建 CSV。tibble() 按列组织数据;tribble() 是 transposed tibble 的缩写,按行书写,列名前加 ~,各值用逗号分隔。两种形式表达同一个小表:
tibble(
  x = c(1, 2, 5),
  y = c("h", "m", "g"),
  z = c(0.08, 0.83, 0.60)
)

tribble(
  ~x, ~y, ~z,
   1, "h", 0.08,
   2, "m", 0.83,
   5, "g", 0.60
)
把原章练习留作检查清单
- 若字段用竖线
|分隔,应选择哪个读取函数?提示:考虑read_delim()的delim参数。 - 除了
file、skip、comment,read_csv()和read_tsv()还有哪些共同参数?核对两者文档,而不是靠记忆复制。 read_fwf()的关键参数是什么?尝试分别从列宽和起止位置描述字段。- 字符串本身含逗号时,需要正确的引用字符。对
"x,y\n1,'a,b'",应设置哪一个参数?此例需要识别单引号,可检查quote。 - 检查下面五段有意构造的 CSV:列数多于表头、记录列数不一致、引号未闭合、数值列混入文字,以及分隔符用错。不要把解析警告简单隐藏。
read_csv(I("a,b\n1,2,3\n4,5,6"))
read_csv(I("a,b,c\n1,2\n1,2,3,4"))
read_csv(I("a,b\n\"1"))
read_csv(I("a,b\n1,2\na,b"))
read_csv(I("a;b\n1;3"))
第六项练习是练习引用非标准列名:用下面的数据提取名为 1 的列,画 1 与 2 的散点图,创建 3 = 2 / 1 的列,再把三列改成 one、two、three。反引号用于引用列名,不能与字符串引号混淆。
annoying <- tibble(
  `1` = 1:10,
  `2` = `1` * 2 + rnorm(length(`1`))
)
这段练习含随机数据,不同运行不会产生完全相同的散点。本文仅保留题目,没有执行这些故意异常的输入。
学会读取 CSV 之后,后续还会遇到 Excel、Google Sheets、数据库、Parquet、JSON 和网页数据。这里建立的习惯仍适用:保留输入来源,先诊断再清洗,明确类型与缺失规则,并把保存回读作为独立的验证步骤。
来源、许可与改写说明
原文为 Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund 所著 R for Data Science (2e), Chapter 7: Data import。全书首页注明 CC BY-NC-ND 3.0。此处保留原公开许可、作者与原链接;不把 ND 本身解释为授予翻译改编权。译者补充与来源正文已区分。
版本与参数补充核对官方 readr 2.2.0 读取 API 和 dplyr if_else API;后者当前页面显示 1.2.1。
本文没有推定章节的首次发布日期。与原文相比,统一给字面数据加 I(),用内联学生数据及临时输出路径便于独立审阅,明确区分缺失声明与解析失败,纠正 if_else() 参数名称解释,并补充回读检查。所有结果叙述均来自原文或明确标注的静态推理,未声称通过运行测试。










暂无评论内容