


作者:Amine Dirhoussi、Quentin Gallouédec、Kashif Rasul、Sergio Paniego。原文发布于 2026 年 9 月 10 日:Async GRPO with LoRA across HF Jobs: a bucket, a proxy, and no NCCL。本文为中文翻译整理,性能数字均来自原作者实验。
TRL v1.14 为 AsyncGRPOTrainer 加入了 LoRA 支持。训练器现在可以只训练适配器,并把适配器同步给 vLLM,而不必在每次策略更新后搬运整个模型。对一个 1.5B 模型来说,秩为 1 的适配器只有几 MB,完整模型权重则约为 3 GB。这个体积差异,让跨机器部署有了另一条路径:把适配器写入共享存储,让推理副本自己读取。
原文依据 LoRA Without Regret 的研究背景指出,策略梯度强化学习中,低秩适配器可能已经足够表达有效更新。这个经验并不意味着所有任务都只需要 rank 1;本文选择它,是为了验证训练与推理拆开以后,系统能否正确而高效地运行。
把一个训练流程拆成三个 Job
AsyncGRPOTrainer 本来就把训练和生成分开,两边可以使用不同机器、按各自速度推进。但在 Hugging Face Jobs 上,一个 Job 是一台虚拟机上的一个容器;原文描述的产品条件下,单个 Job 不能自行展开为多节点集群,单节点最多可使用 8 张 H200。不同 Job 没有共同的本地磁盘或 localhost,也不能把集群内 NCCL 权重广播的假设直接搬过来。
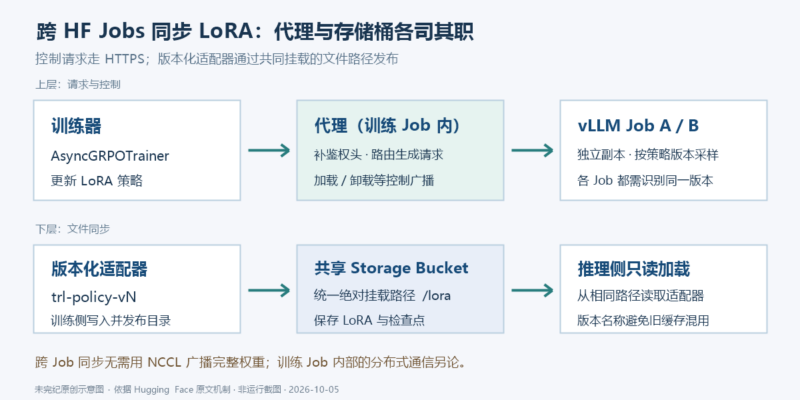
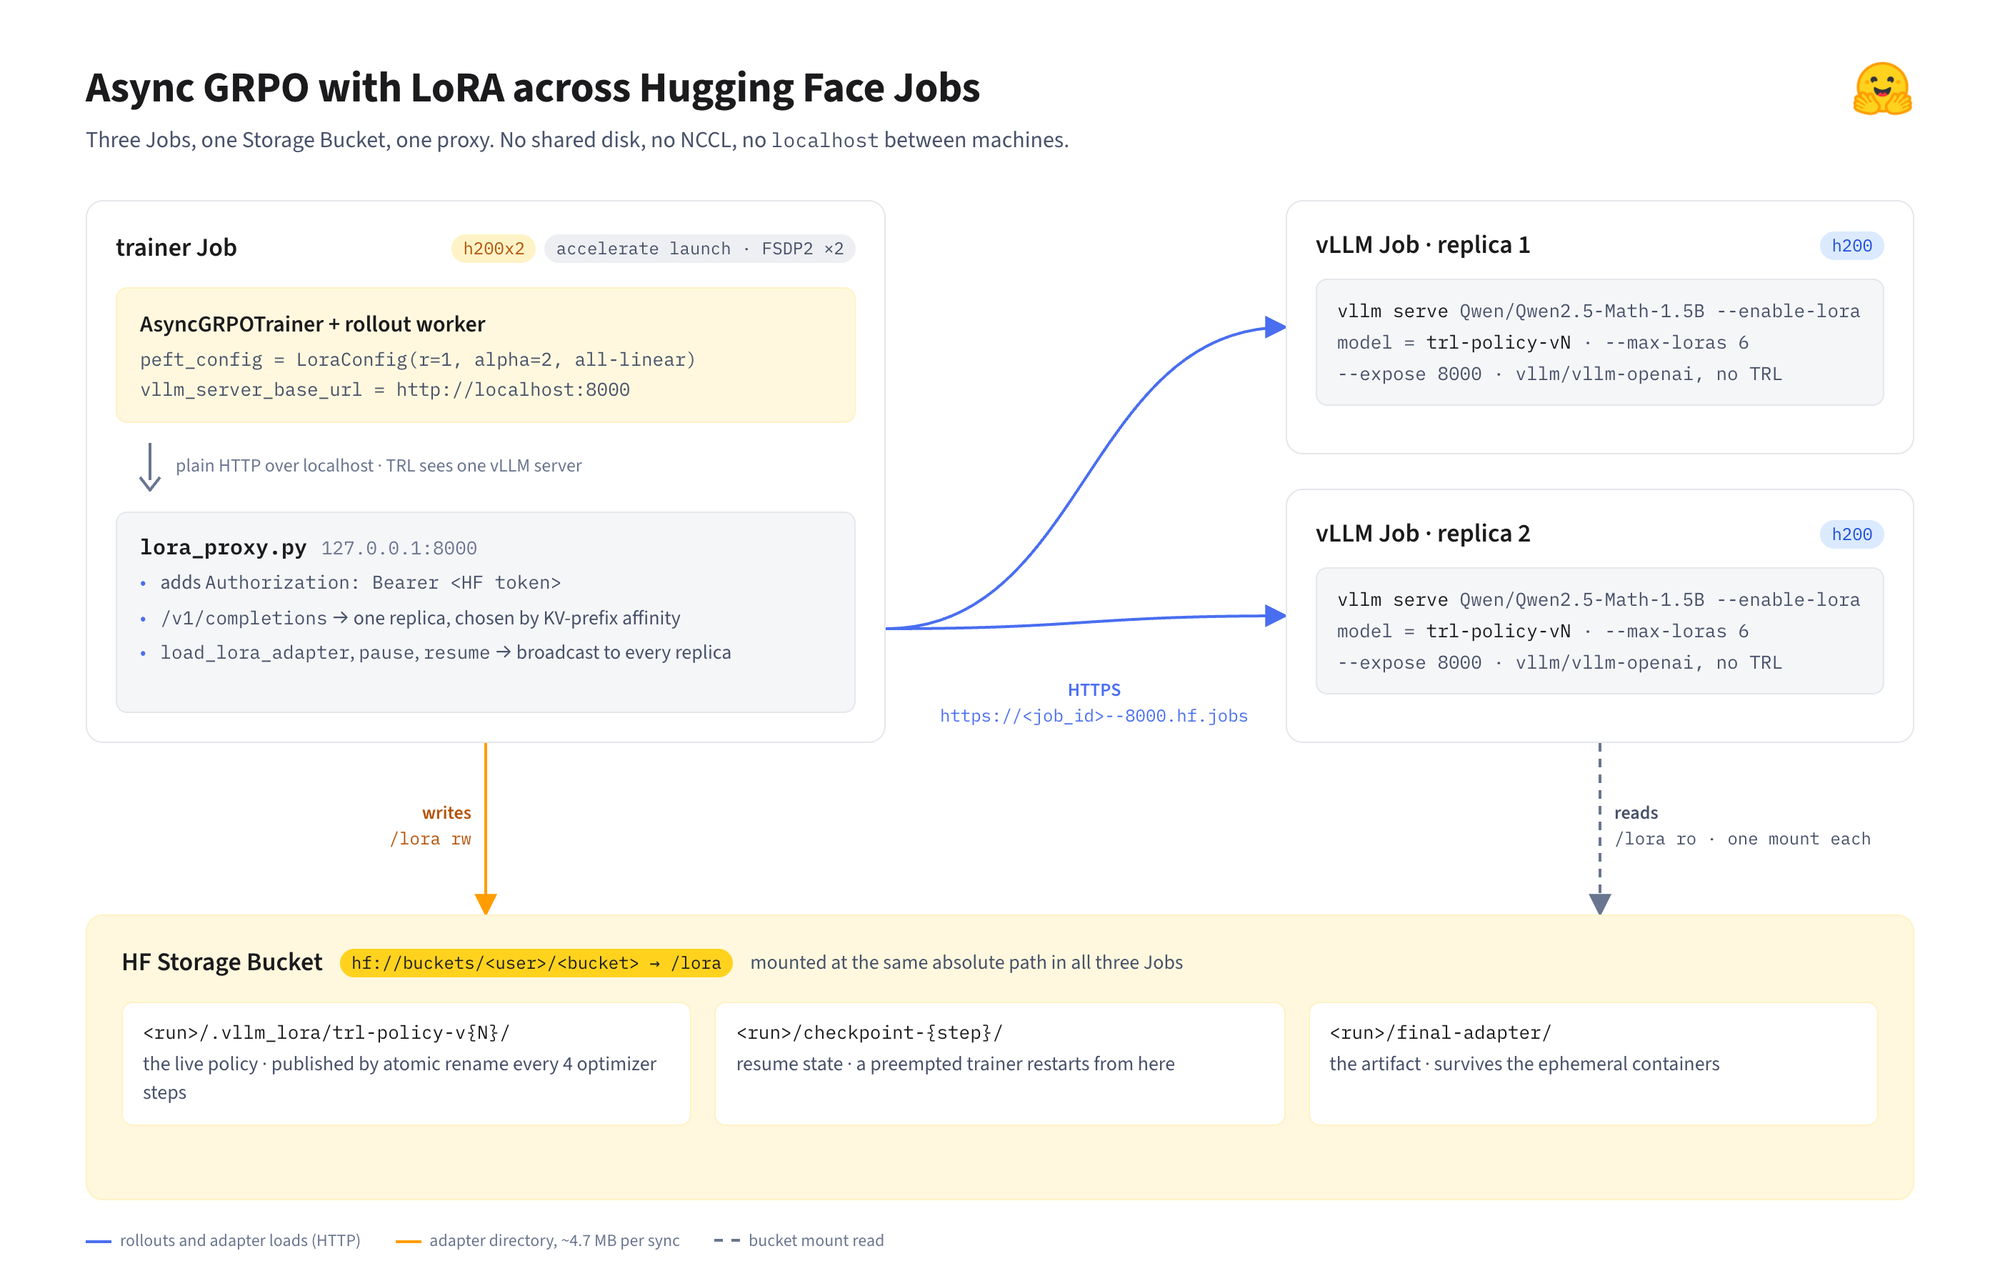
方案由一个训练 Job、两个 vLLM Job、一个所有 Job 都能挂载的 Storage Bucket,以及运行在训练 Job 内的小型代理组成。训练器负责策略更新,推理副本负责采样;存储桶传送适配器文件,代理负责 HTTPS 请求、鉴权、路由和广播。
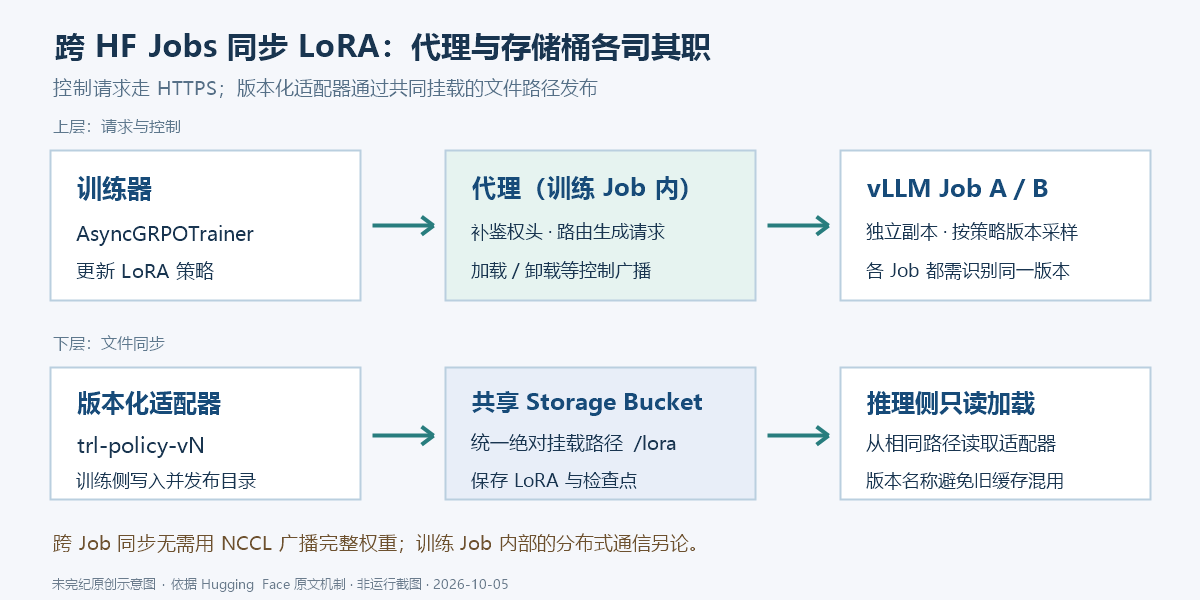
每隔几个优化步骤,训练器把适配器保存到 <output_dir>/.vllm_lora/trl-policy-v{N},通过原子重命名发布目录,然后向 vLLM 的 /v1/load_lora_adapter 发送目录路径。vLLM 从自己的文件系统读取文件,后续采样请求用 model="trl-policy-v{N}" 指定策略。
这利用了 vLLM 现有的运行时 LoRA 加载机制。所有 Job 必须把同一个存储桶挂载到相同的绝对路径,例如 /lora,这样训练器发送的路径在每个副本内都有效。底层由 hf-mount 通过 FUSE 暴露文件系统。检查点和最终适配器也写到存储桶,避免 Job 被抢占或停止后只留下易失的本地文件。
适配器必须有版本,槽位必须留出交换余量
每个推理副本使用一张 GPU 和 vllm/vllm-openai:v0.27.1 镜像。原文明确固定这个版本,因为运行时加载端点和命令行参数是配方的一部分。不能把它随意换成 latest 后仍假定所有行为相同。
max_staleness=4 表示样本最多可以落后当前策略四个版本。例如训练器在 v7 时,仍可以使用 v3 生成的样本。因此正在用旧策略生成的请求必须有机会用同一策略结束,vLLM 要同时保留当前版本和前四个版本。加载新版本发生在卸载最旧版本之前,交换期间还需多一个槽位,所以原文使用 --max-loras 6,即 max_staleness + 2。
如果反复用同一个适配器名覆盖权重,vLLM 的前缀缓存可能把旧权重计算出的 KV 当成新策略可用的缓存。这样一次生成可能用旧策略做 prefill、用新策略做 decode。版本名把“名称”与“一组确定权重”绑定起来,避免旧前缀跨版本误命中。
# 原文配置节选:执行会创建收费 GPU Jobs;本次未执行。
for replica in 1 2; do
  hf jobs run --detach --flavor h200 --timeout 8h --secrets HF_TOKEN \
    --expose 8000 \
    -v "hf://buckets/${BUCKET}:/lora:ro" \
    -e VLLM_ALLOW_RUNTIME_LORA_UPDATING=1 \
    -e VLLM_SERVER_DEV_MODE=1 \
    -- vllm/vllm-openai:v0.27.1 \
    vllm serve Qwen/Qwen2.5-Math-1.5B --host 0.0.0.0 --port 8000 \
      --max-model-len 4096 --logprobs-mode processed_logprobs \
      --generation-config vllm --enable-lora --max-lora-rank 1 --max-loras 6
done
:ro 让推理侧只读存储桶;VLLM_ALLOW_RUNTIME_LORA_UPDATING=1 开启动态加载;VLLM_SERVER_DEV_MODE=1 提供训练器需要的 /pause、/resume、/server_info。这也是实际的管理接口暴露面:应限制 token 权限、保护外部端点、避免在请求日志中记录 Bearer token,并只允许读取受控的适配器目录。它不是面向任意互联网调用者的默认安全配置。
数据集和训练配方
实验使用 sail/Sanity-Test-R1D-1.5B。根据 Qi 等人的论文,研究者用 DeepSeek-R1-Distill-Qwen-1.5B 为每道 MATH 问题生成 40 个答案,再保留成功率介于 20% 和 80% 的问题,共 1,460 道。这些问题既不是模型已经完全掌握的题,也不是毫无学习信号的题,适合检查强化学习流程是否正常。
原文采用 Qwen/Qwen2.5-Math-1.5B、LoRA rank 1、alpha 2、学习率 4e-5;每个 prompt 采样 8 次,参考配置每个优化步骤有 128 条 completion;最大生成长度 3,000 token,上下文长度 4,096 token。模型、数据集和论文配方分别有自己的适用条件与许可,文章授权不会改变这些软件或数据的许可证。
from peft import LoraConfig
from trl.experimental.async_grpo import AsyncGRPOConfig, AsyncGRPOTrainer

# 原文参数节选,不是可单独运行的完整训练程序。
config = AsyncGRPOConfig(
    output_dir="/lora/sanity-lora-r1",
    vllm_server_base_url="http://localhost:8000",
    max_staleness=4,
    weight_sync_steps=4,
    save_strategy="steps",
    save_steps=50,
)
# 构造 Trainer 时还需提供原项目的数据、奖励函数等参数。
peft_config = LoraConfig(r=1, lora_alpha=2, target_modules="all-linear")
这里的 URL 指向训练 Job 内代理,不直接指向 vLLM Job。初始化时 TRL 读取 /server_info,发现 lora_config 后选择只同步适配器的路径。DoRA、modules_to_save 或超过服务端 --max-lora-rank 的配置,可能回退为合并权重同步并打印警告;应核对日志是否出现 Adapter-only vLLM sync enabled。
与原文代码的差异:原文用省略号代表完整配置和 Trainer 参数。本稿把它明确写成参数节选,并不声称这里的几行已经足以开始训练。
代理解决鉴权与多副本一致性
HF Jobs 暴露的端口要求请求包含 Authorization: Bearer <HF token>。代理在转发时补上请求头,训练器本身不必知道这些外部地址和认证细节。
另一个原因是,多 GPU 生成不能简单等同于给单个 vLLM 服务设置 --data-parallel-size > 1。在原文对应实现中,/v1/load_lora_adapter 只到达处理请求的 DP rank,其他 rank 可能仍在用基础模型,却接受同一个策略名。TRL 因而拒绝这种模式下的适配器专用同步。
原文把数据并行提升到代理层:每个 Job 是一个独立副本,completion 请求只发给其中一个,适配器加载、卸载、暂停和恢复等状态改变则广播到全部副本。代理在 127.0.0.1:8000 监听;对训练器而言,它像一个 data_parallel_size=1 的服务。
按前缀缓存路由,而不是只轮询
生成有两个主要阶段。prefill 一次处理整个 prompt,计算已有 token 的注意力键和值;decode 逐 token 生成,复用前面计算的 KV。因果注意力中,一个 token 的 KV 只依赖它前面的 token,所以共享相同前缀的请求能够复用对应的缓存。
原文中 vLLM 按 16 token 一块管理前缀缓存,GRPO 又会为同一个 prompt 发送 8 个请求。把同组请求送到已经看过该 prompt 的副本,可以省去重复 prefill;纯轮询则容易让另一张 GPU 再做一次相同工作。
路由器把完整的 16-token 块做链式哈希:第 3 块的哈希同时代表前 1、2、3 块的顺序。链的初始种子包含适配器名称,因此 v3 与 v4 的相同文本不会互相命中。135-token 请求会有 8 个完整块,剩余 7 token 不纳入这一层哈希。
每个哈希记录哪些副本处理过它,以及它后面出现过哪些不同的块。后继集合只需要区分“一个”与“多个”,所以最多记录两个。若一个块已被所有副本处理,或有多个后继,就将它视为公共前缀。公共聊天模板或系统提示很快会在每个副本出现,不能用它们判断一个具体问题真正缓存在哪一张卡上。
为每个副本统计连续匹配的前导块,减去公共前缀后,就得到该 prompt 的专有匹配长度。路由规则如下:
- 若某个副本有专有匹配,而且它的在途请求数不比最轻负载副本多出 8 个以上,就发给它,记为 affinity hit。
- 若有专有匹配,但该副本过忙,就放弃缓存亲和性,交给最轻负载副本,记为 spill。
- 若没有专有匹配,按最小负载分配;并列时轮询,记为 unmatched。
例如 A、B 各有 3 个请求,只共同缓存了模板块。问题 0 的首个请求可以分到 A,下一条同题采样会利用 A 的 8 个块;问题 1 没有专有命中,应分到负载较轻的 B。当 A 已有 12 个在途请求而 B 只有 3 个时,即便 A 缓存了问题 0,也要把新的请求转给 B。省一次 prefill 不值得让一张卡长期排队。
这仍是基于代理观察记录的亲和性启发式,不等同于直接读取 GPU 内部的实时缓存状态。原文也指出,更大规模时可能需要更深入的推理负载指标。
加载广播:处理挂载可见性差异
每个 Job 拥有自己的存储桶挂载,新的适配器目录未必同时可见。如果某个副本报告 No adapter found for <path>,代理只重试该副本,直到成功或超时。若出现其他错误,则对已经加载成功的副本发送卸载请求,避免只有部分副本认识新策略。
原文将这一策略称为全成或全败:/health 仅在全部副本健康时返回 200;/server_info 和 /v1/models 只需选一个副本回答;加载、卸载、暂停和恢复则需要广播。
静态审核补注:文中展示的是控制流程片段,不是分布式事务证明。回滚请求本身也可能失败,应检查其响应并停止使用状态不确定的副本。原文片段还省略了部分变量、错误汇总和完整超时逻辑;不能直接复制为完整代理。共享目录的发布与最终可见性也应分别验证,不能仅看到“原子重命名”就假定所有挂载瞬时一致。
第一轮实测:正确运行,但训练器吃不下采样
参考实验跑 500 步,每 50 步保存检查点。训练器使用 h200x2 Job,两个推理副本各使用一个 h200 Job。原文报告三者合计约每小时 20 美元,这是当时的配置估算,不是当前报价。
| 环节 | 优化前 | 优化后 |
|---|---|---|
| 完整同步 | 30.8 秒 | 中位数 8.5 秒,范围 6.6–9.2 秒 |
| 暂停两个副本 | 0.3 秒 | 0.3 秒 |
| 适配器 all-gather 并写存储桶 | 0.6 秒 | 1.1 秒 |
| 两个副本接受适配器 | 约 29 秒 | 约 7 秒 |
252 次适配器加载全部成功,其中 6 次在第二次尝试成功,246 次在第三次尝试成功。这组结果说明该实验里的挂载可见性延迟确实需要重试;它不能保证之后永不失败。
64,728 次 rollout 中,两个副本分别接收 31,928 和 32,800 次;affinity hit 为 54,712,spill 为 820,unmatched 为 9,196。对应比例是 84.5%、1.3% 和 14.2%。每个 prompt 有 8 次采样,至少第一次通常是冷请求,所以理论上的冷请求下限约为 12.5%。
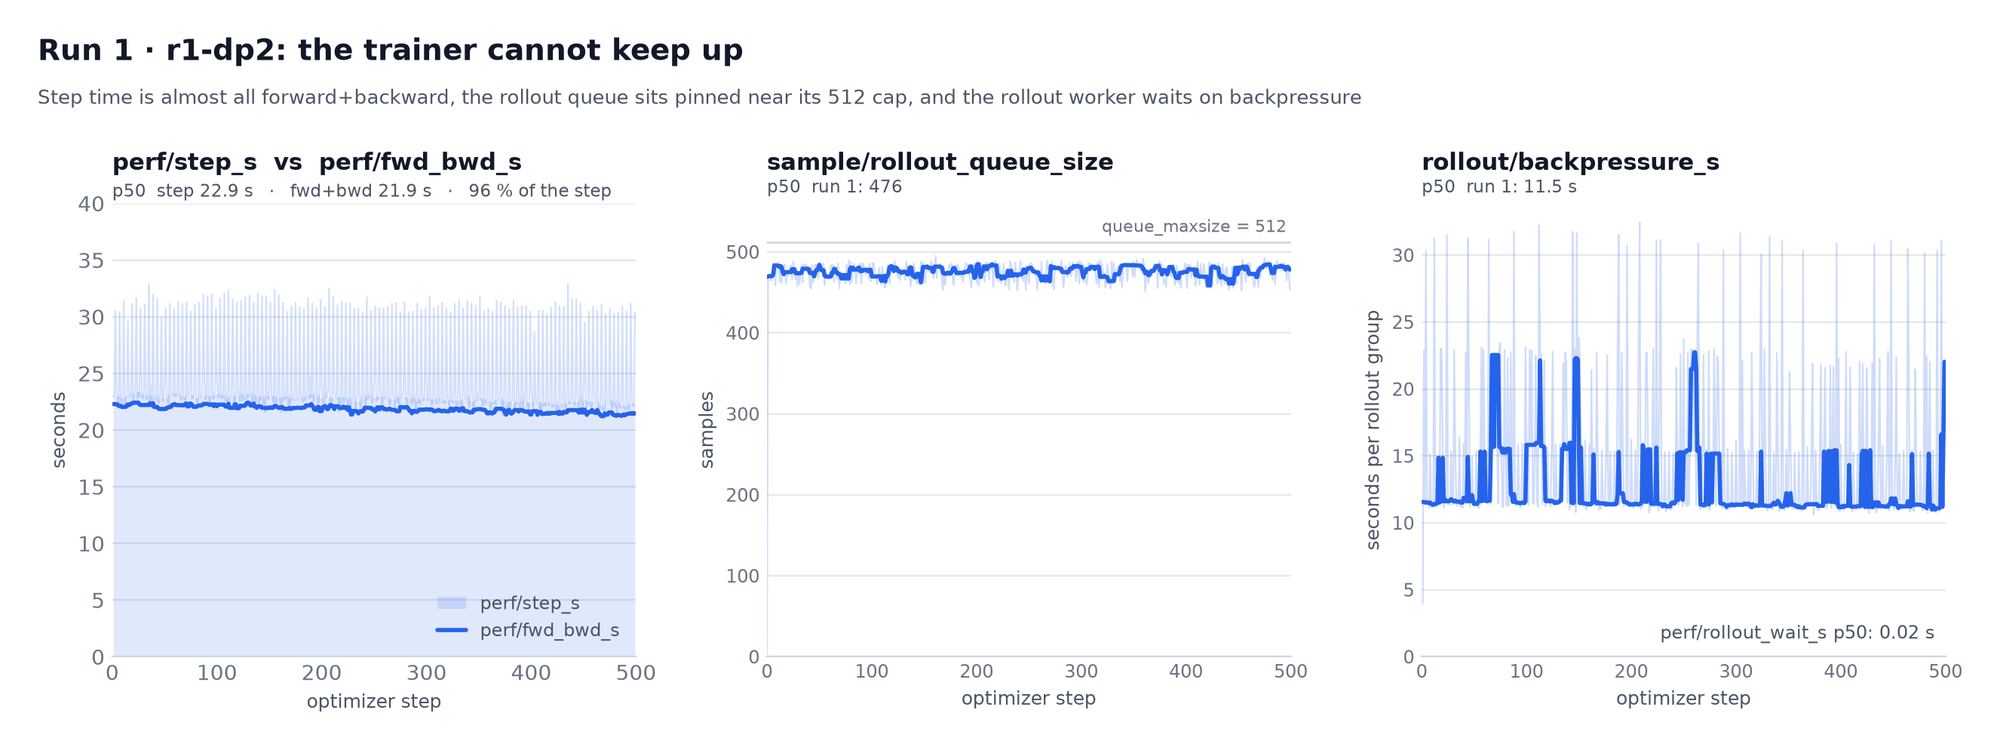
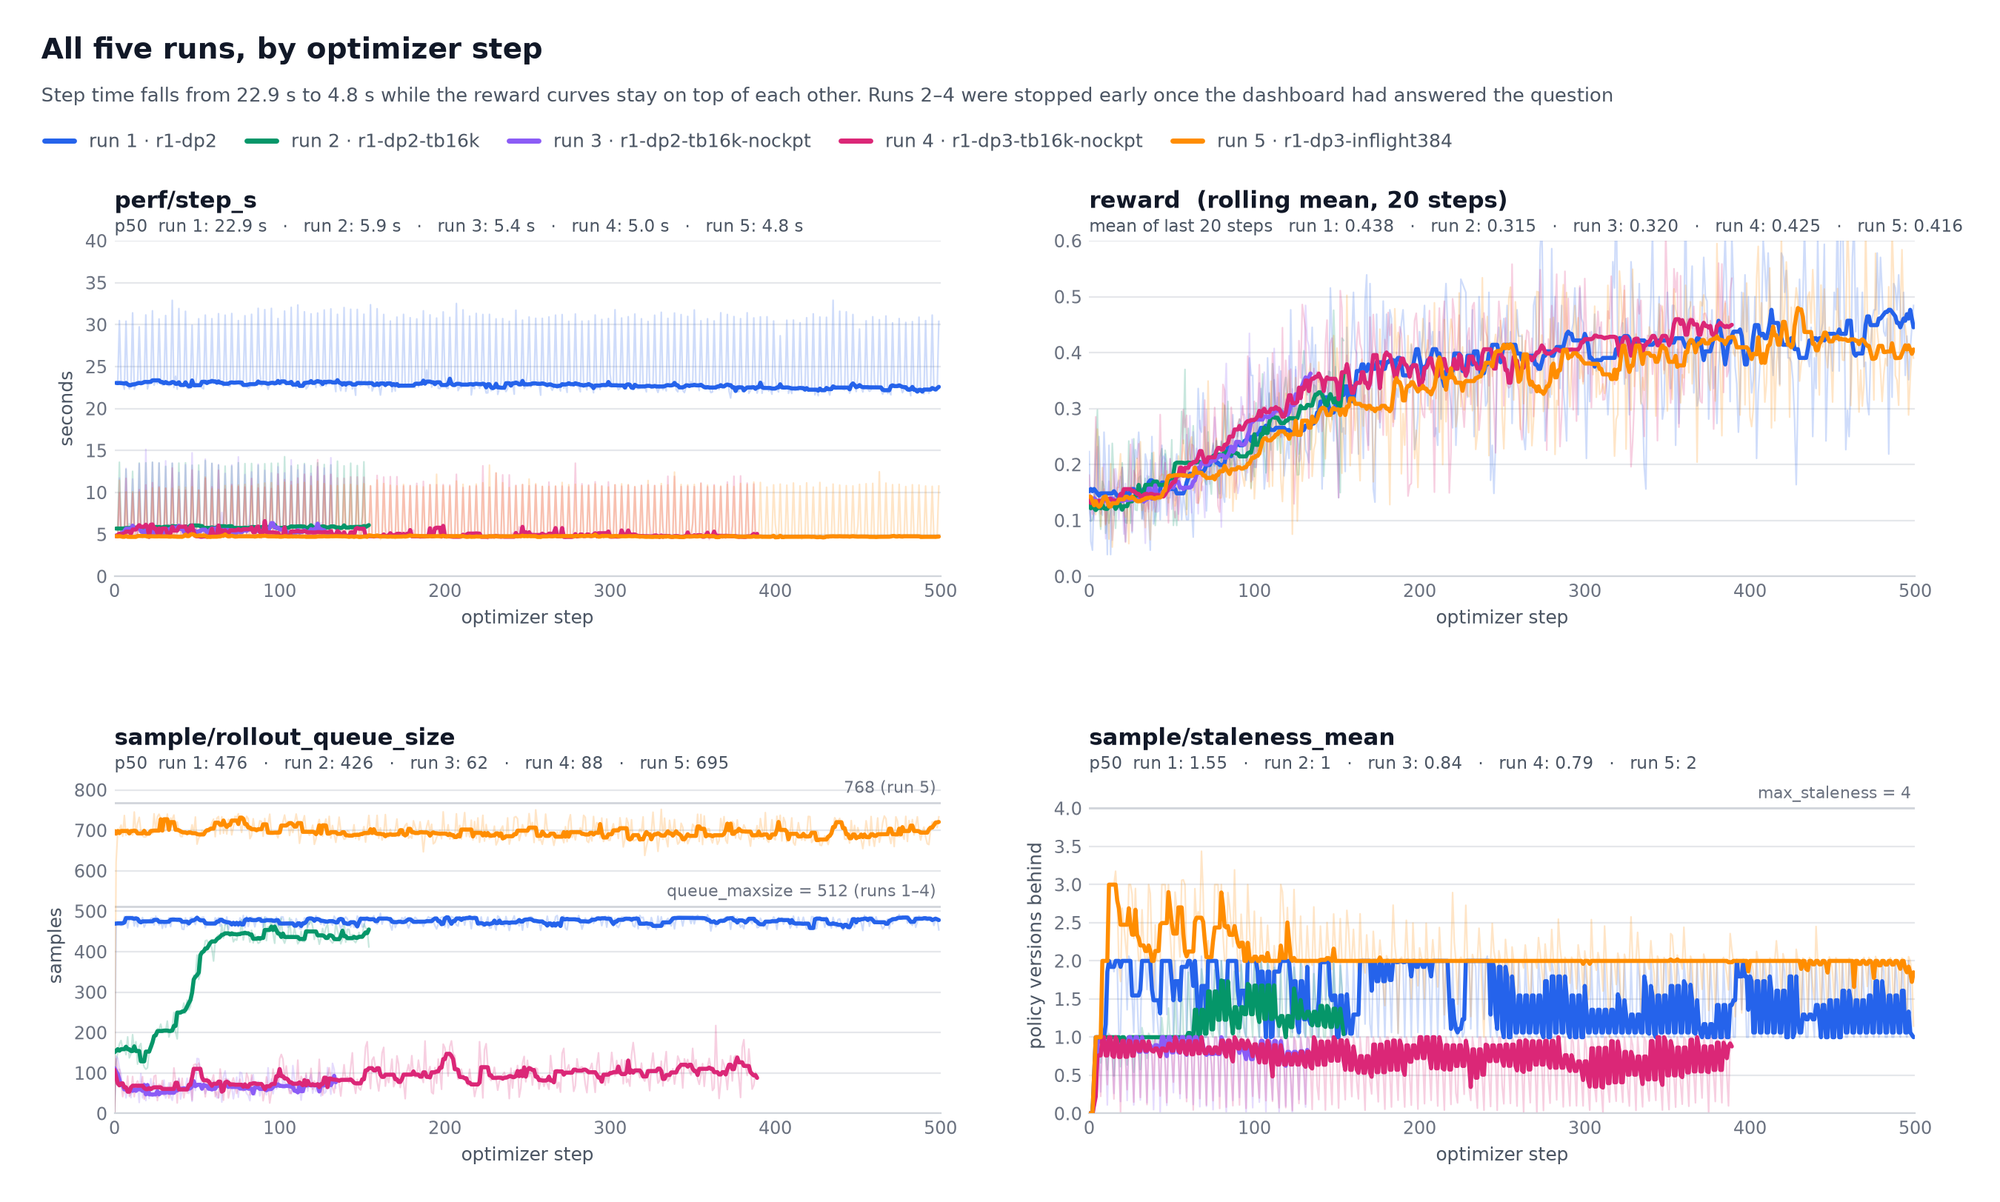
但是,优化步骤中位耗时 22.9 秒,前向和反向就占 21.9 秒;等待 rollout 只需 0.02 秒。容量 512 的队列平均附近占用约 476,训练 MFU 约为 3.9%。生成端已经比训练端快,再加推理副本并不能解决问题。
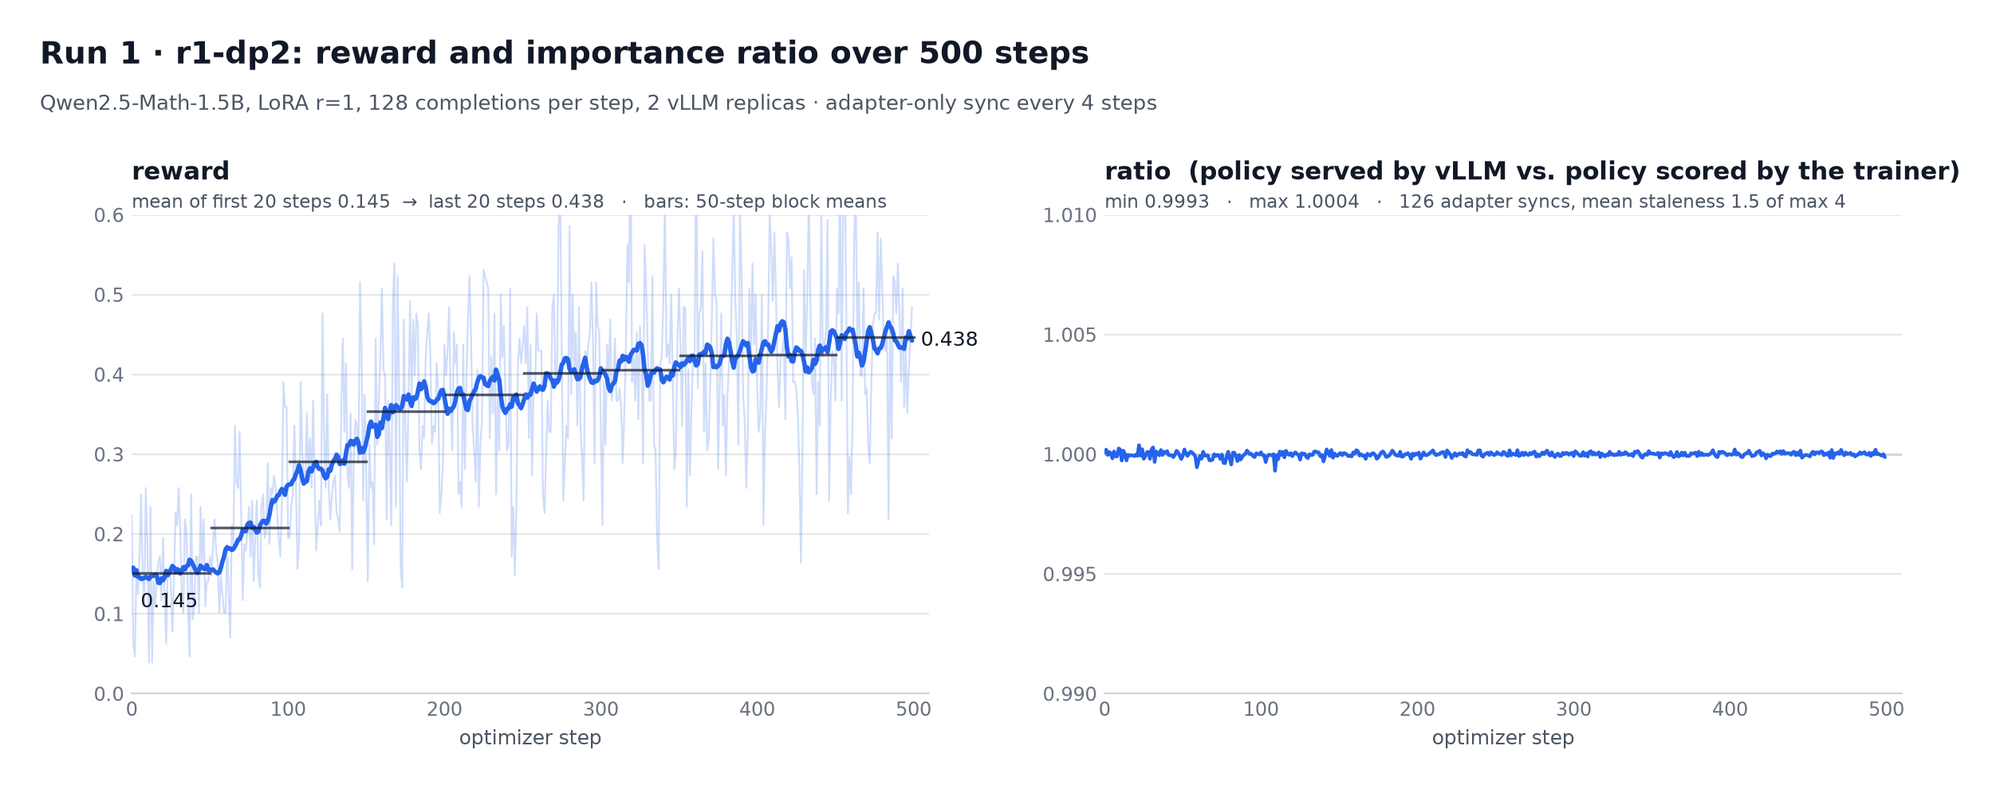
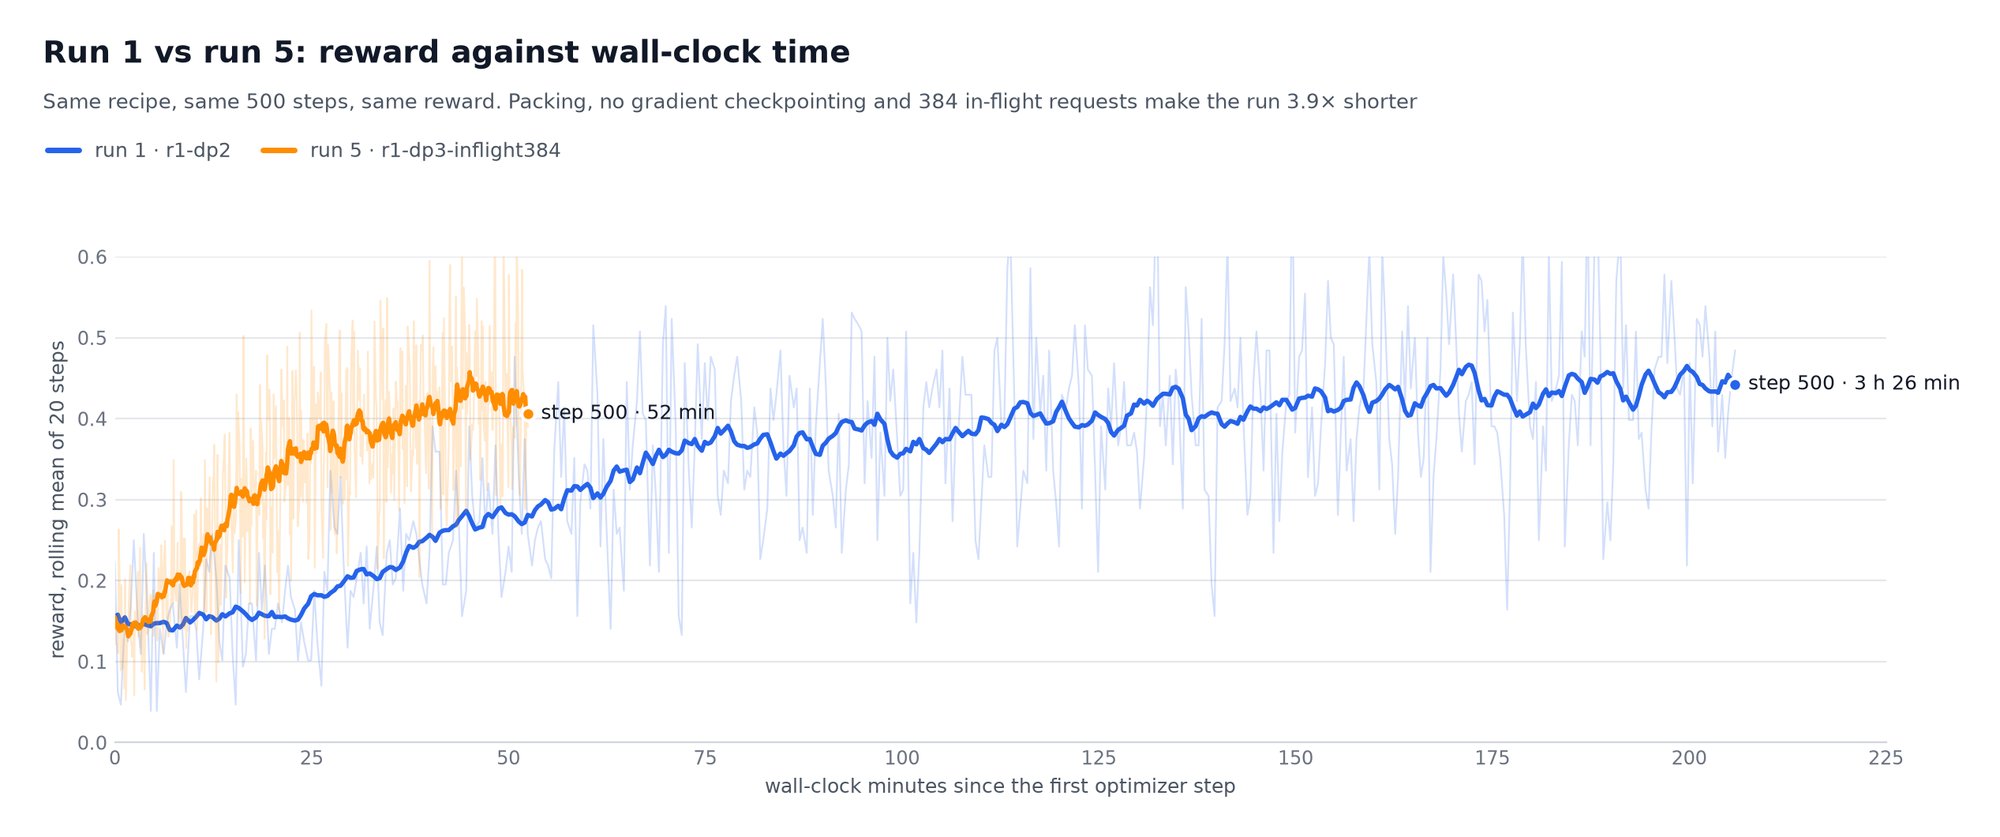
500 步总计 3 小时 27 分钟。首 20 步和末 20 步平均奖励由 0.145 升至 0.438;ratio 在 0.9993–1.0004 附近,平均陈旧度 1.5 个策略版本,低于允许的 4。原作者据此判断这次运行的训练与推理策略保持一致。本文不把接近 1 的单一指标提升为所有故障均已排除的保证。
沿着队列与等待时间,逐轮移动瓶颈
perf/rollout_wait_s 表示训练端等样本多久;rollout/backpressure_s 表示生成结果因队列满而等待多久。打分阶段无法入队时会阻塞,继而让生成阶段无法交付下一组结果,形成 rollout/score_block_s。这些指标结合队列占用,比只看单张 GPU 的吞吐量更有解释力。
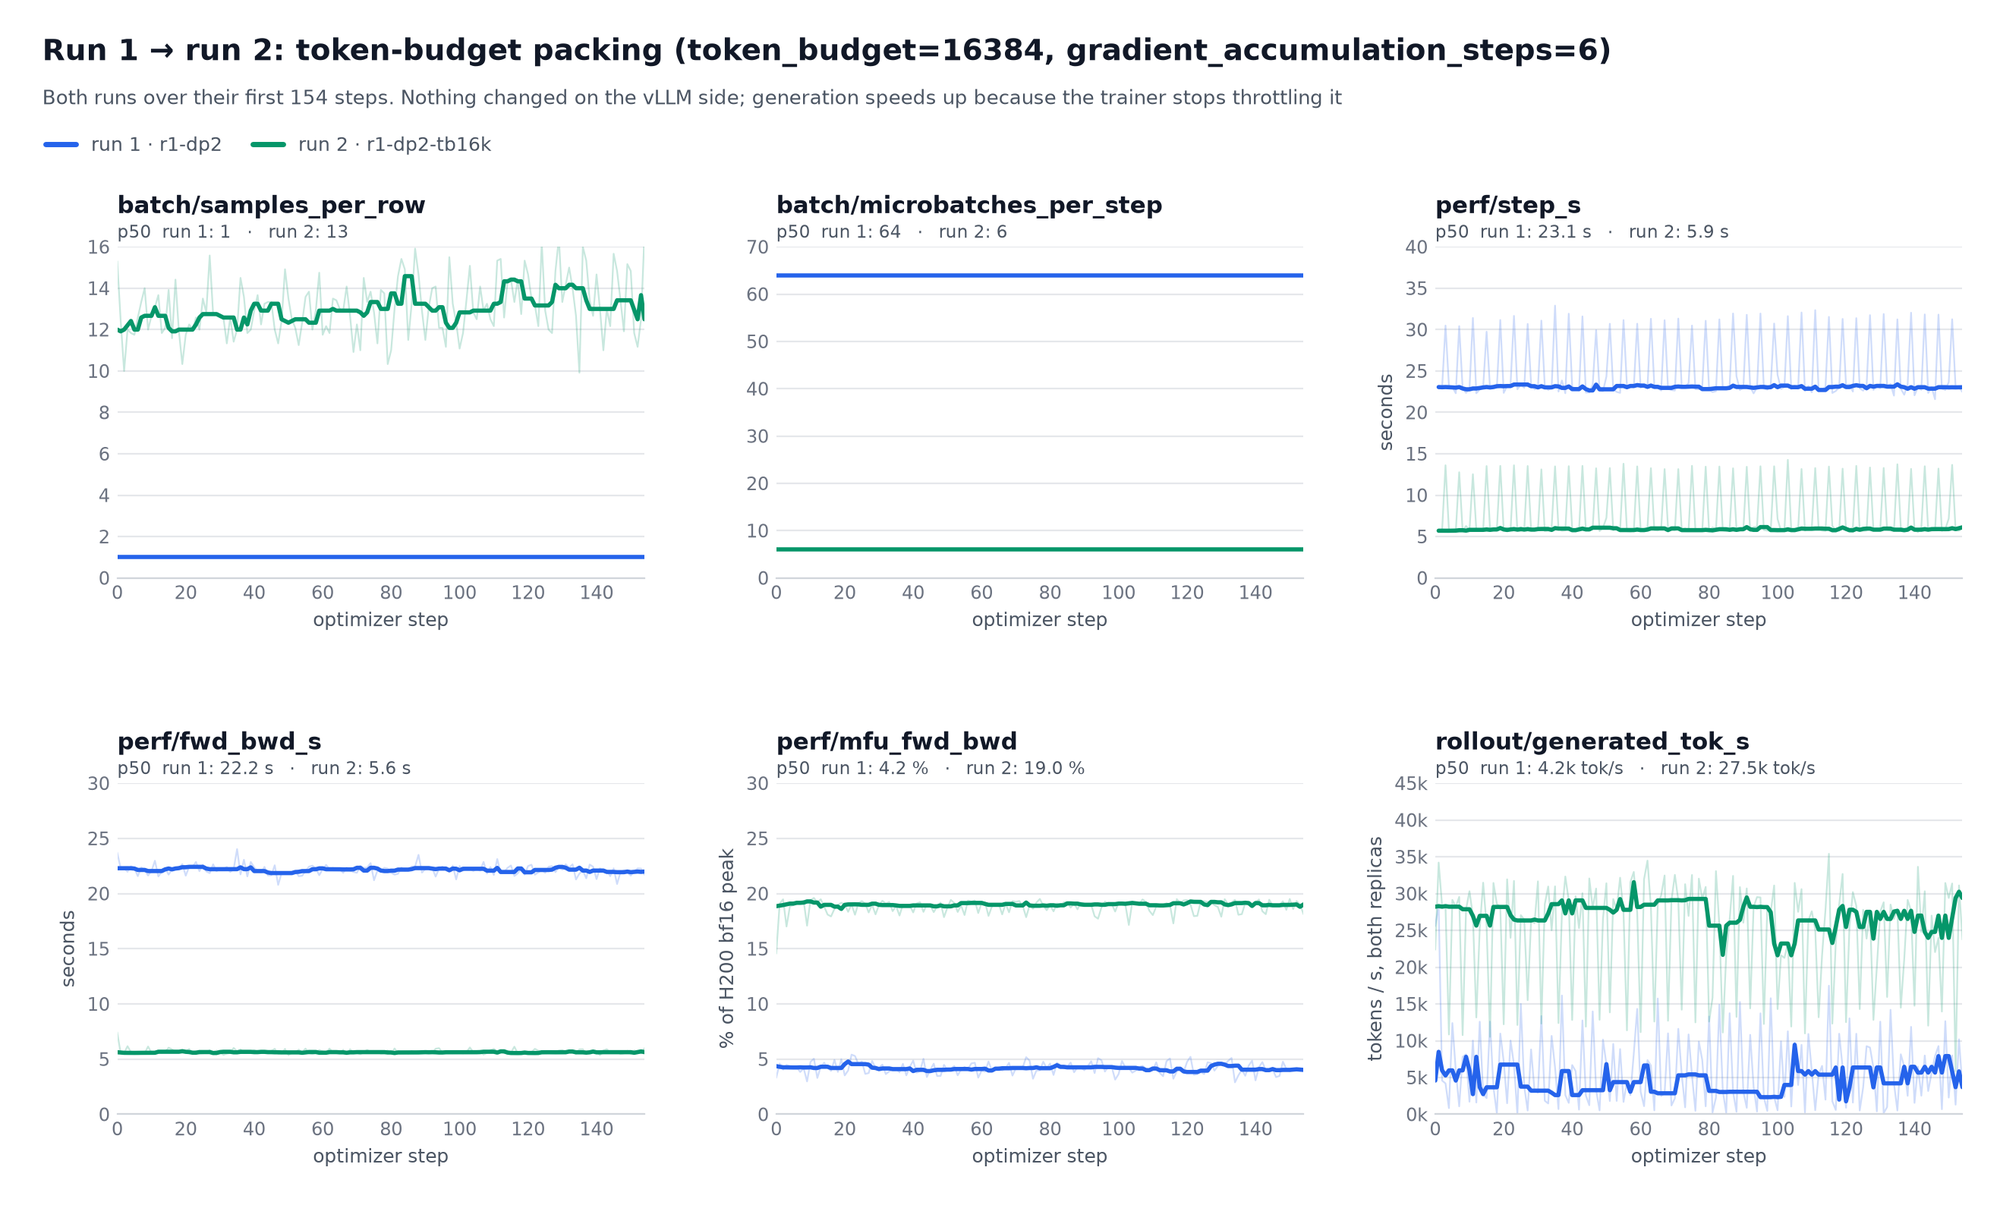
第一轮 r1-dp2 使用 per_device_train_batch_size=1,每个 rank 每次只处理约 1.2k token 的一个序列,每步要做 64 个 microbatch。对 H200 上的 1.5B 模型而言,这让计算被小批次调度延迟拖累。
第二轮 r1-dp2-tb16k 改成 token-budget batching:设置 token_budget=16384、gradient_accumulation_steps=6,把多个样本紧密装进无填充的行。每行样本数约从 1 变成 12.7,行填充率达到 95%,microbatch 数从 64 降至 6,前反向从 21.9 秒降到 5.6 秒,MFU 提升到约 19%。生成速度也随背压减轻而上升,尽管 vLLM 配置没有变化。
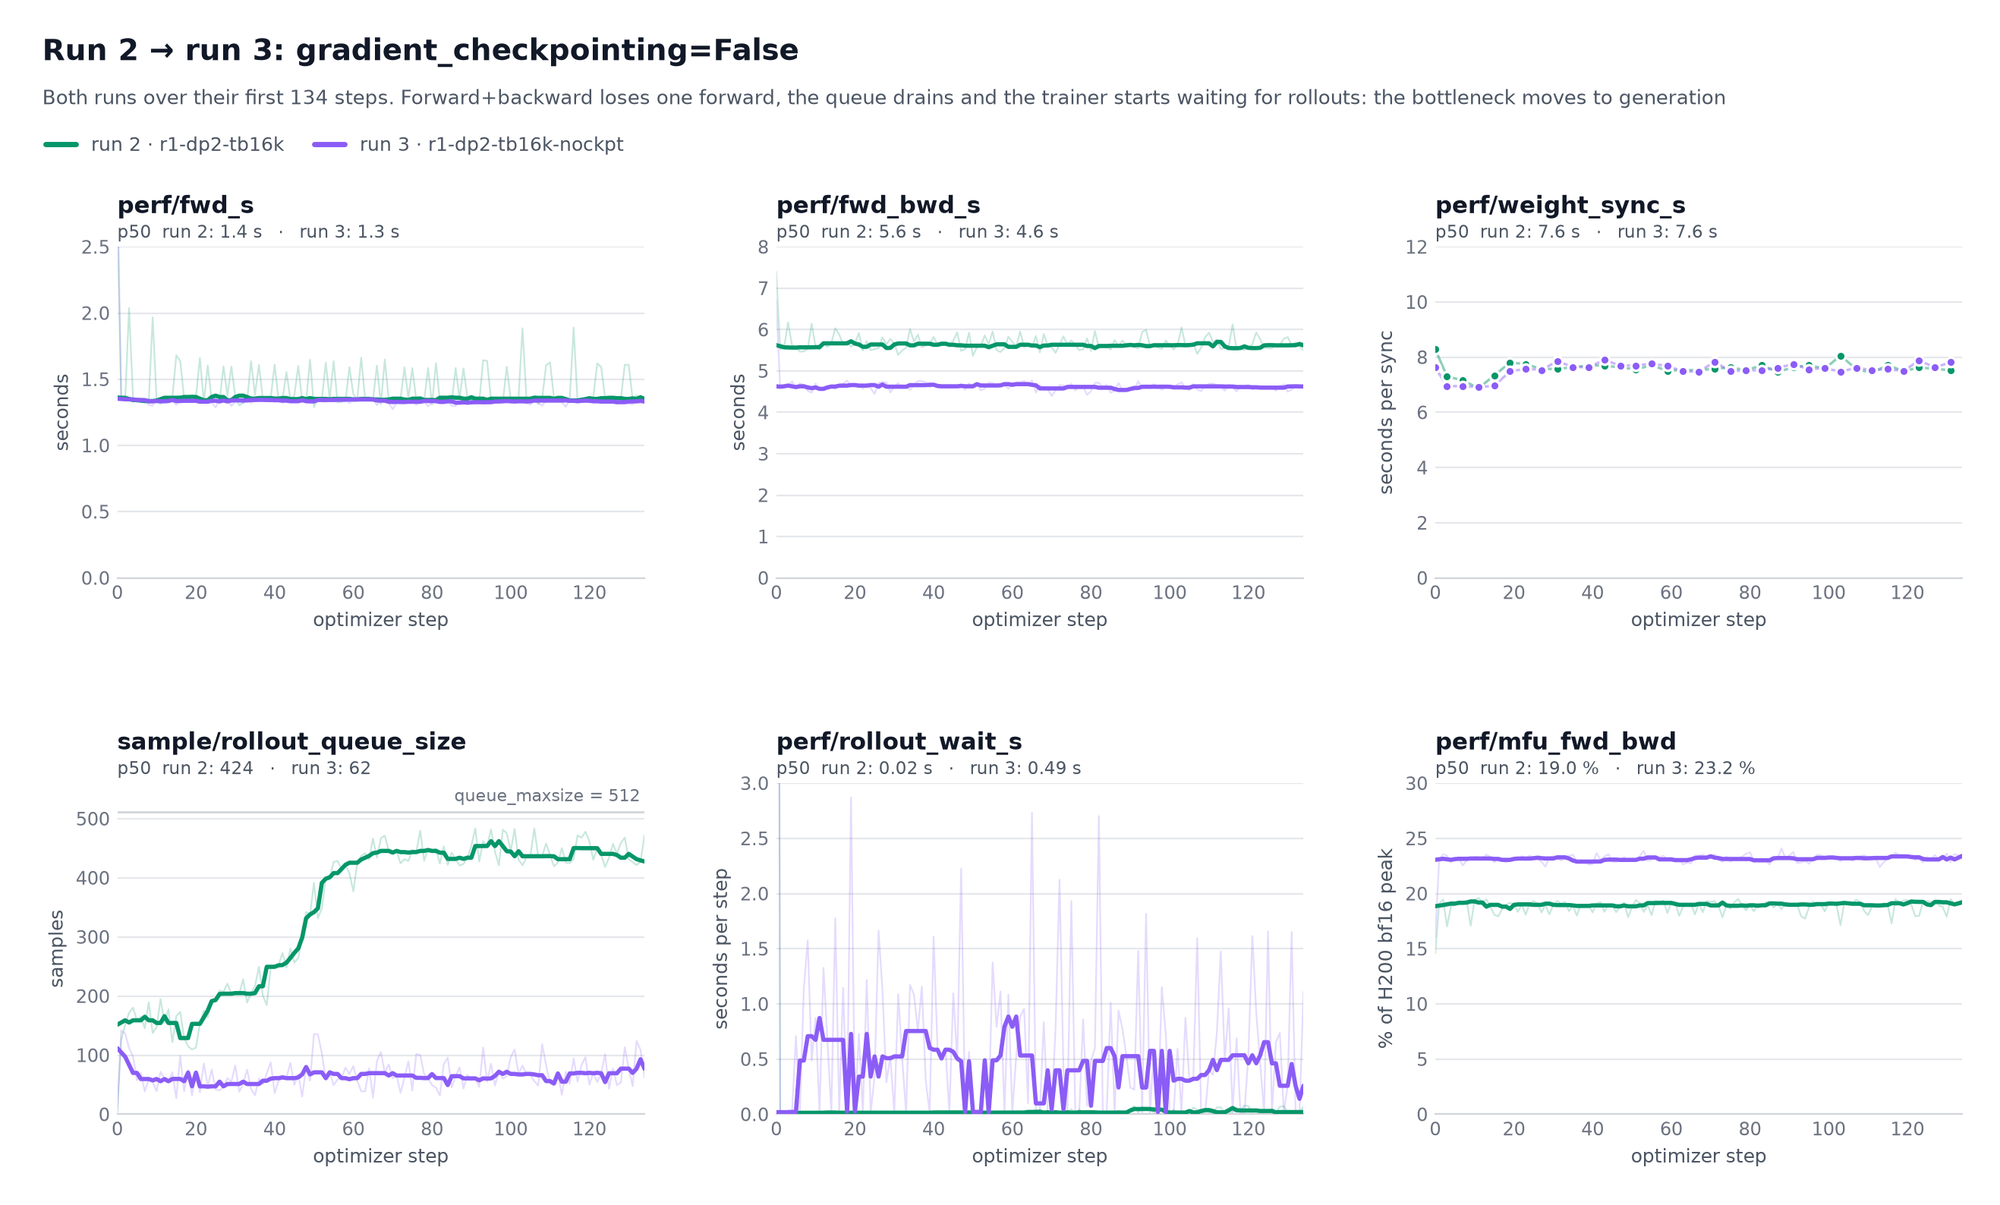
第三轮 r1-dp2-tb16k-nockpt 关闭 gradient_checkpointing。该实验模型较小、显存充足,没必要靠反向阶段重新计算前向来节省激活内存。前反向时间降到 4.6 秒,MFU 约 23%,队列下降、训练器开始等生成,瓶颈于是转到推理侧。这不是建议所有模型都关闭梯度检查点。
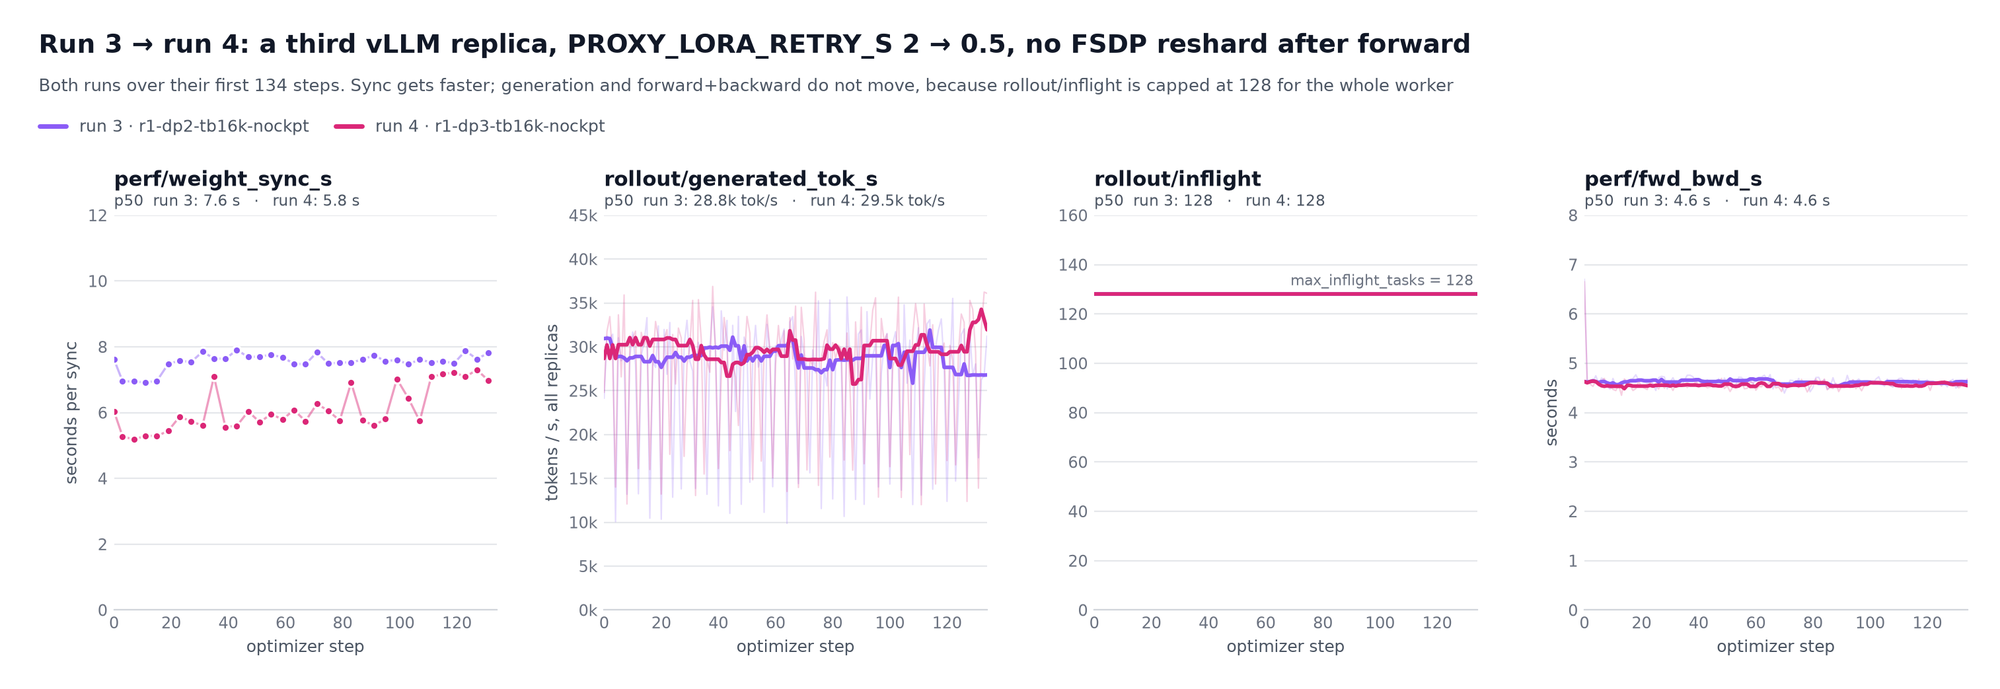
第四轮 r1-dp3-tb16k-nockpt 增加第三个推理副本,把加载重试间隔从 2 秒缩为 0.5 秒,并关闭 fsdp_reshard_after_forward 排查重分片开销。同步时间从 7.6 秒降为 5.8 秒,但前反向仍是 4.6 秒,生成速度也只是约 25k 到 26k token/s。问题来自全局 max_inflight_tasks=128:新增 GPU 只是把同样 128 个请求分成约 44、43、41 个,并没有增加总并发。
第五轮 r1-dp3-inflight384 把 max_inflight_tasks 提到 384,queue_maxsize 提到 768,每个副本约承担 128 个在途请求。队列重新填到约 690,背压回来,rollout 等待降至 0.03 秒,瓶颈重新回到训练。更大队列也让平均陈旧度从 1.5 增至 2.0,仍低于 4。
| 指标 | 第一轮 | 第五轮 |
|---|---|---|
| 总时长 | 3 小时 27 分钟 | 53 分钟 |
| 优化步骤中位耗时 | 22.9 秒 | 4.8 秒 |
| 前反向中位耗时 | 21.9 秒 | 4.6 秒 |
| 前反向 MFU | 3.9% | 23.5% |
| 每步样本数 | 128 | 168 |
| 训练样本总量 | 64,000 | 84,078 |
| 同步中位耗时 | 8.5 秒 | 6.2 秒 |
| 平均策略陈旧度 | 1.5 | 2.0 |
| 首 20 步 → 末 20 步平均奖励 | 0.145 → 0.438 | 0.145 → 0.416 |
原作者概括为约 3.9 倍提速,并训练了约多 31% 的样本。需要保留两个限定:中间第 2 至 4 轮在回答性能问题后提前停止;打包后实际每步样本数改变,因此不能把这张表描述为严格等样本预算下的对照。最终奖励也不是数值完全相等,而是曲线和效果大致相近。
复现入口与运行前检查
原项目位于 AmineDiro/hfjobs-lora-buckets。原文通过克隆仓库、hf auth login 后运行 run_all.sh --wait 启动实验,并用 MAX_STEPS=20 RUN_TAG=smoke 做约 15 分钟的小规模运行;参考 500 步配置约 3.5 小时,优化配置约 55 分钟。这些都是原文估计,不是本次执行结果。
运行前需要在自己控制的环境中静态检查脚本、固定依赖与镜像、确认 GPU 费用和超时,明确存储桶与 token 的权限,以及 Job 结束后服务器是否正确停止。原文优化入口列出 TOKEN_BUDGET=16384、GRAD_ACCUM=6、GRADIENT_CHECKPOINTING=0、PROXY_LORA_RETRY_S=0.5、MAX_INFLIGHT=384、QUEUE_MAXSIZE=768;还应核实项目脚本中的实际副本数量确实对应三副本实验,而不只复制这些变量。
参考资料
- John Schulman 等,LoRA Without Regret,Thinking Machines Lab,2025 年 9 月。
- TRL 的 AsyncGRPOTrainer 文档与 PR #7017。
- Penghui Qi、Zichen Liu、Xiangxin Zhou、Tianyu Pang、Chao Du、Wee Sun Lee、Min Lin,Defeating the Training-Inference Mismatch via FP16,2025。配套代码:Precision-RL。
- 完整运行曲线、hf-mount 重现脚本及 Jobs/Buckets 说明见原文参考链接。
原文路由与广播片段
以下逐字保留原文的局部伪代码,用于对照前述规则;省略的记录、超时、变量和错误汇总必须在完整项目中实现,不能单独执行。广播片段中 timed_out 与错误状态 st 的绑定没有在所示范围内完整定义;Python 3 的生成式变量不会自动泄露到外层,回滚响应本身也须检查。
def choose(self, upstreams, model, prompt):
    hashes = self.block_hashes(model, prompt)         # chained blake2b over 16-token blocks, seeded with `model`
    matched = self.matched_prefix(hashes)             # per replica: leading blocks it has served
    common = self.common_prefix_len(hashes)           # leading blocks that identify no prompt (see below)
    specific = [max(0, m - common) for m in matched]  # what actually distinguishes replicas
    least = min(u.inflight for u in upstreams)
    best = max(range(self.n), key=lambda i: (specific[i], -upstreams[i].inflight))

    if specific[best] > 0 and upstreams[best].inflight - least <= self.cfg.imbalance:
        pick = best                                   # affinity: the replica that has this prompt, and is not swamped
    else:
        candidates = [i for i in range(self.n) if upstreams[i].inflight == least]
        pick = candidates[self.rr % len(candidates)]  # spill or new prompt: least-loaded, round robin on ties
        self.rr += 1
    ...record `pick` as an owner of every block, and each block's successor...
    return upstreams[pick]
async def load_one(u):
    while True:
        status, _, out = await send(u, "POST", "/v1/load_lora_adapter", headers, body)
        if status == 200 or "No adapter found" not in out.decode() or time.monotonic() > deadline:
            return u, status, out
        await asyncio.sleep(cfg.lora_retry_s)          # this replica's mount has not seen the directory yet

results = await asyncio.gather(*(load_one(u) for u in ups))
if any(st != 200 for _, st, _ in results):
    await asyncio.gather(*(send(u, "POST", "/v1/unload_lora_adapter", headers, unload) for u, st, _ in results if st == 200))
    return web.Response(status=504 if timed_out else st, text="rolled back on the others")
原文引用 LoRA Without Regret 时提出一个信息量解释:策略梯度每次episode的优势函数大约只提供 O(1) 比特信号,因此秩为1的适配器在其研究场景下可具备足够容量。这是来源研究的论证背景,不是所有强化学习任务的容量保证。路由例子中两个问题分别为135与103个token,共享23-token聊天模板;只匹配公共块并不能定位独占缓存。原代理在参考128个在途非流式JSON请求规模下未显现瓶颈,不可自动外推到更高并发。
原文架构与实验图
原始图片版权与许可
架构图及七张实验图来自 Hugging Face documentation-images 数据集,由原文作者及 Hugging Face 贡献者提供,保留原图内容。数据集声明使用 Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International(CC BY-NC-SA 4.0,署名—非商业性使用—相同方式共享)。查看图像许可声明。该许可针对原始图像,不据此推定博客正文许可;未完纪原创中文示意图另行标注。











暂无评论内容