


基数是你按多少个维度为读数建立索引的结果。下面通过测量展示曲线在哪里转折,以及不离开 Postgres 就能采取什么措施。
有人给传感器表加了 firmware_ver 列。一行 DDL,一分钟就通过审查。两周后,摄取任务错过时间窗口,曾在毫秒内返回的仪表盘查询耗时变成秒级,值班工程师翻查 EXPLAIN,想知道规划器何时停止使用索引。摄取速率几乎没变,改变的是索引形状:多一个索引维度,数据库需要跟踪的不同序列数量就发生了乘法增长。
你并未触及引擎上限,而是改变了自己掌握的模式设计决策。因此,解决办法是改变模式,而不是换数据库。本文将这项一行改动的成本量化,并与同一基线上增加一百万行的成本比较,展示成本真正落在哪里:索引宽度和规划器估算,两者都源于模式设计。
“标签免费”:起初有效的默认选择
主流时间序列入门都教同一种模型:把可能用于过滤的属性直接附在读数上。在 InfluxDB 行协议中叫 tags,在 Prometheus 中叫 labels,在 Postgres 中则是宽表的列。设备、传感器、单位、站点、产线、固件版本——引擎把这些值的每种唯一组合当成独立序列。
小规模时,这是正确选择:不用设计元数据表,读路径没有连接,也不用创建和维护代理键。按标签限定的查询很快,因为标签就在索引中。无需前期设计就能得到这些好处。
它基于一个假设:建立索引的属性集合固定,且事先已知。对于指标集合明确定义的产品,假设成立,宽表可能在整个生命周期内都仍是正确选择。
工业设备群的特点却恰好违反这一假设。每次集成都带来某个希望用于过滤的描述字段。新厂商加入固件字段;合规团队要班次代码;维护团队要产线变体。它们都不是错误,却各自新增一个索引维度。
基数究竟是什么,以及增长的两种方式
这个词常被宽泛地用作“有多少标签”的同义词,因此先严格定义:基数是一个维度可以取到的不同值的数量。 数据库跟踪的不同序列数,是所有索引维度的这些数量之积。一万项资产、每项一百个传感器、十个固件修订版、一百个站点,约为十亿种组合。
这个定义把经常混淆的增长分成两个方向。
第一种是线性增长。给现有索引维度增加值,序列数按比例上升。多一百台设备,就增加一百台设备对应的序列。传感器从只报告0或1,变为报告0到100时,该维度的基数会从二增加到原文所说的一百,序列数随之增长。极限情形是 GPS 坐标这类连续值标签,维度实际上没有上限。
第二种是乘法增长。增加一个索引维度,序列数就乘上该维度不同值的数量。多一列、一个审查意见,数据库需跟踪的对象数量就成倍跳升。这类模式变化在差异中看起来微不足道,正是故障让人意外的原因。
用索引形状表示,只需一行:(tag_id, value, timestamp) 用一个维度标识序列;(tag_id, device, location, unit, firmware, value, timestamp) 则用五个维度。
但在 Postgres 中,这种增长落在一个具体位置,并不是标签索引直觉所认为的地方。复合 B-tree 每行有一个条目,而非每个不同组合有一个条目,所以索引大小约为 rows × entry_width。条目宽度是索引列宽度之和,再加上每条目的开销。
| 变化 | 在 Postgres 中的成本 |
|---|---|
| 多一百万行 | 1,000,000 × entry_width |
| 多一个索引列 | existing_row_count × new_column_width |
第二行解释了标题为什么可能成立:成本随全部现有行数扩展。但是否成立取决于基线;表足够小时,多一百万行会比多一列更贵。下面固定基线,测量两种改动。
第二类成本发生在规划器上,而且更尖锐。Postgres 合并选择率时假设各列独立,而生产设备群中的维度高度相关:设备位于一个站点、一条产线上,运行一种固件。把相关选择率当成独立值相乘,行数估计就会坍缩;每叠加一个相关谓词,误差继续复合。这就是 SQL 未变,却从索引扫描切成顺序扫描的原因。扩展统计可以不迁移就修补估算;下文会讨论它解决了什么、留下了什么。
同一个根本原因,在不同引擎中有不同表现,所以两位工程师即使描述互不相同的症状,也可能都在观察基数问题。标签索引引擎用序列索引映射每个唯一序列键,内存、启动时间与 OOM 风险随序列数增长,能调的杠杆是移除标签维度或删除数据。Postgres 宽模式通过普通机制出问题:高基数列使索引膨胀,autovacuum 运行更久并争抢写 I/O,规划器统计漂移使索引扫描悄然变为顺序扫描;宽行减少每个分块的行数,增加按分块规划的开销。
身在其中时,两者都像引擎撞了墙。因此,人们本能地选择换平台,而不是重新建模。
测量“悬崖”:基数基准测试
公开资料几乎不展示真实曲线,所以我们进行了测量。基线是在 Postgres 17.10、TimescaleDB 2.29.1 上存储一亿行相关的设备群数据。每个实验分支只改变一件事:A 增加一百万行;B 增加一个索引列 firmware_ver,也就是开头例子中的那列;C 是对照组,在总数据量固定的情况下改变不同标签数。如果基数本身使 Postgres 退化,应该在这里出现。每个分支都在三种基线规模下重跑,因此展示的是曲线形状,而非单个点。
| 分支 | 索引大小变化 | 估算与实际比率 | p95 延迟 | 插入吞吐量 |
|---|---|---|---|---|
| 基线 | 2.9 GB | 9.17x | 点查0.2ms / 范围0.7ms / 汇总313.5ms | 164,956 rows/s |
| A:+1,000,000行 | +30.1 MB | 9.68x | 点查0.3ms / 范围0.5ms / 汇总304.6ms | 168,113 rows/s |
| B:+1个索引列 | +864.9 MB | 10.42x | 点查0.3ms / 范围0.6ms / 汇总311.6ms | 137,941 rows/s |
| C:4k个不同标签 | +1.5 MB | 10.44x | 点查0.5ms / 范围0.5ms / 汇总46.9ms | 148,073 rows/s |
| C:40k个不同标签 | +16.0 KB | 10.31x | 点查0.2ms / 范围0.6ms / 汇总251.8ms | 160,808 rows/s |
| C:200k个不同标签 | -128.0 KB | 9.44x | 点查0.1ms / 范围0.4ms / 汇总1,008.3ms | 180,675 rows/s |
变化量相对于基线。B 分支还重跑过一次:用近乎唯一、独立的列替代 firmware_ver,同样一行改动的成本约为两倍,因为“加一列”的两个极端不应预期得到相同结果。
多一个索引列的成本,是多一百万行的28.73倍。 写路径也一致:新增列损失约六分之一插入吞吐量,一百万行则没有这项损失。但这个倍数属于当前基线,正如上面的算式所要求。对足够小的表做同样改动,不等式会反过来。
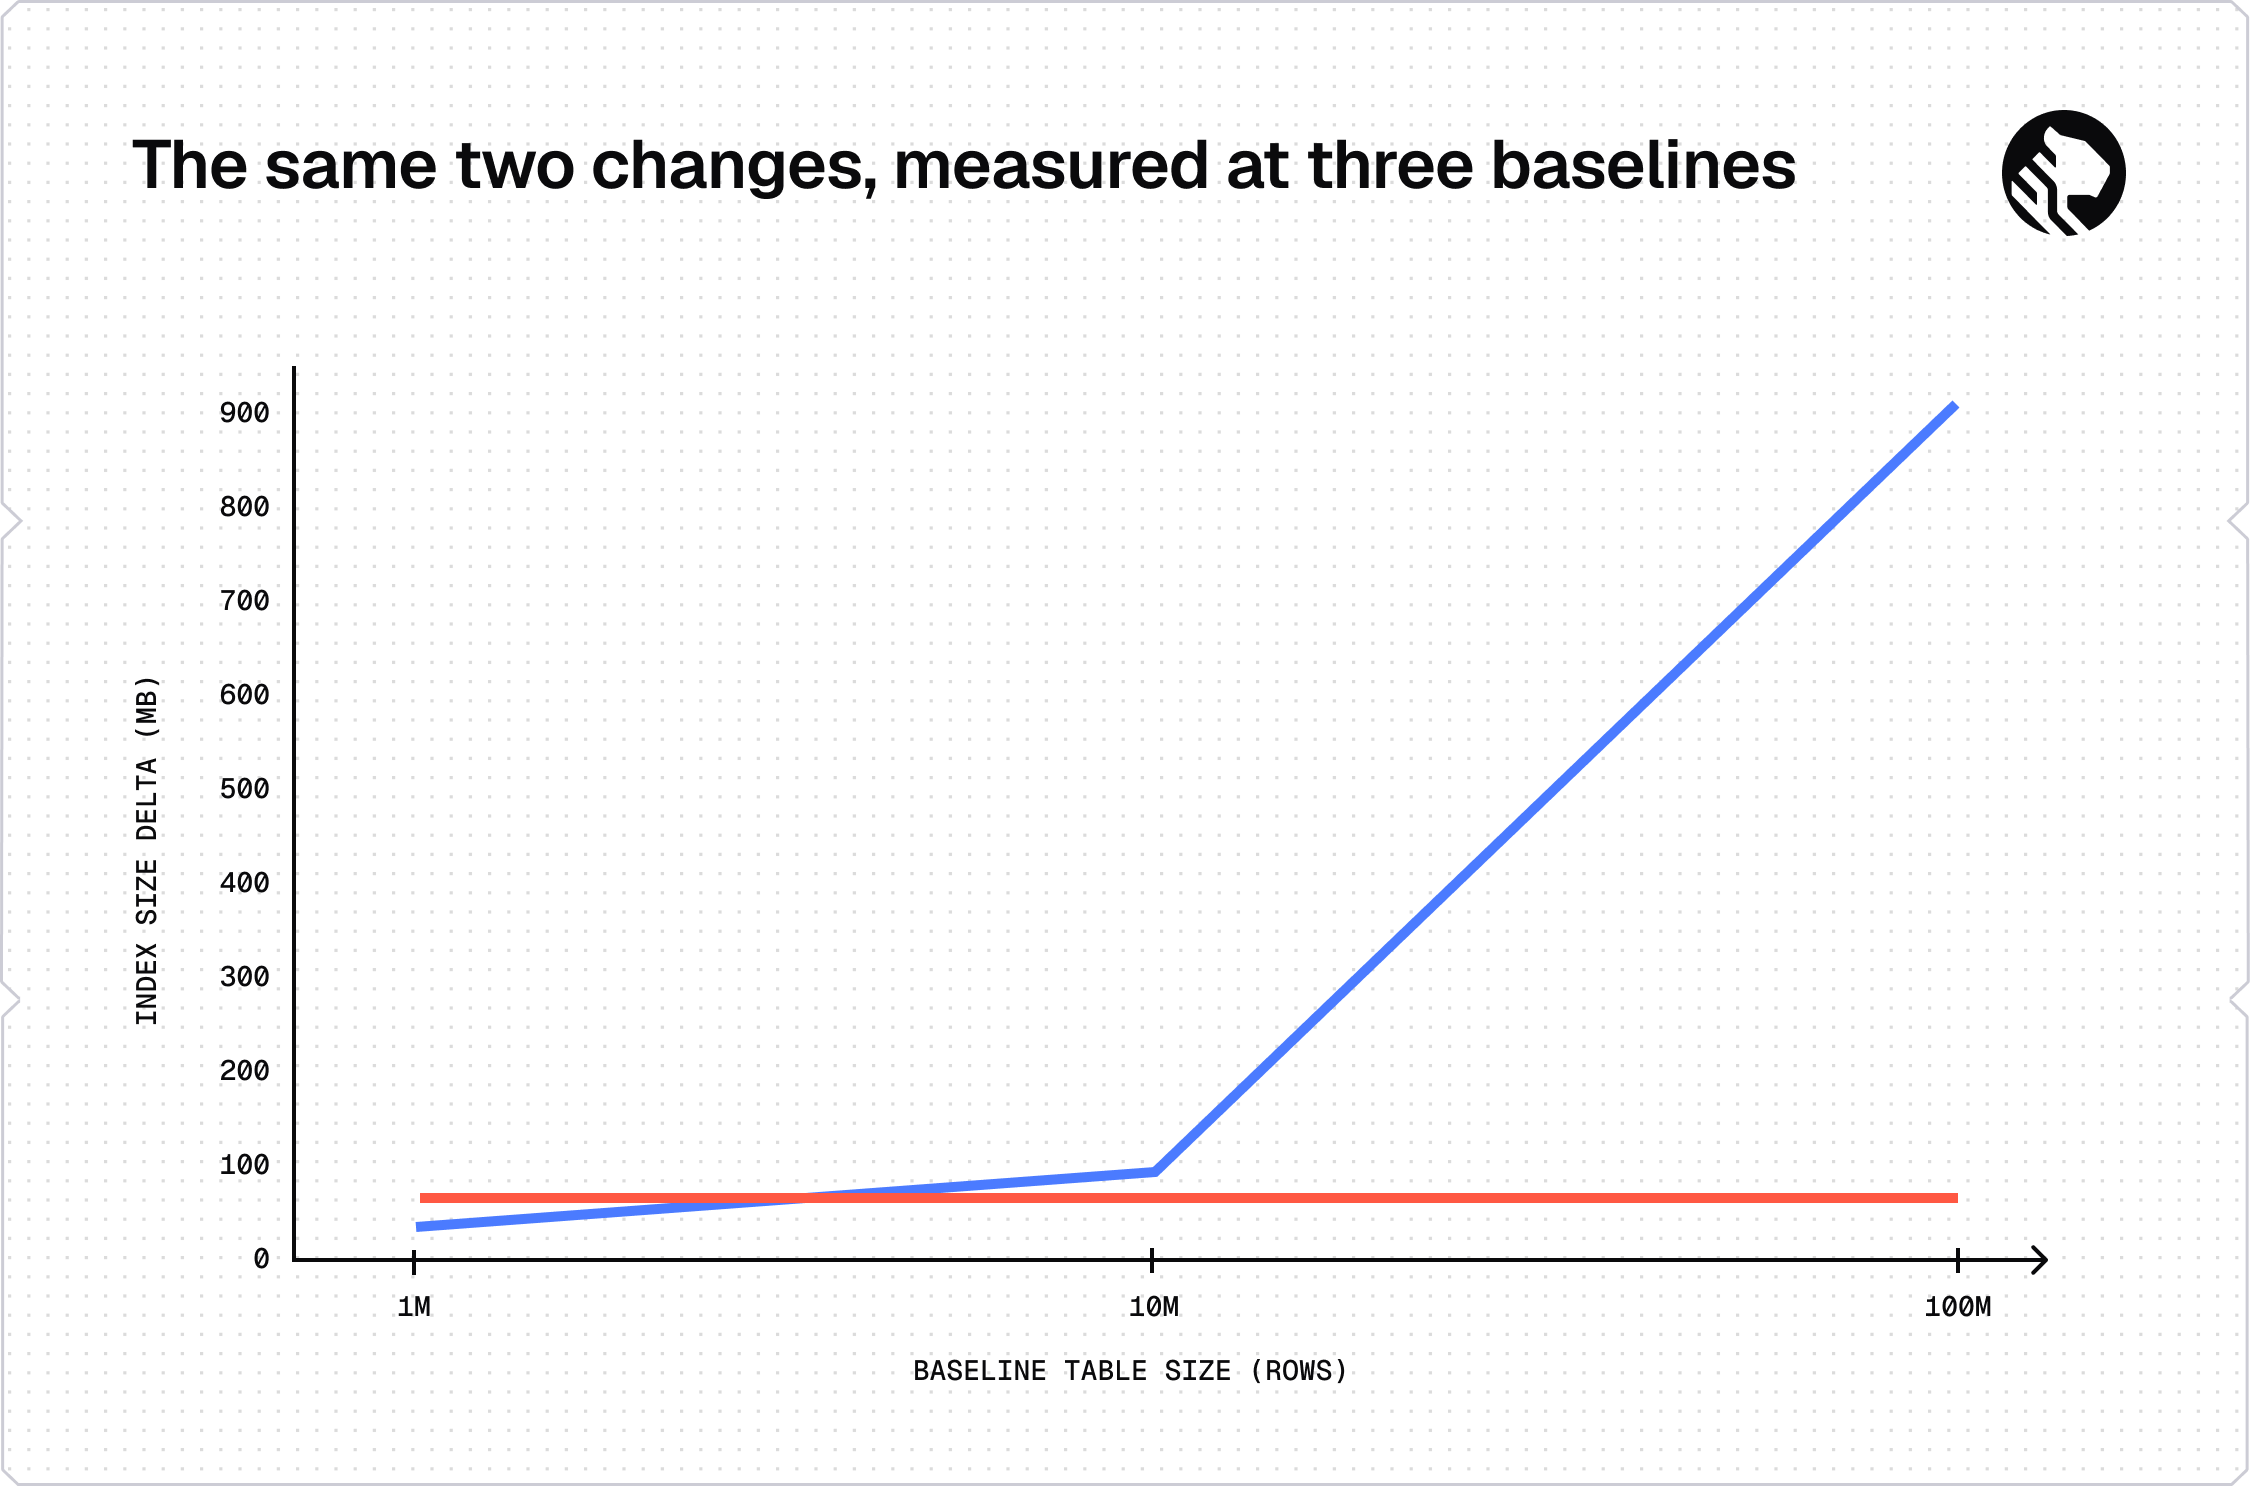
规划器数字才最值得带到设计评审中。按 site 和 line 两个相关维度过滤时,估算约低了九倍。沿相关链增加到四个过滤条件后,在宽模式鼓励使用的谓词上,估算低了三个数量级,达到2,880倍。复合误差来自叠加相关列,而不是数据量:两个谓词的数字在全部测量规模中都保持稳定。
对照组结果则是平的。我们沿基数轴寻找“悬崖”,却没有找到。把不同标签数乘以50,索引和估算比率都留在原位置。“悬崖”属于标签索引引擎的内存序列索引:它按设计随序列数扩展,无法产生这样的平线。Postgres 在别处付出成本,即索引宽度与规划器估算,两者都是模式属性。
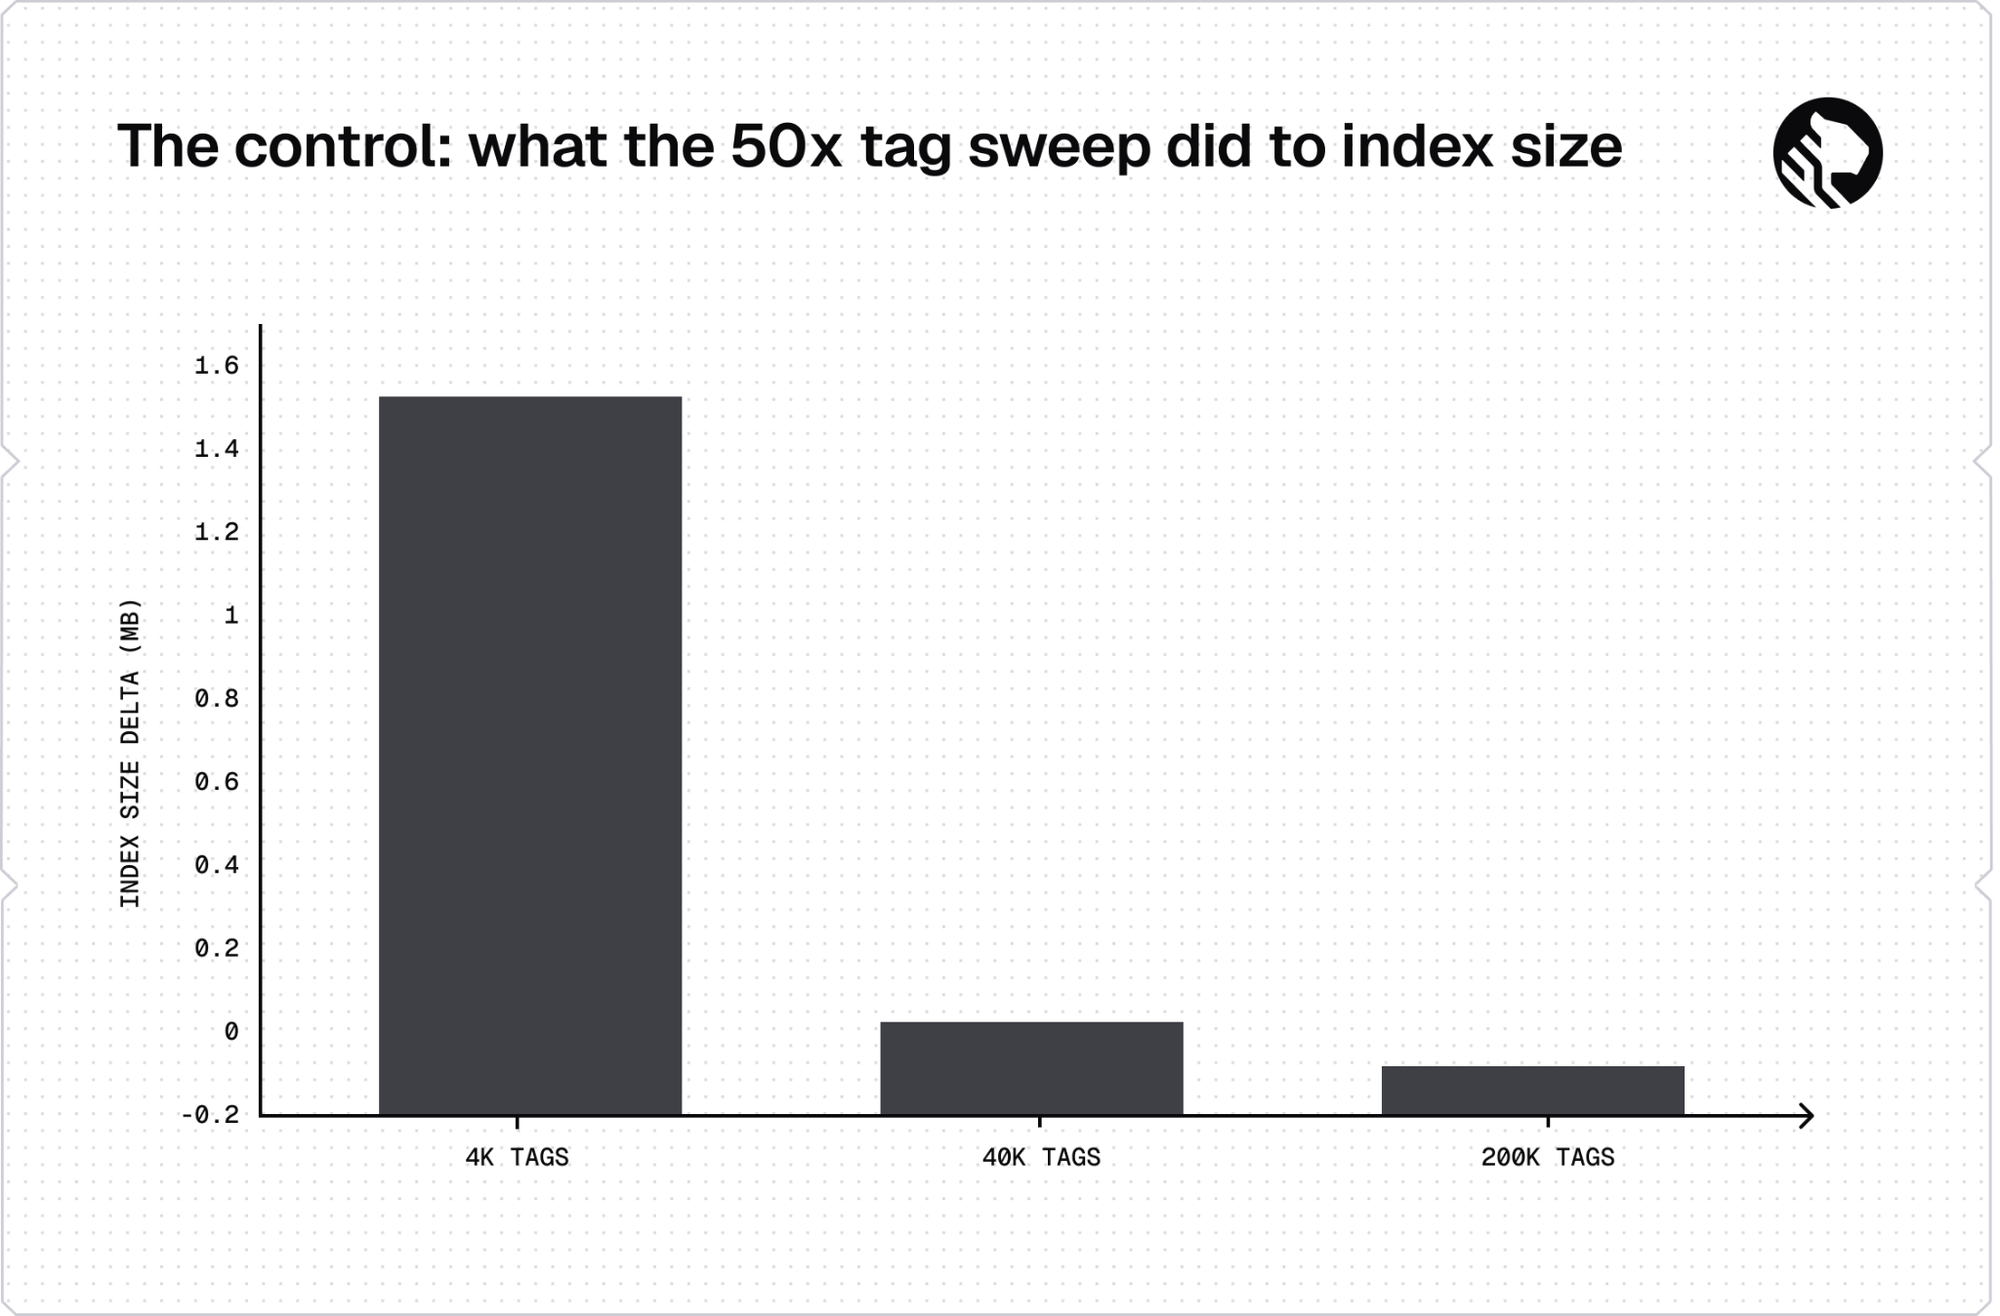
必须坦诚给出两个边界:平线只测到200,000个标签,而工业设备群可达数百万序列,不能无限外推。此外,对照组延迟和吞吐量反映数据生成器中的设备群形状,而不是基数,因此对照组应通过索引大小和估算比率理解。
这次运行之前,机制已存在于 Postgres 行为文档中。实验新增的是不等式中的具体数字、交叉点位置,以及传说会出现悬崖之处的一条平线。
重新理解:基数是模式决策,不是引擎上限
宽模式按描述序列的维度,而不是序列本身,为事实表建立索引。每一行永远携带每个描述字段,并在每次插入及规划器估算中为此付费。
将其规范化:给每个不同测量点一个代理标识符,在元数据表中只存一次描述属性,窄读数表只按这个标识符建立键。
索引从 (tag_id, device_id, site, line, firmware_ver, recorded_at) 缩为 (tag_id, recorded_at)。修复模式没有增加东西,而是移除了四列,因为 tag_id 从一开始就是序列身份。描述字段仍然存在,位于 tag_metadata,每个标签一行,离开写路径,也离开事实表索引。
“增加描述字段不会使序列数相乘”直接来自前述严格定义:如果序列数是索引维度不同值数量之积,而只有一个索引维度,增加描述字段就不乘任何东西。只有真正增加标签时,序列数才增长。
还有竞争策略,否认这一点不诚实。InfluxDB 3 重建于列式、对象存储架构之上,宣传可提供无限基数。这是同一问题的真实而不同的回答,但属于厂商声明,而不是独立基准结果。关键差别是工作落在哪里:一条路径要求采用新存储引擎;另一条要求执行你已经知道如何编写的规范化。
你在交换什么
关系型元数据并非免费。要预先付出模式设计工作、包含维护窗口的一次迁移,以及读路径上的连接。下面量化另一面:同样一亿条读数、同一机器、同样设置,窄模式的计量完整包含 tag_metadata。
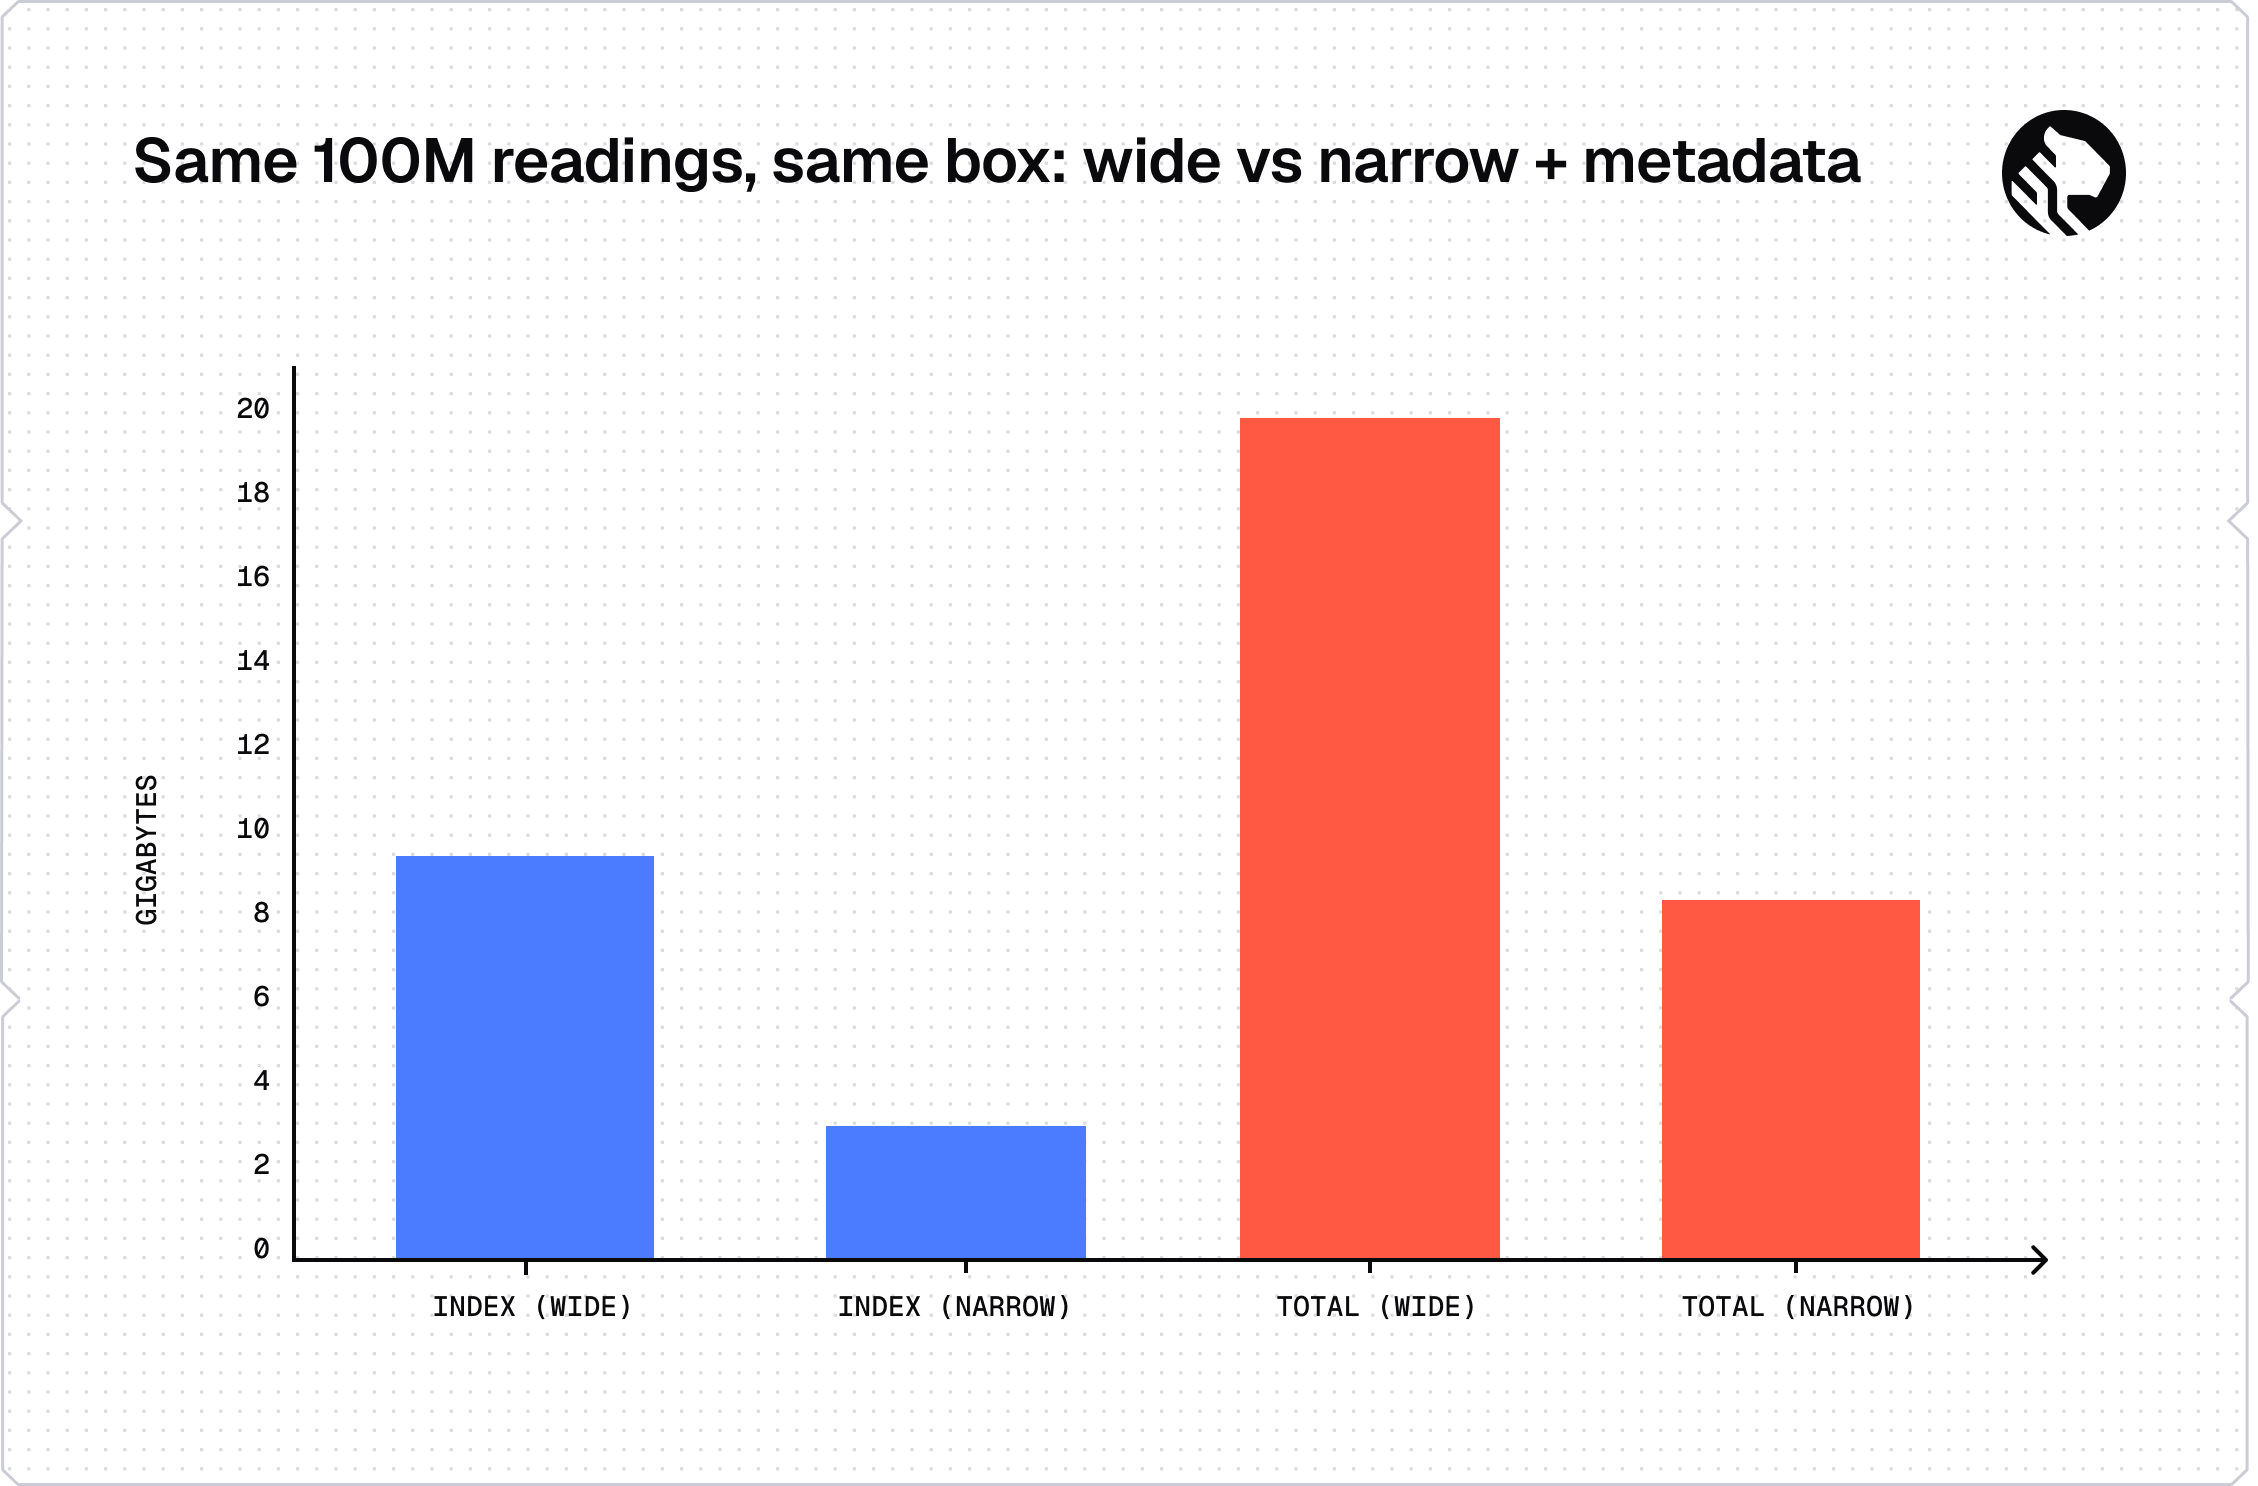
索引小了三分之二,总存储约减少一半。读取变化也符合宽模式的痛点:两个相关维度的汇总明显更快,四谓词版本约快30倍。点查和短范围扫描基本打平,两者都在亚毫秒级,符合一直由前导键驱动的查询特征。写入提升约四分之一到三分之一,取决于每次插入是否解析标签 ID,还是使用缓存映射。限制变为普通 Postgres 的行数和索引行为,而非内存序列索引。
这一对比有一项前提:两侧均关闭压缩,所以必须理解为未压缩比较。开启压缩会改变两边;宽表在比率上有更大提升空间,因为每行重复的描述字段,是列式格式最容易压缩的内容。元数据表不需要这种限定:每个标签只有一行,而读数随时间按标签积累,两者一起扩展,小到可忽略的部分仍然小到可忽略。
很容易声称规范化治好了规划器的独立性假设,但并没有。描述列只是移动到 tag_metadata,Postgres 对它们仍会产生近似幅度的误估。改变的是谁承担错误:描述字段过滤现在发生在五万行元数据表上,差的估算几乎不花成本;事实表则通过解析后的 tag_ids 访问,估算几乎准确。宽模式中,同样的误估落在一亿行事实表上,并达到三个数量级,这就是前述30倍差距的来源。盲点仍在,只是不再昂贵。
如果误估是唯一症状,CREATE STATISTICS 可以不迁移就修复,是正确的第一步。但它会完整留下索引宽度、写放大和 vacuum 成本。
最先感受到的是查询重写成本,兼容视图可以限定这项成本:通过把窄表重新连接到 tag_metadata,构建保留原宽形状的视图。没有它,规范化意味着切换当天重写每个仪表盘查询。有它,现有读取继续工作,重写可逐步完成。视图在读路径上增加连接,我们原以为会有成本,但与直接查询窄表相比,汇总差距在2%以内,亚毫秒查询低于测量噪声。视图不会是迫使你排定日程的因素。
本文没解决一个约束:工业标签值并不全是浮点数。同一历史数据库会出现布尔值、整数、字符串与状态码。单个 value DOUBLE PRECISION 列,会让你第一天就面对选择:多个带类型的列、每种值类型一张表,或者更宽的联合类型。
从哪里开始
设备群增长时看到的变慢,是索引形状的属性,而索引形状由你掌握。解决路径是 Postgres 内部迁移,你已经知道如何编写。
计划前,先检查自己的数据:每个标签是否一直具有相同描述字段,还是有些标签曾移动产线、改变固件。扫描一次宽表即可回答;对一亿行约需一分钟。
描述字段稳定时,元数据表可以直接从已有数据导出。标签生命周期内发生变化,也仍可迁移,只是更费时。重塑采用分批、可恢复的迁移,保留全部历史行;我们已端到端执行,包括故障演练。它和识别数据属于哪种情况的扫描,会成为后续文章主题。如果希望迁移期间由服务管理超表、压缩和策略,这就是 Tiger Cloud 的用途。











暂无评论内容