


调查事故时,上下文至关重要。假设你正在值班,半夜收到通知。告警将你带到仪表盘,你看到一个熟悉的延迟模式,但这个尖峰在当前时段是否正常,又是否与事故相关?接着,你扩大时间窗口,检查其他相关指标,尝试弄清发生了什么。你并非找不到答案,但这类情形时间紧迫:随手可得的上下文,可能决定问题能否快速解决,还是会陷入漫长的排障过程。
为解决这个问题,Grafana Labs 开发了一个仅基于 PromQL 的异常检测框架。到目前为止,它既用于内部调试,也成为 Grafana Cloud Application Observability 的组成部分,效果良好,因此团队将它分享出来。
本文基于近期的 PromCon 演讲,介绍这一可靠的开源框架如何构建,以及如何开始使用。
构建异常检测框架的方法
异常检测有多种实现方式,但团队要求框架遵守三个原则:
- 不依赖外部系统。必须兼容 Prometheus,才能与 Grafana Mimir 一起工作。虽然可以用外部工具从 Prometheus 读取数据并写回,但团队希望只用 Prometheus 内置功能,让任何人无需外部依赖即可使用。
- 在大规模环境仍保持性能。团队将自己的所有指标,以及 Grafana Cloud 用户的多租户实例放在 Mimir,因此框架必须能在很大规模下运行。
- 没有黑箱魔法。它必须能向团队成员及其他同事解释,也必须是团队有信心信任的实现。
这些是 Grafana Labs 的约束,但方法适用于更广泛的用户。事实上,框架能与任何兼容 Prometheus 的指标后端一起使用。
建立基线:第一次尝试
团队从多数异常检测方案采用的公式开始,它基于 z-score 公式:
Baselines = average ± stddev * multiplier
这个公式之所以常见,是因为它能建立一条中线——通常是跟随趋势的移动平均——并定义行为的上、下边界,边界之外视为异常。
实现使用了 Prometheus 记录规则。下面分别说明每个组成部分。
平均值
这里最重要的选择是时间窗口,需要在中线落后于指标的程度和平滑程度之间权衡。团队发现一小时最合适,因为系统针对短期异常检测,即较短时间内的大幅偏离。
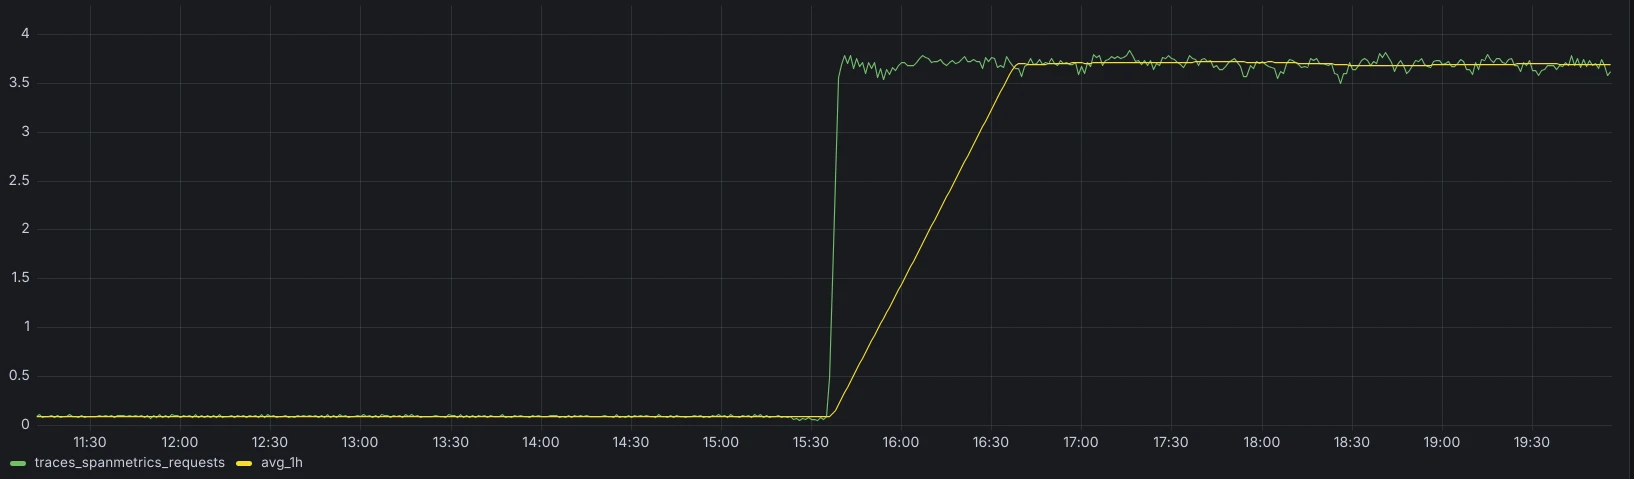
记录规则如下:
- record: avg_1h
  expr: avg_over_time(metric[1h])
标准差
Prometheus 提供 stddev_over_time 函数。这里采用较大的时间窗口,以纳入尽可能多的信息,让边界真正适应指标波动:
- record: stddev_26h
  expr: stddev_over_time(metric[26h])
这类计算通常采用24小时,但团队选择26小时,给用户更多余量。例如某件事每24小时发生一次,可能会让边界产生异常的收缩或扩张模式;夏令时也可能改变自然周期。额外两小时提供缓冲,使预测更准确。
乘数与最终公式
乘数属于调节参数。数值越高,边界越宽、敏感度越低;数值越低,敏感度越高。通常依用例选二或三,团队发现这里用二最合适。
- record: stddev_multiplier
  expr: 2
将这些部分组合,最初公式的记录规则如下:
- record: upper_band_st
  expr: avg_1h + stddev_26h * on() group_left stddev_multiplier

这是第一版框架的结果,看起来不错:图中出现尖峰,绿色阴影表示检测到了异常,灰色边界也随数据变异程度增加而扩张。团队对初次尝试满意,但在生产使用中遇到了几个问题。
克服实际挑战
下面介绍如何解决初版暴露的问题。
极端离群值
标准差公式对差异取平方,因此增长速度可能远快于平均值。极端尖峰会让边界迅速扩张,系统随后停止检测异常,几乎失去作用。
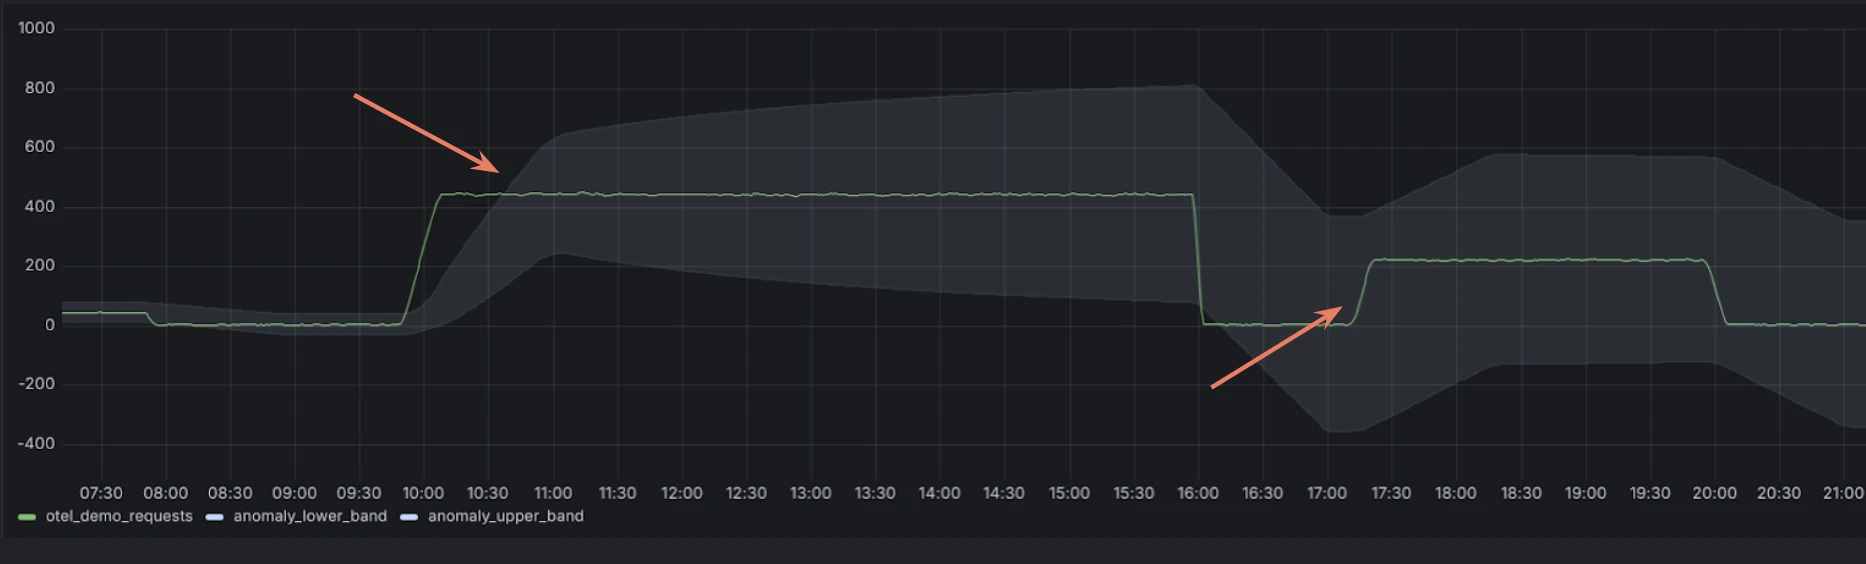
团队需要控制边界扩张速度,因此增加平滑函数,在边界敏感度与误报之间权衡。记录规则如下:
- record: stddev_1h
  expr: stddev_over_time(metric[1h])

- record: stddev_st
  expr: avg_over_time (stddev_1h[26h])
低敏感度
平滑函数实现了预期目的,却也造成过度修正:边界过窄,敏感度不足,无法捕捉正常波动,因此可能产生大量误报。
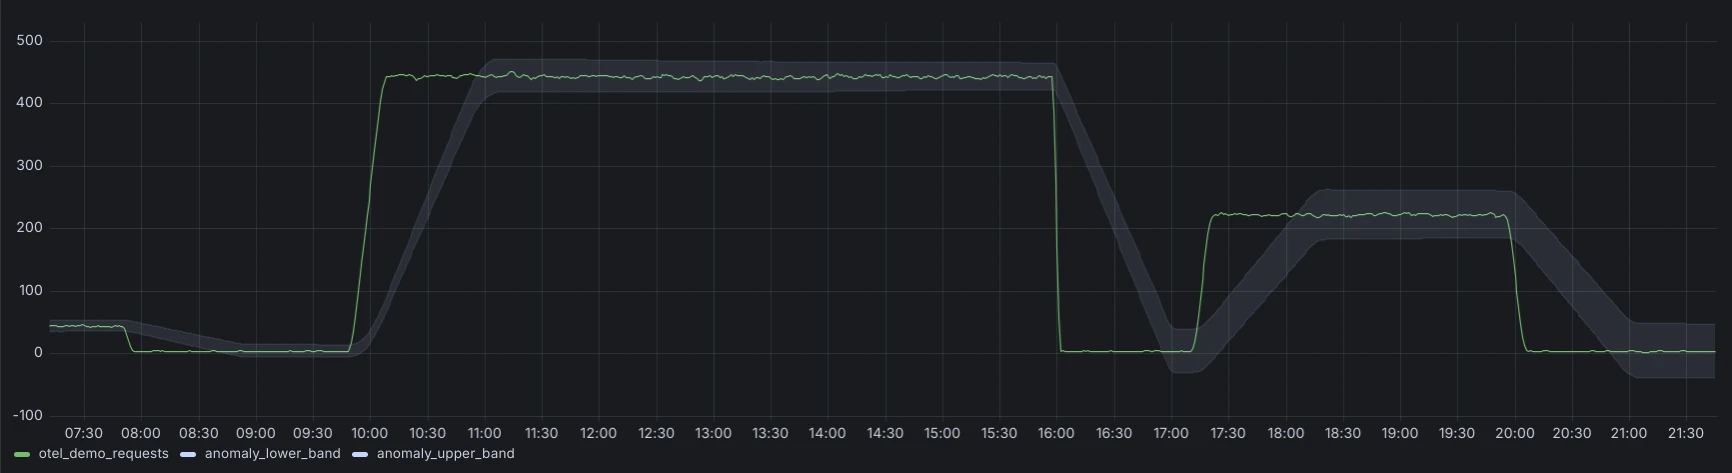
问题仍与标准差有关。在稳定期间,标准差接近零,边界扩张不够快。高变异和低变异时段混合后,数据被稀释,于是团队过滤掉低变异时段:
- record: stddev_1h:filtered
  expr: |
   stddev_over_time(metric[1h])
   > ?????
但最后一行的阈值不好确定。框架希望适用于任何指标,而不同指标的数量级不同。例如每秒10个请求时增加5个,变化很大;每秒1000个请求时增加相同数量,可能微不足道。
为使阈值自适应,团队采用统计概念变异系数:
- record: threshold_by_covar
  expr: 0.5

- record: stddev_1h:filtered
  expr: |
   stddev_over_time(metric[1h])
   > avg_1h * on() group_left threshold_by_covar
结果在敏感度和平滑程度之间取得了较好的折中:

不连续
过滤低变异时段产生了另一个问题:长期稳定表现可能导致所有数据都被过滤。

为此,团队增加一个边界,与刚才定义的边界互补。它基于平均值,用于定义可接受的最小宽度:
- record: margin_multiplier
  expr: 2

- record: margin_upper_band
  expr: avg_1h + avg_1h * on() group_left margin_multiplier
这提供了更明确的边界,设定最小上、下余量。接着将两个边界组合:
- record: upper_band
  expr: |
   max(
     margin_upper_band or
     upper_band_st
   )
组合结果如下:

长期重复模式
最后还要处理季节性,例如 cron 作业,或者每周同一时间出现的尖峰。解决方式比较简单:沿用之前的公式,但使用更小的时间窗口:
- record: upper_band_lt
  expr: |
    avg_1h offset 23h30m
    + stddev_1h offset 23h30m * on() group_left stddev_multiplier

这条规则回看过去的行为,预测未来,并在尖峰到来之前扩张边界。它很简单,但原文团队发现实际效果良好。
整体而言,现在定义了三种边界:
- record: upper_band
  expr: |
   max(
     margin_upper_band or
     upper_band_st
     upper_band_lt
   )
最终图表如下:
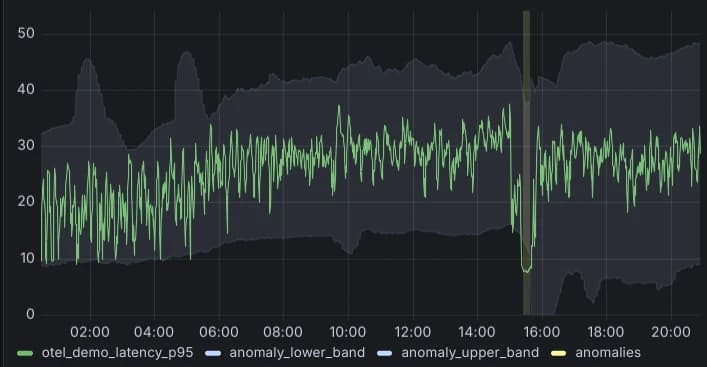
如何在自己的系统中使用
以上规则构成一个适用于任何指标的可复用框架。只需将记录规则和告警规则添加到 Prometheus 实例,并给指标加上标签:
- record: anomaly:request:rate5m
  expr: sum(rate(duration_milliseconds_count[5m])) by (job)
  labels:
    anomaly_name: "otel_demo_requests”
    anomaly_type: ”requests”
将 anomaly_name 替换为指标的唯一标识。也可以从四个默认类型中选择:request、latency、errors 和 resource。
可访问 GitHub 仓库获取记录规则、告警规则、仪表盘和更多示例。也可以在已经配置完成的演示环境中尝试。

团队期待看到大家如何使用,也希望收到改进方式及所需功能的反馈。可以在 Grafana 社区 Slack 的 #promql-anomaly-detection 频道联系团队,或在仓库提交 issue 与 PR。
若想深入了解,可观看 YouTube 上的完整 PromCon 演讲。原文还提到2.8 MB 的幻灯片下载,但当前页面可见正文未提供有效下载链接。
接下来做什么
异常检测能提供重要上下文,但异常本身还不足以证明系统出了问题。要让数据能够指导行动,下一步是把框架与已有的基于 SLO 的告警关联,纳入根因分析流程。例如,可将这些告警连接到 Grafana Cloud Asserts 等可视化工具,显示系统中的全部异常。
以下简要展示 Grafana Cloud 的做法:
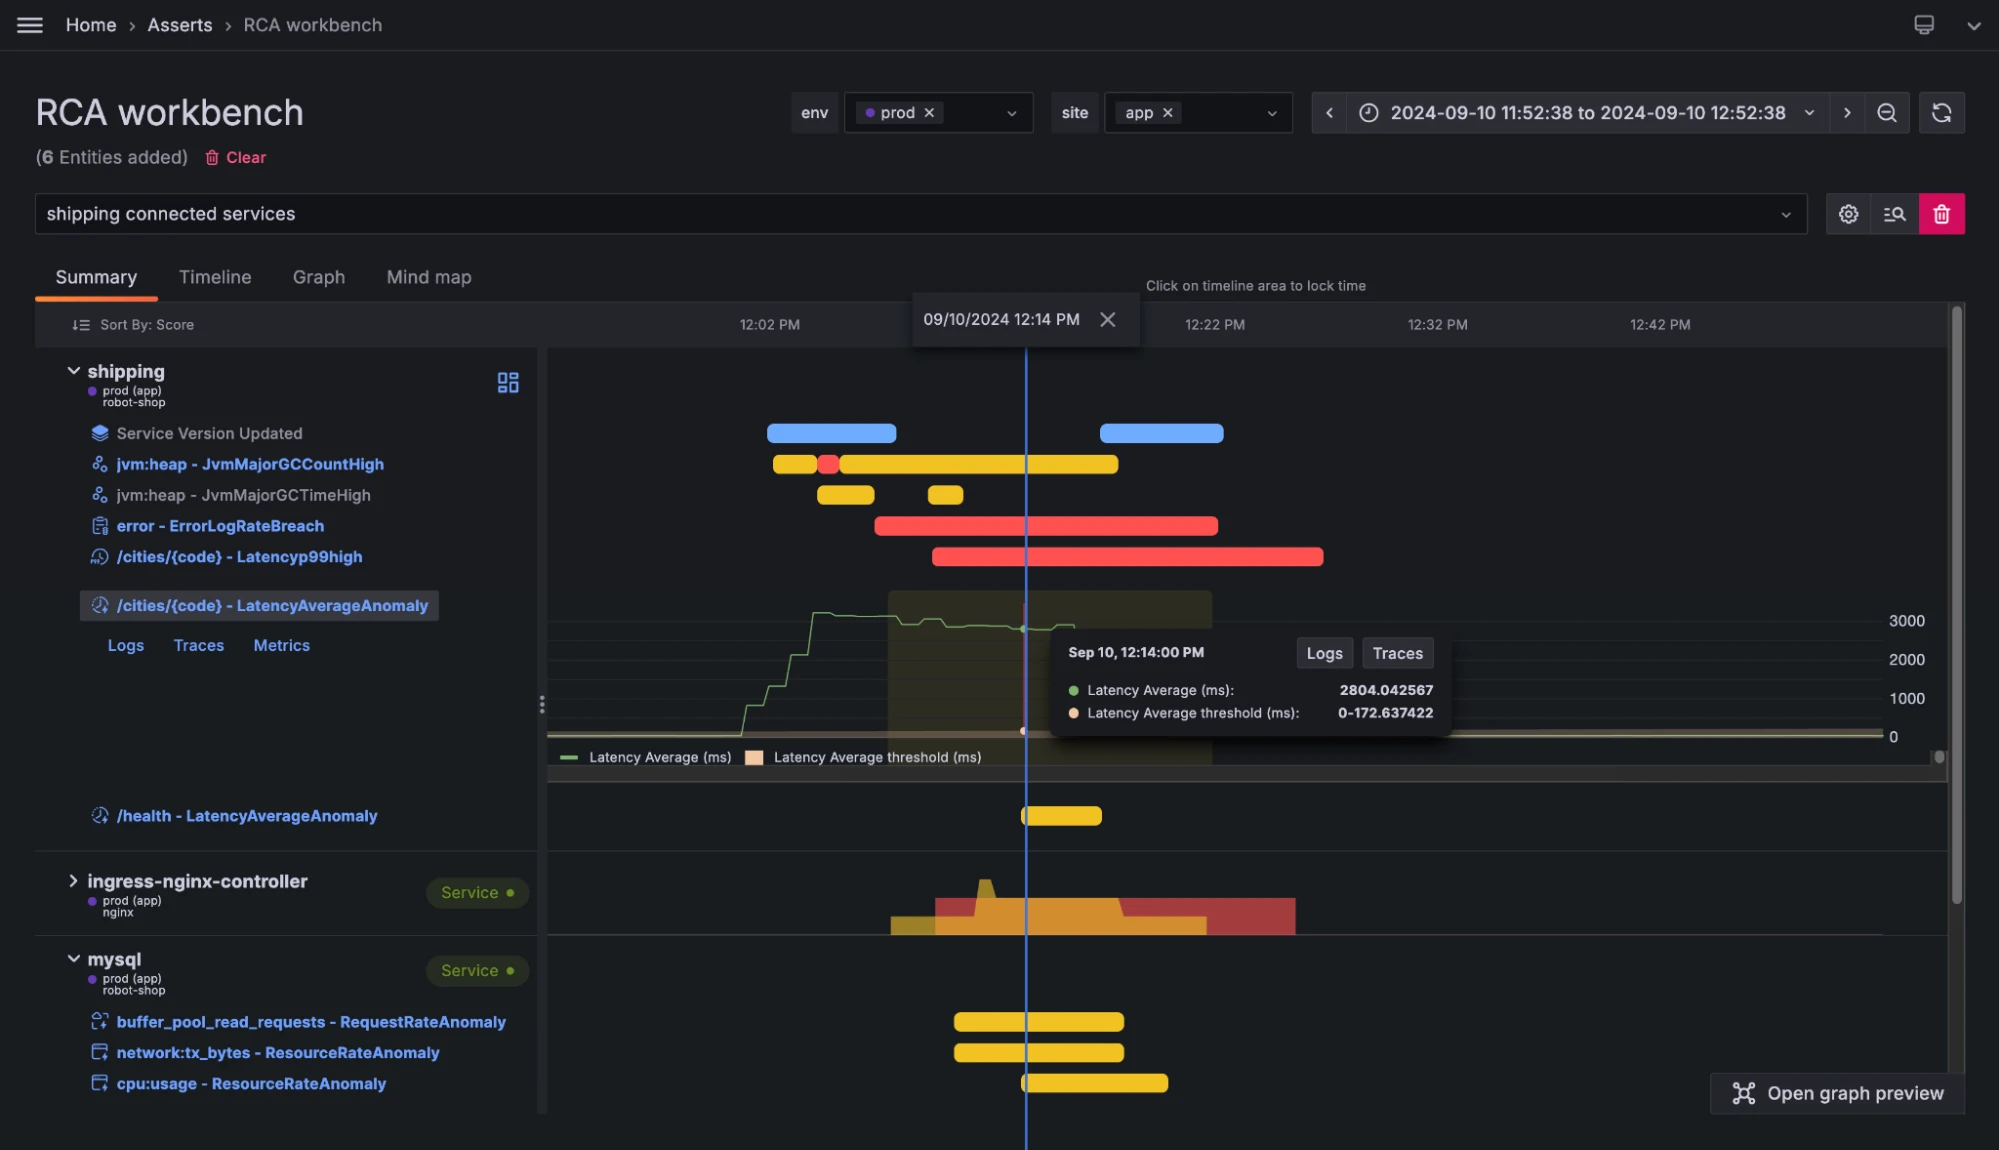
当告警触发时,可以追踪系统,理解相互依赖关系,以及告警上游、下游流转的内容,即时补充上下文,加快故障排查。
Grafana Cloud 可用于开始使用指标、日志、trace、仪表盘等功能。原文介绍其长期免费层及不同用例的计划,并提供免费注册入口。











暂无评论内容