


Dawid Dębowski是G2A.COM的软件工程师,也是Grafana Champion。他拥有计算机科学硕士学位,在可观测性领域主要关注PromQL和使用Grafana进行数据可视化。
你是否曾写出一条很棒的PromQL查询,期待得到需要的结果,运行后却只看到“No data”?如果遇到过,你可能掉进了PromQL向量匹配的陷阱。
本文概述PromQL中的向量,包括不同类型及其重要性,也会解释向量匹配,并使用Prometheus和Grafana逐步演示。
Prometheus向量概览
在Prometheus中,几乎每个查询都会返回一个向量,也就是一组时间序列数据点。它可以是即时向量(instant vector),也可以是区间向量(range vector)。
可以把即时向量理解为包含值与时间的一对(v1, t1);区间向量则类似数组[(v1, t1), (v2, t2), (v3, t3), …]。每个向量还可以有标签,不同标签意味着不同向量。
还有标量(scalar)类型,它是单个浮点值,没有时间含义,例如v1。这些定义之所以重要,是因为存在二元运算:标量除以标量很容易,向量除以标量也容易——向量中每个元素的值都除以该标量。但向量除以向量呢?
PromQL中的算术二元运算只针对即时向量定义;尝试用一个区间向量除以另一个区间向量会报错。根据Prometheus文档,对两个即时向量执行二元运算,会对左侧向量的每个条目及其在右侧向量中的匹配元素应用运算符。
听起来复杂?下面通过示例说明。
设置环境
假设部署了一个收集宝可梦的简单应用。它暴露pokemon_caught_total指标,一个简单计数器,并带有表示宝可梦属性的type标签。我们使用Prometheus抓取指标,用Grafana可视化。
先运行简单查询pokemon_caught_total{type="water"},显示应用从生命周期开始累计收集的水属性宝可梦数量。

可以看到,这是一个即时向量,处于某个时间点并有一个值。另一个快速查询显示,目前共捕获285只宝可梦。水属性约占总量的5.26%。
看看Prometheus会返回什么:

结果出乎意料。不过,我们忘记在除数外加sum了,补上应该可以!
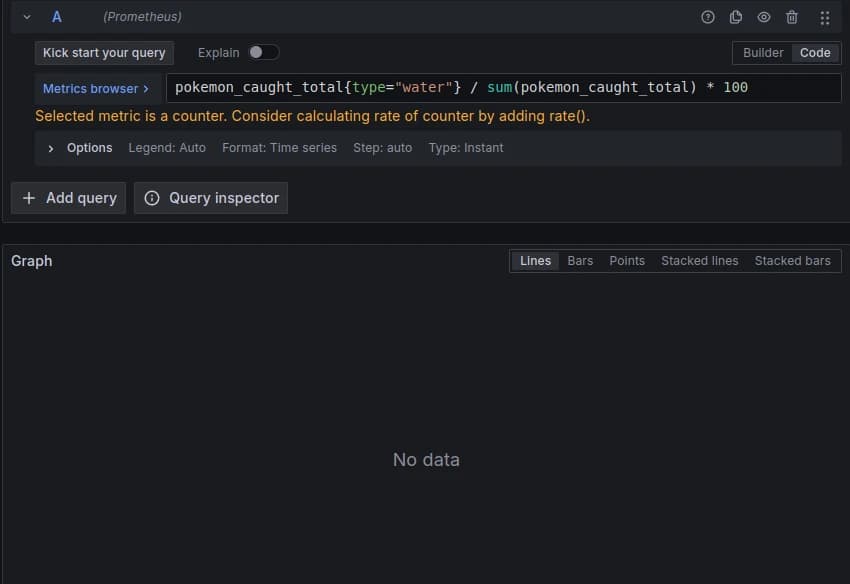
仍然没有结果。究竟发生了什么?
向量匹配
Prometheus文档介绍了元素匹配规则。两个即时向量之间发生算术运算时,Prometheus比较它们的所有标签,尝试找到匹配项。未匹配的向量会从结果中丢弃。因此,第一个示例显示100%:Prometheus在两侧找到一个匹配项,它就是带有type=water标签的向量。
其余结果不匹配,所以被丢弃。这也解释了为什么第二个例子两侧都有数据,却返回No data:sum生成没有标签的向量,Prometheus无法让带标签的内容与无标签的内容匹配。
因此,对两个向量执行二元运算时,要特别注意:有时结果看起来正确,实际却不对,因为Prometheus没有匹配所有本应参与的向量。
解决方法
最简单的方法是让左右两侧向量具有相同标签。在计算水属性宝可梦占比的示例中,只需移除运算左侧的标签:

左侧已经查询了全部关注的宝可梦,所以也可以用sum跨序列求和。现在两侧都没有标签,Prometheus就能匹配它们。但如果希望绘制各种属性宝可梦占比的图表呢?
在聚合中使用分组,会让我们回到最初的问题:

如果希望在同一张图中比较数据,创建多张图表或使用Grafana变量也不合适。好在PromQL提供了两个允许不同标签集合匹配的关键字:on和ignoring。它们告诉Prometheus应基于哪些标签匹配,或匹配时应忽略哪些标签。
对于一对一匹配,即一侧每个向量恰好匹配另一侧的一个向量,只需在二元运算符后加入其中一个关键字。
回到计算水属性宝可梦占比的示例:
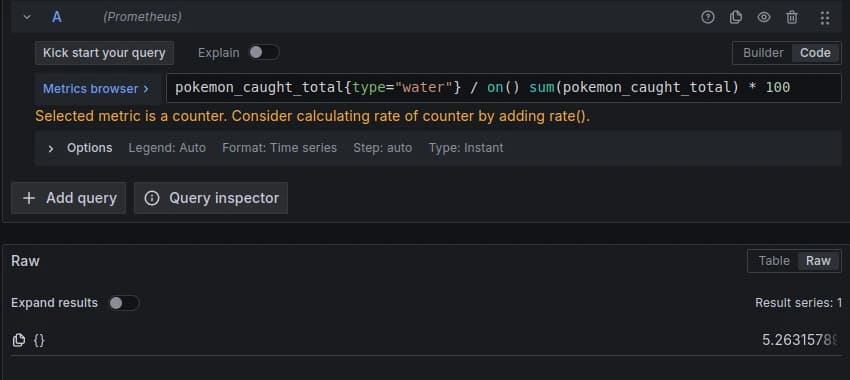
由于共同标签集合为空,我们告诉Prometheus按空标签集合进行on匹配。左侧恰好一个向量只匹配右侧一个向量,因此是一对一匹配,on关键字已经足够。
但如果要将左侧多个向量匹配到右侧一个向量呢?此时会出现错误:
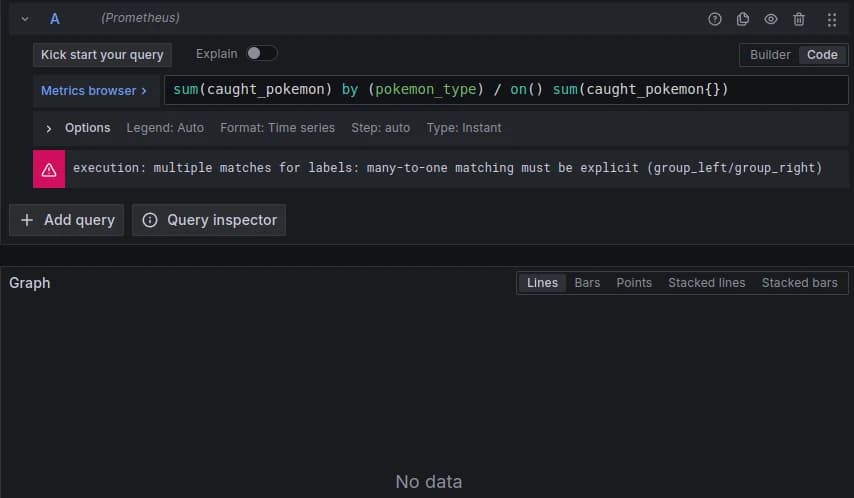
这是多对一匹配:左侧多个向量匹配右侧一个向量。此时还必须通过group_left或group_right告诉Prometheus,哪一侧代表“多”,以及应从哪一侧保留标签。保留左侧标签时使用group_left,保留右侧标签时使用group_right:
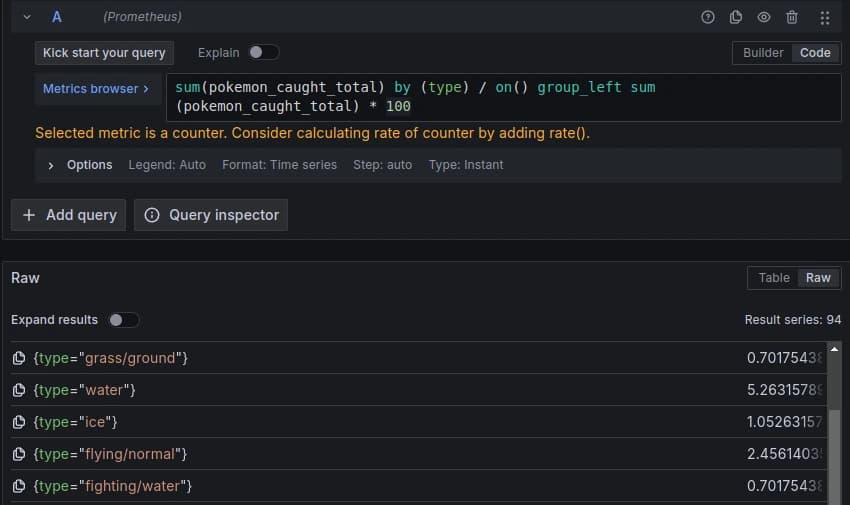
现在得到了所有属性的占比。检查一下,水属性占比为5.26%,与前面计算一致。
结束语
现在你知道,向量之间的二元运算可能并不像表面看起来那么直接。如果希望进一步试验指标与宝可梦示例应用,可以访问GitHub仓库。
关于向量的更多信息见PromQL文档,算术运算逻辑在运算符文档中有详细介绍。本文示例可以很容易迁移到HTTP响应时间、HTTP状态码等真实场景,例如计算全部流量中错误状态码所占的比例。
感谢阅读与跟随示例!
原文:PromQL vector matching: what it is and how it affects your Prometheus queries,Dawid Dębowski,2024年12月14日,Grafana Labs。按转载授权汉化。8张查询截图来自原文;截图中的完整查询尚需验图提取,未运行这些查询。











暂无评论内容