


- 本文介绍Meta容量效率计划:我们构建了AI智能体平台,帮助自动发现并修复整个基础设施中的性能问题。
- 智能体通过统一、标准化的工具接口使用编码后的领域知识,帮助节省电力,让工程师减少处理性能问题的时间,转而创新产品。
我们构建了统一AI智能体平台,将资深效率工程师的领域知识编码成可复用、可组合的技能。这些智能体现在能够自动发现和修复性能问题,帮助回收数百兆瓦(MW)的电力容量,并将数小时的手动性能回归调查压缩到数分钟,使计划能够为不断增加的产品领域交付更多容量收益,而无需按比例增加人员。
在防守侧,Meta内部性能回归检测工具FBDetect每周发现数千次回归;更快的自动化解决意味着更少的额外耗电在整个机群中不断累积。在进攻侧,AI辅助的优化机会处理每半年都扩展到更多产品领域,覆盖越来越多工程师无法逐一手动处理的优化收益。
这让Meta容量效率计划持续提升以兆瓦衡量的收益,而无需同比扩大团队。最终目标是建立自我维持的效率引擎,由AI处理长尾问题。
下面介绍其工作方式与未来方向:
- 超大规模效率优化同时需要进攻(主动发现优化)和防守(发现并缓解进入生产环境的性能回归),AI能加速两者。
- 我们构建的统一平台,将标准工具接口与编码后的领域知识结合起来,自动执行双方的调查工作。
- 这些AI系统已成为容量效率计划的基础设施。该计划回收了数百兆瓦电力容量,足以为数十万美国家庭供电一年。
- 自动诊断可将约10小时的手动调查压缩到约30分钟,AI智能体还能自动完成从效率机会到待审查pull request的整个过程。
介绍容量效率计划
当交付的代码服务于超过30亿人时,即便0.1%的性能回归,也可能转化为显著增加的电力消耗。
在Meta的容量效率组织中,我们将效率视为双向工作:
- 进攻:寻找使现有系统更高效的机会,即主动代码改动,并部署它们。
- 防守:监控生产环境资源使用情况,检测回归,将根因定位到某个pull request,并部署缓解措施。
这些系统运作良好,多年来一直在Meta效率工作中发挥重要作用。但真正解决它们发现的问题,又带来了新的瓶颈:工程师的时间。
工程师可能需要完成以下工作:
- 查询性能分析数据,寻找优化热点函数的机会。
- 查看效率机会的描述、文档与历史示例,理解实现优化的最佳方式。
- 检查近期代码与配置部署,查找可能导致资源使用出现阶跃变化的改动。
- 阅读近期有关上线的内部讨论,了解是否与某次回归相关。
Meta的许多工程师每天使用效率工具处理这些问题。但无论工具质量多高,在创新产品是最高优先级的情况下,工程师处理性能问题的时间终究有限。
我们开始思考:AI能否接手调查与解决过程?
进攻与防守具有相同结构
突破点在于,我们意识到两类问题共享相同的结构:
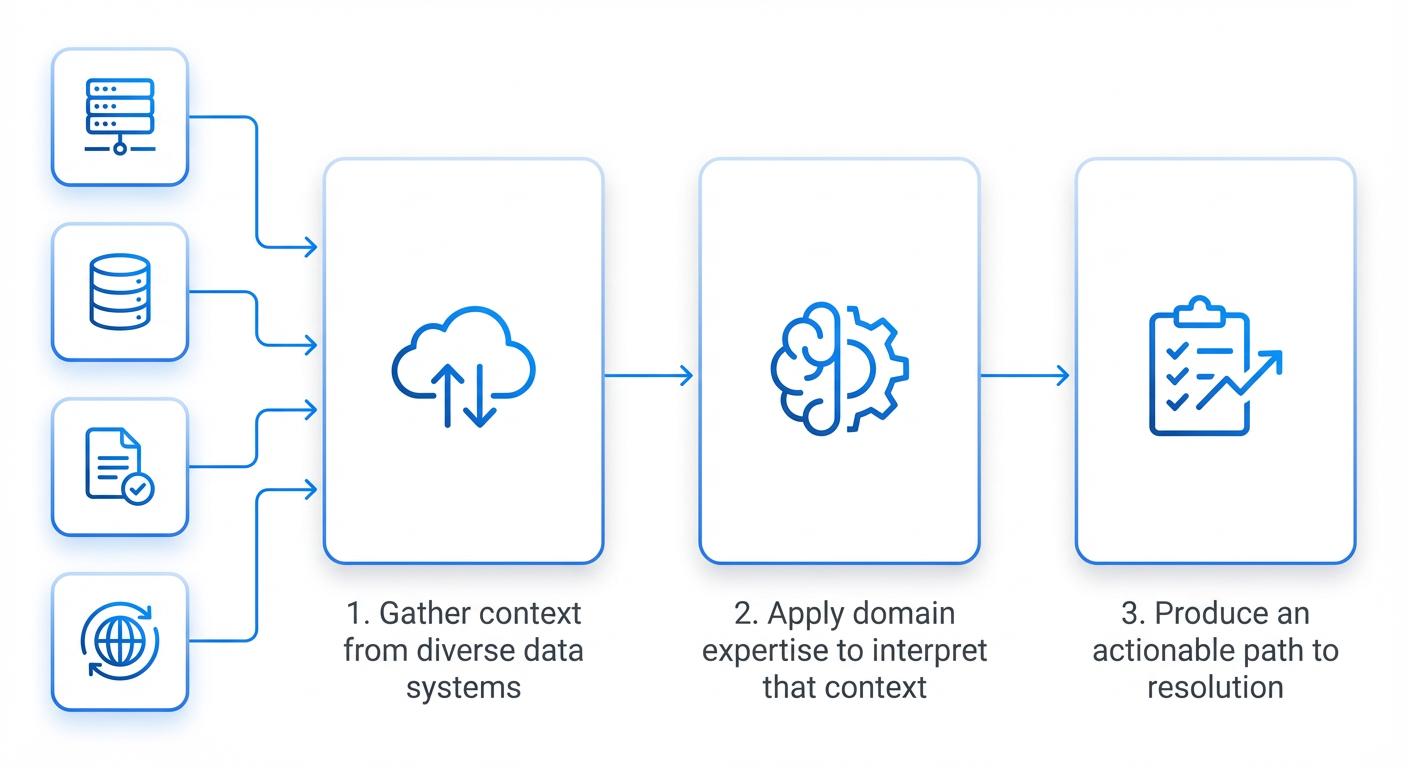
这意味着不需要两套独立AI系统,而需要一个能同时服务两者的平台。
我们将其构建为两层:
- MCP工具:这是供LLM调用代码的标准接口。每个工具只完成一项工作:查询性能分析数据、获取实验结果、检索配置历史、搜索代码,或提取文档。
- 技能:编码性能效率领域的专业知识。技能告诉LLM应使用哪些工具,以及如何解释结果,保存资深工程师多年积累的推理模式,例如“发生端点延迟回归时,查看主要GraphQL端点”,或“受影响函数处理序列化时,检查最近的schema变更”。
工具与技能结合,让通用语言模型能够应用通常由资深工程师掌握的领域知识。同一组工具可服务进攻与防守,区别只在技能。
防守:在回归影响累积前发现它
FBDetect是Meta内部性能回归检测工具,可以在嘈杂的生产环境中捕捉小至0.005%的回归。它会分析如下时间序列数据:
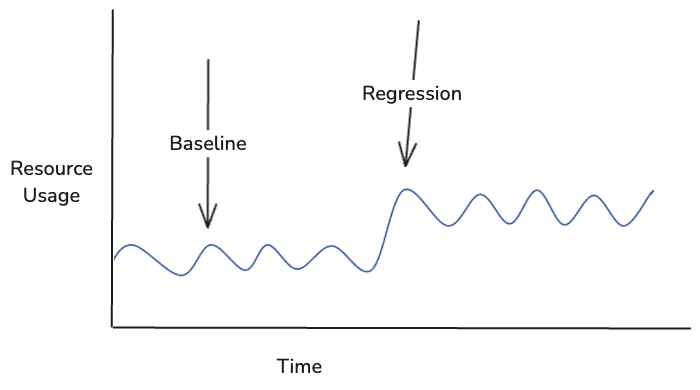
FBDetect发现回归时,我们立即尝试将根因定位到代码或配置改动,这是理解发生了什么的重要第一步。主要通过传统技术完成,例如将出现回归的函数与近期pull request关联。确定根因后,通常通知工程师采取行动,例如优化近期代码改动。我们加入了一个新功能来加快这一过程。
AI Regression Solver
AI Regression Solver是FBDetect最新且最有潜力的组件,能自动生成pull request,以向前修复的方式解决回归。过去,造成性能回归的根因pull request要么被回滚,拖慢工程迭代速度;要么被忽略,造成不必要的基础设施资源消耗。
现在,我们的内部编码智能体会执行:
- 通过工具收集上下文:查找回归症状,例如受影响函数;定位根因pull request,包括具体修改的文件与行。
- 通过技能应用领域知识:使用针对特定代码库、语言或回归类型的缓解知识。例如,日志引起的回归可通过提高采样程度、减少记录量来缓解。
- 创建解决方案:生成新的pull request,提交给根因改动的原作者审查。
进攻:把优化机会变为上线代码
在进攻侧,“效率机会”是被认为能提升现有代码性能的概念性改动建议。我们构建的系统让工程师可以查看某个机会,并请求AI生成实现它的pull request。过去需要数小时调查的工作,现在只需数分钟进行审查与部署。
流水线与防守侧的AI Regression Solver相似:
- 通过工具收集上下文:AI智能体查找机会元数据、解释优化模式的文档、类似机会的历史解决示例、涉及的具体文件与函数,以及确认修复有效的验证标准。
- 通过技能应用领域知识:使用编码成技能的专业工程师知识,处理特定类型的效率机会,例如缓存某个函数结果以减少CPU使用。
- 创建解决方案:在保护措施约束下生成候选修复,验证语法与风格,确认修复针对正确的问题,然后将生成的代码展示在工程师编辑器中,供其一键应用。
我们使用与防守侧相同的工具:性能分析数据、文档与代码搜索。不同之处是技能。
一个平台,持续累积的收益
统一架构共享工具与数据来源,是一种清晰的抽象。每个现有或新增智能体都能通过我们提供的接口,方便地获取性能相关上下文,不必重复构建基础能力。
本文重点介绍最初两个应用:性能回归与优化机会。在一年内,同一基础还支持了其他应用,包括效率问题对话助手、容量规划智能体、个性化机会推荐、引导式调查流程以及AI辅助验证。每项新能力都只需很少甚至无需新的数据集成,因为可以把现有工具与新技能组合起来。
影响
容量效率计划取得显著成果:我们回收了数百兆瓦的电力容量。进攻与防守两侧的AI系统都在支持这项工作。
更深层的变化在于进攻与防守如何彼此加强:过去整个上午进行防守分诊的工程师,现在几分钟就能审阅AI生成的分析。使用效率工具的工程师也能获得AI辅助生成的代码,无需从零开始。令人畏惧的“我究竟从哪里开始”问题,已被审查与部署高影响力修复所替代。
原文:Capacity Efficiency at Meta: How Unified AI Agents Optimize Performance at Hyperscale,Engineering at Meta,2026年4月16日。© 2026 Meta。按转载授权汉化。容量、性能与耗时数据均为原文披露,未独立复测;配图来自原文。











暂无评论内容