


Valkey 的 maxmemory 与键驱逐:理解 LRU、LFU 和内存余量
原作者:Valkey documentation contributors|中文翻译与技术校注:未完纪|核对日期:2026 年 10 月 5 日。
本文根据 Valkey 官方文档 Key eviction 完整翻译整理,涵盖原文全部配置、策略、监控口径、近似 LRU 实验及 LFU 参数。原文没有固定发布版本;本文保留原文语境,并把静态审查与补充说明单独标出。
把 Valkey 用作缓存时,常常希望新数据写入后自动淘汰旧数据。这个行为与 memcached 的常见使用方式类似。决定内存压力下如何处理数据的核心,是 maxmemory 阈值以及 maxmemory-policy 驱逐策略。Valkey 的 LRU 并不是严格维护全局顺序的精确 LRU,而是一个可调整精度的近似实现。
设置 maxmemory
maxmemory 设置 Valkey 数据内存管理的上限,可以写入 valkey.conf,也可以运行时通过 CONFIG SET 修改。原文用以下配置示例表示 100MB 的限制:
maxmemory 100mb单位校注:Valkey 配置中的 mb 按 1024 × 1024 字节计算,因此这个具体值是 100 MiB,即 104,857,600 字节;原文使用了通俗的“100 megabytes”表达。
maxmemory 0 表示不设置这一限制,原文说明这是 64 位系统的默认行为;32 位系统有隐含的 3GB 限制。这里的默认值描述不能替代对具体发行包、托管服务和实际生效配置的检查。达到阈值之后,可以拒绝可能继续增加内存的命令,也可以依据策略移除旧键,为新增数据腾出空间。
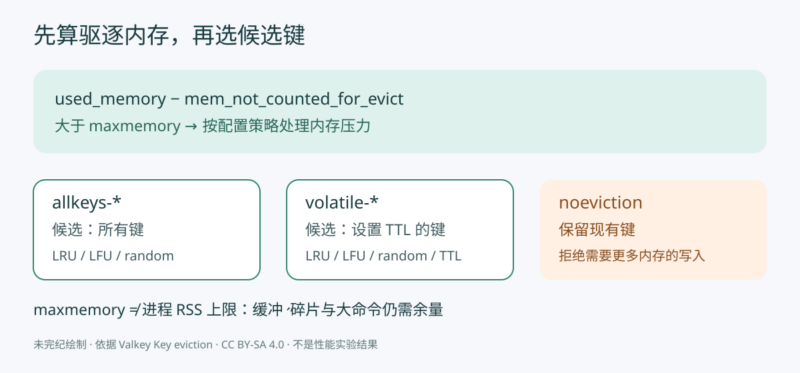
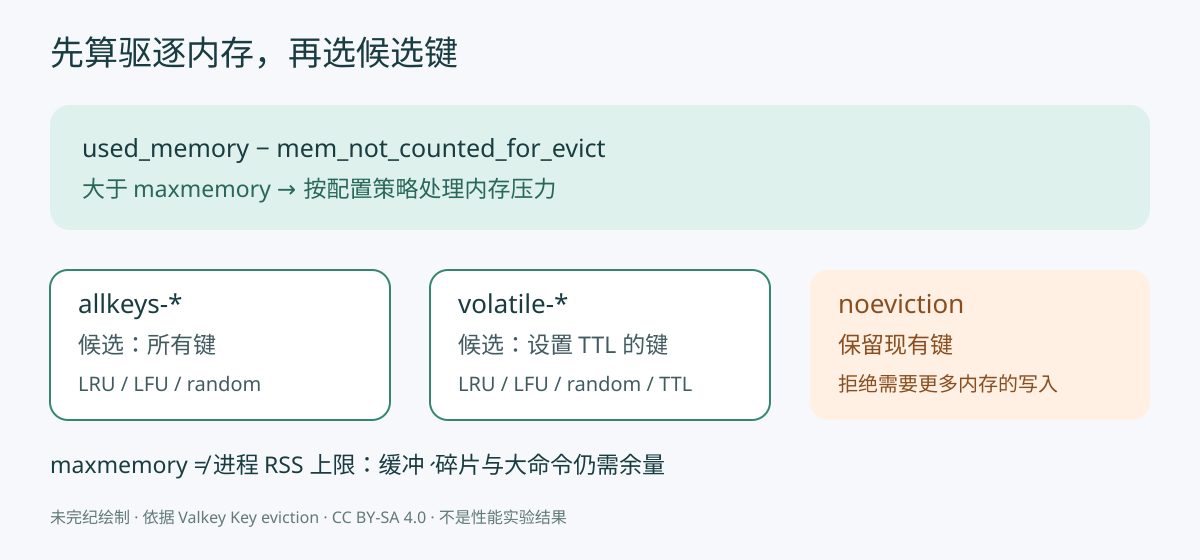
静态审查:maxmemory 不是整个进程 RSS 的硬上限,更不是容器或主机物理内存保护机制。分配器碎片、复制和 AOF 缓冲,以及大命令产生的瞬时内存都需要余量。把阈值直接设为机器全部可用内存,会让缓存尚未正常回收就遭遇系统内存不足。
复制与 AOF 为什么需要额外预留内存
启用复制后,Valkey 需要缓冲区把数据发送到副本;AOF 写入也有缓冲区。用于驱逐比较的内存计数不会包含其中需要排除的缓冲内存。
原因是驱逐本身会产生新的变更,这些变更也要进入复制或 AOF 缓冲。如果把这些缓冲也当成继续驱逐的理由,就可能出现循环:删除键释放的空间立刻被传播删除操作的缓冲占用,于是继续删除,极端情况下直到数据库被清空。
因此,带复制的实例通常应比不带复制的单实例设置更低的 maxmemory,为复制缓冲、AOF 缓冲和其他进程留下空间。INFO MEMORY 中的 mem_not_counted_for_evict 可帮助估算不计入驱逐判断的内存。具体预留值取决于实际写入与复制行为,不应从文中的示例数字直接推导。
八种策略,先看候选键的范围
maxmemory-policy 决定触及阈值后如何选择键。allkeys 表示可从所有键中选,volatile 表示只从设置了 TTL 的键中选。
| 策略 | 行为与适用范围 |
|---|---|
noeviction |
不通过驱逐释放空间;达到限制时,拒绝需要更多内存的写入。复制架构中原文的说明主要针对主库;只读命令仍可工作。 |
allkeys-lru |
从所有键中近似选择最久未使用的键,倾向保留最近访问过的数据。 |
allkeys-lfu |
从所有键中近似选择使用频率最低的键。 |
volatile-lru |
仅在设置了 TTL 的键中按近似 LRU 选择。 |
volatile-lfu |
仅在设置了 TTL 的键中按近似 LFU 选择。 |
allkeys-random |
从所有键中随机移除。 |
volatile-random |
仅从设置了 TTL 的键中随机移除。 |
volatile-ttl |
仅在设置了 TTL 的键中,优先近似选择剩余存活时间最短的键。 |
如果没有符合条件的键,四种 volatile-* 策略的行为会类似 noeviction,不能因为选了“驱逐策略”就认定写入不会失败。LRU、LFU 和 volatile-ttl 都采用近似、随机化的算法,不能把策略名称理解成严格的全局排序保证。
根据访问模式选择策略
原文给出的是经验起点,而不是所有工作负载的最优解:
- 如果访问热度接近幂律分布,即少量键获得远高于其他键的访问量,可以从
allkeys-lru开始。尚不清楚访问模式时,它也是常见的起点。 - 如果应用循环扫描所有键,或各键访问概率大体均匀,可以评估
allkeys-random。 - 如果应用希望通过不同 TTL 向缓存提示“哪些对象更适合先被移除”,可以考虑
volatile-ttl。
volatile-lru 和 volatile-random 的一个用途,是在同一实例里混放缓存和不设置 TTL 的持久键。不过原文通常更建议使用两个 Valkey 实例来分开这两类数据。为键设置 TTL 本身也需要内存;使用 allkeys-lru 时,键不必为了成为驱逐候选而额外配置 TTL。
边界校注:“可被驱逐”应由数据是否可丢弃决定。allkeys-* 会把未设 TTL 的键也纳入候选,错误用于持久数据实例可能造成数据丢失;TTL 到期删除与内存压力驱逐是两种不同机制。改变策略不会自动判断哪部分数据在业务上重要。
策略可以在应用运行时更改。原文建议通过 INFO 中的缓存命中与未命中统计观察效果。评估时应使用可比时段的增量,并考虑流量变化,不能只看一组自启动以来累计的数字。
驱逐并不是从不越线
原文将过程解释为一个反复发生的循环:客户端执行命令,增加数据;Valkey 检查内存是否超过阈值;若超出,则按照策略驱逐键;随后处理下一条命令。
因此,内存可能越过限制,再经驱逐回落。某条命令如果临时使用大量内存,例如把很大的集合交集写入一个新键,短时间内超限可能非常明显。maxmemory 的作用不能理解为每次分配之前都绝不越过该值。
从 INFO 看什么时候会触发驱逐
INFO MEMORY 中至少要一起看以下两项:
used_memory:服务端分配的内存字节数,等于used_memory_overhead与used_memory_dataset之和,包含内存管理相关开销,并不等于 RSS。mem_not_counted_for_evict:不计入驱逐比较的内存,包括相应的复制与 AOF 缓冲。
原文给出的判断关系是:
used_memory - mem_not_counted_for_evict > maxmemory第一组官方示例:
# Memory
used_memory:12498952
...
maxmemory:10737418240
...
mem_not_counted_for_evict:12336
...
用于比较的值是 12,498,952 − 12,336 = 12,486,616 字节,远小于 10,737,418,240,因此尚未触发驱逐。把阈值调得更接近,就得到第二组示例:
# Memory
used_memory:12498952
...
maxmemory:12500000
...
mem_not_counted_for_evict:12336
扣除缓冲后的值仍是 12,486,616,与阈值只差 13,384 字节,已经接近触发点。以上数据来自官方文档,不是本次读取任何实际数据库得到的结果。
发生内存压力时,INFO STATS 还提供相关统计。原文介绍 total_eviction_exceeded_time 用于记录超出驱逐内存条件的累计时间,单位为毫秒。实际分析时,应把该指标与上面的驱逐内存口径一起理解,并结合命中、未命中和被驱逐键数量观察;不要只拿进程 RSS 与阈值比较就推断策略异常。
近似 LRU:用少量采样换取更低内存开销
精确 LRU 要维护足以找出“全体键中最久未被访问者”的信息,这会消耗更多内存。Valkey 选择另一条路线:每次从少量键中抽样,挑出样本里访问时间最旧的候选,同时维护一个适合驱逐的候选池。结果通常偏向较老的数据,但不能保证每次选中全局最老的键。
每次检查多少个样本由以下指令控制:
maxmemory-samples 5样本数可以在 CPU 开销与选择精度之间调整。原文的比较实验先装入一批键,再从第一个到最后一个依次访问,令最先访问的键成为 LRU 最合适的淘汰对象;随后再加入相当于原数量 50% 的键,迫使约一半旧键被淘汰。
原图分为三种点带:浅灰表示被淘汰的对象,灰色表示保留下来的旧对象,绿色表示后来添加的对象。精确 LRU 应淘汰旧键中最早访问的那一半;近似 LRU 则以概率方式更倾向淘汰较老的键。可查看 官方历史实验原图;本文的内存示意图没有冒充该实验图。
历史结果:原文引用 Redis OSS 3.0 时期的实验,称每次采样 5 个键已有不错表现,10 个样本更接近精确 LRU,并指出该部分算法后来没有显著变化。它还报告,在幂律访问的模拟中,精确 LRU 与近似实现的差异很小或不存在。这些结论属于特定实验,不是当前 Valkey 在任意硬件、数据规模与流量下的性能保证,本稿没有复现实验。
LRU 本来就是对未来访问概率的预测模型。即使某个实现更精确,也不一定对实际请求更有利。可以提高到 10 个样本,观察缓存未命中是否下降,并同时记录 CPU 成本。原文提供运行时命令模板:
CONFIG SET maxmemory-samples <count>命令审查:这是在 Valkey 客户端中输入的命令,<count> 是需要替换的占位符,不能原样复制到 shell。CONFIG SET 会即时改变运行中的服务行为,执行前应记录现值、确认访问权限与测试窗口;不要因为语法短就省略风险评估。本次没有连接数据库,没有改配置,也没有触发驱逐。
LFU:用频率判断哪些键值得保留
LFU 模式是 LRU 的另一种选择,在一些工作负载中可能获得更好的命中比例。LRU 关注“上次什么时候用过”,LFU 则估计“用得有多频繁”,让经常访问的键更有机会留在内存。对应的策略是 volatile-lfu 和 allkeys-lfu。
LFU 同样是近似算法。它用称为 Morris counter 的概率计数思想,以少量位估计对象的访问频率,再结合衰减周期让计数随时间降低。某个键过去很热,不代表以后永远很热;衰减使算法有机会适应访问模式变化。选择驱逐候选时,也会像 LRU 一样对这些信息进行采样。
LFU 有两个值得理解的参数:频率计数多久衰减一次,以及计数器需要多少次访问才接近饱和。原文给出的默认配置是:
lfu-log-factor 10
lfu-decay-time 1
在这个配置下,原文将计数器饱和对应的访问量描述为大约一百万次,衰减间隔为一分钟。它们是经过实验选定的起点,仍需根据业务访问分布评估。
lfu-decay-time 的单位是分钟:键被采样时,如果距离上次衰减的时间已经达到间隔,就按规则降低计数。它不是一个为所有键逐个准时触发的独立一分钟计时器。特殊值 0 表示永不衰减,这会让过去的热点更难被遗忘。
lfu-log-factor 影响计数增长的速度。计数器范围只有 0 到 255;factor 越大,达到最大值需要的访问越多,更有利于区分访问非常频繁的键。factor 越小,对低访问量的分辨率更高,却更容易在高访问量下饱和。
| factor | 100 次访问 | 1,000 次 | 100,000 次 | 1,000,000 次 | 10,000,000 次 |
|---|---|---|---|---|---|
| 0 | 104 | 255 | 255 | 255 | 255 |
| 1 | 18 | 49 | 255 | 255 | 255 |
| 10 | 10 | 18 | 142 | 255 | 255 |
| 100 | 8 | 11 | 49 | 143 | 255 |
表格保留原文数值,展示的是概率计数器在不同 factor 下的量级关系,不是任何一次运行都必须得到的精确计数。相关细节可继续核对对应发行版本的 valkey.conf 示例文件。
把参数放回业务目标里
配置时先确定哪些键允许丢弃,再确定内存预算及复制缓冲余量,然后根据访问分布选策略。只有在这些前提清楚之后,调整采样数、对数因子和衰减周期才有意义。通过 INFO 观察实际缓存效果,能帮助判断提高 LRU 精度或转向 LFU 是否值得承担额外成本。
本文仅对官方说明、命令语法和数据丢失边界进行了静态审查;没有执行任何读写命令、调整生产阈值或测量命中率。文中演示配置不能代替针对真实数据可丢弃性和运行版本的确认。










暂无评论内容