


在连接 R 数据表前验证键并控制多重匹配
原文:Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund,《R for Data Science》第二版第 19 章 Joins。本文依据 2026 年 10 月 5 日的在线章节翻译整理。全书首页标注 CC BY-NC-ND 3.0;本译文及配图依据另行取得的授权使用。
数据分析很少只使用一张表。航空公司名称、飞机属性、机场坐标和每小时天气,往往分散在不同数据框中。连接(join)把这些相关信息组合起来。dplyr 提供两类重要连接:增列型连接从另一张表的匹配记录中加入变量;筛选型连接根据是否存在匹配,保留或删除当前表的记录。
本文先确定连接依赖的键,再使用真实航班数据练习连接,随后通过小表解释结果行数,最后扩展到交叉、不等式、滚动和区间重叠连接。学习时需要 dplyr 的 join_by() 语法;主要数据来自 nycflights13 包,生日示例还使用 lubridate 和 babynames。
library(tidyverse)
library(nycflights13)
先弄清主键与外键
主键是能唯一标识一条观测的一个变量,或一组变量;需要多列时称为组合键。外键则是当前表中与另一张表主键相对应的字段。nycflights13 中的相关表如下:
| 表 | 记录内容 | 主键 | 原文大小 |
|---|---|---|---|
airlines |
航空公司代码和全称 | carrier |
16 行、2 列 |
airports |
机场名称、经纬度、海拔和时区 | faa |
1458 行、8 列 |
planes |
飞机制造年份、类型、制造商、型号、发动机和座位等 | tailnum |
3322 行、9 列 |
weather |
出发机场各小时的天气 | origin 与 time_hour |
26115 行、15 列 |
例如,航空公司代码 AA 对应 American Airlines Inc.,机场代码标识具体机场,飞机尾号标识具体飞机。weather 单用时刻不能标识记录,因为多个机场会在同一时刻记录天气。
航班表 flights 中,tailnum 对应 planes$tailnum,carrier 对应 airlines$carrier;出发地 origin 和目的地 dest 都对应 airports$faa。origin 与 time_hour 共同对应天气表的同名组合主键。
这些表设计得比较一致:大部分同名列具有相同含义,主键与外键也往往同名。但有一个重要例外:flights$year 是航班出发年份,planes$year 是飞机制造年份。稍后会看到,同名不代表应该匹配。
检查“应该唯一”是否真的唯一
先按主键计数,找出出现多次的值;再检查主键是否缺失。一个缺失值不能可靠标识观测。
planes |>
  count(tailnum) |>
  filter(n > 1)

weather |>
  count(time_hour, origin) |>
  filter(n > 1)

planes |>
  filter(is.na(tailnum))

weather |>
  filter(is.na(time_hour) | is.na(origin))
原文四个检查都返回 0 行,分别支持飞机尾号和“时刻+机场”的唯一性及完整性。这里使用的是含完整日期时刻的 time_hour,不是只含 0–23 的小时数字。
唯一值还不够:键要有业务意义
航班表本身还没有讨论主键,因为本章没有其他表通过它的主键引用航班。但要向他人描述某条记录,仍需要标识。作者尝试后发现以下组合没有重复:
flights |>
  count(time_hour, carrier, flight) |>
  filter(n > 1)
# 原文:0 行
没有重复是良好起点,却不能自动证明键设计合理。例如用机场海拔和纬度识别机场显然不可靠:
airports |>
  count(alt, lat) |>
  filter(n > 1)
# 原文:1行,alt=13、lat显示为40.6、n=2
仅凭当前数据,无法判断一组字段是否适合作为长期主键。航班时刻、航空公司和航班号的组合更有业务依据,因为同一家航空公司在同一时段出现多个同号航班会造成混乱。
也可以引入简单的数字替代键(surrogate key):
flights2 <- flights |>
  mutate(id = row_number(), .before = 1)
原文结果为 336776 行、20 列,新增的 id 从 1 起按行编号。告诉同事“查看第 2001 号航班记录”,比描述“2013 年 1 月 3 日上午 9 点出发的 UA430”更方便。编辑提示:这里的行号只在当前数据和排序下标识记录;重新排序后重新生成行号,不能把它当作跨系统永久身份。
练习:键与关系
- 原书关系图没有画出
weather与airports的联系。这个关系是什么,箭头应该如何连接? - 目前天气表只包含纽约的三个出发机场。如果它包括美国全部机场,还能与
flights建立什么新联系? year、month、day、hour、origin几乎构成天气表的组合键,但有一个小时出现重复。那个小时有什么特别之处?- 平安夜、圣诞节等特殊日期可能乘客较少。如何用一张表表达这些日期?主键是什么,怎样与现有表连接?
- 画出 Lahman 包中
Batting、People、Salaries的关系,再画出People、Managers、AwardsManagers的关系。如何描述Batting、Pitching、Fielding之间的关系?
用 left_join 加入更多信息
dplyr 的六个基本连接函数是 left_join、inner_join、right_join、full_join、semi_join 和 anti_join。它们都接收两个数据框 x 和 y,返回一个数据框;输出行列的顺序主要由 x 决定。
增列型连接先按键匹配记录,再把另一表的变量复制过来。新列通常出现在右侧,为便于查看,原文重新创建一个只含六列的 flights2。它覆盖前面的替代键例子,是新的教学步骤:
flights2 <- flights |>
  select(year, time_hour, origin, dest, tailnum, carrier)

flights2 |>
  left_join(airlines)
第二段默认按 carrier 连接,结果为 336776 行、7 列,新增航空公司全称。UA 对应 United Air Lines Inc.,AA 对应 American Airlines Inc.,B6 对应 JetBlue Airways。left_join 适合补充元数据,因为它保留 x 的全部记录;但若 y 中有多条匹配,x 的记录可能复制,行数未必保持不变。
同样可以添加出发时的气温和风速,或飞机类型、发动机数和座位数:
flights2 |>
  left_join(weather |> select(origin, time_hour, temp, wind_speed))

flights2 |>
  left_join(planes |> select(tailnum, type, engines, seats))
天气连接自动使用 time_hour 与 origin,原文结果为 8 列;飞机连接自动使用 tailnum,原文结果为 9 列。若某航班在飞机表中找不到匹配,新加入的字段就填 NA:
flights2 |>
  filter(tailnum == "N3ALAA") |>
  left_join(planes |> select(tailnum, type, engines, seats))
原文找到 63 条这样的航班,type、engines、seats 都缺失。匹配失败不意味着原表中这三个属性已经明确存了 NA,也可能是参考表根本没有该飞机的记录。
显式指定连接键
默认连接使用两表全部同名列,称为自然连接。这种启发式规则很方便,但并不总正确。直接连接完整飞机表就会出问题:
flights2 |>
  left_join(planes)
# 默认:join_by(year, tailnum)
航班年份与飞机制造年份含义不同,强制它们相等会制造大量未匹配记录。应该只按尾号连接:
flights2 |>
  left_join(planes, join_by(tailnum))
结果中的 year.x 来自航班表,year.y 来自飞机表;原文前六条飞机制造年份分别是 1999、1998、1990、2012、1991、2012。可以通过 suffix 修改默认后缀。
join_by(tailnum) 是 join_by(tailnum == tailnum) 的简写,表达的是等值关系。完整形式还可连接两表中不同名称的键:
flights2 |>
  left_join(airports, join_by(dest == faa))

flights2 |>
  left_join(airports, join_by(origin == faa))
前者添加目的机场信息,后者添加出发机场信息。原文的目的地 BQN 没有机场表匹配,而出发地 EWR、LGA、JFK 分别得到 Newark Liberty Intl、La Guardia、John F Kennedy Intl。
旧代码中的 by = "x" 对应 join_by(x);by = c("a" = "x") 对应 join_by(a == x)。作者推荐更清楚、也更灵活的 join_by()。
只筛选,不增加列
semi_join(x, y) 保留在 y 中至少存在一条匹配的 x 记录。它不会把 y 的列加入结果。下面分别筛出航班数据中出现过的出发机场和目的机场:
airports |>
  semi_join(flights2, join_by(faa == origin))

airports |>
  semi_join(flights2, join_by(faa == dest))
原文前者得到 EWR、JFK、LGA 三个机场,后者得到 101 个机场。anti_join 则保留找不到匹配的记录,很适合寻找“隐式缺失”:不是某个单元格显式为 NA,而是整条参考记录不存在。
flights2 |>
  anti_join(airports, join_by(dest == faa)) |>
  distinct(dest)
# 原文:BQN、SJU、STT、PSE

flights2 |>
  anti_join(planes, join_by(tailnum)) |>
  distinct(tailnum)
# 原文:722行,前几项包括N3ALAA、N3DUAA、N542MQ、
# N730MQ、N9EAMQ、N532UA
练习:真实航班数据
- 找出全年延误最严重的 48 个小时,与天气表交叉核对,观察是否有规律。
- 先运行下面的代码得到前十个热门目的地,再找出所有飞往这些机场的航班。
top_dest <- flights2 |>
  count(dest, sort = TRUE) |>
head(10)- 每个出发航班都能匹配到对应小时的天气吗?
- 找不到飞机记录的尾号有什么共同点?原文提示,一个变量能解释约 90% 的问题。
- 给
planes添加一列,列出驾驶过每架飞机的全部carrier。每架飞机是否只由一家航空公司使用?用已学工具验证这个假设。 - 把出发机场和目的机场的经纬度加入
flights。在连接前还是连接后重命名字段更方便? - 按目的地计算平均延误,连接机场坐标后画出空间分布。可以先用下方代码绘制美国地图,再用点大小或颜色表示延误。
airports |>
  semi_join(flights, join_by(faa == dest)) |>
  ggplot(aes(x = lon, y = lat)) +
  borders("state") +
  geom_point() +
coord_quickmap()- 2013 年 6 月 13 日发生了什么?绘制当天延误地图,再通过网络检索与天气记录交叉核对。
这些是原章练习,本文保留问题与代码,不伪造未经运行的答案。
连接到底生成了哪些行
下面用两个最小数据框观察匹配。每表只有一个键和一个值列,原理同样适用于多列键和更多值列:
x <- tribble(
  ~key, ~val_x,
     1, "x1",
     2, "x2",
     3, "x3"
)
y <- tribble(
  ~key, ~val_y,
     1, "y1",
     2, "y2",
     4, "y3"
)
可以想象把 x 的各行和 y 的各行排成一个网格,每个交点是一种潜在配对。满足连接条件的交点就是匹配;增列型连接中的每个匹配成为一条输出记录。值列随着匹配一起带到输出。
| 连接 | 上例保留的键 | 未匹配值的处理 |
|---|---|---|
inner_join(x, y, join_by(key)) |
1、2 | 仅保留双方匹配 |
left_join(x, y, join_by(key)) |
1、2、3 | key=3 的 val_y 为 NA |
right_join(x, y, join_by(key)) |
1、2、4 | key=4 的 val_x 为 NA |
full_join(x, y, join_by(key)) |
1、2、3、4 | key=3 的 val_y、key=4 的 val_x 为 NA |
外连接可以理解为给缺少匹配的一侧加一条虚拟记录,其值全是 NA。左连接保留 x,右连接保留 y,全连接保留双方;结果尽可能沿用 x 的次序,再附加尚未匹配的 y 记录。维恩图能提醒我们保留哪一部分行,但无法充分展示列如何组合,也不容易说明重复匹配。
上述条件都是键相等的等值连接。因为它最常见,日常通常省略“等值”二字。
多重匹配会扩大结果
对内连接而言,x 的一行可能有三种命运:没有匹配就删除;匹配一行就保留一次;匹配多行则每个匹配各生成一行。例如 x 的键为 1、2、3,y 的键为 1、2、2,输出虽然也有三行,却不是与原来的三行一一对应:键 1 一行、键 2 两行、键 3 消失。
若两侧都有重复键,可能产生组合爆炸:
df1 <- tibble(key = c(1, 2, 2), val_x = c("x1", "x2", "x3"))
df2 <- tibble(key = c(1, 2, 2), val_y = c("y1", "y2", "y3"))

df1 |>
  inner_join(df2, join_by(key))
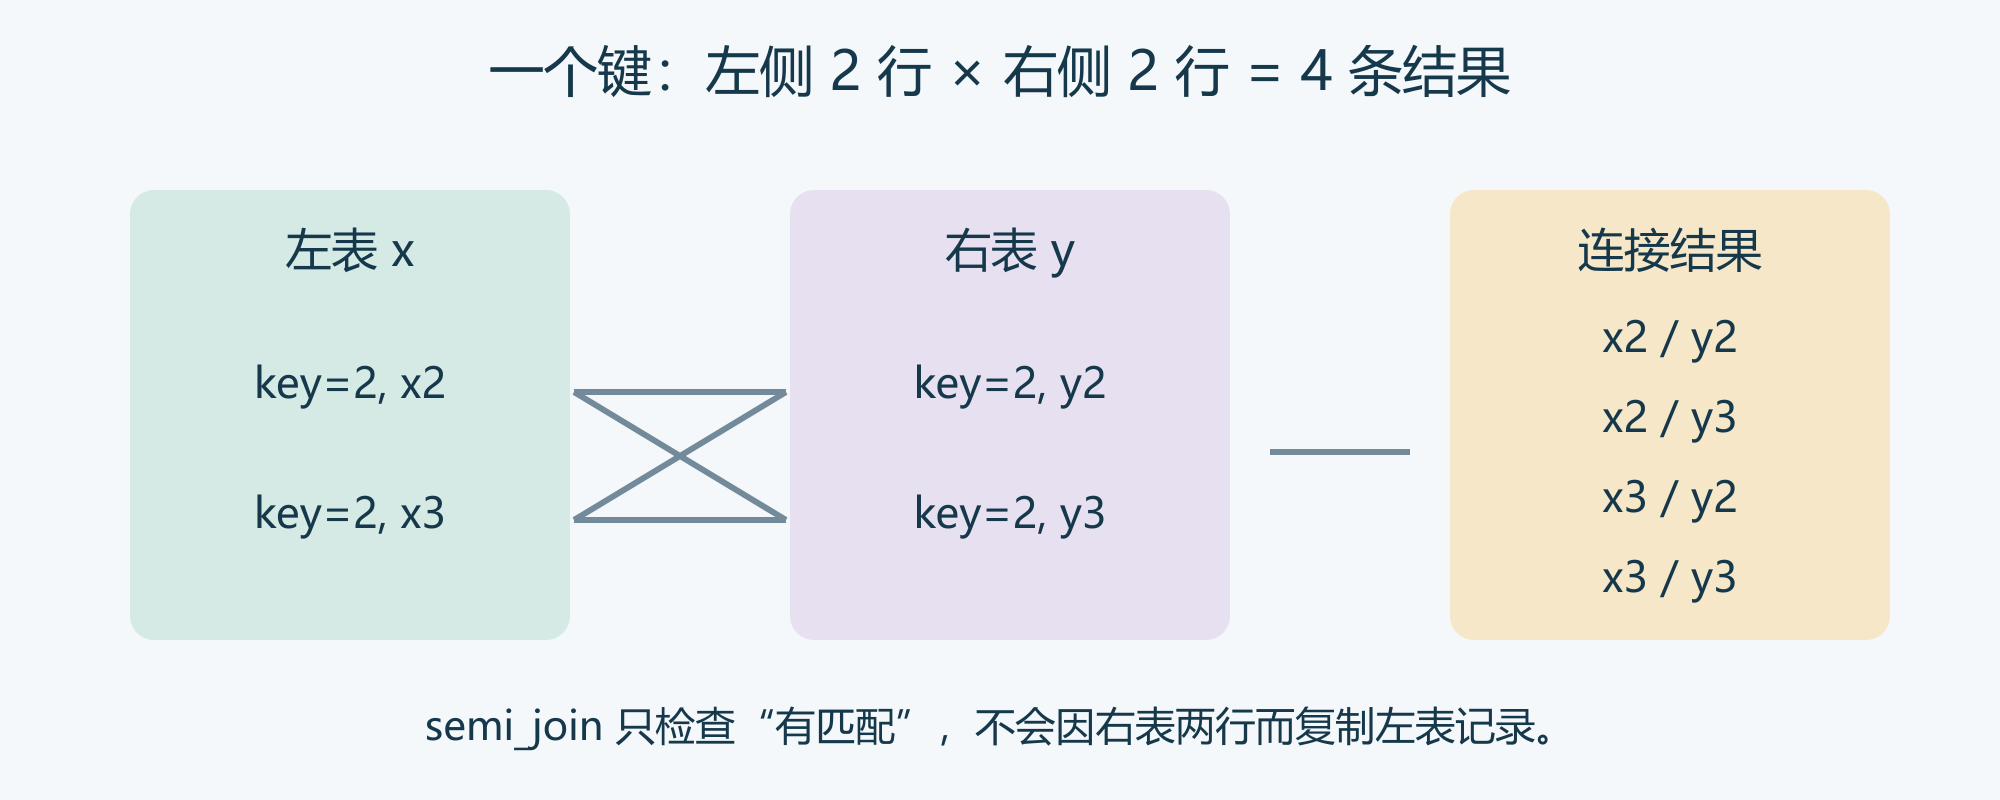
原文得到 5 行:键 1 对应 x1/y1;键 2 产生 x2/y2、x2/y3、x3/y2、x3/y3 四种组合。dplyr 发出非预期多对多关系警告。如果这种关系确实是有意设计的,可以显式设置 relationship = "many-to-many"。
编辑核对:原章早先脚注称,左连接不保持原行数时会得到警告。这不能作为通用保证。根据当前 dplyr 连接文档,默认主要检查等值连接中的非预期多对多关系;一对多导致的扩行,以及通常就会多重匹配的不等式连接,并不一定警告。若要求每个 x 行至多匹配一条 y,可明确设置 relationship = "many-to-one":
# 编者补充:把预期关系变成可检查的约束。
flights2 |>
  left_join(planes, join_by(tailnum), relationship = "many-to-one")
relationship 检查匹配数量关系,不负责“完全没有匹配”的情况。不要为了消除警告就盲目设为 "many-to-many";应先确认重复来源和期望结果。
筛选型连接只关心匹配是否存在。semi_join 保留至少一条匹配的 x 行,anti_join 保留零匹配的 x 行;它们不会像增列型连接那样因多个匹配复制 x 的记录。
从等值连接走向非等值连接
等值连接中两侧键相同,默认输出一份键即可;需要观察两侧来源时,可以设置 keep = TRUE:
x |>
  inner_join(y, join_by(key == key), keep = TRUE)
# key.x val_x key.y val_y
#     1 x1        1 y1
#     2 x2        2 y2
非等值连接的两侧键可能不同,因此通常保留双方键。除了 ==,还可以用不等式、最近匹配或区间关系定义行对是否匹配。
交叉连接:所有行对
cross_join 生成笛卡尔积,结果行数为 nrow(x) * nrow(y)。例如把四个姓名与自身连接,会得到包含自身配对在内的 16 个有序行对:
df <- tibble(name = c("John", "Simon", "Tracy", "Max"))
df |>
  cross_join(df)
这也称为自连接。由于所有行都匹配,交叉连接无需再区分 inner、left、right 或 full。数据稍大时,乘积规模可能非常高,应先估算行数。
不等式连接:限制允许的行对
使用 <、<=、>、>= 可以限制匹配集合。比如给姓名加编号,只保留左编号小于右编号,就得到不含自身、也不重复顺序的六种二人组合:
df <- tibble(id = 1:4, name = c("John", "Simon", "Tracy", "Max"))
df |>
  inner_join(df, join_by(id < id))
原文结果为 John/Simon、John/Tracy、John/Max、Simon/Tracy、Simon/Max、Tracy/Max。join_by 中左边的 id 默认来自 x,右边来自 y;不是同一行的 id 与自身比较。
滚动连接:按方向找最近匹配
滚动连接在满足不等式的候选中取最近值,用 closest() 包装条件。closest(x <= y) 找不小于 x 的最小 y;closest(x > y) 找严格小于 x 的最大 y。它适合两张时间表无法精确对齐、需要向前或向后匹配最近日期的情况。
假设办公室每季度举行一次生日聚会,通常选周一,避开一月第一周,以及 2022 年第三季度首个周一的美国独立日。聚会安排为:
parties <- tibble(
  q = 1:4,
  party = ymd(c("2022-01-10", "2022-04-04", "2022-07-11", "2022-10-03"))
)

set.seed(123)
employees <- tibble(
  name = sample(babynames::babynames$name, 100),
  birthday = ymd("2022-01-01") + (sample(365, 100, replace = TRUE) - 1)
)

employees |>
  left_join(parties, join_by(closest(birthday >= party)))
这样为每位员工找到生日当天或之前最近的聚会。例如原文中 Kemba 的生日是 1 月 22 日,匹配 1 月 10 日;Orean 的生日是 6 月 26 日,匹配 4 月 4 日;Amparo 的生日是 11 月 11 日,匹配 10 月 3 日。
但 1 月 10 日之前生日的人没有前一场聚会,反连接能找出这一遗漏:
employees |>
  anti_join(parties, join_by(closest(birthday >= party)))
# 原文:
# Maks    2022-01-07
# Nalani  2022-01-04
注意“最近”限定的是键值,不能自动保证参考表没有重复的最近键。如果业务要求每条记录只得到一个匹配,仍需要检查重复值或显式声明预期关系。
区间连接:直接表达覆盖范围
区间重叠连接为常用不等式提供了三个辅助形式,默认使用下列包含端点的条件:
| 辅助形式 | 对应条件 |
|---|---|
between(x, y_lower, y_upper) |
x >= y_lower 且 x <= y_upper |
within(x_lower, x_upper, y_lower, y_upper) |
x_lower >= y_lower 且 x_upper <= y_upper |
overlaps(x_lower, x_upper, y_lower, y_upper) |
x_lower <= y_upper 且 x_upper >= y_lower |
对生日案例,更直接的方法是指定每场聚会负责的生日区间,为一月上旬作特别处理。原文先故意录入一个存在重叠的版本:
parties <- tibble(
  q = 1:4,
  party = ymd(c("2022-01-10", "2022-04-04", "2022-07-11", "2022-10-03")),
  start = ymd(c("2022-01-01", "2022-04-04", "2022-07-11", "2022-10-03")),
  end = ymd(c("2022-04-03", "2022-07-11", "2022-10-02", "2022-12-31"))
)

parties |>
  inner_join(parties, join_by(overlaps(start, end, start, end), q < q)) |>
  select(start.x, end.x, start.y, end.y)
自连接检测到第二、第三个区间都包含 2022 年 7 月 11 日:第二个区间从 4 月 4 日到 7 月 11 日,第三个从 7 月 11 日到 10 月 2 日。修正第二个区间终点后再继续:
parties <- tibble(
  q = 1:4,
  party = ymd(c("2022-01-10", "2022-04-04", "2022-07-11", "2022-10-03")),
  start = ymd(c("2022-01-01", "2022-04-04", "2022-07-11", "2022-10-03")),
  end = ymd(c("2022-04-03", "2022-07-10", "2022-10-02", "2022-12-31"))
)

employees |>
  inner_join(
    parties,
    join_by(between(birthday, start, end)),
    unmatched = "error"
  )
原文得到 100 行、6 列,每位员工都有所属季度、聚会日、区间起止日。unmatched = "error" 可以尽快暴露被内连接丢弃的未匹配记录。
编辑核对:当前 dplyr 中,内连接的单值 unmatched = "error" 同时检查 x 和 y,因而不仅未分配员工会报错,完全没有员工对应的聚会也会报错。若只要求员工侧必须匹配,应按 API 使用长度为二的配置区分两侧。它不代替区间重叠检查,也不保证一个生日最多匹配一场聚会;需要这个约束时,还应检查区间并设置合适的 relationship。
练习:保留键和自连接
- 比较下面两个全连接,解释为什么键列的显示方式不同。第一种结果只有一列 key,包含 1、2、3、4;第二种同时显示 key.x、key.y,未匹配的一侧为 NA。
x |>
  full_join(y, join_by(key == key))

x |>
full_join(y, join_by(key == key), keep = TRUE)- 检测聚会区间重叠时,为什么在
join_by()中加入q < q?如果去掉这个不等式,会出现哪些匹配?
把键、匹配与结果一起检查
本章用增列型连接组合字段,用筛选型连接验证是否存在对应记录。真正可靠的连接从明确主键、外键及业务含义开始;随后检查唯一性、缺失、匹配基数、未匹配记录以及最终行数。连接成功返回数据框,不能替代这些检查。
这也是原书“变换”部分的最后一章。此前介绍了用 dplyr 和基础 R 处理逻辑值、数字及表格,用 stringr 处理字符串,用 lubridate 处理日期时间,以及用 forcats 处理因子。接下来的章节转向如何把不同类型的数据导入 R,并整理成整洁数据。










暂无评论内容