


用 TorchRL 完成 PPO 连续控制训练:从环境封装到策略评估
原作者:Vincent Moens。来源:PyTorch TorchRL 官方教程 Reinforcement Learning (PPO) with TorchRL Tutorial。本文依据 2026-10-05 读取的 TorchRL 0.14 文档翻译整理,旧版 PyTorch 教程副本不另计;代码随官方 stable 页面更新,复现时请记录实际依赖版本。
这个教程用倒立双摆任务说明如何把强化学习训练所需的组件连在一起:Gymnasium 环境、观察变换、TensorDict 数据容器、随机策略、价值网络、采样器、广义优势估计和裁剪 PPO 损失。最终得到的不是一段写死控制规则的程序,而是一个根据观察值生成连续动作的参数化策略。
PPO 在限制什么
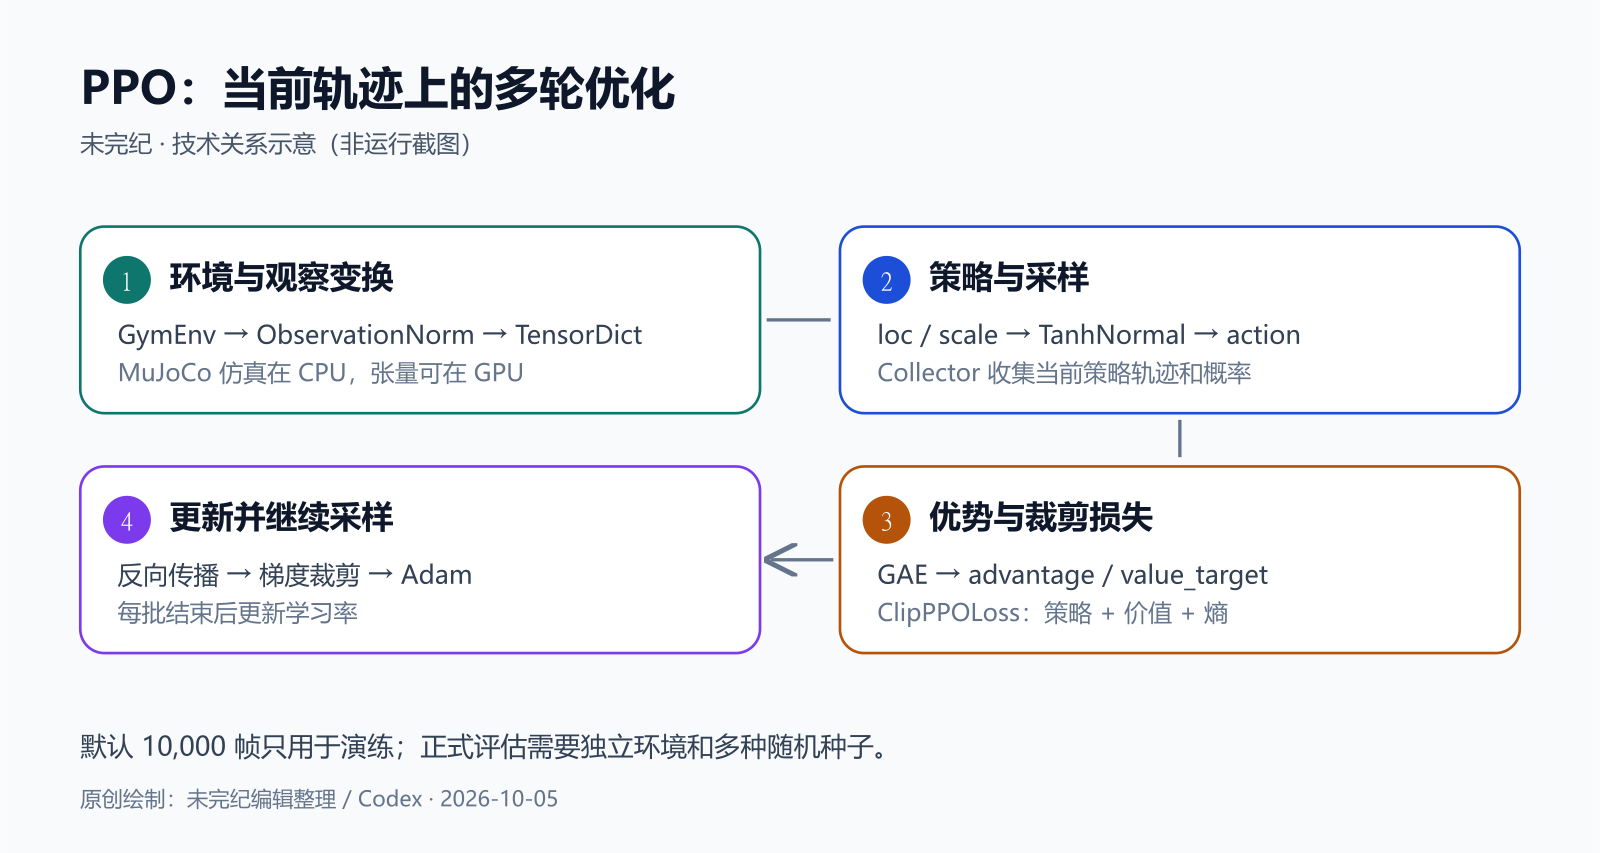
PPO 是一种在策略的策略梯度方法。先用旧策略 πold 与环境交互,收集状态、动作、奖励及动作概率;随后使用这批样本更新当前策略 πθ。对于同一个动作,以当前概率除以采样时概率,得到重要性比率 r = πθ(a|s) / πold(a|s)。
裁剪目标可写为 min(r·A, clip(r, 1−ε, 1+ε)·A),其中 A 是优势估计。取两者较小值,是对更新收益采取较保守的估计:不鼓励策略通过大幅改变动作概率来获得表面上的高收益。它不是对每一步策略变化的严格硬约束。TorchRL 的 ClipPPOLoss 已实现相应计算,读者可以把重点放在采样与数据流的正确衔接上。理论背景见 Proximal Policy Optimization Algorithms。
这里使用回放缓冲区只是为了把当前收集批次拆成小批次,并在若干轮优化中重用。它与 DQN 等离策略算法长期混合旧经验的用法不同;不能无限保留旧轨迹后仍把它当成这份 PPO 教程的等价实现。
准备依赖与超参数
官方在 Colab 中安装 torchrl、gymnasium[mujoco] 和 tqdm,代码还使用 PyTorch、TensorDict 和 Matplotlib。在本地应使用隔离虚拟环境,记录这些包与 MuJoCo 的具体版本,不把无版本号安装视为可复现配置。Notebook 中的 !pip3 是单元格语法;终端安装应使用目标解释器对应的包管理命令。
以下代码块按顺序组合,保留官方训练主线,只压缩打印与进度字符串并翻译注释。本文保留了示例代码与输出;TorchRL 0.14 原示例源码可从官方源码文件下载,与核验副本字节一致(SHA-256:7e89ee9f060398302653dff29ee0ae9de9ad0da4be4585f017ef3ecc89751dc1)。本任务未运行该源码、环境仿真或训练。
from collections import defaultdict
import matplotlib.pyplot as plt
import torch
from torch import multiprocessing, nn
from tensordict.nn import TensorDictModule
from tensordict.nn.distributions import NormalParamExtractor
from torchrl.collectors import Collector
from torchrl.data.replay_buffers import ReplayBuffer
from torchrl.data.replay_buffers.samplers import SamplerWithoutReplacement
from torchrl.data.replay_buffers.storages import LazyTensorStorage
from torchrl.envs import (
    Compose, DoubleToFloat, ObservationNorm, StepCounter, TransformedEnv,
)
from torchrl.envs.libs.gym import GymEnv
from torchrl.envs.utils import check_env_specs, ExplorationType, set_exploration_type
from torchrl.modules import ProbabilisticActor, TanhNormal, ValueOperator
from torchrl.objectives import ClipPPOLoss
from torchrl.objectives.value import GAE
from tqdm import tqdm
网络的隐藏层宽度为 256,学习率为 3×10⁻⁴,梯度范数裁剪阈值为 1。每次收集 1000 帧,总帧数默认 10000;每批数据进行 10 轮优化,小批次大小为 64。折扣系数 γ 为 0.99,GAE 的 λ 为 0.95,PPO 裁剪宽度为 0.2,熵系数为 10−4。
版本和资源边界:原代码检查 multiprocessing 的启动方式,在可用 CUDA 且不是 fork 时选择 GPU。对这个 Gymnasium/MuJoCo 环境,device 只控制动作和观察张量等数据及网络所在设备,物理仿真本身仍在 CPU 上执行;给 GymEnv 传 GPU 不会把 MuJoCo 仿真变成 GPU 仿真。
环境、归一化与 TensorDict
is_fork = multiprocessing.get_start_method() == "fork"
device = torch.device(0) if torch.cuda.is_available() and not is_fork else torch.device("cpu")
num_cells = 256
lr = 3e-4
max_grad_norm = 1.0
frames_per_batch = 1000
total_frames = 10_000
sub_batch_size = 64
num_epochs = 10
clip_epsilon = 0.2
gamma = 0.99
lmbda = 0.95
entropy_eps = 1e-4

base_env = GymEnv("InvertedDoublePendulum-v4", device=device)
env = TransformedEnv(
    base_env,
    Compose(
        ObservationNorm(in_keys=["observation"]),
        DoubleToFloat(),
        StepCounter(),
    ),
)
env.transform[0].init_stats(num_iter=1000, reduce_dim=0, cat_dim=0)
check_env_specs(env)
rollout = env.rollout(3)
print(env.observation_spec, env.reward_spec, env.input_spec)
print(rollout.batch_size)
GymEnv("InvertedDoublePendulum-v4") 包装 Gymnasium 环境。额外关键字会传递给底层环境构造器。这个环境名保留自官方代码,不默默替换成其他版本;如果安装的 Gymnasium 提示版本弃用,应先核对任务定义与观测/动作规范,再迁移。
TransformedEnv 在基础环境外依次叠加三个变换。ObservationNorm 只读写 observation,先以 1000 步估计位置和尺度;DoubleToFloat 把双精度数据转为网络常用的单精度;StepCounter 累计回合步数。默认归一化依据这次随机采样估计的统计量,不意味着所有后续观察严格服从标准正态分布。
TensorDict 是各组件共享的数据接口。模块通过 in_keys 声明读取哪个张量,用 out_keys 声明写入哪个张量。这样策略、损失与环境不需要分别发明位置参数约定。变换若不单独指定输出键,通常会更新对应输入键。
环境还提供 observation_spec、reward_spec、input_spec 和其中的 action_spec。官方示例的观察向量有 11 维,动作有 1 维。check_env_specs 会做短 rollout 并检查数据与规范是否一致;这段调用是读者复现时的检查步骤,本文没有宣称已经执行通过。
env.rollout(3) 返回时间批维为 3 的 TensorDict,动作默认从规范中随机生成。当前观察和动作在顶层;执行动作后得到的观察、奖励以及终止标记在 next 下。例如奖励通过 data["next", "reward"] 读取。不能把当前值和下一步值混用;采用多步变换等情况时,next 也不一定能简单等同于数组中下一行。
构造随机策略与价值网络
PPO 需要探索,因此策略网络输出的是动作分布的参数,而非直接输出一个确定动作。网络从 Dobs 维观察映射到 2Daction 个数,NormalParamExtractor 把它拆成位置参数 loc 和严格为正的尺度 scale。
连续动作有上下界。TanhNormal 将正态变量经过相应变换限制在动作范围内;范围从环境规范读取。ProbabilisticActor 根据 loc 和 scale 构造分布并采样,同时以 return_log_prob=True 保存采样动作的对数概率,供之后计算新旧策略比率。分布构造器要求的参数名必须对应;使用其他 TensorDict 键名时,需要显式映射。
actor_net = nn.Sequential(
    nn.LazyLinear(num_cells, device=device), nn.Tanh(),
    nn.LazyLinear(num_cells, device=device), nn.Tanh(),
    nn.LazyLinear(num_cells, device=device), nn.Tanh(),
    nn.LazyLinear(2 * env.action_spec.shape[-1], device=device),
    NormalParamExtractor(),
)
policy_module = TensorDictModule(
    actor_net, in_keys=["observation"], out_keys=["loc", "scale"],
)
policy_module = ProbabilisticActor(
    module=policy_module,
    spec=env.action_spec,
    in_keys=["loc", "scale"],
    distribution_class=TanhNormal,
    distribution_kwargs={
        "low": env.action_spec_unbatched.space.low,
        "high": env.action_spec_unbatched.space.high,
    },
    return_log_prob=True,
)

value_net = nn.Sequential(
    nn.LazyLinear(num_cells, device=device), nn.Tanh(),
    nn.LazyLinear(num_cells, device=device), nn.Tanh(),
    nn.LazyLinear(num_cells, device=device), nn.Tanh(),
    nn.LazyLinear(1, device=device),
)
value_module = ValueOperator(module=value_net, in_keys=["observation"])

# 必须先初始化 LazyLinear,再构造采样器和优化路径。
policy_module(env.reset())
value_module(env.reset())
policy_module.eval()
value_module.eval()
价值网络同样读取 observation,但只输出一个值,由 ValueOperator 写入 state_value。它估计未来折扣回报,帮助优势估计降低方差;部署仅需策略时不一定使用这个网络。教程为 actor 和 critic 分配独立参数,尽管结构相近。
不能省略初始化前向:使用 LazyLinear 时,输入特征数和参数在首次前向计算时才确定。必须先让策略和价值网络各处理一次 env.reset(),再进入采样器和优化路径;否则可能出现未初始化参数错误。这一步不是可有可无的打印演示。
这版教程在采样器创建前将两个模块都设为 eval(),并在 PPO 优化时保持该模式。eval 控制 Dropout、BatchNorm 等模块行为,set_exploration_type 控制动作怎样从分布选取,torch.no_grad() 控制是否构建自动微分图;三者相互独立。eval() 不会自动关闭梯度,也不代表动作一定确定。
连接采样器、缓冲区与损失
collector = Collector(
    env,
    policy_module,
    frames_per_batch=frames_per_batch,
    total_frames=total_frames,
    split_trajs=False,
    device=device,
    auto_register_policy_transforms=True,
)
replay_buffer = ReplayBuffer(
    storage=LazyTensorStorage(max_size=frames_per_batch),
    sampler=SamplerWithoutReplacement(),
)
advantage_module = GAE(
    gamma=gamma, lmbda=lmbda, value_network=value_module, average_gae=True,
)
loss_module = ClipPPOLoss(
    actor_network=policy_module,
    critic_network=value_module,
    clip_epsilon=clip_epsilon,
    entropy_bonus=bool(entropy_eps),
    entropy_coeff=entropy_eps,
    critic_coeff=1.0,
    loss_critic_type="smooth_l1",
)
optim = torch.optim.Adam(loss_module.parameters(), lr)
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(
    optim, total_frames // frames_per_batch, 0.0,
)
Collector 不断执行“读取观察—生成动作—环境前进一步”,在结束时重置环境。默认在训练进程中运行,每次产生指定帧数的 TensorDict,达到总帧数后停止。这是当前文档采用的统一构造入口;不要不加核对地把旧教程中的 SyncDataCollector 名称替换进同一份代码。
ReplayBuffer 使用容量为一批帧数的 LazyTensorStorage,配合 SamplerWithoutReplacement 做不重复采样。PPO 并不强制使用这个类,也可以直接从采样 TensorDict 切分小批次,但必须保留当前批次与旧策略概率之间的关系。
GAE 用奖励、价值预测和轨迹终止信息估计优势,并将 advantage 与不带梯度的 value_target 写回 TensorDict。价值网络在内层优化中不断改变,所以官方在每一轮 epoch 开头重新计算这些量。不要先把轨迹展平、丢掉时序关系,再计算依赖时间顺序的优势。
ClipPPOLoss 组合策略目标、价值误差和熵项;这里价值损失采用 smooth_l1,权重为 1,启用小幅熵奖励来保留探索。Adam 更新其参数;余弦学习率调度器以外层采样批次数为周期逐渐把学习率降至 0。梯度裁剪和调度器是这份实现的训练选择,不是 PPO 算法定义必不可少的部分。
完整训练与观察指标
logs = defaultdict(list)
pbar = tqdm(total=total_frames)

for i, tensordict_data in enumerate(collector):
    for _ in range(num_epochs):
        advantage_module(tensordict_data)
        data_view = tensordict_data.reshape(-1)
        replay_buffer.extend(data_view.cpu())

        for _ in range(frames_per_batch // sub_batch_size):
            subdata = replay_buffer.sample(sub_batch_size)
            loss_vals = loss_module(subdata.to(device))
            loss_value = (
                loss_vals["loss_objective"]
                + loss_vals["loss_critic"]
                + loss_vals["loss_entropy"]
            )
            loss_value.backward()
            torch.nn.utils.clip_grad_norm_(loss_module.parameters(), max_grad_norm)
            optim.step()
            optim.zero_grad()

    logs["reward"].append(tensordict_data["next", "reward"].mean().item())
    logs["step_count"].append(tensordict_data["step_count"].max().item())
    logs["lr"].append(optim.param_groups[0]["lr"])
    pbar.update(tensordict_data.numel())

    if i % 10 == 0:
        with set_exploration_type(ExplorationType.DETERMINISTIC), torch.no_grad():
            eval_rollout = env.rollout(1000, policy_module)
        logs["eval reward"].append(eval_rollout["next", "reward"].mean().item())
        logs["eval reward (sum)"].append(eval_rollout["next", "reward"].sum().item())
        logs["eval step_count"].append(eval_rollout["step_count"].max().item())
        del eval_rollout

    scheduler.step()
每收到一批轨迹,先计算优势,再展平成样本,将当前批次放入 CPU 缓冲区;抽样后把小批次送回目标设备。损失相加后依次反向传播、裁剪梯度、执行优化和清空梯度。外层批次结束后记录平均单步奖励、当前批次最大步数和学习率。
注意 1000 // 64 等于 15,这份代码每轮 epoch 执行 15 次、每次 64 条样本的优化调用。不能仅因文字写着“遍历一批数据”,就声称这段循环每轮恰好覆盖全部 1000 条;若修改尾批处理,应明确决定是丢弃、补齐还是允许小尾批,并验证与采样器状态的配合。
当 i % 10 == 0 时,教程临时选择确定性动作并关闭梯度,最多 rollout 1000 步,记录平均奖励、累计奖励和最大步数。这里的累计奖励是这次 rollout 的奖励之和,与训练平均单步奖励不是同一个统计量。terminated 与 truncated 也应区分:环境失败终止与达到时间上限截断含义不同。
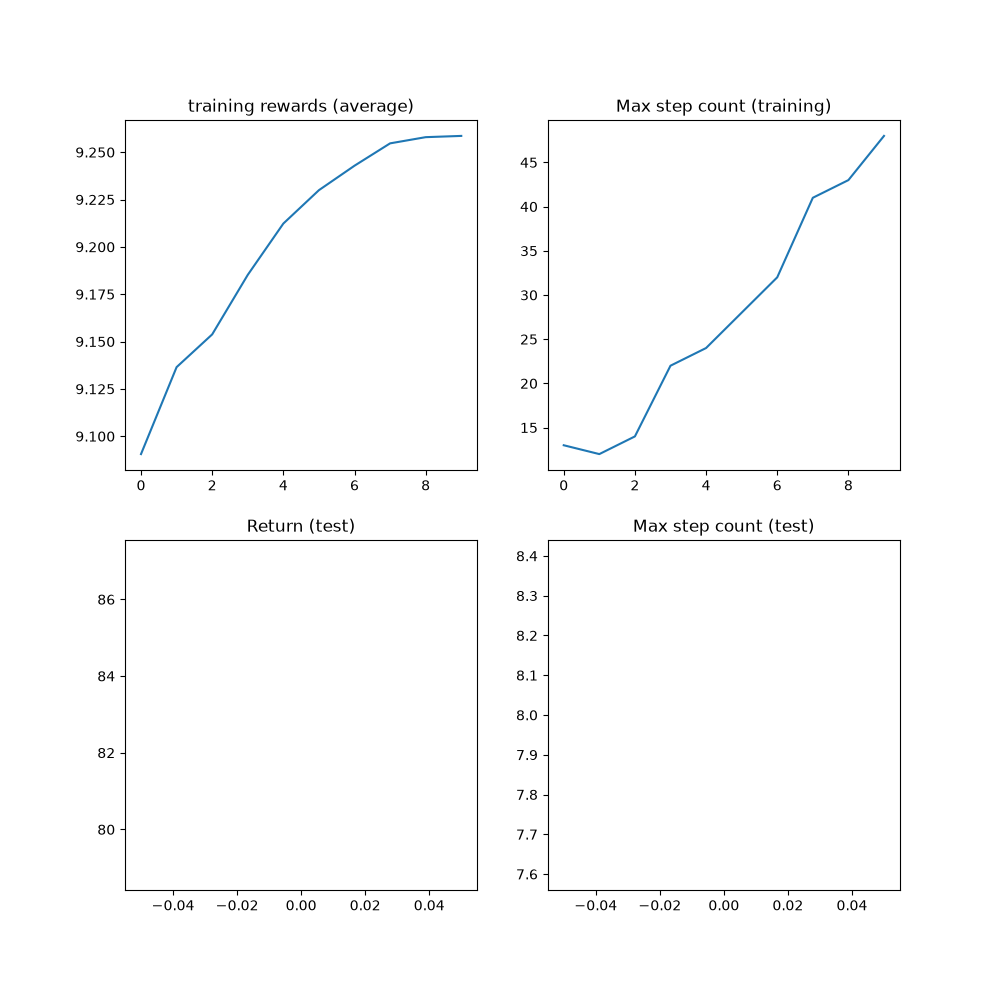
评估边界:默认总共只有 10 个批次,索引从 0 到 9,因此这段条件只在第一批训练后评估一次。即使终端反复显示同一评估结果,也不代表每批都重新测量。本文保留原循环以便对照,同时建议正式实验增加训练预算、合理安排评估次数,并使用独立环境评估,避免共享 env 的 rollout 干扰采样状态。独立评估环境应复制训练时的归一化参数,并用多个随机种子报告结果。
官方建议完整训练把预算提高到约 100 万帧,并期望在达到上限前学到维持 1000 步的策略。这是教程的目标与经验描述,不是对任意版本、硬件和随机种子的保证。源码默认 1 万帧仅适合演练数据链路,不足以证明任务已经解决。
plt.figure(figsize=(10, 10))
plt.subplot(2, 2, 1)
plt.plot(logs["reward"])
plt.title("training rewards (average)")
plt.subplot(2, 2, 2)
plt.plot(logs["step_count"])
plt.title("Max step count (training)")
plt.subplot(2, 2, 3)
plt.plot(logs["eval reward (sum)"])
plt.title("Return (test)")
plt.subplot(2, 2, 4)
plt.plot(logs["eval step_count"])
plt.title("Max step count (test)")
plt.show()
四张图分别展示训练平均奖励、训练批次最大步数、评估累计回报和评估最大步数。原网页含有官方生成的示例日志与图像,但本稿没有把它们冒充为自己的运行结果,也没有自行绘制虚构学习曲线。原文的总运行时间只属于其构建环境,不能用作性能基准。
下一步改进与静态审查结论
当数据流正确后,可以使用 ParallelEnv 并行仿真,提高采样吞吐;需要观察控制行为时,可以启用环境渲染并添加 VideoRecorder。这些扩展会改变资源需求,应先验证环境、进程启动方式和渲染后端。训练结束后也应按所用版本的接口关闭采样器与环境,释放资源。
本次静态检查覆盖网络初始化、TensorDict 键、动作边界、GAE 前后数据形状、损失组合、缓冲区用途及评估频率。所读代码未包含硬编码密钥、远程模型反序列化或拼接用户输入执行 shell 的路径;这不是无漏洞保证。安装依赖会访问软件源,模拟与训练会消耗计算资源;所有文章命令本次均未执行,不能称为训练成功、测试通过或复现了收敛曲线。
版权与许可:Vincent Moens 署名保留;TorchRL 仓库为 MIT License,© Meta Platforms, Inc. and affiliates,完整 MIT 许可证文本可下载。页面另标注 © Copyright 2022, Meta。本文译写与配图依据另行授权制作。本稿的流程图为原创;代码节选与整理差异如上标注。










暂无评论内容