


用 JAX 梯度检查点控制激活保存与重计算
原作者:The JAX authors。本文依据官方 Gradient checkpointing with jax.checkpoint (jax.remat) 全文翻译整理,来源核对日期为 2026-10-05。代码仅经静态审查;文中涉及的残差列表和数值属于原文示例,绝非本次运行记录。新增的标量求导、递归顺序和版本提醒均单独说明。
反向模式自动微分需要使用前向计算产生的一些中间值。JAX 把这些为反向过程保留下来的值称为残差(residuals)。大型模型里,这些值占据的内存常常比参数本身更棘手。jax.checkpoint 的别名是 jax.remat:它让你选择哪些值保留、哪些值在反向计算时重新生成,用额外浮点运算换取较低的残差内存占用。
这里的“检查点”是自动微分中的重计算边界,不是保存训练参数、优化器状态或恢复训练进度的磁盘文件。本页采用 JAX 新的 rematerialization 实现,需要启用 jax_remat3;这不是可以无条件复制到旧版 JAX 的配置。
import jax
jax.config.update('jax_remat3', True)
import jax.numpy as jnp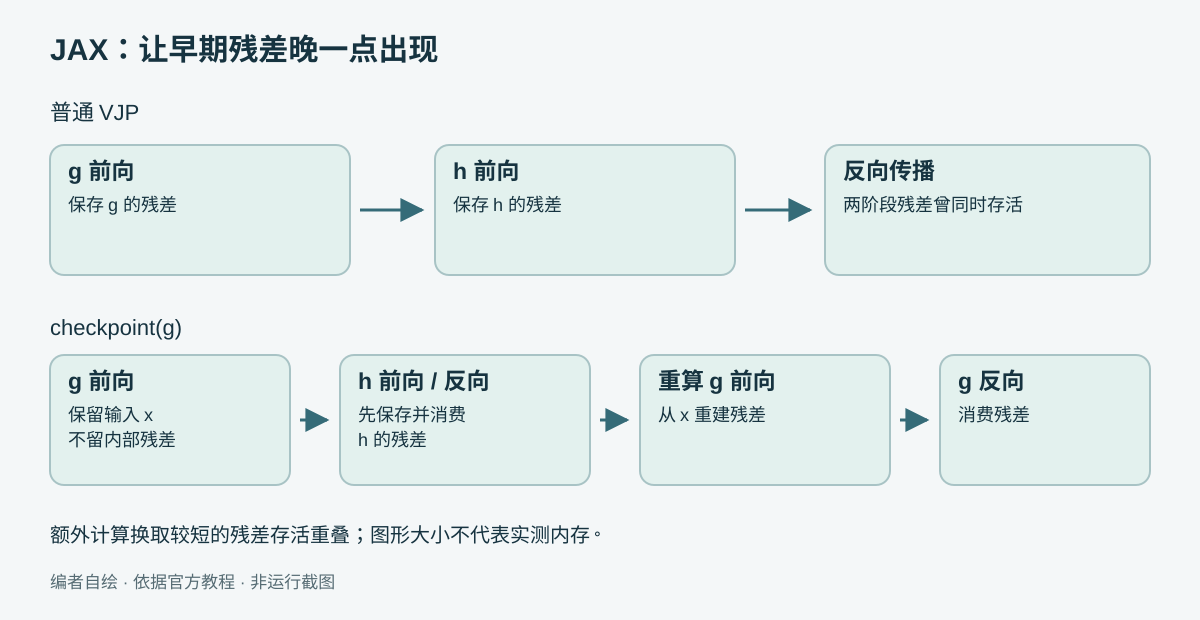
先看 JAX 保存了什么
用三层小网络观察残差:每层先做矩阵与向量的点积,再取正弦。
def g(W, x):
    y = jnp.dot(W, x)
    return jnp.sin(y)

def f(W1, W2, W3, x):
    x = g(W1, x)
    x = g(W2, x)
    x = g(W3, x)
    return x

W1 = jnp.ones((5, 4))
W2 = jnp.ones((6, 5))
W3 = jnp.ones((7, 6))
x = jnp.ones(4)

from jax.ad_checkpoint import print_saved_residuals
print_saved_residuals(f, W1, W2, W3, x)
原文的残差列表包含四个输入,以及形状为 [5]、[6] 的两个正弦输出和形状为 [5]、[6]、[7] 的三个余弦输出。正弦输出用于后续层,余弦用于正弦的导数。
编者修正:原文注释用 jax.grad(f) 描述这一观察,但这里 f 返回长度为 7 的向量,不能直接交给要求标量输出的 grad。检查残差本身不需要将输出改成标量;若实际求梯度,可以先明确损失归约,或使用 VJP。以下归约新增了“把七个输出相加”的目标,不是原函数原封不动的梯度:
def scalar_loss(W1, W2, W3, x):
    return jnp.sum(f(W1, W2, W3, x))

# 对 W1 求导;若需其他参数,另设 argnums。
grad_W1 = jax.grad(scalar_loss)(W1, W2, W3, x)
接着只在各层调用位置加上检查点:
def f2(W1, W2, W3, x):
    x = jax.checkpoint(g)(W1, x)
    x = jax.checkpoint(g)(W2, x)
    x = jax.checkpoint(g)(W3, x)
    return x

print_saved_residuals(f2, W1, W2, W3, x)
默认检查点策略不保存子函数内部残差,而是在需要时从该子函数的输入重新计算。原文此时仍列出四个输入和两个正弦输出,却不再列出余弦输出。那两个正弦值是后续被检查点包裹的层的输入,因此仍可能保存。这说明“某一层内部不保存残差”不等于“整个网络只保存最初输入”。
给中间值命名,把策略留在调用层
如果想试不同保存策略,又不想不断改动模型的调用结构,可以用 checkpoint_name 给关心的值贴上名称。它本身相当于恒等函数,只附加标签:
from jax.ad_checkpoint import checkpoint_name

def f3(W1, W2, W3, x):
    x = checkpoint_name(g(W1, x), name='a')
    x = checkpoint_name(g(W2, x), name='b')
    x = checkpoint_name(g(W3, x), name='c')
    return x

f3 = jax.checkpoint(
    f3,
    policy=jax.checkpoint_policies.save_only_these_names('a')
)
print_saved_residuals(f3, W1, W2, W3, x)
原文列表只保留四个输入与名为 a 的 f32[5] 值。模型负责说明“这是什么”,训练调用处负责决定“允许保留什么”。策略定义的是可保存性,不是强制保存承诺;反向过程根本不用的值,不会因为名字在白名单里就必须保存。
为了进一步观察前向、反向各自执行了什么,原文给出下面的调试工具。它将函数参数展平成 pytree 叶子,追踪 VJP 的前向表示,再展开闭包中的残差并追踪反向表示,用 Rich 并排显示两份 jaxpr。
from jax.tree_util import tree_flatten, tree_unflatten
from rich.console import Console
from rich.table import Table
import rich.text

def print_fwd_bwd(f, *args, **kwargs) -> None:
    args, in_tree = tree_flatten((args, kwargs))

    def f_(*args):
        args, kwargs = tree_unflatten(in_tree, args)
        return f(*args, **kwargs)

    fwd = jax.jit(lambda *args: jax.vjp(f_, *args)).trace(*args).jaxpr.jaxpr
    y, f_vjp = jax.vjp(f_, *args)
    res, in_tree = tree_flatten(f_vjp)

    def g_(*args):
        *res, y = args
        f_vjp = tree_unflatten(in_tree, res)
        return f_vjp(y)

    bwd = jax.jit(g_).trace(*res, y).jaxpr.jaxpr
    table = Table(show_header=False, show_lines=True,
                  padding=(1, 2, 0, 2), box=None)
    table.add_row("[bold green]forward computation:",
                  "[bold green]backward computation:")
    table.add_row(rich.text.Text.from_ansi(str(fwd)),
                  rich.text.Text.from_ansi(str(bwd)))
    console = Console(width=240, force_jupyter=True)
    console.print(table)

def _renderable_repr(self):
    return self.html

rich.jupyter.JupyterRenderable._repr_html_ = _renderable_repr

print_fwd_bwd(f, W1, W2, W3, x)
print_fwd_bwd(f3, W1, W2, W3, x)
这段是原文的交互式 Notebook 辅助代码,依赖 Rich 并修改其 Jupyter 显示方法,使用了 JAX 的追踪表示;它不是稳定的性能测量 API。g_ 用一个形状兼容的值作为余切来追踪反向计算,也不能把它的返回当成你实际损失函数的梯度。原文的大段 jaxpr 对比表明:不加检查点时,多个 cos 在前向阶段计算并保留;只允许保存 a 后,反向阶段出现 RematTraced 与重新执行的点积、正弦和余弦。具体变量编号、文件路径、optimization_barrier 等打印细节随版本变化,完整原始输出随来源证据保留,本文不将它们改造成实测报告。
重计算究竟改变了哪一段工作
jax.linearize 与 jax.vjp 都允许在不同时间计算某些值。以正弦为例,可以在前向时就计算并保存余弦,也可以保存输入,把余弦推迟到反向时才计算:
def sin_vjp(x):
    y = jnp.sin(x)
    cos_x = jnp.cos(x)
    return y, lambda y_bar: cos_x * y_bar

def sin_vjp2(x):
    y = jnp.sin(x)
    return y, lambda y_bar: jnp.cos(x) * y_bar
这两个小例子保存的东西大小相同,所以并没有省内存;只是前向浮点运算减少、反向浮点运算增加。真正有意义的空间交换往往来自函数组合。
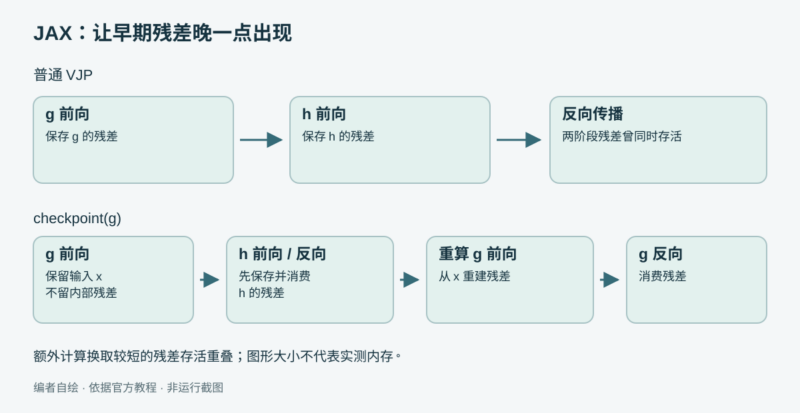
设 f(x) = h(g(x)),普通 VJP 会在前向分别构造 g、h 的 VJP 闭包。两个闭包的残差需要同时存活到反向:
# 本节 g、h 表示任意满足求导要求的子函数,
# 与上文两参数的网络层 g 不是同一个例子。
def f_vjp(x):
    y, g_vjp = jax.vjp(g, x)
    z, h_vjp = jax.vjp(h, y)

    def f_bwd(z_bar):
        y_bar, = h_vjp(z_bar)
        x_bar, = g_vjp(y_bar)
        return x_bar

    return z, f_bwd
另一种实现先只计算 g(x) 的值,等 h 的反向完成后,再构造 g 的 VJP:
def f_vjp_checkpoint(x):
    y = g(x)
    z, h_vjp = jax.vjp(h, y)

    def f_bwd2(z_bar):
        y_bar, = h_vjp(z_bar)
        _, g_vjp = jax.vjp(g, x)
        x_bar, = g_vjp(y_bar)
        return x_bar

    return z, f_bwd2
现在前向不计算也不保存 g_vjp 闭包中的残差,而把这部分工作放到反向。若 g 与 h 的残差内存相近,并且都远大于输入 x,原文的理想化推导可以把这部分所需残差内存降到大约一半。代价是 jax.vjp(g, x) 会再次计算 g(x),而这里用下划线丢弃它的值。这个“一半”有明确假设,不能外推为任意模型的峰值显存都减半。
无需手写 VJP,直接把检查点放在第一阶段 g 上就能表达同样的意图:
def f_checkpoint(x):
    y = jax.checkpoint(g)(x)
    return h(y)
若最终输出为标量,计算其梯度可理解为五步:先运行 g 的前向而不保留内部残差;运行 h 前向并保存残差;完成 h 反向并消费其残差;重新运行 g 前向以准备残差;最后完成 g 反向。对应的教学展开式是:
def f_checkpoint_grad(x):
    y = g(x)
    z, h_vjp = jax.vjp(h, y)
    y_bar, = h_vjp(1.0)
    _, g_vjp = jax.vjp(g, x)
    x_bar, = g_vjp(y_bar)
    return x_bar
这里的 1.0 只适用于标量输出的余切种子。一般而言,jax.checkpoint(foo) 保持 foo 的输入输出行为,改变的是自动微分下的保存方式,尤其影响 linearize、vjp 及其封装(如 grad),而不是普通的 jvp 计算。
为什么不能只把整个函数包起来
在上述简单组合、默认“内部都重算”策略下,把整个 f 包进检查点,会先跑一次前向并丢掉残差,紧接着为了反向又跑一次完整前向并保存全部残差。需要使用那些残差时,峰值仍然存在,只是多做了一轮计算:
def f_grad_bad(x):
    _ = f(x)
    _, f_vjp = jax.vjp(f, x)
    x_bar, = f_vjp(1.0)
    return x_bar
只给最后阶段 h 加检查点也有类似问题。g 的残差仍然留着,h 刚丢掉的残差马上就要重算回来:
def f_grad_bad2(x):
    y, g_vjp = jax.vjp(g, x)
    z = h(y)
    _, h_vjp = jax.vjp(h, y)
    y_bar, = h_vjp(1.0)
    x_bar, = g_vjp(y_bar)
    return x_bar
对 f3(f2(f1(x))) 这样的链式结构,优先考察 f1、f2 或两者组合的边界,它们表达不同的内存/重计算交换。原文的这一解释不排斥后文“给整个 loss 配选择性策略”的做法:后者允许保留部分关键值,讨论的策略与默认全重算并不相同。最终仍应观察实际编译与内存行为。
用保存策略在两个极端之间选择
没有检查点时,JAX 的自动微分倾向于尽早计算可计算的值并留给反向;默认检查点则倾向于前向少存、反向重算。policy 提供中间选项:
save_only_these_names(*names):只有这些名字允许保存。save_any_names_but_these(*names):除了所列名字之外,其他已经命名的值允许保存;不能误读为所有未命名值也会保存。save_and_offload_only_these_names(...):一些名字保留在设备,另一些可以转移到其他内存空间。everything_saveable与nothing_saveable:分别表达“全部允许保存”和“全部重算”的两个极端;后者等同于不指定 policy 的检查点行为。
看一个有显式标量损失的网络:
def loss(params, x, y):
    return jnp.sum((predict(params, x) - y) ** 2)

def predict(params, x):
    *Ws, Wlast = params
    for i, W in enumerate(Ws):
        x = layer(W, x)
        x = checkpoint_name(x, name=f'layer{i}_output')
    return jnp.dot(Wlast, x)

def layer(W, x):
    return jnp.sin(jnp.dot(W, x))

W1 = W2 = W3 = jnp.ones((4, 4))
params = [W1, W2, W3]
x = jnp.ones(4)
y = jnp.ones(4)

print_saved_residuals(loss, params, x, y)

loss_checkpoint = jax.checkpoint(
    loss,
    policy=jax.checkpoint_policies.save_any_names_but_these('layer1_output')
)
print_saved_residuals(loss_checkpoint, params, x, y)
原文默认列表包括参数、输入、两层的余弦、中间层输出以及损失计算中的乘法结果。应用策略后,列表变为参数、输入 x、目标 y 和 layer0_output。无需改动 loss、predict、layer 的调用方式,就能在外层试验策略。所有“允许保存”的决策都要再经过“反向是否需要”的判断。
不一定要重算,也可以卸载到主机内存
设备内存不足时,另一个选择是在前向把残差移动到其他内存空间,反向需要时再搬回。这样消耗的是传输带宽而不是重计算 FLOPs。策略的四类参数分别指定设备上可保存的名字、可以卸载的名字、源内存空间和目标内存空间;未列出的名字及未命名的值按重计算处理。
from functools import partial

policy = jax.checkpoint_policies.save_and_offload_only_these_names(
    names_which_can_be_saved=['y'],
    names_which_can_be_offloaded=['z'],
    offload_src='device',
    offload_dst='pinned_host'
)

@partial(jax.checkpoint, policy=policy)
def f_offload(x):
    y = checkpoint_name(jnp.sin(x), 'y')
    z = checkpoint_name(jnp.sin(y), 'z')
    w = checkpoint_name(jnp.sin(z), 'w')
    return jnp.sum(w)

print(jax.grad(f_offload)(jnp.arange(4.)))
print_saved_residuals(f_offload, jnp.arange(4.))
原文的梯度示例为 [1., 0.26450825, -0.18009877, -0.9704719],残差中出现 f32<host>[4] 的 device_put 输出:它仍然被保存,只是放在主机而不是设备内存。pinned_host 的可用性、传输成本与收益取决于后端和硬件;本次没有测量 PCIe 传输、峰值显存或吞吐量,不能据这四个数字声称卸载更快。
让 custom_vjp 自己定义重计算规则
命名策略只能从函数标记过的值里选择。有时函数作者知道一个更值得保存的量,或者能重写整个重计算过程。新的 custom_vjp.defremat 为此提供三条规则:
fwd(*args) -> (out, res):在重计算区域的前向运行,决定留下什么。rem(res, *args) -> (out, res2):在反向阶段,根据留下的残差和原参数重新生成输出,以及反向规则需要的残差。bwd(res2, g) -> arg_cotangents:使用新残差和输出余切,返回各输入的余切。
通常,defvjp 提供的前向规则进入 jax.remat 后,也像普通代码一样被重计算;defremat 改写这个默认过程。若函数在 remat 外求导,rem 会紧跟 fwd 在前向运行,最终只保存 bwd 所需的值。若希望 remat 外另用一套 VJP,还可以同时定义 defvjp。此功能需要 jax_custom_vjp3,不能只打开 jax_remat3 就假设可用。
jax.config.update('jax_custom_vjp3', True)

sin = jax.custom_vjp(jnp.sin)
sin.defremat(
    lambda x: (jnp.sin(x), jnp.cos(x)),
    lambda cos_x, x: (jnp.sin(x), cos_x),
    lambda cos_x, g: (cos_x * g,)
)

f_custom = jax.remat(lambda x: sin(sin(x)))
print(jax.grad(f_custom)(1.0))
print(jax.grad(jnp.sin)(jnp.sin(1.0)) * jnp.cos(1.0))
这个例子知道正弦的反向只需要余弦,于是在前向主动留下余弦。原文两次打印同为 0.36003947,第二次使用链式法则作参考。这是原文结果,不是本文运行验证。
jax.custom_gradient(remat=True) 可以用闭包表达同样的规则。被装饰函数返回输出与 rem;rem 接收原参数,再返回输出与 VJP 函数。被 rem 捕获的值在前向保存,被 VJP 捕获的量则由 rem 准备:
@jax.custom_gradient(remat=True)
def sin_with_remat(x):
    cos_x = jnp.cos(x)

    def rem(x):
        return jnp.sin(x), lambda g: (g * cos_x,)

    return jnp.sin(x), rem

f_custom_closure = jax.remat(
    lambda x: sin_with_remat(sin_with_remat(x))
)
print(jax.grad(f_custom_closure)(1.0))
本文把原文反复使用的函数名 sin、f 改成局部更明确的名称,计算规则不变。自定义导数可能静默写错;即使静态上符合链式法则,也不能替代数值梯度核对和真实训练验证。本次没有执行这些检查。
递归检查点:减少随深度增长的残差
检查点可以嵌套:一个被检查点包裹的函数内部,再调用其他带检查点的函数。原文以多次正弦组成的链为例,在适当的递归结构下,残差内存增长可以从 O(D) 变成 O(log₂ D),代价是总 FLOPs 相比通常方案增加一个 O(log₂ D) 量级的因子。
def chain_compose(funs):
    def f(x):
        for fun in funs:
            x = fun(x)
        return x
    return f

f_chain = chain_compose([jnp.sin] * 8)
print_saved_residuals(f_chain, 3.)
f_chain = chain_compose([jnp.sin] * 16)
print_saved_residuals(f_chain, 3.)
普通链在原文中分别保存 8 个和 16 个余弦残差。原文递归函数的二函数分支写为 f1(f2(x)),大分支也先运行后半列表;由于演示全是同一个正弦,这不会暴露顺序问题。但若直接套到不同函数的列表,就与上面 for 循环的从左到右执行顺序不一致。
编者改写:下面保持列表顺序,先运行左半段,再运行右半段,并把重计算边界放在较早执行的左半段;另补空列表的恒等情况。这是静态分析后的示意修正,未执行等价性测试,不能把它误标成原文代码。
def recursive_checkpoint_in_order(funs):
    if not funs:
        return lambda x: x
    if len(funs) == 1:
        return funs[0]
    if len(funs) == 2:
        first, second = funs
        return lambda x: second(first(x))
    midpoint = len(funs) // 2
    left = recursive_checkpoint_in_order(funs[:midpoint])
    right = recursive_checkpoint_in_order(funs[midpoint:])
    return lambda x: right(jax.checkpoint(left)(x))

f_recursive = recursive_checkpoint_in_order([jnp.sin] * 8)
print_saved_residuals(f_recursive, 3.)
print_fwd_bwd(f_recursive, 3.)
原文同一正弦演示的递归版本在深度 8 时列出 4 个残差,深度 16 时列出 5 个;它的 jaxpr 将更多正弦/余弦运算放到反向的重计算区域里。这些计数描述的是那个玩具例子,不是任意模型的字节数,也不是上面改写版本的本次实测输出。实际张量大小、编译器优化和工作区分配都影响峰值。
在真实网络里,优先关注 scan 的层边界
当求导后的函数交给 XLA 编译,例如对包含 jax.grad 的函数使用 jax.jit,XLA 本身会优化值的计算和重计算时机,因此许多场景并不需要手动设置检查点。一个常见例外是 jax.lax.scan 等已展开到编译图中的控制流:编译器跨越前向 scan 与对应反向 scan 的优化往往不如直线代码充分。
大型 Transformer 常把层序列写成 scan,以降低编译耗时。用全连接网络打比方,原来的 Python 层循环如下:
LayerParam = tuple[jax.Array, jax.Array]
ParamsList = list[LayerParam]

def net_loop(params: ParamsList, x: jax.Array):
    for W, b in params:
        x = jnp.maximum(jnp.dot(x, W) + b, 0.)
    return x
当各层权重与偏置形状兼容,可以沿新轴堆叠,再让 scan 逐层消费:
params = [
    (jnp.array([[0.5, 0.5], [1., 1.]]), jnp.array([0.5, 0.5])),
    (jnp.array([[0.5, 0.5], [1., 1.]]), jnp.array([0.5, 0.5]))
]
all_weights = jnp.stack([W for W, _ in params])
all_biases = jnp.stack([b for _, b in params])

def scan_layer(x, W_b_pair):
    W, b = W_b_pair
    out = jnp.maximum(jnp.dot(x, W) + b, 0.)
    return out, None

def net_scan(all_weights, all_biases, x):
    x, _ = jax.lax.scan(scan_layer, x, (all_weights, all_biases))
    return x
scan 的 carry 形状与类型必须在每步保持一致,因而这不是任意异形层列表都能直接替换的写法。原文指出它可减少编译时间,却可能妨碍部分梯度优化。可以把检查点放到 scan 的 body 上,并只允许保存值得占用内存的预激活值:
@partial(
    jax.checkpoint,
    policy=jax.checkpoint_policies.save_only_these_names('preactivation')
)
def scan_layer(x, W_b_pair):
    W, b = W_b_pair
    pre = checkpoint_name(jnp.dot(x, W) + b, 'preactivation')
    out = jnp.maximum(pre, 0.)
    return out, None
这样你就在前向与反向之间显式表达了保存选择,而不是完全依赖编译器。实务上应先查看残差,再选择边界与策略,最后在目标版本和硬件上比较峰值内存、编译成本与每步耗时。本文完成的是源码与文档层面的审查,尚未运行这些性能比较。
原文链接:Gradient checkpointing with jax.checkpoint (jax.remat)。© Copyright 2024, The JAX Authors。翻译转载与配图依据另行授权;保留原作者及版权署名。图与标注为编者新增,不暗示 JAX 项目对改写代码作过验证。










暂无评论内容