


用 Dask 重叠分块完成邻域计算
原文:Dask documentation contributors / Dask Developers。译自 Overlapping Computations,依据 2026 年 10 月 5 日读取的 stable 文档翻译整理。原页 © Copyright 2026。
有些数组运算不能只看当前分块。例如,在图像上做卷积,求滑动窗口的和、均值或最大值,寻找可能横跨分块边界的高斯斑点,计算偏导数,或运行“生命游戏”,都需要相邻块之间交换边缘数据。
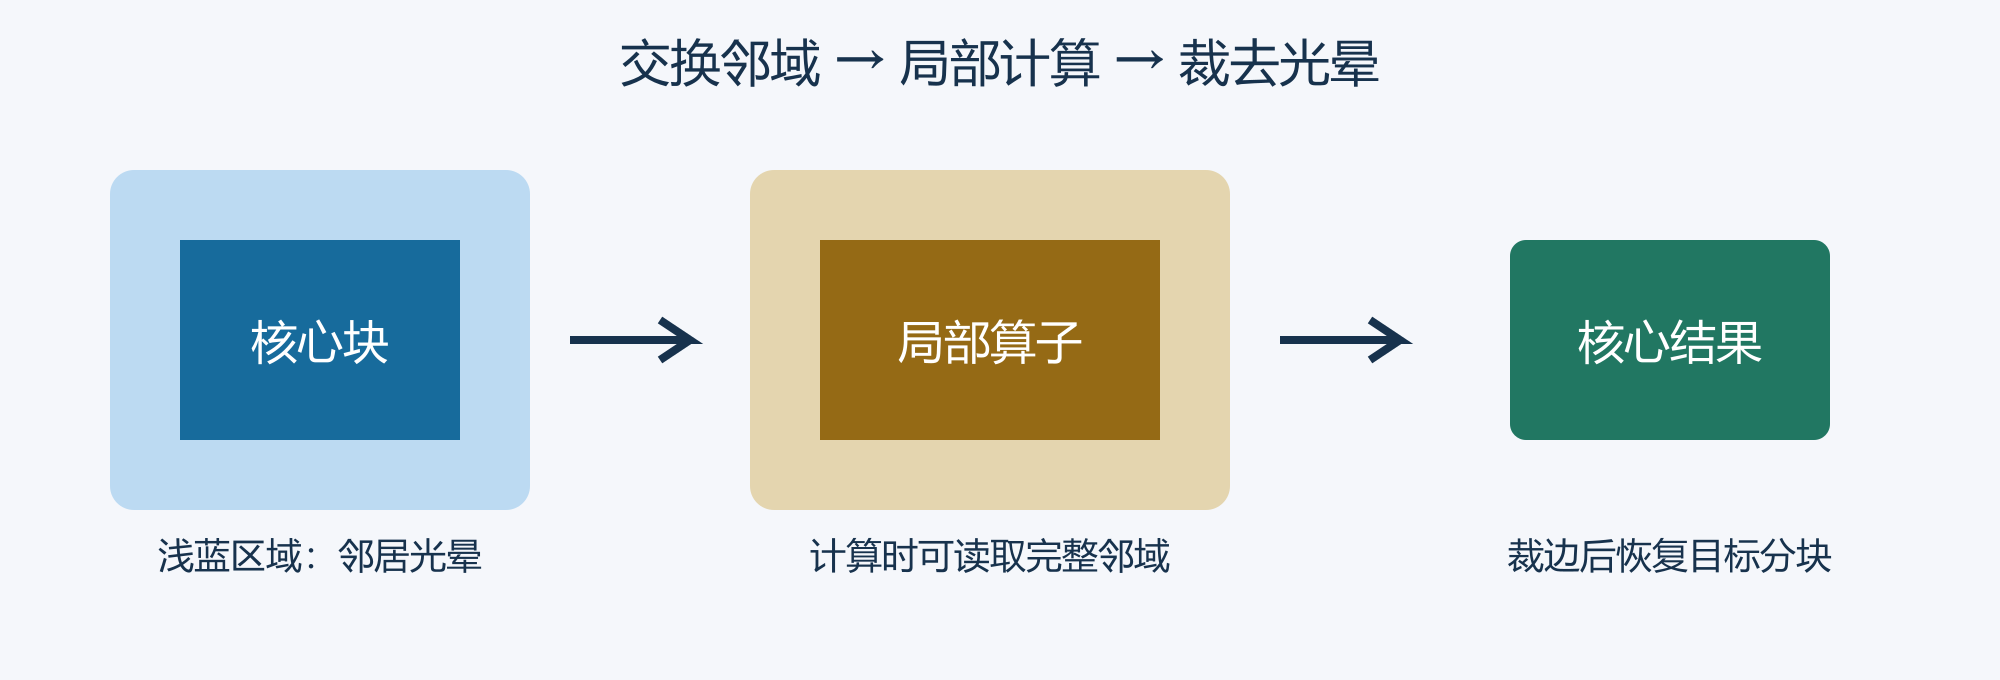
Dask Array 的做法是,把每个块稍微扩展一圈,将邻居的边缘复制进来,再让局部函数独立计算。代价是额外的数据复制以及许多小块的通信;好处是获得邻域以后,各块上的计算便可以高度并行地进行。
从 map_overlap 开始
最常用的入口是 map_overlap。它先共享相邻区域,再映射函数,最后裁去多余边缘。如果某一轴上的重叠深度大于块大小,Dask 会在允许的情况下重新分块。
dask.array.map_overlap(
    func, *args, depth=None, boundary=None, trim=True,
    align_arrays=True, allow_rechunk=True, **kwargs
)
func 接收扩展后的块;有多个输入数组时,参数顺序与 args 一致。Dask 会在真正计算前尝试推断输出数组类型,如果函数不能处理用于推断的零维输入,应显式传入 meta。其余关键字可以使用 map_blocks 支持的参数。
| 参数 | 含义与限制 |
|---|---|
depth |
默认 0。整数表示各轴共同的共享宽度;元组或字典可分别设置各轴;列表可分别设置多个输入数组。字典的值可用 (左侧深度, 右侧深度) 表示非对称重叠,目前只有 boundary='none' 支持这种情况。 |
boundary |
支持 'reflect'、'periodic'、'nearest'、'none',也可填充常数,如 0 或 np.nan。元组或字典按轴设置,列表按输入数组设置。 |
trim |
默认 True,函数返回后裁去每块的 depth 个边缘元素。若函数已经自行裁边,应设为 False。 |
align_arrays |
默认 True,使多个数组在长度相同的维度上采用兼容分块,必要时把较大块拆成小块。设为 False 时,各维块数不兼容会报错。 |
allow_rechunk |
默认 True,允许内部重新分块。禁用时,输入必须已满足相应块大小及核心维度要求。 |
编辑说明:depth、boundary 等是关键字参数。原文部分旧示例使用位置传参,本文统一写成显式关键字,避免不同调用接口下的歧义。
一维差分:跨块边界仍然连续
import numpy as np
import dask.array as da

x = da.from_array(np.array([1, 1, 2, 3, 3, 3, 2, 1, 1]), chunks=5)

def derivative(block):
    return block - np.roll(block, 1)

y = x.map_overlap(derivative, depth=1, boundary=0)
y.compute()
# 原文输出:
# array([1, 0, 1, 1, 0, 0, -1, -1, 0])
函数计算当前位置与前一位置的差。分块边界处的前一个元素由重叠区域提供;整个数组最左侧使用常数 0,因而第一个结果是 1。np.roll 对块本身的回卷影响落在最终被裁掉的辅助边缘中。
二维边界与扩展块大小
x = np.arange(16).reshape((4, 4))
d = da.from_array(x, chunks=(2, 2))
d.map_overlap(lambda block: block + block.size,
              depth=1, boundary="reflect").compute()
# array([[16, 17, 18, 19],
#        [20, 21, 22, 23],
#        [24, 25, 26, 27],
#        [28, 29, 30, 31]])
每个 2×2 核心块在两个方向各扩展一格后成为 4×4,函数看到的 block.size 为 16。裁边后,整个结果相当于原数组每项加 16。
func = lambda block: block + block.size
depth = {0: 1, 1: 1}
boundary = {0: "reflect", 1: "none"}
d.map_overlap(func, depth=depth, boundary=boundary).compute()
# array([[12, 13, 14, 15],
#        [16, 17, 18, 19],
#        [20, 21, 22, 23],
#        [24, 25, 26, 27]])
第二轴外边界不填充,因此这个特定的 2×2 分块布局中,函数看到的是 4×3 块,增加的是 12。'none' 仅表示不在全局边界补值,内部相邻块仍会交换数据。
多个数组:广播与分块对齐
func = lambda a, b: a + b
x = da.arange(8).reshape(2, 4).rechunk((1, 2))
y = da.arange(4).rechunk(2)
da.map_overlap(func, x, y, depth=1, boundary="reflect").compute()
# array([[0, 2, 4, 6],
#        [4, 6, 8, 10]])
输入不一定具有相同维数,但必须能够广播。函数按块取得输入,所以对应块还必须兼容。默认的 align_arrays=True 会自动寻找共同的分块方案。
x = da.arange(8, chunks=4)
y = da.arange(8, chunks=2)
r = da.map_overlap(func, x, y, depth=1,
                   boundary="reflect", align_arrays=True)
len(r.to_delayed())  # 原文结果:4

# 禁用对齐时,这个例子报错:
da.map_overlap(func, x, y, depth=1,
               boundary="reflect", align_arrays=False).compute()
# ValueError: Shapes do not align {'.0': {2, 4}}
自动对齐和自动重新分块是便利机制,也可能增加任务数量、通信和中间内存,不能只根据原来的 chunks 估算运行成本。
默认深度为零;归约会看见重叠值
只设置边界模式不会产生光晕,必须给出非零 depth。默认情况下,map_overlap 等同于普通的 map_blocks。下面是一个独立的归约示例:
func = lambda block: block.sum()
x = da.ones(10, dtype="int")
block_args = dict(chunks=(), drop_axis=0)
da.map_blocks(func, x, **block_args).compute()  # 原文:10
da.map_overlap(func, x, **block_args,
               boundary="reflect").compute()  # 原文:10
da.map_overlap(func, x, **block_args, depth=1,
               boundary="reflect").compute()  # 原文:12
最后一次调用先把两侧各扩展一个 1,再求和,故结果为 12。不能把给归约函数增加光晕理解为自动去重求和。
用 meta 明确输出类型
有些函数会读取某个位置,例如 block[2]。它对实际扩展块是合法的,却可能在 Dask 用零维样本推断元数据时触发 IndexError。原文以 meta=np.array(()) 展示显式元数据;它产生的元数据类型是浮点数,而输入示例是整数。下面的整理版同时明确了预期的二维整数输出类型:
x = np.arange(16).reshape((4, 4))
d = da.from_array(x, chunks=(2, 2))
y = d.map_overlap(
    lambda block: block + block[2],
    depth=1, boundary="reflect",
    meta=np.empty((0, 0), dtype=x.dtype)
)
y.compute()
# 原文的数值输出:
# array([[4, 6, 8, 10],
#        [8, 10, 12, 14],
#        [20, 22, 24, 26],
#        [24, 26, 28, 30]])
对于非 NumPy 数组,meta 也应使用相应后端。例如原文还给出了 CuPy 版本;下面同样将元数据写成与输入 dtype 一致的空二维数组。该片段需要适用的 CuPy/GPU 环境。
import cupy

x = cupy.arange(16).reshape((4, 4))
d = da.from_array(x, chunks=(2, 2))
y = d.map_overlap(
    lambda block: block + block[2],
    depth=1, boundary="reflect",
    meta=cupy.empty((0, 0), dtype=x.dtype)
)
# 原文展示的数值结果与 NumPy 示例相同。
拆开观察:交换边缘、映射、裁剪
两个相邻块不仅交换上下左右的薄片;在多维计算中,对角线方向的数据也会参与扩展。原文下面的例子将 8×8 数组分为四个 4×4 块:
x = np.arange(64).reshape((8, 8))
d = da.from_array(x, chunks=(4, 4))
d.chunks  # ((4, 4), (4, 4))

g = da.overlap.overlap(
    d, depth={0: 2, 1: 1}, boundary={0: 100, 1: "reflect"}
)
g.chunks  # ((8, 8), (6, 6))
第一轴各补两行,第二轴各补一列,每个块从 4×4 扩为 8×6。第一轴的全局外侧填充 100;第二轴的全局外侧反射边缘。将所有扩展块按块拼起来,原文得到:
[[100 100 100 100 100 100 100 100 100 100 100 100]
 [100 100 100 100 100 100 100 100 100 100 100 100]
 [  0   0   1   2   3   4   3   4   5   6   7   7]
 [  8   8   9  10  11  12  11  12  13  14  15  15]
 [ 16  16  17  18  19  20  19  20  21  22  23  23]
 [ 24  24  25  26  27  28  27  28  29  30  31  31]
 [ 32  32  33  34  35  36  35  36  37  38  39  39]
 [ 40  40  41  42  43  44  43  44  45  46  47  47]
 [ 16  16  17  18  19  20  19  20  21  22  23  23]
 [ 24  24  25  26  27  28  27  28  29  30  31  31]
 [ 32  32  33  34  35  36  35  36  37  38  39  39]
 [ 40  40  41  42  43  44  43  44  45  46  47  47]
 [ 48  48  49  50  51  52  51  52  53  54  55  55]
 [ 56  56  57  58  59  60  59  60  61  62  63  63]
 [100 100 100 100 100 100 100 100 100 100 100 100]
 [100 100 100 100 100 100 100 100 100 100 100 100]]
边界策略应与问题一致
periodic 把一端连接到另一端;reflect 将边缘向外镜像;常数值则用指定数填充。不同轴可以选择不同策略,例如:
boundary = {0: "periodic", 1: "reflect", 2: np.nan}需要其他填充方法时,可考虑 dask.array.pad。边界条件是数学问题的一部分:周期边界和零填充通常代表不同的假设,而不是单纯的性能选项。
在扩展块上运行局部函数
扩展后的块携带原本存放在邻居处的数据,可以交给 SciPy 等库处理。原文用高斯滤波说明这个接口:
from scipy.ndimage import gaussian_filter

def func(block):
    return gaussian_filter(block, sigma=1)

filt = g.map_blocks(func)光晕深度提示:这是接口演示,不足以证明与整幅图像滤波相同。前面 g 的深度是两行、一列;gaussian_filter 的默认 truncate=4 配合 sigma=1,通常需要覆盖约四个元素的作用半径。复用时应按算子实际半径设置各轴深度,并一致处理全局边界,然后与小规模整数组结果核对。本文未执行这项对照。
这里也可以换成任意局部函数,或用 Numba 编译的函数。若函数改变块形状,需要给 map_blocks 传入 chunks:规则大小可写 (1000, 1000),不规则大小则需要完整结构,如 ((1000, 700, 1000), (200, 300))。原文的 g.map_blocks(myfunc, chunks=(5, 5)) 是调用形式示意,myfunc 需由读者自行定义。
若函数需要知道正在处理哪个块,可增加 block_id=None 参数。Dask 会传入块坐标元组,左上角是 (0, 0),其右侧是 (0, 1)。
def func(block, block_id=None):
    # 在这里使用 block_id 实现位置相关的处理。
    ...
裁去多余区域
局部函数运行后,通常需要裁去与扩展深度相同的边缘。底层函数 trim_internal 接收相同的深度配置。原文给出的独立例子是:某个数组 x 的各轴分块均为 (10, 10, 10, 10),调用后第一轴各块变为 6,第二轴各块变为 8。
# 独立示例:这里的 x 不是前面 np.arange(64) 创建的 NumPy 数组。
# x.chunks == ((10, 10, 10, 10), (10, 10, 10, 10))
y = da.overlap.trim_internal(x, {0: 2, 1: 1})
# y.chunks == ((6, 6, 6, 6), (8, 8, 8, 8))
典型的完整流程依次调用 overlap、map_blocks、trim_internal。下面仍是原文的结构示意,x 和 myfunc 需要先根据具体任务定义:
g = da.overlap.overlap(
    x, depth={0: 2, 1: 2},
    boundary={0: "periodic", 1: "periodic"}
)
g2 = g.map_blocks(myfunc)
result = da.overlap.trim_internal(g2, {0: 2, 1: 2})
理解底层三步有助于核对形状和边界;多数实际任务可以直接使用 map_overlap。选择光晕宽度时,先满足算子的真实依赖范围,再考虑块大小与通信成本。










暂无评论内容