


Dask Parquet 读写与 Hive 分区布局
原文:Dask documentation contributors / Dask Developers。本文合并翻译整理 Dask Dataframe and Parquet 与 Using Hive Partitioning with Dask,依据 2026 年 10 月 5 日的 stable 文档。原页 © Copyright 2026。
Parquet 是为高效存储和读取设计的列式文件格式。Dask DataFrame 使用 read_parquet() 读取它,使用 to_parquet() 写出它;两者都需要安装 pyarrow。要合理组织大数据集,至少要区分四件事:磁盘文件、文件内部的行组、Dask 的计算分区,以及按字段值生成的 Hive 目录。
下面的片段分别说明各个接口,不是一份从头运行到底的脚本。df 代表已存在的 Dask DataFrame,示例路径需要换成具有相应读写权限的真实位置。
读取一个文件或一组文件
read_parquet 的第一个参数可以是单个文件路径、包含 .parquet 或 .parq 文件的目录、能展开为一个或多个文件的 glob 字符串,或文件路径列表。加上协议前缀后,也可以读取 S3、GCS 等远程文件系统。
import dask.dataframe as dd

df = dd.read_parquet("path/to/mydata.parquet")
df = dd.read_parquet("path/to/my/parquet/")
df = dd.read_parquet("s3://bucket-name/my/parquet/")
远程文件系统可能要求凭据。原文建议尽量通过 Dask 之外的配置文件或环境变量管理,例如 AWS 凭据文件;也可以用 storage_options 将参数传给 fsspec 后端。
df = dd.read_parquet(
    "s3://bucket-name/my/parquet/",
    storage_options={"anon": True}
)
这里的 anon=True 会传给 s3fs.S3FileSystem,只适用于确实允许匿名读取的位置。它不是取得访问权限的方法,也不适合作为私有存储的默认配置。
元数据:减少请求,也可能成为集中瓶颈
读取多文件数据集前,Dask 会先加载元数据,了解数据集 schema、文件划分和每个文件内部的行组。部分数据集包含全局 _metadata 文件,将各文件的元数据汇总到一个位置。
对小型和中型数据集,这样无需逐个读取所有文件的一部分就能取得行组信息。Dask 可以据此把大文件切成较小的内存分区,或把多个小文件合并成较大的分区。然而,数据集很大时,_metadata 自身也可能大到单个执行端无法解析。此时可跳过它:
df = dd.read_parquet(
    "s3://bucket-name/my/parquet/",
    ignore_metadata_file=True
)
跳过汇总文件不等于消除元数据工作,只是改用其他读取路径。需要拆行组或求索引边界时,仍可能需要读取大量文件 footer。
分区大小取决于内存中的数据
默认情况下,Dask 根据数据集中第一个 Parquet 文件的元数据,推断是否适合让每个文件对应一个 DataFrame 分区。若 Parquet 数据的未压缩大小超过 blocksize,默认 256 MiB,一个分区会改为对应若干行组,而不是整个文件。
原文建议尽量让文件载入 pandas 后的内存大小落在 100–300 MiB,并相应设置 blocksize。过大的分区会让单个 worker 承受过高内存压力;过小的分区则可能让调度开销超过有效计算。这个范围是调优起点,不能直接拿压缩后文件大小代替。
如果大文件需要被分成多个行组范围,而数据集没有 _metadata,Dask 就需要预先读取所有相关 footer。已知文件很大时,可指定 split_row_groups="adaptive",让 Dask 尝试将每个分区控制在 blocksize 之下。但一个行组本身过大时,结果仍可能超出限制;blocksize 不是任意切开单个行组的硬性保证。
只读需要的列
不需要全部字段时,通过 columns 明确选择列,可以同时减少文件系统读取量和内存占用。
df = dd.read_parquet(
    "s3://path/to/myparquet/",
    columns=["a", "b", "c"]
)
何时计算 divisions
默认的 read_parquet 不会生成具有已知 divisions 的集合。设置 calculate_divisions=True 后,Dask 会在构建任务图时,利用各文件 footer 或全局 _metadata 中的行组统计计算索引边界。缺少必要统计或无法检测索引列时,仍不会得到已知 divisions。
df = dd.read_parquet(
    "s3://path/to/myparquet/",
    index="timestamp",
    calculate_divisions=True
)
显式指定 index 是让目标字段作为索引的可靠方法。计算 divisions 不需要读取实际行数据,却需要加载、处理每个行组的元数据。大型数据集没有全局 _metadata 时,应谨慎使用这一选项,尤其是在远程存储上。相关概念见 Dask DataFrame 的内部设计。
写出:从计算分区到文件
函数和方法形式的 to_parquet 都可以使用目录作为输出位置,也支持带协议的远程路径。
df.to_parquet("path/to/my/parquet/")
df.to_parquet("s3://bucket-name/my/parquet/")
远程写出同样需要权限,可以使用外部凭据配置,也可以通过 storage_options 传递后端设置。原文展示了 storage_options={"anon": True} 的写入形式;只有存储服务确实允许匿名写入时该设置才有意义,不能据此让私有存储匿名化。
未启用 Hive 分区时,通常每个 Dask DataFrame 分区写成一个文件。为方便后续消费,原文同样建议每个计算分区的内存大小约为 100–300 MiB。可用 DataFrame.memory_usage_per_partition() 检查当前布局。
是否写全局元数据
设置 write_metadata_file=True 会把各文件的行组元数据汇总为全局 _metadata。它可能加速后续读取,但汇总过程在大规模数据上也可能占用过多内存,甚至导致 worker 被终止。因此原文只建议在小型至中型数据集上启用。
df.to_parquet(
    "s3://bucket-name/my/parquet/",
    write_metadata_file=True
)
文件名必须保持分区顺序
默认文件名形如 part.0.parquet、part.1.parquet。name_function 接受一个分区索引,返回对应文件名;返回名称的排序必须与分区索引顺序一致。
df.to_parquet(
    "path/to/output",
    name_function=lambda i: f"data-{i:06d}.parquet"
)
# 例如:data-000000.parquet、data-000001.parquet、data-000002.parquet编辑说明:原文的 f"data-{i}.parquet" 只展示了三个分区。分区数变多后,字符串排序会把 data-10 排在 data-2 前面,本文补零以保持次序;位数应足以覆盖实际分区数。原文写入路径与随后列目录的路径不一致,本文也统一了示例路径。
Hive 目录:让字段值成为路径的一部分
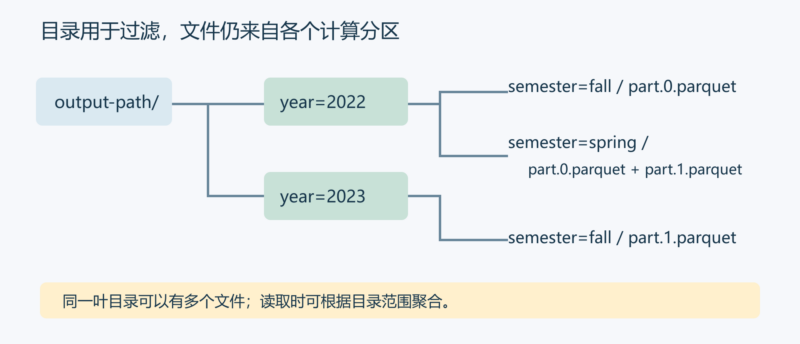
如果 DataFrame 包含 year 和 semester,Hive 风格布局可以写成:
output-path/
├── year=2022/
│   ├── semester=fall/
│   │   └── part.0.parquet
│   └── semester=spring/
│       ├── part.0.parquet
│       └── part.1.parquet
└── year=2023/
    └── semester=fall/
└── part.1.parquet目录自身描述了数据:year=2022/semester=fall/ 下所有行的年份都是 2022,学期都是 fall。其主要优势是部分过滤条件可直接根据目录判断,无需先解析每个文件的元数据。例如,按年份分区后,下面的过滤通常更快:
dd.read_parquet("output-path", filters=[("year", ">", 2022)])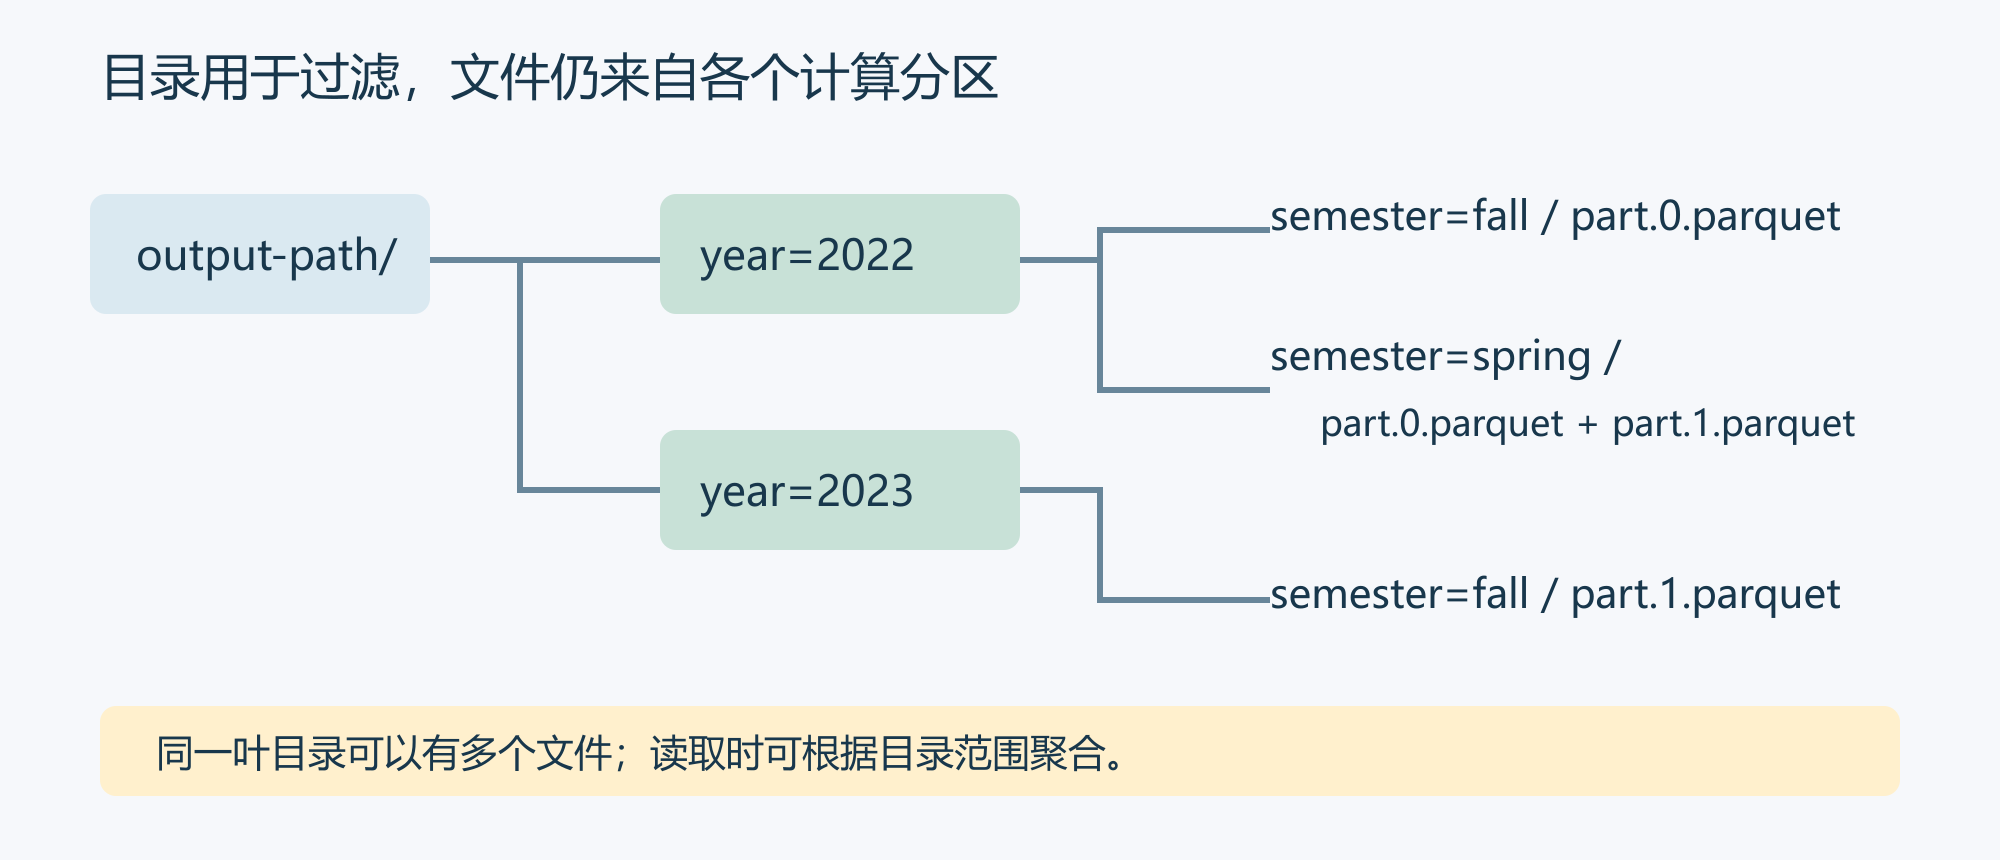
写 Hive 分区不会自动合并同目录文件
df.to_parquet("output-path", partition_on=["year", "semester"])指定 partition_on 后,Dask 自动创建相应目录。这个过程仍由各个 DataFrame 分区独立完成:第 i 个写任务先按 ["year", "semester"] 分组,再把每组写到相应目录中的 part.{i}.parquet。因此,同一叶目录可能得到来自很多计算分区的文件。
如果应用确实要求每个 Hive 分区只有一个文件,可在写出前按分区字段排序或 shuffle:
partition_on = ["year", "semester"]
df.shuffle(on=partition_on).to_parquet(
    "output-path",
    partition_on=partition_on
)编辑说明:原文这行 to_parquet 漏写了必需的输出路径,本文补为 "output-path"。全局 shuffle 的代价很高,应尽量避免;它能把同一组的数据汇集起来,使叶目录内文件数最少,但是否值得应由下游需求决定。
读取 Hive 分区与字段类型
大多数情况下,read_parquet 会自动识别 Hive 分区,默认把目录中的分区字段解释为具有已知类别的 categorical 列。
ddf = dd.read_parquet("output-path", columns=["year", "semester"])原文示例得到 4 个计算分区,year、semester 都是 category[known]。计算后共有 8 行:3 行 2022/fall、3 行 2022/spring、2 行 2023/fall。这同时说明:Hive 目录层级、字段类型和 Dask 分区数是不同的概念。
如果想用明确类型,而不是 categorical,可以给分区列指定 schema:
import pyarrow as pa

schema = pa.schema([
    ("year", pa.int16()),
    ("semester", pa.string()),
])
ddf2 = dd.read_parquet(
    "output-path",
    columns=["year", "semester"],
    dataset={"partitioning": {"flavor": "hive", "schema": schema}}
)
原文显示年份为 int16,学期为字符串对应的对象列;具体 DataFrame 字符串显示形式可能随 Dask/pandas 配置变化。若 Hive 分区列包含 null,原文要求使用这种明确 schema 的方式。高基数字段也建议显式指定类型,因为默认的 categorical 会维护已知类别,明显增加集合的内存占用;Dask 对其他列清除已知类别信息,也是出于类似考虑。
避免高基数和难解析的目录值
Hive 分区有时能减少读取,有时却会降低性能甚至造成错误。通常不要按浮点列或唯一值极多的列分区。一个字段有数百万种值,就可能生成数百万个目录;文件系统管理压力和目录中的小文件会叠加。
目录值是字符串,尽量选择整数或字符串等简单类型。复杂类型若无法从目录名可靠推断,IO 引擎便可能解析失败。例如直接按 datetime64 分区,可能生成 date=2022-01-01 00:00:00/。它未必能被恢复为正确的日期类型,其中的冒号在 Windows 文件名中也不合法。更可靠的方法是根据需要拆成 year、month、day 等简单字段。
在读取时聚合小文件
Hive 布局常常制造许多小文件。aggregate_files 可以允许读取器把多个文件合成一个 DataFrame 分区,从而更接近 blocksize 指定的目标大小。原文将该参数标为实验性,同时说明当时并无删除它或改变其行为的计划;使用时仍需核对实际版本。
dataset-path/
├── region=1/
│   ├── section=a/
│   │   ├── 01.parquet
│   │   ├── 02.parquet
│   │   └── 03.parquet
│   └── section=b/
│       ├── 04.parquet
│       └── 05.parquet
└── region=2/
    └── section=a/
        ├── 06.parquet
        ├── 07.parquet
        └── 08.parquet
设置 aggregate_files=True 时,任意这些文件都可以被合并到同一输出计算分区。设置为分区列名,则只允许合并到该目录层为止具有共同路径前缀的文件。
| 设置 | 在上例中允许的合并 |
|---|---|
"section" |
04 与 05 可以合并;03 与 04 不可以。不同 region 下同名 section 也不是同一完整路径。 |
"region" |
04 与 05 可以合并;03 与 04 也可以,因为都位于 region=1 下。 |
True |
不受上述目录层限制,仍由读取器结合分区大小决定具体聚合。 |
默认读取可能得到远小于 blocksize 的大量分区,合理聚合通常可以缓解这一点。最终布局应同时服务于过滤需求、元数据成本、内存大小及后续计算,而不是只追求更少的文件或更多的目录。










暂无评论内容