


从二乘二列联表估计优势比与置信区间
原文:SciPy 文档贡献者。译自 Odds ratio for a contingency table,SciPy v1.18.0 官方教程,读取日期为 2026 年 10 月 5 日。原页未单独署名,保留版权标识:© Copyright 2008, The SciPy community。
二乘二列联表可以用来比较两个组中事件发生的相对优势。除了给出一个点估计,我们还需要置信区间,判断估计的不确定性,以及它是否包含“优势相同”的参考值 1。
用四个计数描述研究结果
Berger 等人在 2006 年发表的一项研究中,考察了阿司匹林用于男女心血管事件一级预防的效果。原教程转述其结论:女性总体心血管事件风险的降低,与缺血性卒中风险降低有关。该论文列出了多类心血管事件,教程只选取女性缺血性卒中的数据。
研究中的参与者连续数年规律服用阿司匹林或安慰剂,并记录缺血性卒中。教程给出的汇总表如下:
| 结果 | 阿司匹林组 | 对照/安慰剂组 |
|---|---|---|
| 发生缺血性卒中 | 176 | 230 |
| 未发生卒中 | 21035 | 21018 |
教程提出的问题是:这些数据是否为阿司匹林与缺血性卒中减少之间的关联提供证据?以下内容用于演示统计估计,不能从这张历史表格直接推导个人用药建议。
计算条件优势比
把表格按上述行列顺序传给 scipy.stats.contingency.odds_ratio:
from scipy.stats.contingency import odds_ratio

res = odds_ratio([[176, 230], [21035, 21018]])
res.statistic
原文给出的输出是:
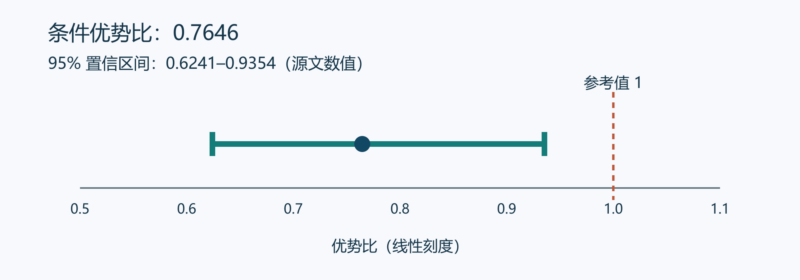
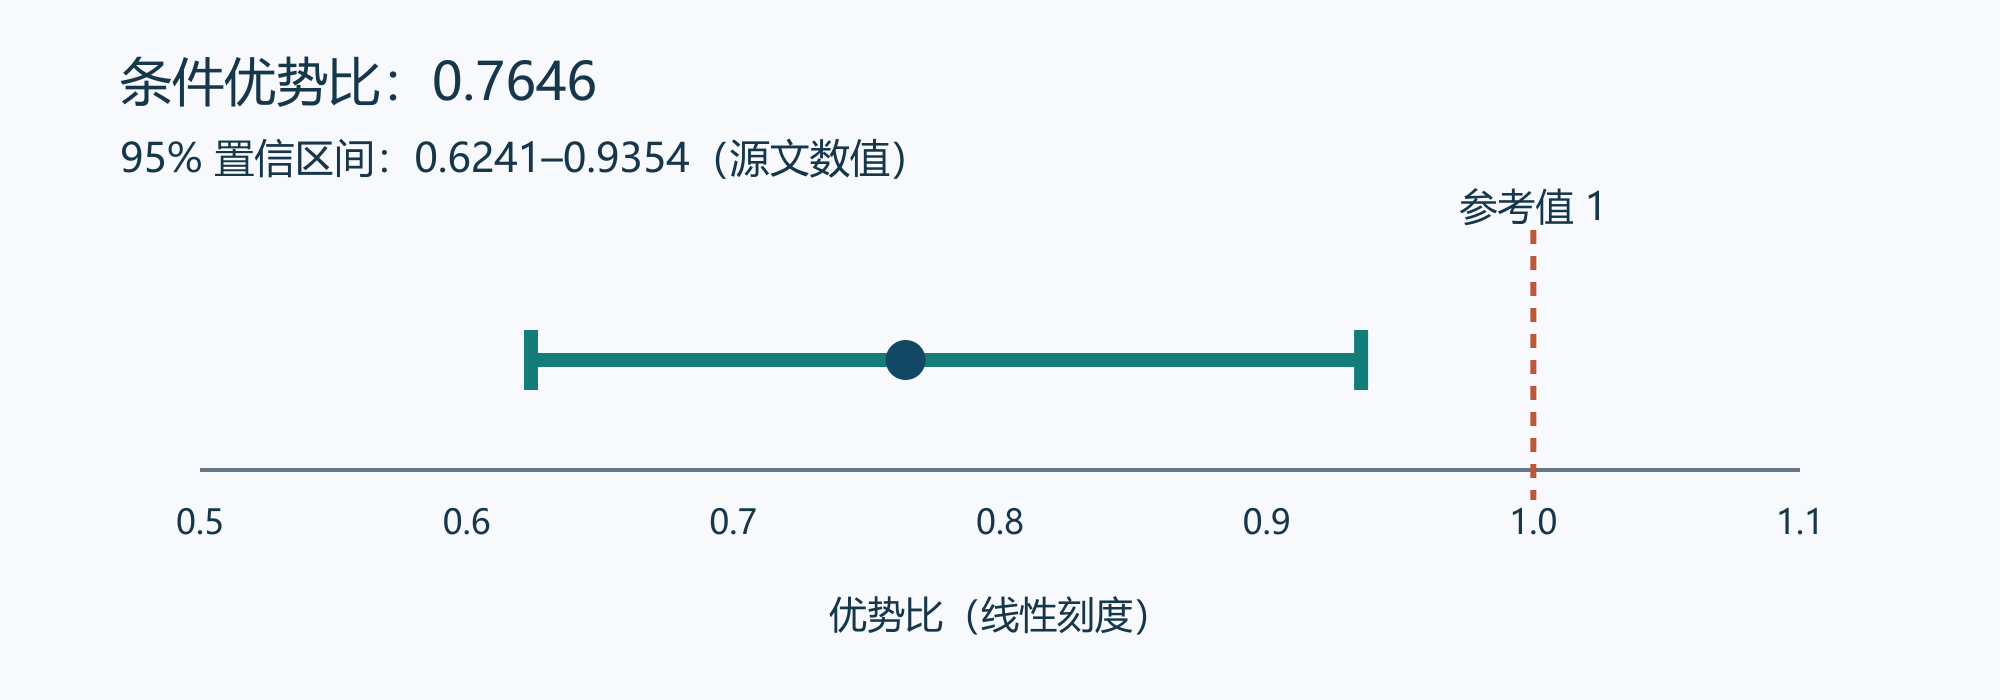
0.7646037659999126按这个点估计,阿司匹林组发生缺血性卒中的优势约为安慰剂组的 0.76 倍。这里比较的是“发生事件”相对于“不发生事件”的优势,即 odds,而不是直接比较发生概率。
编辑说明:根据 SciPy 的 API 文档,默认参数是 kind="conditional",返回条件最大似然优势比估计。若明确选择 kind="sample",则得到常见的样本交叉乘积估计。对于行列为 [[a, b], [c, d]] 的表,样本优势比为 (a / c) / (b / d),也就是 a*d/(b*c)。本文保留教程默认的条件估计,不把两种结果混为一谈。
行列标签决定解释方向。只交换两行或只交换两列,会把优势比变成倒数;因此,不能只复制数字而丢掉表头。
计算 95% 置信区间
为对研究所针对的总体进行统计推断,可以继续调用结果对象的 confidence_interval 方法:
res.confidence_interval(confidence_level=0.95)原文输出如下:
ConfidenceInterval(
    low=0.6241234078749812,
    high=0.9354102892100372
)
因此,条件优势比的 95% 置信区间约为 (0.62, 0.94)。整个区间都低于 1,支持原研究中阿司匹林与缺血性卒中发生减少存在统计显著关联的结论。
不要把优势比读成风险下降比例
编辑说明:风险是事件人数除以组内总人数;优势则是事件人数除以非事件人数。因而,“优势约为对照组的 0.76 倍”不等于“风险下降 24%”,更不等于绝对风险下降 24 个百分点。优势比也不能代替对研究设计、适用人群和其他结局的判断。
点估计描述关联的方向和量级,置信区间描述估计中的统计不确定性。区间低于 1 的解释建立在所用统计模型及研究数据条件之上;这张表本身不提供现代临床决策所需的完整信息。
参考文献
Berger, Jeffrey S. et al. (2006). Aspirin for the Primary Prevention of Cardiovascular Events in Women and Men: A Sex-Specific Meta-analysis of Randomized Controlled Trials. JAMA, 295(3):306–313. DOI: 10.1001/jama.295.3.306。










暂无评论内容