


用 ES|QL 查询动态 JSON:flattened 的建模方式、执行路径与限制
一个日志索引里的主机名、时间戳和状态码通常比较稳定,业务团队自行增加的属性却可能每天变化。如果让每个新属性都成为独立映射字段,字段数量就可能失控;如果把整个对象仅当字符串保存,查询又会变得笨重。flattened 提供了介于两者之间的选择:把开放的属性集合纳入一个映射字段,在需要时再取出具体键值。
本文为中文技术整理,参考 Jordan Powers、Dima Leontyev 于 2026 年 8 月 18 日发表的 Elastic Search Labs 原文及官方函数、映射文档。以下围绕独立示例重新说明建模与查询决策,保留原文涉及的存储机制和限制,并补充文档差异;不是逐句译文。
从一个小型属性袋开始
假设一条事件同时带有部署地域、应用实例和重试次数。我们将属性袋命名为 attrs,以便与核心业务字段区分。下面的索引名专用于示例;若在真实环境复现,必须先确认目标集群与索引名,创建和写入操作都会改变数据。
PUT wwj_flattened_demo
{
  "mappings": {
    "properties": {
      "attrs": { "type": "flattened" }
    }
  }
}

POST wwj_flattened_demo/_doc?refresh=wait_for
{
  "attrs": {
    "zone": "az-a",
    "app": { "instance": "worker-03" },
    "attempts": 12,
    "flags": ["blue", "batch"]
  }
}
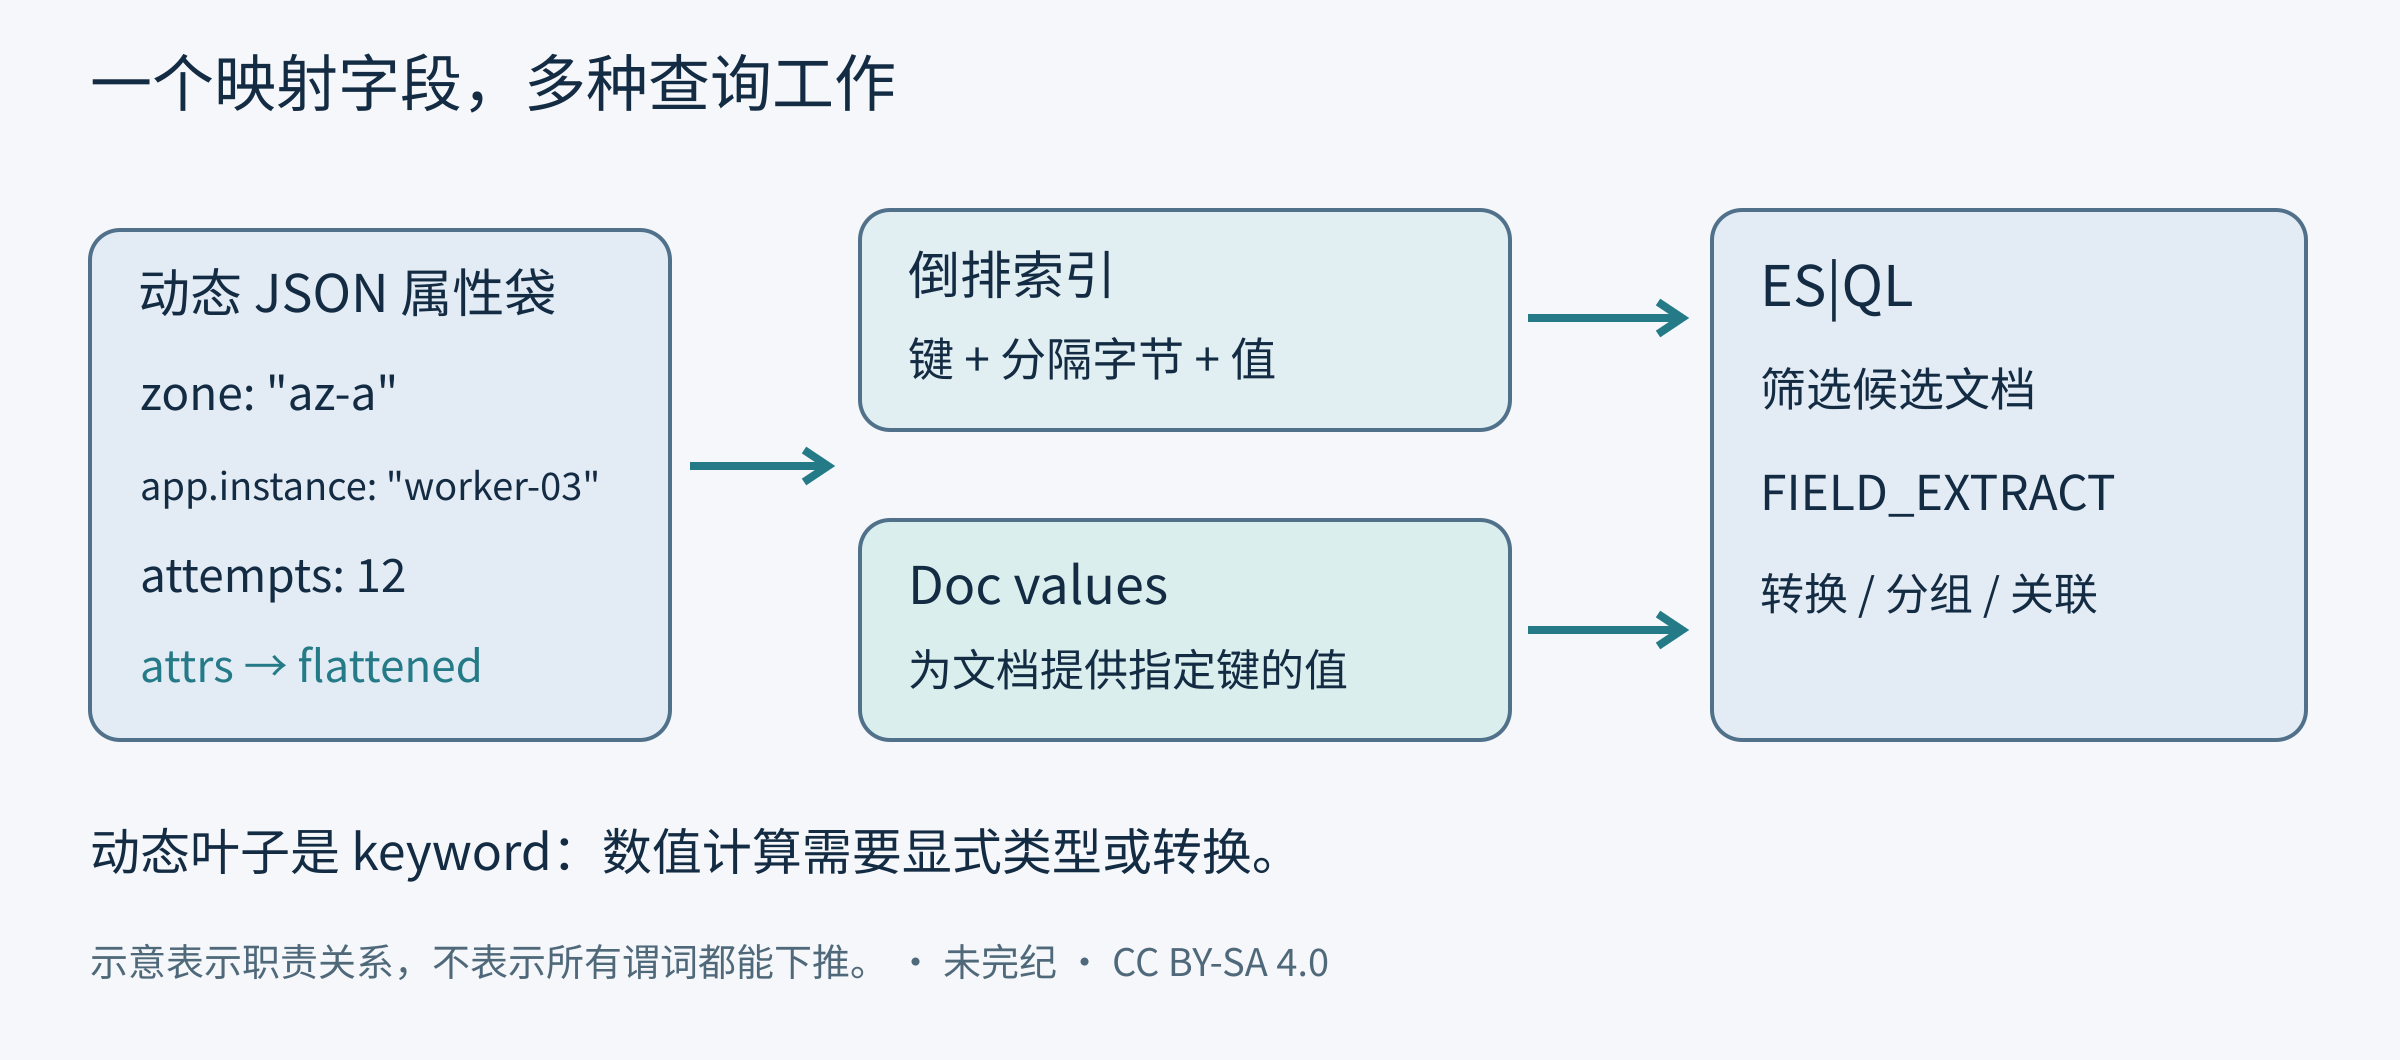
新出现的键不会为 attrs 的每个叶子分别增加普通映射字段。但“不增加字段”不等于“没有成本”:属性和值仍需被解析、存储、压缩和查询;如果每条记录携带大量随机键值,数据体积和读取开销依然可能很大。写入示例的 refresh=wait_for 会等待一次常规刷新,让后续查询能看到该文档;它不会强制立即刷新,参见 Elasticsearch 的refresh 参数说明。这个区分有助于避免把解决映射膨胀误解为解决一切高基数问题。
动态叶子使用 keyword 语义。JSON 数字 12 在这里按字符串值处理,布尔值也类似;动态属性不会自动得到 long、date 或 boolean 字段的运算能力。稳定且经常参与数值计算的核心字段,通常值得从一开始就明确类型。flattened 映射参考还列出了默认嵌套深度限制 20,以及不支持 multi-fields 和 copy_to 等边界。
取出叶子,再决定如何计算
在 ES|QL 中,根字段是一个 flattened 列。读取整个根可以得到 JSON 表示,但对具体属性计算时,应使用 FIELD_EXTRACT。它的第二个参数是叶子的字面键名;原 JSON 中的嵌套对象已经在写入时形成带点的键。
FROM wwj_flattened_demo
| EVAL zone = FIELD_EXTRACT(attrs, "zone"),
       instance = FIELD_EXTRACT(attrs, "app.instance"),
       attempts_text = FIELD_EXTRACT(attrs, "attempts")
| KEEP zone, instance, attempts_text
这里 "app.instance" 对应一个完整键,并不是查询执行时先取 app 再遍历 instance。请求 "app" 没有对应的标量叶子,因此返回 null;大小写不同的键、缺失键也不会意外匹配到其他属性。方括号和数组下标语法不受支持,例如 "flags[0]" 不是选取第一个标签的写法。数组叶子会形成多值 keyword。以上规则以 FIELD_EXTRACT 官方定义为准。
如果只想统计各地域的事件数量,取出属性后即可使用普通 ES|QL 管道:
FROM wwj_flattened_demo
| EVAL zone = FIELD_EXTRACT(attrs, "zone")
| STATS events = COUNT(*) BY zone
| SORT zone
要按重试次数比较大小,则应先决定数值范围,再显式转换。对于这里的小整数,可以使用:
FROM wwj_flattened_demo
| EVAL attempts = TO_INTEGER(FIELD_EXTRACT(attrs, "attempts"))
| WHERE attempts > 10
| KEEP attempts
这是本文增加的类型对照示例。若直接比较 "9" > "10",比较的是字符次序,结果会与整数比较相反。转换也不应被当作数据质量修复器:异常文本、超出 integer 范围的值和多值数据需要单独考虑;官方 TO_INTEGER 文档说明无法转换的值可产生 null 与警告。对生产报表,应检查警告和缺失值,而不是仅看查询是否返回了行。
提取出的列还可以作为排序列、分组列或关联键。下面只展示关联语法,service_inventory 是假定已经存在且按对应版本要求配置好的 lookup 索引,本文没有创建它:
FROM wwj_flattened_demo
| EVAL instance = FIELD_EXTRACT(attrs, "app.instance")
| LOOKUP JOIN service_inventory ON instance
为什么“只有一个映射”仍可以按键查找
理解两种问题的区别就够了:“哪些文档具有某个值?”和“这一篇文档中,指定键的值是什么?”前者适合倒排索引,后者适合面向文档取值的 doc values。flattened 并非把所有内容封成一个永远不可分辨的字符串。
原文给出的内部结构说明可以压缩为一个编码约定:不指定键的查询查找裸值;指定键的查询使用 键 + NUL + 值 的词项。嵌套对象的叶子用带点的键表示,键中不能含 NUL。以本文数据为例,内部键值词项可示意为:
zone + NUL + az-a
app.instance + NUL + worker-03
attempts + NUL + 12
这里的 NUL 表示分隔字节,不是让读者在 JSON 键里输入的字符串,也不是公开映射中需要自己添加的字段。这样写可避免把分隔字节和紧随其后的数字误读成编程语言里的八进制转义。这个编码把同一个键的值聚集到有序词项空间中的同一区间。
对于只有一端边界的范围,不能让扫描随意跨到下一个键。内部可用 [key\0, key\1) 限定键的区间:空缺的下界使用包含式的 NUL 分隔前缀,空缺的上界使用排除式的下一字节哨兵。完整的键前缀一起参与比较,因此 zone 的范围也不会扫进 zonex。这段是对原文内部实现事实的技术说明,接口使用者无需手工构造这些词项。
读取与过滤能够下推到哪里
一条查询可以在两个位置节省工作。第一,读取所需列时,如果字段有 doc values,且优化器可以识别直接的常量键提取,就可以在 block loader 阶段读取所需键值,避免先把整个根字段渲染成 JSON,再对每行重新解析。第二,某些比较还可以下推成底层索引查询,先缩小候选文档范围。能做到哪一步取决于表达式、映射配置和具体版本,不能仅凭使用了 FIELD_EXTRACT 就宣称所有开销都消失。
FROM wwj_flattened_demo
| WHERE FIELD_EXTRACT(attrs, "zone") == "az-a"
直接等值比较是原文说明的可下推情形。复杂表达式、对根的变换或不支持的谓词则可能留在计算引擎中求值。原文也讨论了内部无法融合时的逐行解析回退;当前函数文档要求路径采用字面键名,因此本文没有把“逐行计算键名”作为可直接使用的查询语法。执行计划与资源消耗仍需由实际版本验证。
范围比较的候选筛选仍服从 keyword 次序,不能把它当作数值索引。涉及多值时,底层候选结果还需要由提取后的列重新确认条件。本文没有给出性能百分比,也没有比较吞吐量。
别混淆 Search API 的限制与 ES|QL 的回退
同样是在问某个动态键,Search API 和 ES|QL 走的接口并不完全一样。原文特别讨论了对子键的 fuzzy、regexp、wildcard、没有上下界的 range,以及关闭索引后的 range 限制。某个底层查询无法构造,不代表所有上层计算都不能表达同一条件;反过来,上层能计算,也不代表能通过倒排索引快速筛选。
例如,Search API 直接对子键使用不支持的查询类型可能报错;ES|QL 可以在提取的 keyword 上执行模式匹配,但可能需要更多逐行计算。检查某键是否存在,应表达存在性需求,不要用没有上下界的范围充当替代。关闭 index 后,某些精确匹配可以扫描 doc values,范围行为则应按相应接口验证。这里没有建议关闭索引,也没有把任何查询错误视为可以忽略的警告。
数组和存储格式,需要按返回通道判断
原文回顾了从字典式 SortedSetDocValues 到 BinaryDocValues 的存储变化:字典格式适合重复值多的集合;每文档二进制存储配合压缩,可以避免高基数数据维护全局去重词典的一部分开销。这是版本相关的实现说明,不是本文实测的空间优势。
尤其不要由“存储能保留原始数组”推导出“任意查询都保持数组顺序”。preserve_leaf_arrays = exact 描述的是 synthetic _source 对叶子数组顺序、重复项和 null 位置的保留;FIELD_EXTRACT 文档仍说明多值结果可能是排序、去重后的 keyword 集合。两份资料对存储演进的描述所处层次不同,不能把 synthetic _source 的承诺移用到函数结果。若业务依赖第几项、重复次数或 null 的位置,应分别验证原始 _source、合成 _source 和查询列,必要时调整建模。
让少数关键字段恢复明确类型
开放属性中并非每个键都同样重要。当前映射文档允许在 flattened 的 properties 下为少数叶子声明类型,让这些键通过自己的 typed mapper 索引,其余动态键仍采用 keyword 路径。于是地域可以继续灵活增加,而状态码、时间或 IP 等已知字段保留相应运算语义。使用时要核对版本支持及 typed 子字段的访问方式,不能假定它们仍完整出现在普通 keyed doc-values 表示中。
对既有数据也不应承诺“改一份映射就完成迁移”。类型设计应在独立目标索引里验证,涉及重建、迁移或切换别名时,需要保留旧数据并规划回退。本文没有附带删除索引或重建数据的命令。
选择 flattened 的判断标准因此比较具体:键名开放且变化多,主要需要精确过滤、分组和关联,可以接受动态叶子的字符串语义。若数据结构稳定,全文检索、数值统计或日期计算贯穿所有字段,普通显式映射通常更容易表达需求。将稳定核心与开放属性袋分开,也比为了追求“无模式”而放弃所有类型约束更便于长期维护。










暂无评论内容