


规划 Ceph 双数据中心 Stretch 模式
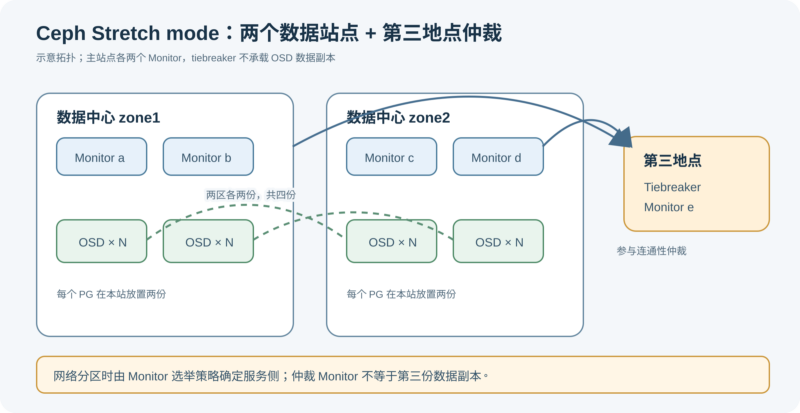
Stretch mode 面向恰好两个数据中心之间的网络分区和单站点故障:跨站点放置副本,并由第三站点 Monitor 担任仲裁者。部署前必须同时验证 Monitor/CRUSH 拓扑、副本规则、版本限制和降级写入风险。
Stretch mode 解决什么问题
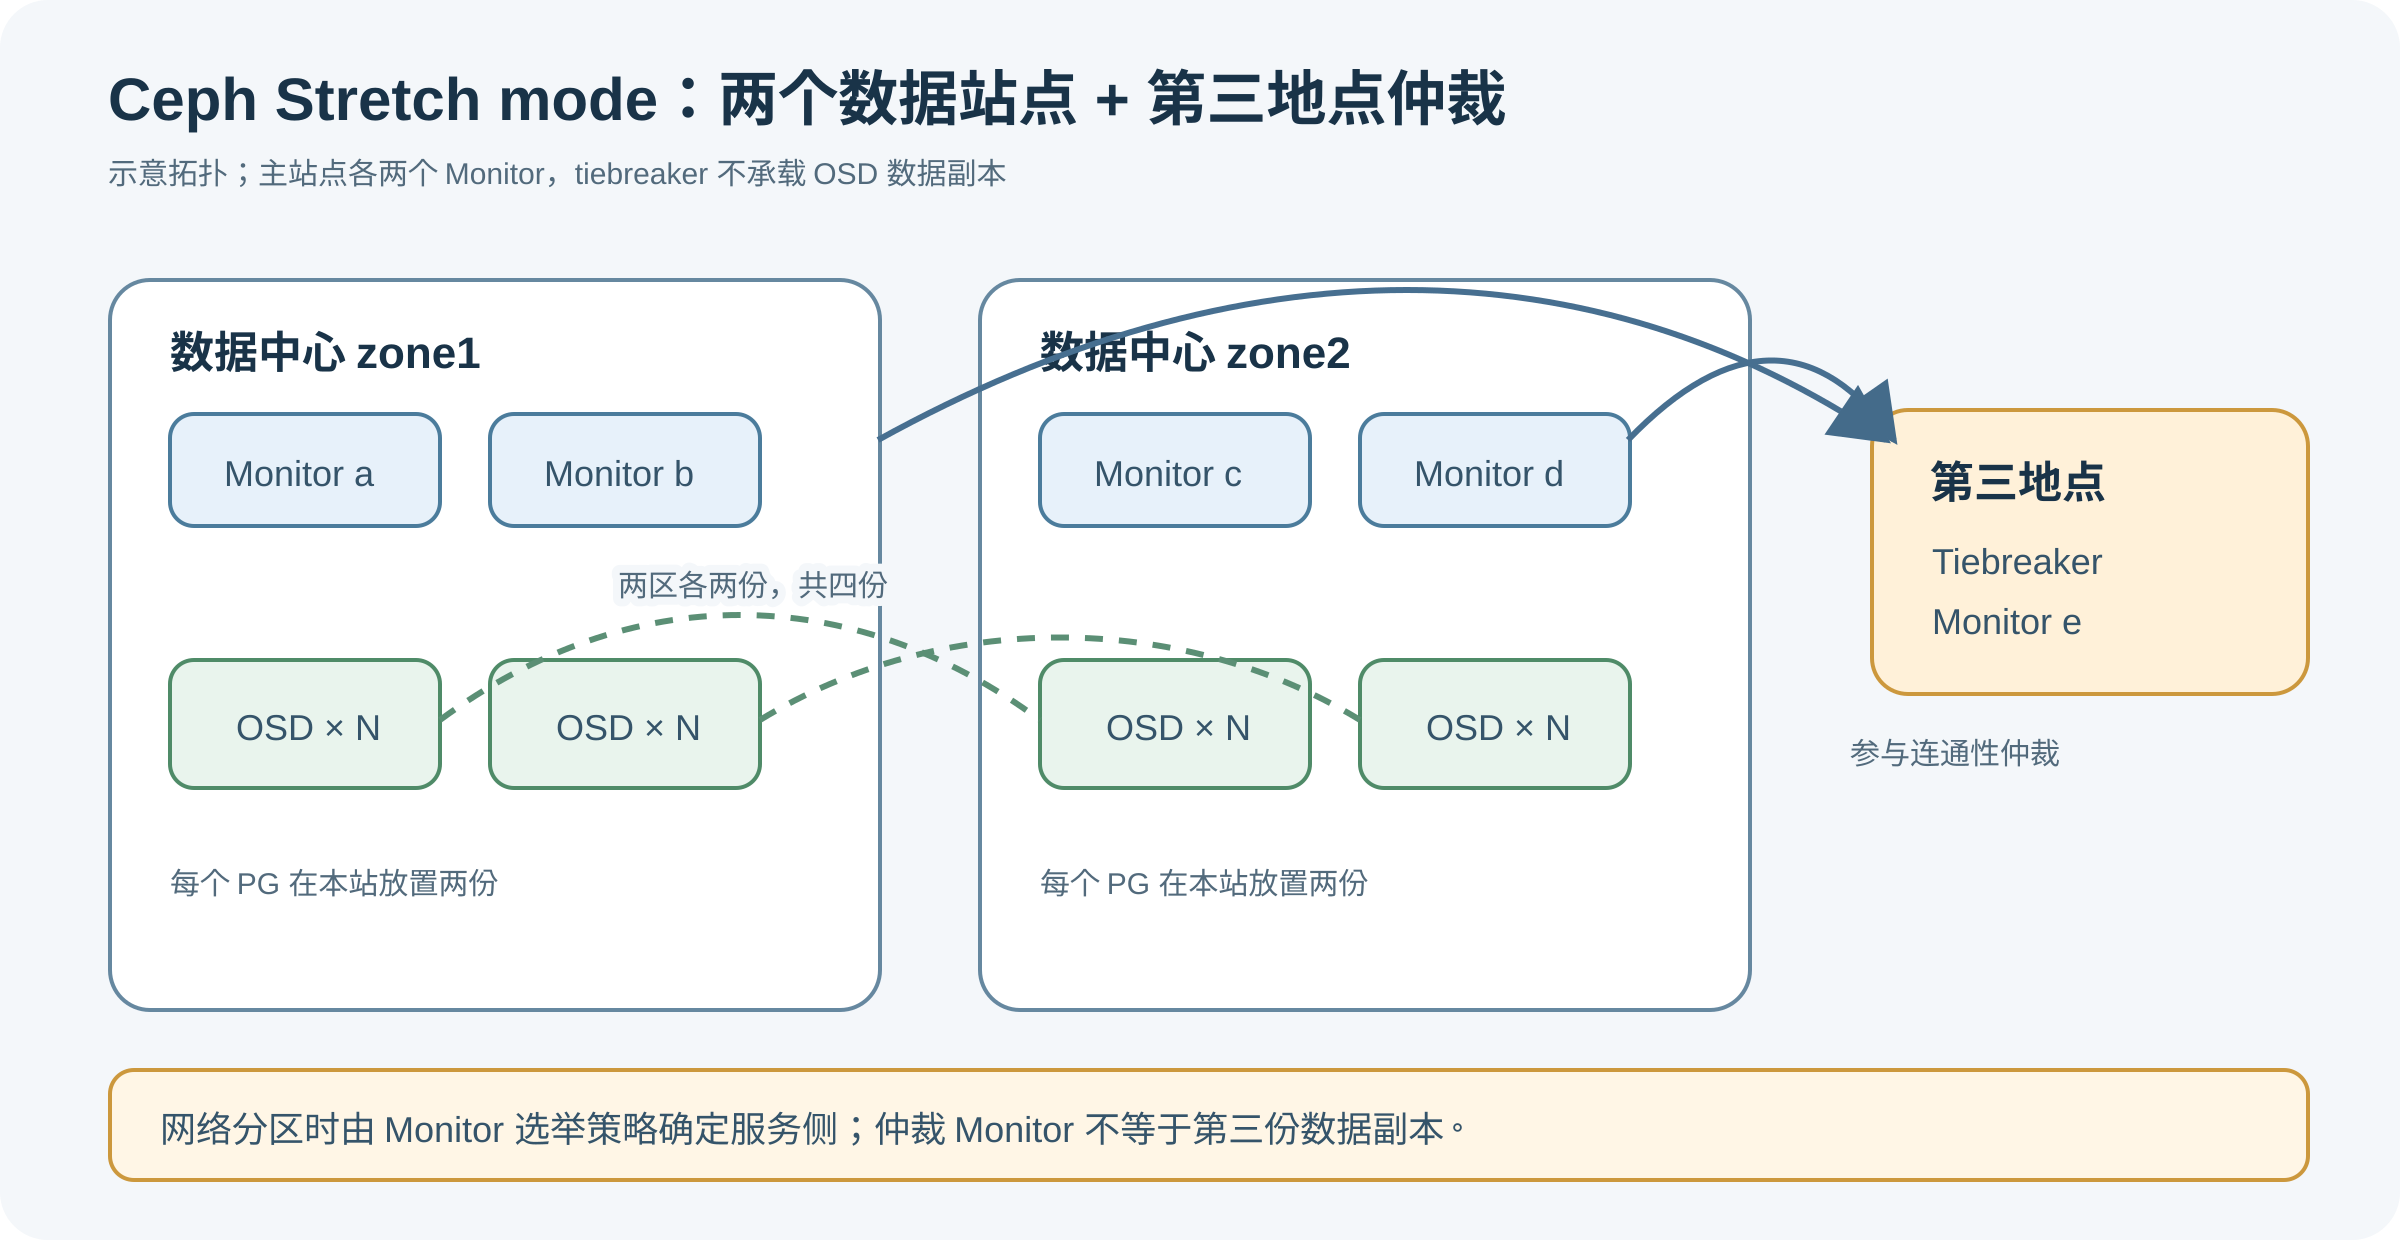
普通集群并不总能从常规副本规则推断“哪一个数据中心仍可安全写入”。站点之间发生网络分区时,两侧可能各自看不到对方,同一 PG(Placement Group,归置组)的副本拓扑也可能不满足跨站点一致性。Ceph Stretch mode 为明确的双站点场景提供仲裁和 peering 规则:Monitor 通过 connectivity 选举策略评估连通情况,第三地点的 tiebreaker 帮助确定分区时由哪侧继续服务;PG 不会仅凭单一数据中心的副本就被允许进入 active。
它适用于恰好两个数据中心且整个集群采用统一配置的情况。不能把三个可用区的一般部署建议直接套成 Stretch mode,也不能把第三处仲裁误认为第三个数据副本区。若仅希望部分池跨两个或更多站点分布,应比较 individual stretch pool:它可按池配置,但官方文档说明多个 zone netsplit 时该池停止 I/O,直到分区恢复;这与 Stretch mode 在仲裁后让一侧降级运行不同。
先确认拓扑和限制
| 项目 | 规划边界 |
|---|---|
| 数据站点 | OSD 必须位于恰好两个数据中心,例如 zone1 与 zone2。 |
| Monitor | 所读官方限制要求每个主数据中心运行两个 Monitor,并在第三地点运行一个 tiebreaker,共五个;OSD 只连接本数据中心的 Monitor,不连接 tiebreaker。 |
| 副本布局 | 复制池总计四个副本,每个站点两个;示例 CRUSH rule 以 datacenter 分布、再以 host 选择叶节点。 |
| 池类型和参数 | Erasure-coded pool 不受支持;进入模式前现有池需符合官方 size/min_size 条件。源页说明降级时 min_size 会降至 1。 |
| 设备类别 | Stretch rule 不要指定 device class;带类别的 shadow bucket 会造成故障时 peering 识别不一致,可能令 PG inactive 并卡住恢复。 |
| 存储介质 | 滚动文档建议使用 SSD OSD,理由是 min_size=1 期间降低数据丢失风险并缩短恢复窗口;需结合目标集群容量与成本评估。 |
Monitor 地理位置要与 CRUSH 层级匹配,名称和 bucket type 必须符合实际集群。tiebreaker 应处于不同于两处主站点的第三个 CRUSH datacenter。所读 latest 页面给出的仲裁 VM 示例为至少 6 vCPU、适度集群 64 GB RAM、较大集群 128 GB RAM;这些是滚动页面的当前建议,不能代替按版本、Monitor 负载和官方硬件指南做 sizing。
副本规则是数据安全边界
示例规则的关键逻辑是从各 datacenter 选择两台不同 host,形成两个站点各两份、总计四份副本。规则 ID 只是演示值;生产集群必须检查现有 map,选用未占用且符合本集群拓扑的 ID。当前文档还提醒:带多个 take 步骤的替代规则可能让某些池的 MAX AVAIL 误报为单个 datacenter 的可用量。官方建议的示例使用 take default 和 choose firstn 0 type datacenter,并提醒核验规则是否适合实际层级。
rule stretch_replicated_rule {
    id 1
    type replicated
    step take default
    step choose firstn 0 type datacenter
    step chooseleaf firstn 2 type host
    step emit
}
这是源文的 CRUSH 示例,不是可直接套用的通用文件。先核实 datacenter/host 层级、规则 ID、OSD 分布、各池副本参数和副本落点;在与目标版本相符的隔离副本上用 crushtool 解码、修改、编译并检查 map。不要对未审查的 map 直接运行 ceph osd setcrushmap:该命令会把整张 CRUSH map 注入活动集群,规则错误可能改变大量数据放置并触发迁移,影响容量、可用性和恢复时间。变更前导出备份、审查差异、验证 ID,并演练回退。
进入模式的顺序
- 盘点集群。记录 Ceph 精确版本、Monitor quorum、站点网络、OSD/host/datacenter 拓扑、池 type/size/min_size/rule 与容量余量。保存 map 和配置清单,使用与安装版本对应的文档。
- 安排 Monitor 位置。把两站点 Monitor 和第三地点仲裁 Monitor 映射到对应 CRUSH datacenter。原文示例采用
ceph mon set_location;自有部署工具可使用该版本支持的--set-crush-location。不要交叉或重复配置位置。 - 构建并检查 CRUSH rule。导出活动 map 到本地文件,解码后在副本中新增规则,检查 ID、树结构、四副本是否各为两份及模拟映射;确认没有 device class。经过评审并准备回退后,才应用变更。
- 选择仲裁者并启用。原文自动选择示例为
ceph mon set_location e datacenter=zone3后运行ceph mon enable_stretch_mode stretch_replicated_rule datacenter;也可按当前版本格式显式指定仲裁 Monitor。启用命令会在必要时自动切换到 connectivity 选举策略,应评估选举和客户端影响。 - 观察 PG 与池状态。确认跨站点 peering、四副本落点、池参数、quorum 与健康状态符合预期;演练断开站点链路和单站点故障,检查服务侧、PG active 状态及恢复收敛。
下面是原文的读取和本地准备命令。第一条会在当前目录写 map 文件;它不修改集群,但应使用安全、有权限且空间充足的路径:
ceph osd getcrushmap > crush.map.bin
crushtool -d crush.map.bin -o crush.map.txt
# 在经过隔离审查的副本中修改并编译
crushtool -c crush.map.txt -o crush2.map.bin
# 此命令会更改活动集群 CRUSH map,不能照抄执行
# ceph osd setcrushmap -i crush2.map.bin
理解故障状态,不要急着清警告
- 站点间 netsplit:仲裁与 connectivity 选举选择一侧。跨站点规则约束 PG peering,避免单侧副本被误当成达到正常跨站点冗余的 active 集合。
- 完整站点不可用:集群进入 degraded stretch mode,池 min_size 降为 1 以允许幸存侧服务;size 仍为 4,PG 显示 undersized,但特殊标志阻止在单站点额外补出原本要求的副本数。降低写入门槛并不等于恢复冗余;期间再发生 OSD 故障,丢失新数据的风险上升,应限制风险操作并尽快恢复另一站点。
- 站点回归:进入 recovery stretch mode 后,需要与此前持续在线站点的 OSD peering。PG 全部已知且不再 degraded/undersized/incomplete 后,集群才回到 regular stretch mode,并把 min_size 恢复到原值(示例为 2)。容量不足或恢复较慢会延长风险窗口。
- OSD 出站比例保护:官方文档提及 mon_osd_min_in_ratio 默认 0.75 的场景:当离线 OSD 比例过高,系统可能停止将更多 OSD 标为 out,以避免灾难性重平衡;这又可能使 PG inactive。没有容量和恢复负载评估时,不要随意降低保护。
特别危险的两个误操作
不要在 Stretch CRUSH rule 中加 device class。带 class ssd 的规则会走诸如 zone1~ssd 的 shadow bucket。两站点在线时可能看似正常;丢失一站点后,降级模式记录实际 zone1,却无法匹配 shadow bucket,PG 可能全部 inactive。站点恢复也不一定自动清除故障,因为恢复状态要求 PG 先健康。官方提示要在两站点都在线时纠正规则;改池规则会迁移大量数据,需按大规模数据重放变更计划。
不要把强制状态命令当作清理 HEALTH_WARN 的按钮。ceph osd force_healthy_stretch_mode --yes-i-really-mean-it 可能用于 PG peering 恢复停滞,但官方明确提示有数据不可用风险;force recovery 命令也会改变故障状态推进。退出模式的 ceph mon disable_stretch_mode 会恢复池原先规则/size/min_size,随后缩容责任由操作者承担。源页指出退出能力要求 Reef 18.2.8 或更高版本,且 recovery 状态下命令不会执行。任何带 --yes-i-really-mean-it 的操作都须核对版本、PG/池状态、变更审批和人工恢复方案,不能为了消除警告直接执行。
部署前评审清单
- 核对运行中的精确 Ceph 版本,并对照该版本的稳定文档;latest 页面当前是开发版。
- 验证两个数据中心各有足够容量承载两份副本;为第三地点仲裁 Monitor 和网络路径安排故障演练。
- 盘点 Monitor CRUSH location、quorum、池 type/size/min_size 和规则。
- 审查 CRUSH 规则,确认两站点各放两份且不使用 EC 或 device class;备份 map,并验证差异、容量影响和回退。
- 在测试环境演练 degraded mode 的写入边界、netsplit、单站点和仲裁者故障、站点恢复及 PG 收敛。
来源、版本与署名
主要来源为 Ceph《Stretch Clusters》,并合并 《Configuring Monitor Election Strategies》 的 connectivity election 说明。两页在 2026-10-05 保存的 latest 抓取均标注为开发版本文档;退出模式 Reef 18.2.8+ 是源页明确列出的边界。使用时应查实际安装版本的稳定文档。
作者归属 Ceph Documentation 社区;源页注明 CRUSH rule 流程由 Prashant Dhange 于 2024 年 5—6 月开发,并注明 Ceph Foundation 提供/维护文档。Ceph 项目说明文档依 CC BY-SA 3.0 许可(许可证文本);本文对来源内容的中文改写与合并部分按同一许可分享。本文的原创拓扑示意图是单独作品,仅随本文展示,不由上述来源许可单独授权复用。整理和风险注释不代表 Ceph 官方背书。










暂无评论内容