


用 MLServer 提供 Hugging Face 文本模型推理接口
来源:Seldon Technologies Ltd. / MLServer 官方 Serving HuggingFace Transformer Models。中文翻译、勘误与技术整理:未完纪。2026-10-05 核对;源页未固定全部依赖版本。
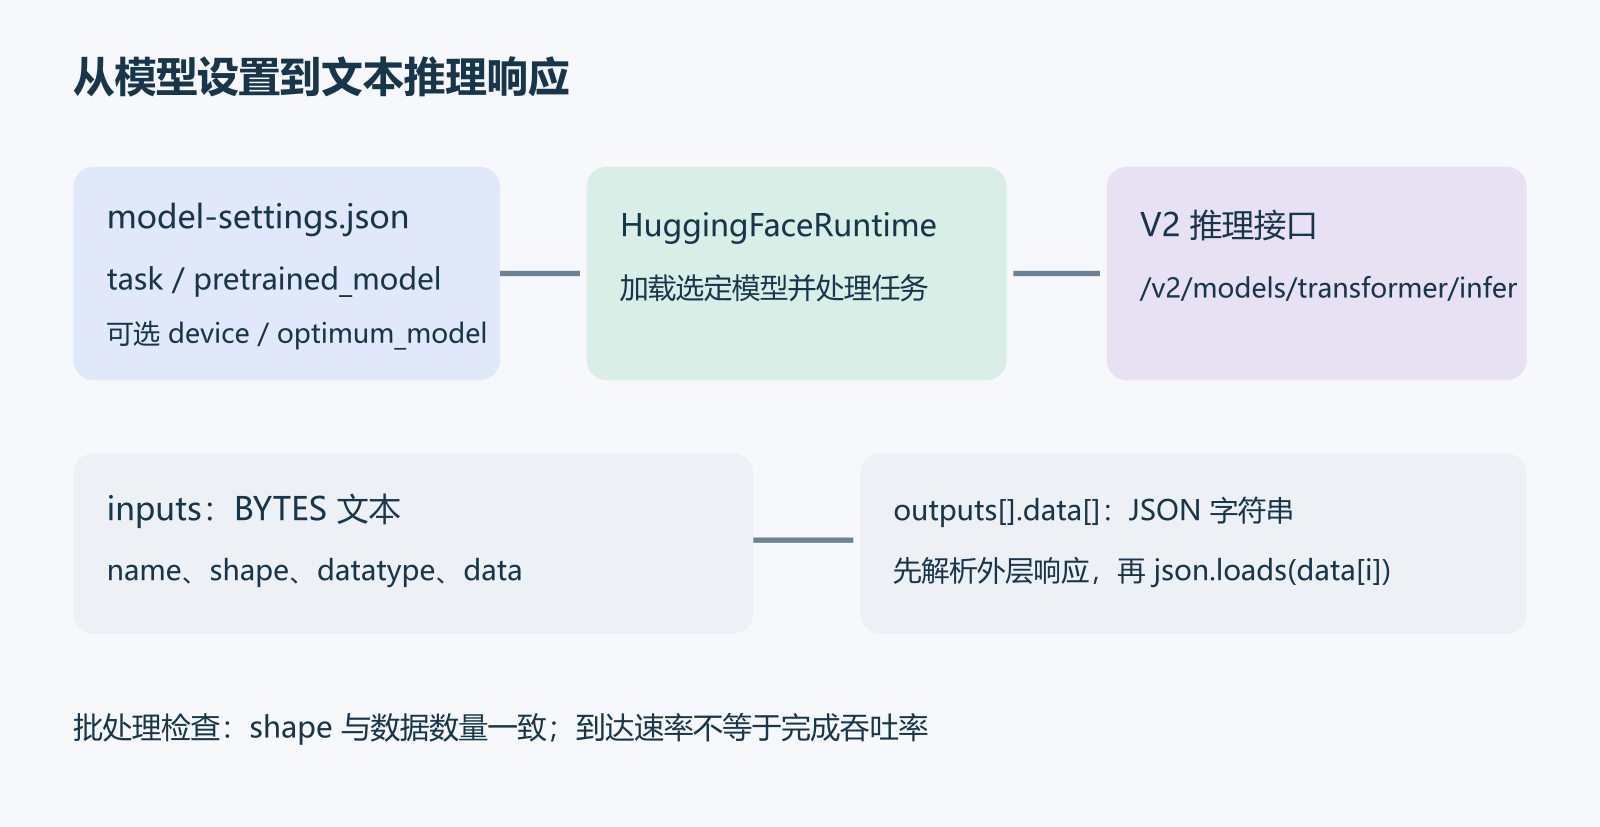
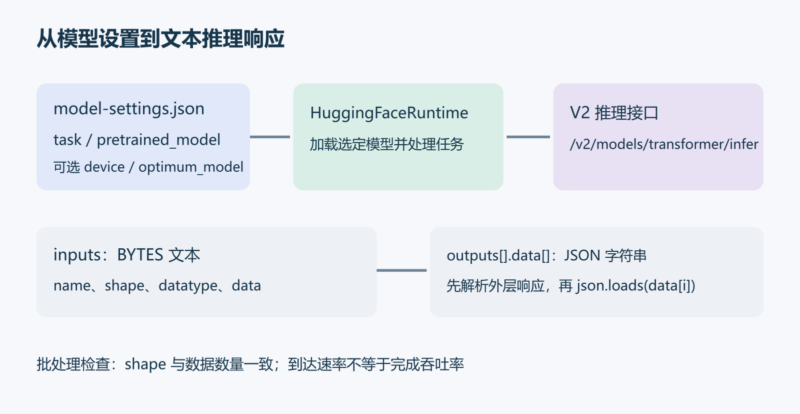
MLServer 的 Hugging Face 运行时可以加载 Hub 上的 Transformer 模型,借助 Optimum 使用量化或优化模型,并通过请求批处理与自适应批处理改善 GPU 利用。本教程从已有预训练模型开始,重点是服务配置、V2 推理请求和响应,而不是模型训练。
本文逐节整理 Serving HuggingFace Transformer Models 全文。源文使用 Notebook 的 %%writefile 与 %%bash;下面把配置明确写成独立 JSON 文件,把 shell 命令单列。原文依赖版本和部分默认模型未固定;本轮没有安装软件、下载模型、启动服务、运行推理或压测。
用模型设置声明文本生成任务
把以下内容保存为 model-settings.json。name 定义服务中的模型名 transformer;implementation 指定 mlserver_huggingface.HuggingFaceRuntime;parameters.extra 选择 text-generation 任务和 distilgpt2 模型。运行环境应已安装与 MLServer 版本匹配的 Hugging Face 运行时及模型依赖;原文并未给出可跨版本照搬的完整锁定清单。
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "parameters": {
    "extra": {
      "task": "text-generation",
      "pretrained_model": "distilgpt2"
    }
  }
}
在配置目录中启动服务器,或者让命令指向该目录。命令会持续运行并等待请求,因此原文建议放在另一个终端。本地演示地址不等于认证和公网部署方案;向外开放前必须另外设计访问控制和网络边界。
mlserver start .首次加载可能从 Hugging Face Hub 获取模型材料。需要核对模型来源、版本与许可证,并使用可信模型文件;不要为兼容未知仓库就随意开启远程自定义代码执行。原文的公开模型身份不保证将来所有修订都适合当前依赖或业务。
构造 V2 输入并分层解析响应
源例用名为 args 的输入传入一个字符串,shape 为 [1]、datatype 为 BYTES。请求路径中的 transformer 与模型设置名称一致。下面保留原始请求结构,但增加 timeout 和 raise_for_status,并显式解析内层 JSON;这些是编辑补充,未运行验证。
import json
import requests

inference_request = {
    "inputs": [
        {
            "name": "args",
            "shape": [1],
            "datatype": "BYTES",
            "data": ["this is a test"],
        }
    ]
}

response = requests.post(
    "http://localhost:8080/v2/models/transformer/infer",
    json=inference_request,
    timeout=60,  # 编辑补充;按模型与业务时限重新设置。
)
response.raise_for_status()  # 编辑补充
payload = response.json()

# 原页输出的 data 元素是 JSON 字符串,不是已经解码的字典。
outputs = payload["outputs"]
decoded = [json.loads(item) for item in outputs[0]["data"]]
print(decoded)
原页面的外层响应包含 model_name、请求 id、parameters 与 outputs。输出的 name 为 output、shape 为 [1, 1]、datatype 为 BYTES,content_type 为 hg_jsonlist;data 内的字符串再编码一个带 generated_text 键的对象。源例生成了以 ‘this is a testnet’ 开头的内容,这是原作者保存的一次结果,不是固定答案,也不是本轮推理结果。实际接入时还应检查输出列表和字段存在性,按自己的响应契约处理错误。
选择 Optimum 优化模型
如果 Hub 上有适合的预训练优化模型,原文通过 optimum_model=true 启用 Optimum 路径。修改 model-settings.json 后重新按服务管理流程加载配置;不要在同一端口盲目启动多个进程。请求结构不变,仍可使用 args 和一条 BYTES 文本。
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "parameters": {
    "extra": {
      "task": "text-generation",
      "pretrained_model": "distilgpt2",
      "optimum_model": true
    }
  }
}
源页显示另一段 generated_text,说明这一路径也返回同样形态的数据。不能根据开关名称推断所有模型都能自动量化,或优化后必然更快;可用后端、模型文件格式和依赖兼容性需要在选定环境中验证。
问答:让 question 与 context 成对输入
问答变体把任务改为 question-answering,源文没有显式指定 pretrained_model,因此会依赖运行时或 Transformers 版本选择的默认模型。为可复现部署,实际项目应补充并审核明确的模型标识与版本;本文不猜测一个默认模型,也没有下载模型来确认。
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "parameters": {
    "extra": {
      "task": "question-answering"
    }
  }
}
question_request = {
"inputs": [
{
"name": "question",
"shape": [1],
"datatype": "BYTES",
"data": ["what is your name?"],
},
{
"name": "context",
"shape": [1],
"datatype": "BYTES",
"data": ["Hello, I am Seldon, how is it going"],
},
]
}
response = requests.post(
"http://localhost:8080/v2/models/transformer/infer",
json=question_request,
timeout=60,
)
response.raise_for_status()
answer = response.json()源页的 data 字符串对象含 answer=’Seldon’、start=12、end=18,score 约 0.987。start 与 end 对应上下文内答案片段的位置;score 属于模型输出分数,不是普遍适用的正确率。仍需按前述方式解析内层 JSON,并根据具体任务验证输出。
情感分析:文本分类任务
情感示例使用 text-classification,同样没有固定默认模型。其输入名回到 args,只有一条文本 ‘This is terrible!’。
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "parameters": {
    "extra": {
      "task": "text-classification"
    }
  }
}
sentiment_request = {
"inputs": [
{
"name": "args",
"shape": [1],
"datatype": "BYTES",
"data": ["This is terrible!"],
}
]
}
response = requests.post(
"http://localhost:8080/v2/models/transformer/infer",
json=sentiment_request,
timeout=60,
)
response.raise_for_status()
sentiment = response.json()原例返回的内层对象含 label=’NEGATIVE’,score 约 0.999614。这是那条英文样本的源站输出;它没有验证中文、讽刺、领域迁移或公平性,不足以证明真实业务中的情感识别可靠性。
GPU 比较段:先纠正请求与对照条件
原文用 device=-1 表示 CPU,device=0 选择编号 0 的 GPU,并提醒机器必须具备适配 TensorFlow/PyTorch 的 GPU 环境。CPU 配置同时设置 max_batch_size=128 和 max_batch_time=1,而 GPU 比较配置省略这两项;模型也未始终固定。比较中改变了多个条件,不能把差异全部归因于 GPU。
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "max_batch_size": 128,
  "max_batch_time": 1,
  "parameters": {
    "extra": {
      "task": "text-generation",
      "device": -1
    }
  }
}
源文的 GPU 对比配置如下:它设 device=0,但没有显式固定模型,也没有设置 max_batch_size 或 max_batch_time。保留这个配置是为了看清源文改变了哪些条件,不是推荐配置:
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "parameters": {
    "extra": {
      "task": "text-generation",
      "device": 0
    }
  }
}
更直接的问题是,CPU 与 GPU 的批量请求都把 data 构造成 512 条字符串,却仍声明 shape:[1],输入名也从前面示例的 args 改成 text_inputs。不要原样复制这一段来宣称成功批处理。下面只是修正数量一致性并沿用前文单请求名称的候选写法,与原文差异明确标出;还必须在选定运行时中验证输入契约和可接受批大小。
# 编辑修订候选:shape与数据数量一致;输入名统一为前文的args。
# 未执行;不保证任意运行时版本或模型都接受512条单请求。
texts = ["This is a generation for the work" for _ in range(512)]
batch_request = {
    "inputs": [
        {
            "name": "args",
            "shape": [len(texts)],
            "datatype": "BYTES",
            "data": texts,
        }
    ]
}
原页 CPU 代码输出为 66.42268538899953 秒,紧接着文字却写成 81 秒;GPU 输出为 11.27933280000434 秒,文章又称其快 8 倍。数字与文字本身不一致,且没有统一模型、批处理策略、预热、硬件与成功响应校验。因此本稿保留这些信息作为源文勘误,不接受“8 倍”作为已证实结论。
想做有意义的对照,应先固定模型修订、依赖、文本集合、生成参数、批大小及服务配置,检查响应成功并核对输出数量,再分别记录预热后多次运行的延迟和吞吐。原文仅在 requests.post 前后用 time.monotonic 计时且未校验状态;一次 HTTP 返回也可能是错误响应,不能直接认定模型完成了预期工作。
自适应批处理:把到达的请求聚合
原文最后把 GPU、明确的 distilgpt2 模型与自适应批处理组合:max_batch_size 设为 128,max_batch_time 设为 1。后者限制调度器等待聚合的时间;它会影响延迟与批次填充,不能只追求批大小而忽略用户等待。
{
  "name": "transformer",
  "implementation": "mlserver_huggingface.HuggingFaceRuntime",
  "max_batch_size": 128,
  "max_batch_time": 1,
  "parameters": {
    "extra": {
      "task": "text-generation",
      "pretrained_model": "distilgpt2",
      "device": 0
    }
  }
}
教程用 jq 生成 Vegeta 的 JSON 请求目标,把请求体 Base64 编码,以每秒 50 次、持续 3 秒的到达负载访问 localhost。下面保留这一部分的结构供阅读,明确采用原文 text_inputs 名称;它与前文名称差异仍需针对具体版本核验。此命令是负载发生器,只能用于自己授权的隔离测试服务,本轮没有执行。
jq -ncM '{"method": "POST", "header": {"Content-Type": ["application/json"]}, "url": "http://localhost:8080/v2/models/transformer/infer", "body": "{\"inputs\":[{\"name\":\"text_inputs\",\"shape\":[1],\"datatype\":\"BYTES\",\"data\":[\"test\"]}]}" | @base64}' \
  | vegeta -cpus="2" attack -duration="3s" -rate="50" -format=json \
  | vegeta report -type=text
源页报告 150 次请求、约 50.34 次/秒的发送速率、22.28 次/秒的完成吞吐、总耗时 6.732 秒、平均延迟约 3.168 秒,以及 150 个 HTTP 200。这个结果不能写成“已经达到每秒完成 50 次推理”:负载只发送约 2.98 秒,随后又等待约 3.753 秒完成。100% HTTP 成功也不是对生成内容正确性或持续负载稳定性的证明。
安全与可复现性核查
原例没有写入真实凭证,也未包含删除数据或执行模型输出的代码。请求内容只是文本;不要在接入工具或业务动作后把模型生成内容直接当作可信指令。模型服务示例本身未提供认证、TLS、配额、输入长度限制或模型供应链策略,这些都需要部署方补齐。
本文修订了普通请求的超时与状态检查,去掉 Notebook 文件魔法命令的歧义,并针对批量 shape 给出明确标注的候选修正。所有配置和代码均只做静态审查,没有将原站输出写成自己的测试结果;这些检查不构成无漏洞证明。
出处:MLServer 官方教程页面;原文文件位于 MLServer 仓库的 docs/examples/huggingface/README.md。版权 Copyright 2020 Seldon Technologies Ltd.。该仓库根目录的 LICENSE 为 Apache License 2.0,完整文本随稿(Apache 2.0 文本);教程页面没有显示单独的页面许可或例外。本文中文翻译与转载依据另行取得的许可使用,不把另行许可称为开放许可。模型、依赖和第三方材料各有自己的许可。翻译、勘误与原创示意图由未完纪整理,修改已在正文标明。










暂无评论内容