


让 PyTorch 自定义 Function 支持二次反向传播
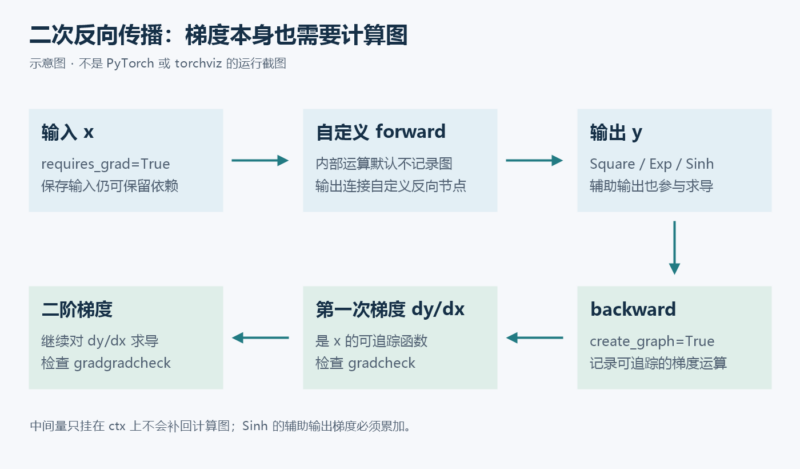
有时我们需要再对反向传播得到的梯度求导,例如计算高阶导数。一个自定义 torch.autograd.Function 能完成一次 backward,并不意味着它已经正确支持二次反向传播。关键在于:第一次反向传播本身能否被 autograd 记录成可继续求导的计算图,以及保存下来的张量是否仍然与原来的输入保持正确关系。
本文据 PyTorch 官方教程 Double Backward with Custom Functions 翻译整理。原作者为 PyTorch 文档与教程贡献者;原页创建和更新日期均为 2021-08-13,标注最后验证日期为 2024-11-05。本次于 2026-10-05 核对的站点标题为 PyTorch Tutorials 2.14.0+cu130。这是文档站点版本信息,不表示下列例子已在该版本重新执行。
先弄清楚哪些运算会被记录
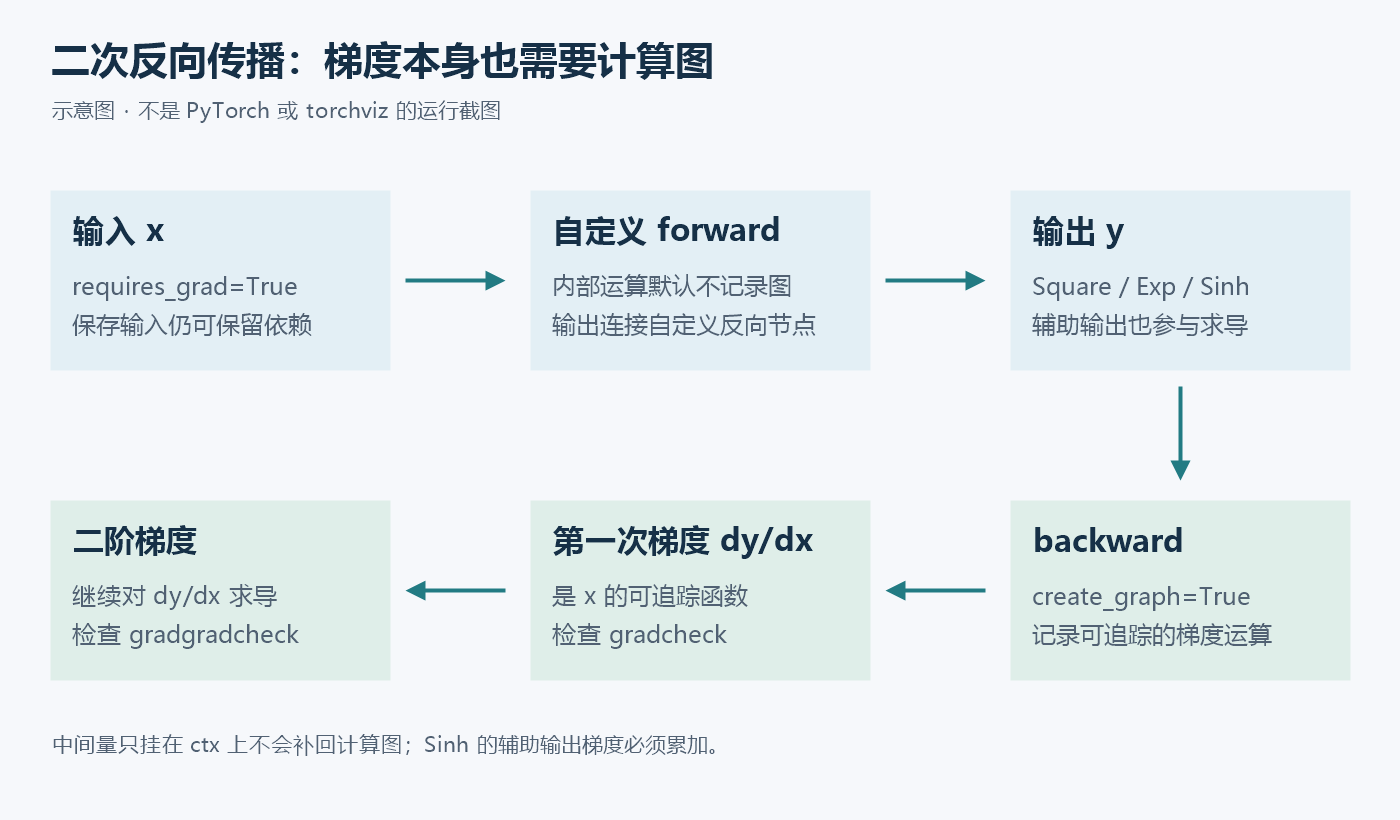
自定义 Function 对梯度模式有两处容易忽略的影响:
forward内执行的运算,默认不会被 autograd 记录成内部计算图。前向结束后,自定义 Function 的反向节点成为各个输出的grad_fn。- 执行
backward时,如果调用方指定create_graph=True,autograd 就会记录计算梯度所使用的、能够被它追踪的运算,从而允许继续对梯度求导。
因此,save_for_backward 不是“保存任何张量就能恢复计算图”的开关。保存输入、保存输出、保存只存在于前向内部的中间值,会产生不同结果。下面逐一说明。
保存输入:平方函数
先看 y = x²。前向保存输入 x,反向返回上游梯度乘以 2x。如果 x 本身由其他需要梯度的张量计算而来,它仍然携带相应的梯度关系;如果它是需要梯度的叶张量,autograd 也能追踪反向计算对它的依赖。只要反向里的乘法能被记录,二阶求导便可继续进行。
import torch

class Square(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x):
        ctx.save_for_backward(x)
        return x**2

    @staticmethod
    def backward(ctx, grad_out):
        x, = ctx.saved_tensors
        return grad_out * 2 * x

# 有限差分会放大数值误差,所以教程使用双精度。
x = torch.rand(3, 3, requires_grad=True, dtype=torch.double)
torch.autograd.gradcheck(Square.apply, x)
torch.autograd.gradgradcheck(Square.apply, x)
gradcheck 检查一阶梯度,gradgradcheck 检查梯度的梯度。这里保留的是原文的检查调用,本文没有执行这些调用,也不声称检查已经通过。
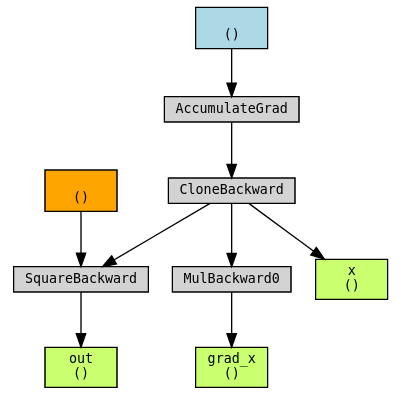
原文进一步用 torchviz 观察计算图。下面的 create_graph=True 是重点:结果 grad_x = 2x 自身仍然是 x 的函数。
import torchviz

x = torch.tensor(1., requires_grad=True).clone()
out = Square.apply(x)
grad_x, = torch.autograd.grad(out, x, create_graph=True)
torchviz.make_dot(
    (grad_x, x, out),
    {"grad_x": grad_x, "x": x, "out": out},
)
可视化需要额外安装并配置 torchviz 及其绘图依赖。图结构只能辅助理解,不能代替数值检查和目标算子的边界测试。
保存输出:指数函数
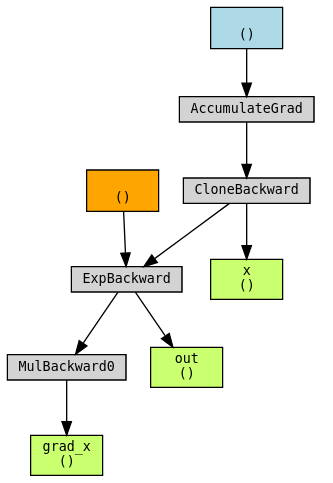
也可以保存输出而不是输入。exp(x) 的导数还是 exp(x),因此反向可以复用前向结果。输出与自定义 Function 的反向节点相连,使用 save_for_backward 保存它,能够在之后的求导中保留所需关系。
class Exp(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x):
        result = torch.exp(x)
        ctx.save_for_backward(result)
        return result

    @staticmethod
    def backward(ctx, grad_out):
        result, = ctx.saved_tensors
        return result * grad_out

x = torch.tensor(1., requires_grad=True, dtype=torch.double).clone()
torch.autograd.gradcheck(Exp.apply, x)
torch.autograd.gradgradcheck(Exp.apply, x)

out = Exp.apply(x)
grad_x, = torch.autograd.grad(out, x, create_graph=True)
torchviz.make_dot(
    (grad_x, x, out),
    {"grad_x": grad_x, "x": x, "out": out},
)
这里的保存对象是前向输出,而不是任意内部缓存。教程把非张量等上下文信息直接放在 ctx 上;对参与反向的输入或输出张量则使用 save_for_backward。
保存中间结果:把必要的中间量也作为输出
较棘手的情况是双曲正弦:
sinh(x) = (exp(x) − exp(−x)) / 2,而它的导数为 cosh(x) = (exp(x) + exp(−x)) / 2。
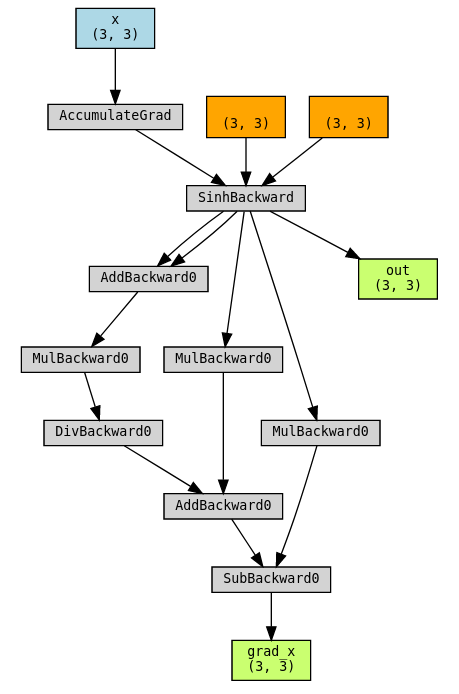
为了避免重复计算,我们可能想在前向中缓存 exp(x) 和 exp(-x)。问题是,前向内部默认没有建立这些运算的图。如果反向只把缓存当作常量使用,梯度图便缺失了“指数结果来自 x”的关系,继续求导时会得到错误结果。
原文采用的办法是:除了真正的 sinh(x),同时返回两个中间量。它们成为自定义 Function 的输出,于是拥有相应的反向关系;外面再包一层函数,仅把第一个输出暴露给调用者。
class Sinh(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x):
        expx = torch.exp(x)
        expnegx = torch.exp(-x)
        ctx.save_for_backward(expx, expnegx)
        return (expx - expnegx) / 2, expx, expnegx

    @staticmethod
    def backward(ctx, grad_out, _grad_out_exp, _grad_out_negexp):
        expx, expnegx = ctx.saved_tensors
        grad_input = grad_out * (expx + expnegx) / 2

        # 即使包装函数没有直接返回这两个辅助输出,
        # 二次反向传播仍会用到它们,不能省略相应贡献。
        grad_input += _grad_out_exp * expx
        grad_input -= _grad_out_negexp * expnegx
        return grad_input

def sinh(x):
    return Sinh.apply(x)[0]

x = torch.rand(3, 3, requires_grad=True, dtype=torch.double)
torch.autograd.gradcheck(sinh, x)
torch.autograd.gradgradcheck(sinh, x)

out = sinh(x)
grad_x, = torch.autograd.grad(out.sum(), x, create_graph=True)
torchviz.make_dot(
    (grad_x, x, out),
    params={"grad_x": grad_x, "x": x, "out": out},
)
backward 接收到三个上游梯度,分别对应三个前向输出。后面两项必须累加:对 exp(x) 的贡献是 _grad_out_exp * expx,对 exp(-x) 的贡献带负号。即使平时只使用第一个输出,高阶求导也会通过这些辅助输出继续传播。它们不是可以随意忽略的额外返回值。
错误示范:只把前向中间量挂到 ctx
下面保留原文的反例,用来说明失败机制,不要将它作为正确的二阶求导实现:
class SinhBad(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x):
        expx = torch.exp(x)
        expnegx = torch.exp(-x)
        ctx.expx = expx
        ctx.expnegx = expnegx
        return (expx - expnegx) / 2

    @staticmethod
    def backward(ctx, grad_out):
        expx = ctx.expx
        expnegx = ctx.expnegx
        return grad_out * (expx + expnegx) / 2

out = SinhBad.apply(x)
grad_x, = torch.autograd.grad(out.sum(), x, create_graph=True)
torchviz.make_dot(
    (grad_x, x, out),
    params={"grad_x": grad_x, "x": x, "out": out},
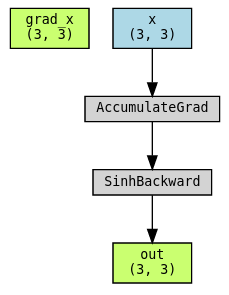
)在这个例子中,expx 和 expnegx 只在不记录图的前向内部生成,也没有作为输出返回。对这里的 out.sum() 求导时,上游梯度是常量,得到的 grad_x 因而没有所需要的反向图。把调用改成 create_graph=True 并不能凭空补回早已丢失的运算关系。
这也说明,“一阶公式写对了”与“高阶梯度可追踪”是两件事。单次反向能给出预期数值,仍然不足以证明二次反向正确。
反向过程无法自动追踪时,再定义一个 Function
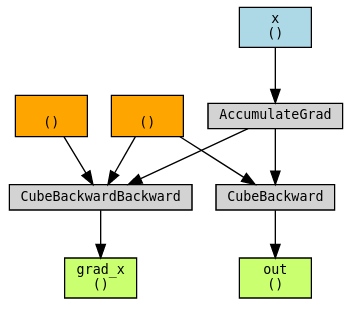
假设反向计算调用了 NumPy、SciPy 或一个 autograd 无法记录内部运算的 C++ 扩展。可以再定义一个自定义 Function,专门包装第一次反向计算,并手工实现它的反向。原文用三次函数来演示结构:cube_backward 在例子中仍用 PyTorch 运算表达,但应把它理解为未来可以替换成外部实现的位置。
def cube_forward(x):
    return x**3

def cube_backward(grad_out, x):
    return grad_out * 3 * x**2

def cube_backward_backward(grad_out, sav_grad_out, x):
    return grad_out * sav_grad_out * 6 * x

def cube_backward_backward_grad_out(grad_out, x):
    return grad_out * 3 * x**2

class Cube(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x):
        ctx.save_for_backward(x)
        return cube_forward(x)

    @staticmethod
    def backward(ctx, grad_out):
        x, = ctx.saved_tensors
        return CubeBackward.apply(grad_out, x)

class CubeBackward(torch.autograd.Function):
    @staticmethod
    def forward(ctx, grad_out, x):
        ctx.save_for_backward(x, grad_out)
        return cube_backward(grad_out, x)

    @staticmethod
    def backward(ctx, grad_out):
        x, sav_grad_out = ctx.saved_tensors
        dx = cube_backward_backward(grad_out, sav_grad_out, x)
        dgrad_out = cube_backward_backward_grad_out(grad_out, x)
        return dgrad_out, dx

x = torch.tensor(2., requires_grad=True, dtype=torch.double)
torch.autograd.gradcheck(Cube.apply, x)
torch.autograd.gradgradcheck(Cube.apply, x)

out = Cube.apply(x)
grad_x, = torch.autograd.grad(out, x, create_graph=True)
torchviz.make_dot(
    (grad_x, x, out),
    params={"grad_x": grad_x, "x": x, "out": out},
)
CubeBackward.forward 有两个张量输入,依次是原先的上游梯度和 x,所以它的 backward 也必须按相同顺序返回两个梯度:dgrad_out 和 dx。不能只返回对 x 的导数。这里还要区分保存下来的 sav_grad_out 与第二次反向新传入的 grad_out,它们处于不同层次。
把示例迁移到真实算子时
这篇教程的主线是:判断反向计算是否能被 autograd 追踪。保存输入和输出的两个简单例子通常可以直接继续求导;前向内部中间量需要正确连接到输出;不能被记录的外部反向实现,则需要另一个 Function 明确给出导数。
编辑补充:这些代码只覆盖少量、小尺寸、双精度输入。真实算子还应单独验证 dtype、设备、广播、非连续输入、边界值以及预期支持的高阶次数;指数函数还存在大幅值溢出的数值边界。通过一次 gradcheck 或 gradgradcheck 也不是所有输入均正确的证明。本文只做静态阅读和公式检查,没有安装或执行 PyTorch、torchviz,也没有生成任何伪装成实测结果的图。
静态安全审核:示例未包含网络访问、凭证、文件删除或系统命令;主要实际问题是反例的计算图断裂,以及外部反向实现可能缺失高阶导数。本稿保留这些问题并解释其原因,没有把反例改写为可用实现。代码中的检查函数是读者可以执行的验证步骤,不是本次测试记录。未发现其他问题,不等于证明没有漏洞。
来源:PyTorch 官方教程原文。版权:Copyright (c) 2017–2022, Pytorch contributors;教程仓库采用 BSD 3-Clause License,完整许可文本随稿附上(BSD 3-Clause 文本)。本稿为中文翻译整理,新增版本说明、静态审核说明和一张原创概览图;五张 PyTorch 官方教程原始计算图均未经修改并在各自图注中标明来源。原技术示例的算法逻辑保持不变。










暂无评论内容