


扩展 Celery 消费者与启动依赖
本文合并翻译整理 Celery 官方用户指南的 Extensions and Bootsteps 与 Application 两章。核对日期:2026 年 10 月 5 日;源站当次显示 Celery 5.6.3 文档。原作者及文档贡献者保留署名;用户手册版权页署名 Ask Solem,Copyright © 2009–2016。
扩展 worker 时,最容易混淆的不是类怎么写,而是组件何时可用、连接断开后谁会重启,以及回调究竟在哪里执行。Celery 用 bootstep 描述组件生命周期,用 blueprint 组织依赖。普通任务通过任务池执行;自定义 Kombu 消费者的消息回调则是消费路径的一部分,不能自然等同于一个已获得重试、幂等和结果存储机制的 Celery task。
先建立明确的 application
Celery 使用前需要实例化 application,通常简称 app。官方说明它是线程安全的,同一个进程可以有不同配置、组件和任务的多个 app。Celery() 的字符串表示包含类名、主模块名和对象内存地址;这里真正影响任务身份的是主模块名。
任务消息不携带函数源码,只携带任务名。每个 worker 的任务注册表把任务名映射到本地函数。如果在交互式终端定义任务,或直接把任务模块当程序运行,任务可能叫 __main__.add;另一个进程导入同一模块时,它却叫 tasks.add。发送者和 worker 看到不同名称,就无法正确匹配。为 app 指定稳定名称,并让任务在双方以一致模块路径导入。
from celery import Celery

app = Celery("tasks")

@app.task
def add(x, y):
    return x + y

# 在这个模块作为主程序时,显式的 app 名让任务使用 tasks.add。
上例是命名教学,不是 broker 部署配置。不要把进程地址、示例输出或 __main__ 名称写进跨进程协议。
配置顺序与敏感信息
app.conf 可逐项赋值,也可用 update() 批量修改。配置查找依次考虑运行时修改、已加载配置模块和默认配置;额外默认源可由 app.add_defaults() 提供。
app.conf.update(enable_utc=True, timezone="Europe/London")
app.config_from_object("celeryconfig")
# config_from_object 会重置此前已设置的配置;补充覆盖应写在加载之后。
app.conf.update(timezone="Asia/Shanghai")
config_from_object() 接受模块名、模块对象或带配置属性的类/对象;也可使用 myproj.config:CeleryConfig 这样的完整路径。官方更推荐模块名字符串,尤其在 prefork 池中可避免序列化模块对象造成的问题。配置模块本质上是可导入的 Python 代码,因此配置路径必须来自可信部署,不应任由外部请求指定。
# celeryconfig.py
enable_utc = True
timezone = "Europe/London"

# 另一种加载方式:环境变量的值是模块名,而非配置文件内容。
import os
from celery import Celery
os.environ.setdefault("CELERY_CONFIG_MODULE", "celeryconfig")
app = Celery("proj")
app.config_from_envvar("CELERY_CONFIG_MODULE")
例如启动环境可设置 CELERY_CONFIG_MODULE=celeryconfig.prod。输出诊断配置时,可以用 app.conf.humanize(with_defaults=False, censored=True) 得到表格文本,或用 app.conf.table(with_defaults=False, censored=True) 得到字典。默认只列变更;with_defaults=True 才包含内置默认值。
遮盖不是保密保证。原文说明 censored 只按常见键名匹配,例如包含 API、TOKEN、KEY、SECRET、PASS、SIGNATURE、DATABASE 的键。自定义键可能漏掉,值里嵌套的秘密也不能假定全部安全。发布日志前必须再检查,最好只输出需要的非敏感配置。
app 的惰性初始化、任务绑定与应用链
构造 app 时,Celery 主要创建事件逻辑时钟、任务注册表,将自己设为 current app(除非禁用 set_as_current),并调用默认不做事的 on_init()。@app.task 不一定在定义瞬间创建最终任务对象,它可能先返回 PromiseProxy;访问对象、属性或 repr() 都可能触发求值。
显式调用 app.finalize(),或者访问 app.tasks,会使 app 完成初始化:复制应在 app 之间共享的任务,求值待处理的装饰器,并确保任务绑定到当前 app,以便读取配置默认值。任务默认可共享;装饰器的 shared 关闭后,则只属于其绑定的 app。
Celery 总会有一个 default app,但扩展组件最好显式接收 app,不要依赖隐藏的 current_app 全局状态。原文把逐层传递 app 称为“app chain”。内部的 app_or_default(app) 用于兼容选择;开发时可设置 CELERY_TRACE_APP=1 来帮助发现应用链断裂。
class Scheduler:
    def __init__(self, app):
        self.app = app
原文还回顾了 API 历史:早期可以直接发送任意 callable,这让非 pickle 序列化很困难,Celery 2.0 移除了这种方式,改用任务装饰器。老的模块级兼容 API 到 5.0 已移除,celery.task 不再可用。现代任务基类应从 celery import Task 导入,而不是复制历史的 celery.task.Task、celery.registry 或 celery.execute.apply_async 写法。
接入自定义 JSON 消费者
要在 worker 中手工处理独立消息,可以继承 bootsteps.ConsumerStep 并实现 get_consumers(channel)。它应返回一组 Kombu Consumer;每次连接建立时,这些消费者都会启动。下面保留原文的队列、exchange、routing key、JSON 序列化和 ack 流程;唯一配置性修改是将原文隐式 amqp:// 改为必须提供的环境变量,避免读者误用默认连接。
import os
from celery import Celery, bootsteps
from kombu import Consumer, Exchange, Queue

my_queue = Queue("custom", Exchange("custom"), "routing_key")
app = Celery("custom_consumer", broker=os.environ["CELERY_BROKER_URL"])

class MyConsumerStep(bootsteps.ConsumerStep):
    def get_consumers(self, channel):
        return [
            Consumer(
                channel,
                queues=[my_queue],
                callbacks=[self.handle_message],
                accept=["json"],
            )
        ]

    def handle_message(self, body, message):
        # 仅演示接收和确认;不是业务落盘或幂等处理。
        print("Received message: {0!r}".format(body))
        message.ack()

app.steps["consumer"].add(MyConsumerStep)

def send_me_a_message(who, producer=None):
    with app.producer_or_acquire(producer) as producer:
        producer.publish(
            {"hello": who},
            serializer="json",
            exchange=my_queue.exchange,
            routing_key="routing_key",
            declare=[my_queue],
            retry=True,
        )

if __name__ == "__main__":
    send_me_a_message("world!")
保存为模块后,worker 必须加载同一个 app,独立发送进程也必须导入同一个配置。此处不提供任何真实 broker 地址或凭据,环境变量不存在时程序会直接报错。环境变量本身不是加密方案;远程 broker 的认证、TLS、虚拟主机隔离及证书验证需按实际部署配置。
这段代码只证明协议结构。它打印后立即 ack,没有持久化业务结果,也没有输入结构校验、重复投递防护、失败处理、限流或死信策略。真实处理应先验证消息、完成可确认的业务提交,再决定 ack/reject/重试。生产者重试和连接中断可能造成重复消息,不能因为 retry=True 就声称恰好执行一次。不要把敏感消息体完整写入日志,也不要在消费回调里做长时间阻塞工作。accept=["json"] 保留了明确的格式限制;不要为接收不可信消息而扩大到 pickle。
Kombu 有两种回调接口。callbacks 接收若干 (body, message) 函数,消息已解码;on_message 接收单个 (message,) 函数,不会自动解码。需要时显式调用 message.decode(),并自行处理解码失败。原文示例还打印 message.properties 和 len(message.body),这类元数据同样应按敏感性筛选。
# 原文 on_message 形式的整理:解码动作显式可见。
def get_consumers(self, channel):
    return [Consumer(channel, queues=[my_queue],
                     on_message=self.on_message, accept=["json"])]

def on_message(self, message):
    payload = message.decode()
    print("Received message: {0!r}".format(payload))
    message.ack()
上面第二段也保留教学用 print+ack,额外加了与主例一致的 JSON 接收限制,未变成生产处理器。
Worker 与 Consumer 两套 blueprint
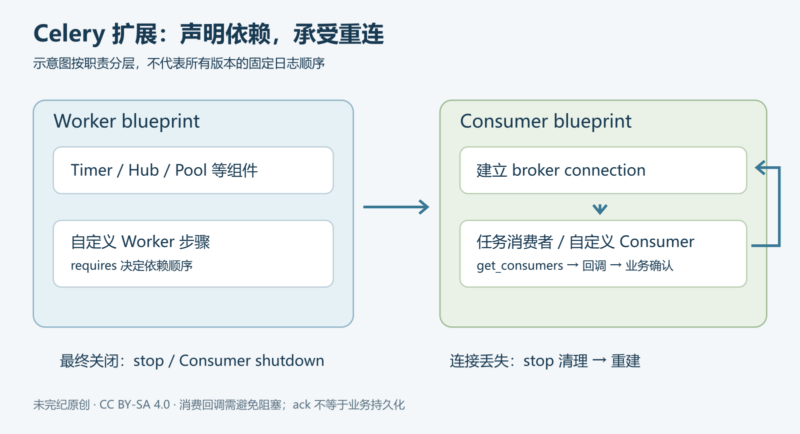
Bootstep 是一个定义生命周期钩子的类,每个步骤归属一个 blueprint。Worker blueprint 先启动,准备事件循环、执行池和 ETA/定时事件使用的 timer;然后启动 Consumer blueprint,由它建立 broker 连接、配置任务执行策略并开始消费。
扩展不是靠注册列表的位置排序。requires 描述依赖图,Celery 按图确定启动顺序。因此不要“碰巧”在某次日志中看见 Pool 已就绪,就跳过依赖声明。
| Worker 属性 | 用途与依赖 |
|---|---|
app / hostname / blueprint |
当前 app、节点名与 Worker blueprint。 |
hub |
事件循环,依赖 celery.worker.components:Hub;原文支持异步 I/O 的 amqp、redis transport,并要求 worker.use_eventloop 条件。 |
pool |
当前 process/eventlet/gevent/thread 池,依赖 celery.worker.components:Pool。 |
timer |
定时函数,依赖 celery.worker.components:Timer。 |
statedb |
跨 worker 重启保存状态;只有启用 statedb 参数才存在,依赖 celery.worker.components:Statedb。 |
autoscaler |
自动增减池进程;只在 autoscale 启用时存在,依赖 celery.worker.autoscaler:Autoscaler。 |
Worker 的核心对象是 WorkController,它会作为第一个参数传入钩子。__init__ 在构造时执行;create 可以返回一个提供 start/stop 的委托对象;start 在启动时执行,stop 用于正常关闭,terminate 用于终止。原文的简单示例如下,仅调整了注释与输出文字。
from celery import bootsteps

class ExampleWorkerStep(bootsteps.StartStopStep):
    requires = {"celery.worker.components:Pool"}

    def __init__(self, worker, **kwargs):
        print("WorkController constructed")

    def create(self, worker):
        return self

    def start(self, worker):
        print("Worker step started")

    def stop(self, worker):
        pass

    def terminate(self, worker):
        pass
这里没有打印全部 kwargs,避免把可能包含凭据的参数全部写入日志;stop/terminate 留空是该无资源示例的行为,不是有资源扩展的清理实现。实际扩展必须释放自己创建的计时器、连接、描述符和回调。
Consumer 的重连与资源清理
Consumer blueprint 在 broker 连接丢失时会重新启动,包含心跳、远程控制消费者、任务消费者等步骤。Consumer 步骤必须支持重复启动;stop 在连接重启及关闭时调用,额外的 shutdown 在 worker 最终关闭时调用。Worker 的 stop 则只在关闭时调用,不调用 Consumer 专用的 shutdown。
原文强调 stop/shutdown 要可重入;它们可能在信号处理器上下文执行,Python logging 并非可重入,不能假定在其中记录日志总是安全。资源句柄应在清理后置空,重复清理不要重复释放;重连时不要重复注册同一个回调或遗留旧定时器。
| Consumer 成员 | 含义 |
|---|---|
app, controller, hostname, blueprint |
当前 app、创建它的 WorkController、节点名、当前 blueprint。 |
hub, pool, timer |
事件循环、执行池、计时器;使用时须满足相应组件条件与依赖。 |
connection |
当前 Kombu 连接;依赖 celery.worker.consumer.connection:Connection。 |
event_dispatcher |
事件发送器;依赖 celery.worker.consumer.events:Events。 |
gossip |
worker 间广播通信;依赖 celery.worker.consumer.gossip:Gossip。 |
heart |
发送 worker 事件心跳;依赖 celery.worker.consumer.heart:Heart。 |
task_consumer |
处理任务消息的 Kombu Consumer;依赖 celery.worker.consumer.tasks:Tasks。 |
strategies |
每个已注册任务类型的执行策略映射,由 Tasks 步骤启动时建立,同时构建任务 tracer。 |
task_buckets |
按任务类型保存限流桶;无速率限制时可为 None。默认 TokenBucket 提供 consume(tokens) 和 expected_time(tokens),替代实现也要符合接口。 |
qos |
控制任务通道预取值,可用 increment_eventually(1)、decrement_eventually(1) 或 set(10);这些示例值不等于推荐生产参数。 |
常用方法也有不同职责:reset_rate_limits() 重建所有任务的限流桶映射;bucket_for_task(type, Bucket=TokenBucket) 根据任务 rate_limit 建桶;add_task_queue(name, exchange=None, exchange_type=None, routing_key=None, **options) 添加队列,cancel_task_queue(name) 取消队列,两者的效果会跨连接重启保留;apply_eta_task(request) 按 request.eta 调度任务。
原文高级示例中的具体缺口
这些例子适合理解挂接位置,但不能直接当作经过验证的生产算法。静态检查发现:
- DeadlockDetection:每 30 秒扫描活动请求、超时阈值 3600 秒、超时后抛出
SystemExit。示例未导入time,也未完整交代worker.active_requests的来源及时间戳时钟语义;“耗时长”本身不等于死锁。贸然退出 worker 会影响任务。可借鉴的是保存timer.call_repeatedly()返回的句柄,在 stop 中 cancel 并置空,而不是直接照搬退出逻辑。 - Gossip 集群限流:任务列表两项之间缺逗号,
self.app没有在示例中赋值;用活跃节点数做除数还需处理零值,延迟调用的参数与回调签名也不完整。重连时注册的事件回调需要清理。其思想是订阅 node_join、node_leave、node_lost,在集群大小变化后更新 rate_limit 并调用 reset_rate_limits;示例并未证明这种算法在分区、重复事件或零节点时正确。 - InfoStep:原文把 app 创建和
add(InfoStep)缩进到了 InfoStep 类体里,类名尚未完成绑定便被引用。应把注册放到类定义结束之后。
Gossip 的 node_join/node_leave 分别表示加入和离开;node_lost 只表示心跳没有及时收到或处理,并不能直接证明节点已经离线。原文用 10 秒延迟再次检查表达这个思想。这里保留机制解释,未提供未经验证的“修复版集群限流器”或自动杀进程算法。
安装步骤与观察启动过程
注册时添加的是类,不是实例;可一次添加多个步骤,依赖图决定顺序。
# 在所有相关类定义完成之后执行:
app.steps["worker"].add(ExampleWorkerStep)
app.steps["consumer"].add(MyConsumerStep)
# 若有 StepA 和 StepB:
# app.steps["consumer"].update([StepA, StepB])
原文 InfoStep 用 init、start、stop、shutdown 打印调用时点。概念上的顺序是 Worker/Consumer 构造、Worker 启动、Consumer 建立连接并启动、关闭时停止 Consumer 与 Worker、最后 Consumer shutdown。--loglevel=debug 会显示图构建和子步骤细节。文档展示的完整日志来自 2013 年,包含 guest 本地 AMQP 连接及旧组件顺序;它们不是 5.6.3 的本次运行证据,也不是现代部署的认证建议。
自定义任务处理日志
Celery worker 的任务生命周期日志格式字符串位于 celery.app.trace,例如 LOG_SUCCESS 与 LOG_REJECTED。可以覆盖这些字符串;任务名和 ID 可用于百分号格式化,有些事件还提供返回值或异常字段。
import celery.app.trace

celery.app.trace.LOG_SUCCESS = "Task completed"
celery.app.trace.LOG_REJECTED = "%(name)r rejected: %(exc)s"
替换模板前应核对该事件实际提供的键,不匹配会导致格式化错误。异常文本与返回值可能含敏感数据;输出层面的自定义不应成为泄漏入口。这里是原机制的中性文字示例,未在 worker 中执行。
把 Click 选项和子命令接入 Celery
worker、beat、events 命令各有 app.user_options 集合。加入 click.Option 后,相应参数会传给 bootstep 的构造函数。下例把原文未定义的 party() 替换为保存布尔选项,避免把教学占位函数误作可运行功能。
from click import Option
from celery import bootsteps

app.user_options["worker"].add(
    Option(("--enable-my-option",), is_flag=True,
           help="Enable custom option.")
)

class MyBootstep(bootsteps.Step):
    def __init__(self, parent, enable_my_option=False, **options):
        super().__init__(parent, **options)
        self.enabled = enable_my_option

app.steps["worker"].add(MyBootstep)
umbrella 命令还支持传给所有子命令的 preload 选项。原文用 -Z / --template 选择配置模板,默认 default,通过 signals.user_preload_options 接收解析结果并调用 use_template(options["template"])。use_template 是需要应用自行实现的函数,不是 Celery 内置 API;如果用模板名拼接文件路径或模块名,必须做允许列表验证,不得接受任意路径或代码。
增加子命令则通过包的 celery.commands entry point,值指向有效 Click command。以下保留 Flower 的演示结构;它只是说明插件如何注册,不是在安装或启动真实 Flower 服务。
# setup.py 的相关配置
entry_points = {
    "celery.commands": [
        "flower = flower.command:flower",
    ],
}

# flower/command.py 的教学用函数
import click

@click.command()
@click.option("--port", default=8888, type=int, help="Webserver port")
@click.option("--debug", is_flag=True)
def flower(port, debug):
    print("Running our command")
等号左边是子命令名,右边 flower.command:flower 是模块路径与属性名,二者用冒号分隔。这个 entry point 配置还需放进实际包构建配置并安装,单独声明字典并不会注册命令。
Hub 和 Timer 的接口边界
官方这一章把 amqp、redis 列为支持 worker 异步 I/O 的 transport;其他 transport 的机制要以具体版本核对。hub.add(fd, callback, flags) 是底层注册方式;add_reader(fd, callback, *args) 在可读时回调,add_writer(...) 在可写时回调;remove(fd) 移除该描述符的全部回调。fd 可以是整数,也可以是有 fileno() 的文件对象。一个 fd 一次只能关联一组现有注册语义,再次 add 会替换之前的回调;在描述符失效或显式移除前,注册会持续存在。
Timer 提供 call_after(secs, callback, args=(), kwargs=(), priority=0)、call_repeatedly(...) 和 call_at(eta, ...)。保留返回的定时任务句柄,才能在重连或关闭时取消。时间单位、回调参数和实际执行上下文必须核对;不应在事件循环里安排长时间阻塞工作。
自定义任务基类
@app.task 默认继承 app 的 Task 基类;可通过 base=OtherTask 改写。自定义通用基类应继承 celery.Task,它在绑定 app 之前是中性的,绑定后才读取 app 的配置。原文的 @app.task(base=OtherTask): 多了冒号,下面修正为合法装饰器语法。
from celery import Task

class DebugTask(Task):
    def __call__(self, *args, **kwargs):
        print("TASK STARTING: {0.name}[{0.request.id}]".format(self))
        return self.run(*args, **kwargs)

@app.task(base=DebugTask)
def add(x, y):
    return x + y
该章特别指出:覆盖 __call__ 时要调用 self.run 执行任务体,不能在这个示例中换成 super().__call__。如果没有自定义 __call__,worker 的 tracer 为优化会直接调用 run。也可在定义任务之前替换 app.Task = MyBaseTask,让后续任务统一继承自定义基类,例如设置默认队列。基类方法是否适合直接调用、worker 调用或其他上下文,仍需单独验证。
来源、许可与审核结论
两章的全部主题均已核对;重复 app 初始化和历史启动日志在中文稿中合并解释,保留实际 API、生命周期、默认值与历史演进。关于代码的变更已分别标注:broker 从默认字符串改为必要环境变量,on_message 加 JSON 限制,不输出完整构造参数,未定义演示函数改为明确教学逻辑,指出 InfoStep/Gossip/DeadlockDetection 缺口,修正装饰器多余冒号。
Celery User Manual 版权页规定文档按 CC BY-SA 4.0 发布。本文中文翻译整理及原创配图亦按 CC BY-SA 4.0 提供;保留 Ask Solem 和 Celery 文档贡献者归属,标明上述改编。
本次没有连接 broker、启动 worker、发送消息、安装插件或运行任一代码片段。静态审核已覆盖明示缺陷、反序列化、凭据、日志泄漏和生命周期风险,但不构成无漏洞、业务可靠性或执行成功保证。










暂无评论内容