


用集群、OSD 和 PG 状态定位 Ceph 健康问题
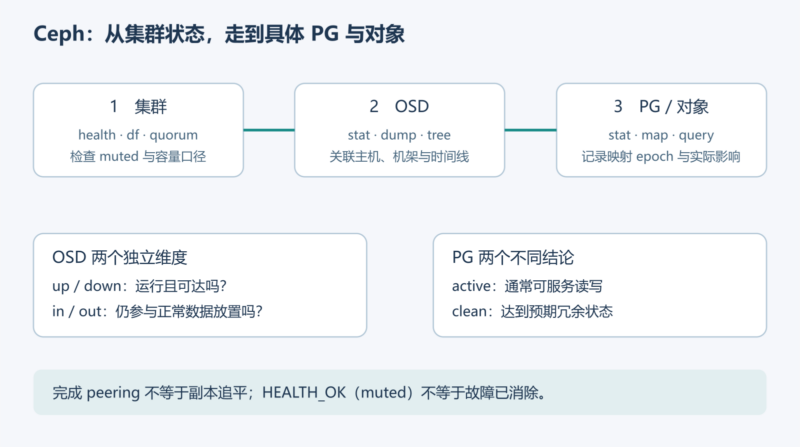
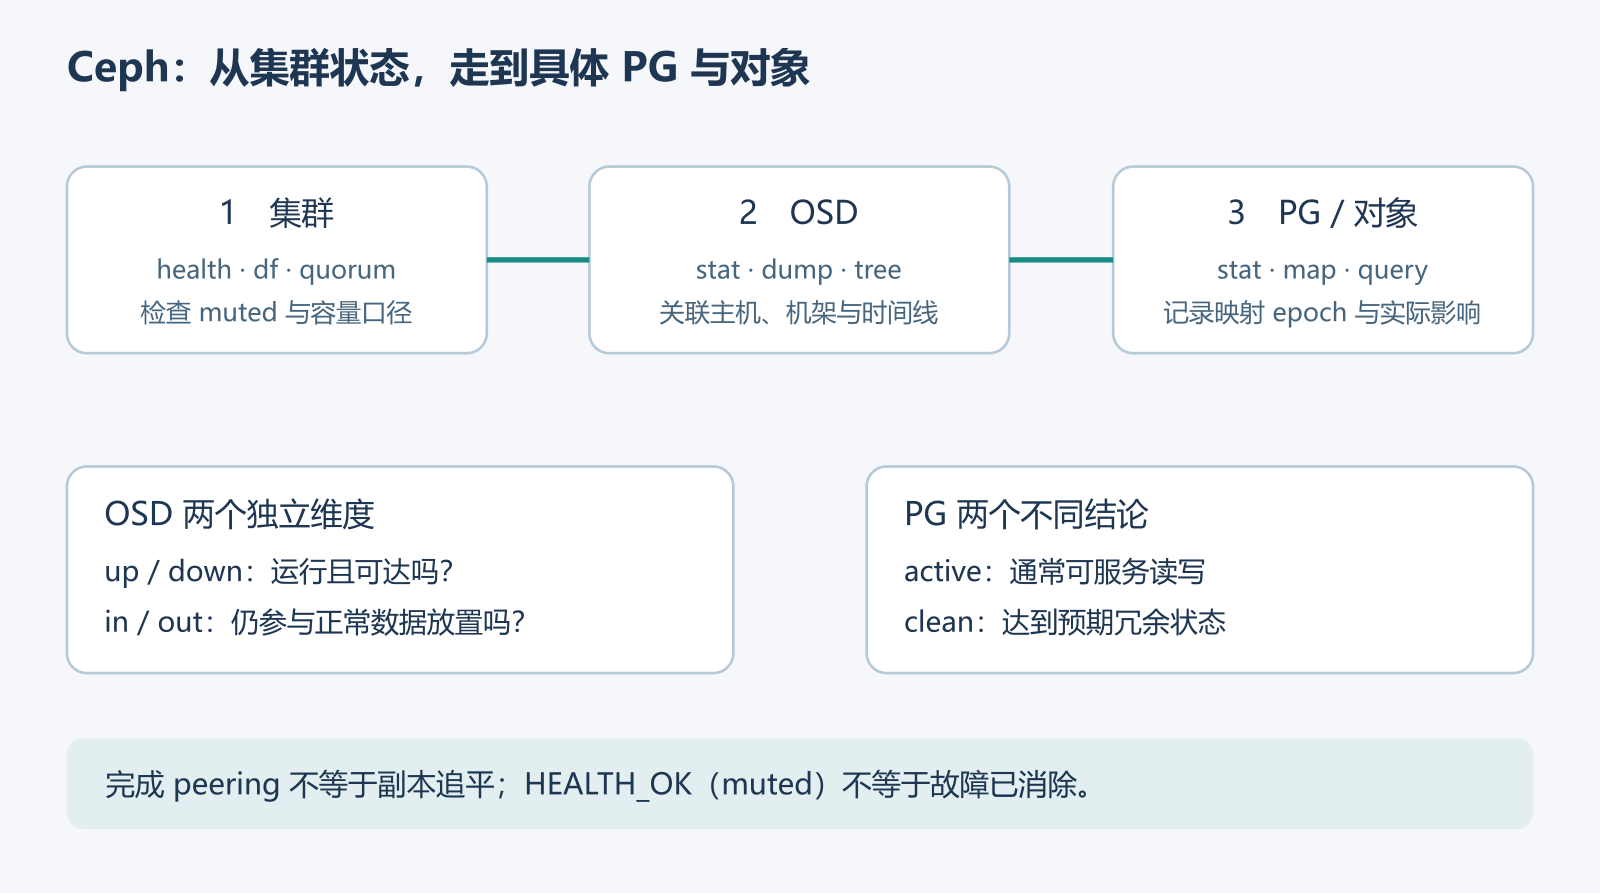
Ceph 的对象并不固定绑定在某块磁盘上。客户端根据集群映射把对象映射到放置组(PG),再由 CRUSH 与当前映射确定承载它的 OSD。因此,定位故障需要从集群整体状态下钻到 OSD 和 PG,再关联到具体对象;一处故障使某个对象不可访问,并不等于整个集群的所有对象都不可访问。
本文合并翻译整理 Ceph 文档贡献者的 Monitoring a Cluster 和 Monitoring OSDs and PGs 全文,核对日期为 2026 年 10 月 05 日。两页 latest 文档都明确标为开发版本;命令、字段、默认值与功能可用性必须按实际部署的发行版核对。本文仅静态审查,未连接任何 Ceph 集群,也未运行诊断、配置修改、对象写入或删除命令。
从状态与日志获得第一份事实
命令行中直接运行 ceph 可进入交互模式,再输入 health、status、quorum_status 或 mon stat。非交互模式的常见入口如下:
ceph status
ceph -s
ceph health
ceph health detail
非默认配置或 keyring 路径可显式传给工具:
ceph -c /path/to/conf -k /path/to/keyring health配置路径不是秘密本身,但 keyring 内容可能包含凭证;不要将其内容贴到公开排障记录。原文的状态输出包含集群标识、健康状态、mon 仲裁、mgr、MDS、OSD 的 up/in 数量,以及池、PG、对象数和容量。示例中的 “3 osds: 3 up, 3 in” 和 “16 active+clean” 用于解释格式,不能当成本次测试输出。
要连续观察集群日志,可使用 ceph -w;只看最近消息,可使用 ceph log last 50 这样的有界查询。原文默认集群日志路径为 monitor 上的 /var/log/ceph/ceph.log,容器化和不同发行版的日志收集位置可能不同。
OSD 下线时,健康状态可能出现 OSD_DOWN 和 PG_DEGRADED;恢复后,日志会先记录降级程度变化,随后记录检查清除。应保留时间顺序,避免只截取恢复后的单行 HEALTH_OK,而遗漏中间持续多久、哪些 PG 和对象受到影响。
HEALTH_OK 与告警静音
Ceph 持续执行健康检查,失败结果汇总到 ceph status、ceph health 和集群日志。查看 health detail,既要看状态,也要看是否有 muted 或 (MUTED)。
原文的 ceph health mute <code> 会修改告警呈现,让被静音的检查不再影响总体状态。如果集群只有一个 OSD_DOWN 告警并将它静音,就可能显示 HEALTH_OK (muted: OSD_DOWN)。因此 HEALTH_OK 不一定说明所有问题已修复。
静音可以带 TTL,例如 4h 或 15m;health unmute 可解除。通常故障清除后静音会消失,后续同类故障重新报告;--sticky 会使其在故障清除后仍保留到相应期限。具有阈值的多数检查在状况加重时会取消静音。静音是告警管理动作,不是修复措施,不应放入只读诊断脚本。本次没有修改任何静音状态。
容量:原始空间与池数据不要混算
ceph df
ceph df detail
ceph -s 的 usage 表示实际原始存储使用量;其中可用量与总量也按原始容量呈现。逻辑数据在副本、纠删码、分配粒度、元数据与内部开销影响下,会消耗不同的物理空间。要分别读 RAW STORAGE 和 POOLS 部分,而不是将两者直接求和比较。
| 范围/字段 | 应该怎样理解 |
|---|---|
| RAW:CLASS、SIZE、AVAIL | 设备类别(如 SSD/HDD)、受管理容量与空闲容量。 |
| RAW:USED | 用户数据消耗的原始空间,原文定义排除 BlueStore 数据库。 |
| RAW:RAW USED、%RAW USED | 包括用户数据、内部开销和保留容量;结合 nearfull、backfillfull、full 阈值观察。 |
| POOLS:ID、PGS | 池的 ID 与 PG 数。ID 是池标识,不是“池中节点编号”。 |
| POOLS:STORED、OBJECTS | 用户存储的数据量与逻辑对象数,不应按副本数重复计算为多份用户数据。 |
| POOLS:USED | 池在全部 OSD 上分配的空间,包含复制、分配粒度和纠删码开销,并考虑压缩节省与对象空洞;不含 BlueStore 数据库。 |
| DATA、OMAP | DATA 对应 RBD、CephFS 文件内容及 RGW 对象数据;OMAP 是键值元数据,常用于 CephFS 和 RGW。 |
| %USED、MAX AVAIL | 池的使用比例与估计还可写入的逻辑数据量,不是简单的全局磁盘剩余量。 |
| QUOTA OBJECTS、QUOTA BYTES | 对象数和字节配额信息。 |
| DIRTY | 缓存层中尚未刷回基础池的对象,仅适用于使用缓存分层的情况。 |
| USED COMPR、UNDER COMPR | 前者是压缩数据所分配空间及相应复制/纠删码等开销;后者是经过压缩处理且值得压缩存储的数据量,按副本汇总。 |
原文修订:集群监控页一处把 POOLS 整段概括为“不包含副本”,并把 ID 解释成节点编号,但它对 USED 的逐字段定义明确包含复制与纠删码开销。本文采用逐字段口径,修正这两处表述,不把所有池字段都泛称为逻辑量。
MAX AVAIL 还受副本或纠删码设置、CRUSH 规则、相关设备利用率和 mon_osd_full_ratio 影响。因此全局还有空闲容量,并不能证明某个池可以继续回填或写入。
Monitor 仲裁与 CephFS 元数据服务
有多个 monitor 的集群必须维持仲裁。启动后以及读写前,应检查 monitor map 和实际 quorum,而不只是确认进程存在:
ceph mon stat
ceph mon dump
ceph quorum_status
quorum 输出的关键字段包括 election_epoch、quorum 成员编号、quorum_names、quorum_leader_name,以及 monmap 的 epoch、FSID、feature 与地址。原文 JSON 中的旧版本 feature 名称和回环地址只展示结构,不应套到实际生产网络。
CephFS 的 MDS 提供元数据服务,相关检查包括:
ceph mds stat
ceph fs dump
核对 up/down、active/standby 等实际角色和状态。对象存储诊断与 CephFS 元数据可用性有关联,但正常的 OSD 数量不等于 MDS 服务也健康。
OSD 有两个独立的状态维度
up/down 表示 OSD 是否运行并可达;in/out 表示它是否仍在数据放置的服务集合中。up 的 OSD 可以是 in,也可以是 out。OSD 被标记 out 后,CRUSH 不再按正常规则向它分配 PG,集群会尝试向其他 OSD 迁移以满足冗余目标,但这不等于迁移瞬间完成。
原文修订:OSD/PG 页有一句“down 的 OSD 也会是 out”,与同页紧接着的 down+in 警告以及后文 down 到 out 的超时机制矛盾。本文明确区分两维状态,不能从 down 推断已经 out 或已完成数据迁移。
ceph osd stat
ceph osd dump
ceph osd tree
osd stat 给出总 OSD 数、up 数、in 数和 osdmap epoch。若 in 多于 up,应通过 tree 和 dump 找出差异,并沿 CRUSH 中的机架、主机和设备层级关联物理位置。启动、重启、增删 OSD 或修改 map 后,暂时的 HEALTH_WARN 可能是过渡状态;要看是否持续推进、持续多久,以及是否有用户访问受损。
原文示例包含启动 ceph-osd@1 的 systemctl 操作。这会改变服务状态,且不能直接适用于所有 cephadm 或容器部署;应先确认 OSD 下线原因、设备状态、部署方式和恢复计划,再决定是否启动。本文不将它列为自动修复步骤。
理解 PG、Up Set 与 Acting Set
池通过 PG 把对象间接映射到 OSD。三副本池可能把某个 PG 的副本分别放到三个 OSD,CRUSH 选择还要满足配置的故障域,因此大型集群中这些 OSD 编号通常不相邻。
Up Set 表示根据当前放置映射期望承载 PG 的 OSD 集合;Acting Set 是当前实际承担该 PG 请求处理的集合。正常情况下两者通常相同;新增或移除 OSD、恢复或回填期间可能不同。差异是继续调查的线索,不能单凭它宣布故障,也不能单凭一致就确认数据完整。
ceph pg dump
ceph pg map 1.4
这里 1.4 仅为文档式示例 PG ID。输出会给出 osdmap epoch、PG ID、up [...] 和 acting [...]。在原文的复制池语境中,Acting Set 中首个 OSD 为 primary。
PG ID 由池编号、小数点和十六进制 PG 编号组成,例如 1.4,池编号可由 ceph osd lspools 对照名称。不是对象 ID,也不是 OSD ID。原文某处示例排版出现多余空格,本文用合法连续格式说明。
ceph osd lspools
ceph pg stat
ceph pg 1.4 query
查询指定 PG 可得到 JSON 状态。若需要导出整体 PG 状态,可用 ceph pg dump -o pg-dump.json --format=json;这会写入本地文件,可能覆盖同名文件,且结果含拓扑信息。应选取受控路径,不把这一步当作纯无副作用的屏幕查询。
Peering、Active 与 Clean 不是同一件事
PG 在服务读写前,需要 primary 与其他相关 OSD 完成 peering:就 PG 的数据和元数据历史形成一致认识。完成 peering 只说明达成一致,不意味着每份副本已经持有最新内容。
原文用“权威历史”解释恢复基础:已向客户端确认的写入必须在对应 Acting Set 成员中留下可靠记录,Ceph 才能据此重建一组完整、有序的操作,使落后副本追到正确状态。因此不能为了让告警消失而忽略保存最新历史的 OSD。
| PG 状态 | 含义与观察重点 |
|---|---|
| creating | PG 正在创建,之后需要 peering。新建池或调整过程中可短暂出现。 |
| peering | 相关 OSD 协商 PG 的权威历史;不等同于副本内容已全部同步。 |
| active | 通常可以服务该 PG 的读写,但是否有缺失对象、冗余不足等还须看其他状态。 |
| clean | 相关 OSD 完成 peering,数据达到应有的副本/分片状态,没有待处理的多余副本。 |
| degraded | 数据冗余未满足目标。可以与 active 并存,但不代表所有对象都能访问;unfound 对象需要单独处理。 |
| recovering | OSD 返回后或其他恢复情形中,正在把落后内容恢复到当前状态。 |
| backfill_wait / backfilling | 等待回填或正在回填,例如新增 OSD 后重新分配 PG。 |
| backfill_toofull | 目标容量不足以接受回填;可能随数据重新分布而缓解,也可能需要容量/放置问题诊断。 |
| remapped | 映射改变,旧集合与新集合之间需要迁移或过渡。 |
| stale | monitor 没有收到该 PG 的及时状态报告,可能与 primary 下线或网络/上报故障有关。 |
状态可以组合,例如 active+clean+scrubbing。Scrubbing、恢复、回填和拓扑变化不都代表同一种故障;观察应围绕影响范围和进度展开。一个长期不推进的 inactive、stale 或 unclean 状态,比短暂的迁移状态更值得立即调查。
OSD 下线后,Ceph 可能在等待一段时间后将其标记 out 并重新映射。文档举出的 mon_osd_down_out_interval 默认值为 600 秒,但实际行为受配置和集群标志影响,不能依计时猜测已经迁移。
恢复和回填的资源争用
恢复本身会与业务 I/O 争用 CPU、磁盘及网络。一个机架交换机故障可能同时影响多台主机上的 OSD;此时应先解决共同根因,再评估恢复,避免只对单个守护进程反复启动。
原文列出的恢复参数包括 osd_recovery_delay_start(延迟开始恢复)、osd_recovery_thread_timeout、osd_recovery_max_active(并发恢复请求)以及 osd_recovery_max_chunk(恢复块大小)。这些参数说明资源限制的方向,不构成一套可直接套用的性能优化值。
回填涉及的原文参数与示例默认值如下:
osd_max_backfills:原文默认 1;启用 mClock 调度时通常不能直接按传统方式修改,除非明确启用osd_mclock_override_recovery_settings等对应机制。backfill_full_ratio:原文示例阈值 90%,通过对应 osd set-backfillfull-ratio 操作改变会影响集群行为,不能为了通过回填而盲目调高。osd_backfill_retry_interval:原文示例 30 秒;目标拒绝回填后按间隔重试。osd_backfill_scan_min/osd_backfill_scan_max:原文示例为 64 / 512。
不同发行版和 mClock 配置会改变有效值或参数作用。先查询本机发行版及实际运行配置,结合业务延迟、容量和恢复目标规划变更。本文没有执行任何恢复参数调整,也没有测量恢复速度。
从“卡住的 PG”找到下一步
Unclean 指冗余尚未达到目标,可能仍在恢复;inactive 表示无法处理读写,可能在等待持有最新数据的 OSD;stale 表示状态长期未上报,相关判断涉及 mon_osd_report_timeout。这些情况不能统一处理成“重启所有 OSD”。
ceph pg dump_stuck inactive
ceph pg dump_stuck stale
ceph pg dump_stuck unclean
原文语法还列有 undersized 与 degraded。本文将方括号和竖线表示的可选参数改为分开的具体查询,避免把文档语法误当作 shell 管道。得到 PG ID 后,再查询该 PG 的状态与映射、对应 OSD 和主机日志,结合时间线判断是网络、设备、容量还是拓扑问题。
从对象名称定位到 PG 与 OSD
定位对象需要池名称、对象名称,以及适用时的 namespace:
ceph osd map data test-object-1原文示例输出会显示 pool ID、对象名、原始哈希映射到的 PG 与实际 PG、Up Set、Acting Set 和 primary。例如它展示过对象映射到 PG 1.4、up 与 acting 均为 [0,1] 的结构;这只是原文格式示例。
对象位置会随集群变化而动态变化,因此应同时记录 osdmap epoch。要确认对象实际存在,需采用相应已授权的只读查询;映射计算本身不能证明内容存在、可读或完整。
原文附带一个练习:用 rados put 将本地测试文件写入 data 池,列出对象,再用 rados rm 删除。写入可能覆盖同名对象,删除会移除数据;这不是只读诊断。本文仅说明练习的目的,不提供可不加判断连续执行的创建—删除脚本,也未执行它。需要重现时,应另行使用明确授权的隔离测试池、唯一对象名和非敏感文件。
心跳与网络性能证据
OSD 通过心跳同时检测可用性和网络延迟。单个迟到响应可能只是负载较高;不同 OSD 对之间持续出现延迟,则可能涉及交换机、网卡或物理链路。原文中超过 1000 毫秒的心跳触发健康告警是文档默认行为示例,仍须核对实际阈值。
health detail 会列出相关 OSD、位置和延迟,但该健康项的输出行数有限。需要更完整信息时,原文使用 manager admin socket 的 dump_osd_network,也可以针对一个 OSD 查询它的交互:
ceph daemon /var/run/ceph/ceph-mgr.x.asok dump_osd_network 0x 与 socket 路径是示例,末尾 0 表示以零毫秒阈值返回全部网络性能信息,而不是把运行中的健康阈值修改为零。返回项包括 last update、stale、from osd、to osd、front/back 接口,以及 1/5/15 分钟的平均、最小、最大值和 last。应同时检查信息是否过期、方向是否对称及多对 OSD 是否共享同一故障域。
Admin socket 与 Messenger:读状态也有边界
ceph daemon 通过守护进程的本地 admin socket 工作,通常需要登录所在主机;ceph tell 则经 monitor 转发,不要求直接登录该主机。默认 socket 在 /var/run/ceph,实际部署可不同。先查询可用命令:
ceph daemon osd.0 help这个接口既能查询也能修改运行配置。原文介绍的 raise HUP 和 raise -9 可向守护进程发送信号,其中 -9 会强制终止进程;它们属于高风险控制操作,不能作为健康查询,更不能粘贴进监控脚本。本次没有运行任何信号或配置操作。
messenger dump 提供连接、socket、监听地址和 TCP_INFO 内核统计的快照。创建快照需要锁住连接数据结构,原文提示可能持续数十毫秒并干扰正常操作;可使用该版本支持的 dumpcontents 参数限制收集内容,避免高频全量采样。
ceph tell osd.0 messenger dump
ceph tell osd.0 messenger dump client
ceph tell osd.0 messenger dump client --tcp-info
未指定 messenger 名称时返回可用列表;client、cluster 对应相关网络,hb_ 前缀用于心跳。原文用 jq 提取每个连接的 conn_id、socket_fd、worker_id、连接状态、state、peer 标识,以及协议 v2 的 con_mode、crypto.rx 和 compression.rx;这些字段可帮助区分 crc/PLAIN 与 secure/AES-128-GCM 等示例连接模式,但不应将某次样例输出推广到整个集群的加密状态。
带 --tcp-info 时,可对已连接且 peer.type 不是 client 的项提取 tcpi_rtt_us、tcpi_rttvar_us 与 tcpi_total_retrans,观察 RTT、变化和重传。原文 jq 管道只做 JSON 筛选,没有执行返回内容;本文用字段解释替代长管道,保留所需技术信息,并避免把某一开发版 JSON 结构当作稳定 API。
开发版的池可用性统计
当前 latest 页还介绍:
ceph osd pool availability-status输出包含 UPTIME、DOWNTIME、NUMFAILURES、MTBF、MTTR、SCORE 和 AVAILABLE。只要池中至少一个 PG inactive 或存在 unfound 对象,原文就把该池视为 unavailable。可用性统计与用户实际请求成功率并非同一个指标,不能替代业务端 SLO 测量。
页面记录的计时更新规则如下;本文忠实保留当前文档的离散采样口径,不据它自行推导未验证的公式:
| 上次状态 → 当前状态 | uptime 更新 | downtime 更新 |
|---|---|---|
| 可用 → 可用 | 增加时间差 | 不变 |
| 可用 → 不可用 | 增加时间差 | 不变 |
| 不可用 → 可用 | 增加时间差 | 不变 |
| 不可用 → 不可用 | 不变 | 增加时间差 |
原文说明据更新后的计时计算 MTBF、MTTR 和可用性分数。人类可读输出的时间经过取整,精确秒数可通过 JSON/JSON-pretty 格式观察。默认更新间隔为一秒,两个采样点之间发生又恢复的短暂变化可能漏记。
功能默认关闭,enable_availability_tracking 控制启用;pool_availability_update_interval 控制间隔且不能小于 paxos_propose_interval。关闭期间保留上次分数,重新开启后继续更新。clear-availability-status 会清除某个池的历史分数,且功能关闭时不允许执行。启用、改间隔和清历史都属于变更,不在本文只读诊断范围;稳定版可能尚不提供这些命令,须先查自己的版本。
把调查结论落到明确对象上
一份有用的诊断记录应能回答:哪个时间窗内出现了哪个健康项,哪些 OSD 的运行或放置状态异常,哪些 PG 停留在何种状态,相关对象是否受影响,以及恢复是否持续推进。容量、仲裁、网络、映射与对象定位各自提供一部分证据,不能让一个看似正常的指标掩盖另一个维度的问题。
本文修正了源页的 down/out、池 ID 与容量口径歧义;将静音、服务启动、信号、配置调整、清统计和对象写删与查询分开说明。没有执行环境测试,所以没有“修复成功”或“没有漏洞”的结论。
作者、来源与许可
原作者与维护方:Ceph authors and contributors / Ceph 文档贡献者,文档由 Ceph Foundation 支持托管。原页版权为 Copyright 2016-2026, Ceph authors and contributors;仓库 COPYING 对 doc/* 另载 Copyright (c) 2010-2012 New Dream Network and contributors。两者均随本文保留。
文档采用 Creative Commons Attribution-ShareAlike 3.0(CC BY-SA 3.0)。本文为合并翻译改编,技术修订已明示,译文与原创示意图同样按 CC BY-SA 3.0 提供。原文链接见开篇;
许可与署名文件:完整 CC BY-SA 3.0 许可文本。










暂无评论内容