


用 Temporal 编排论坛主题采集:Activity、Workflow 与周期计划
来源与发布方:Temporal;原页《Build a data pipeline with Python》,标注更新日期 2023 年 5 月 1 日,未见可确认个人署名。本文为获授权中文译编;代码编辑差异另行说明。
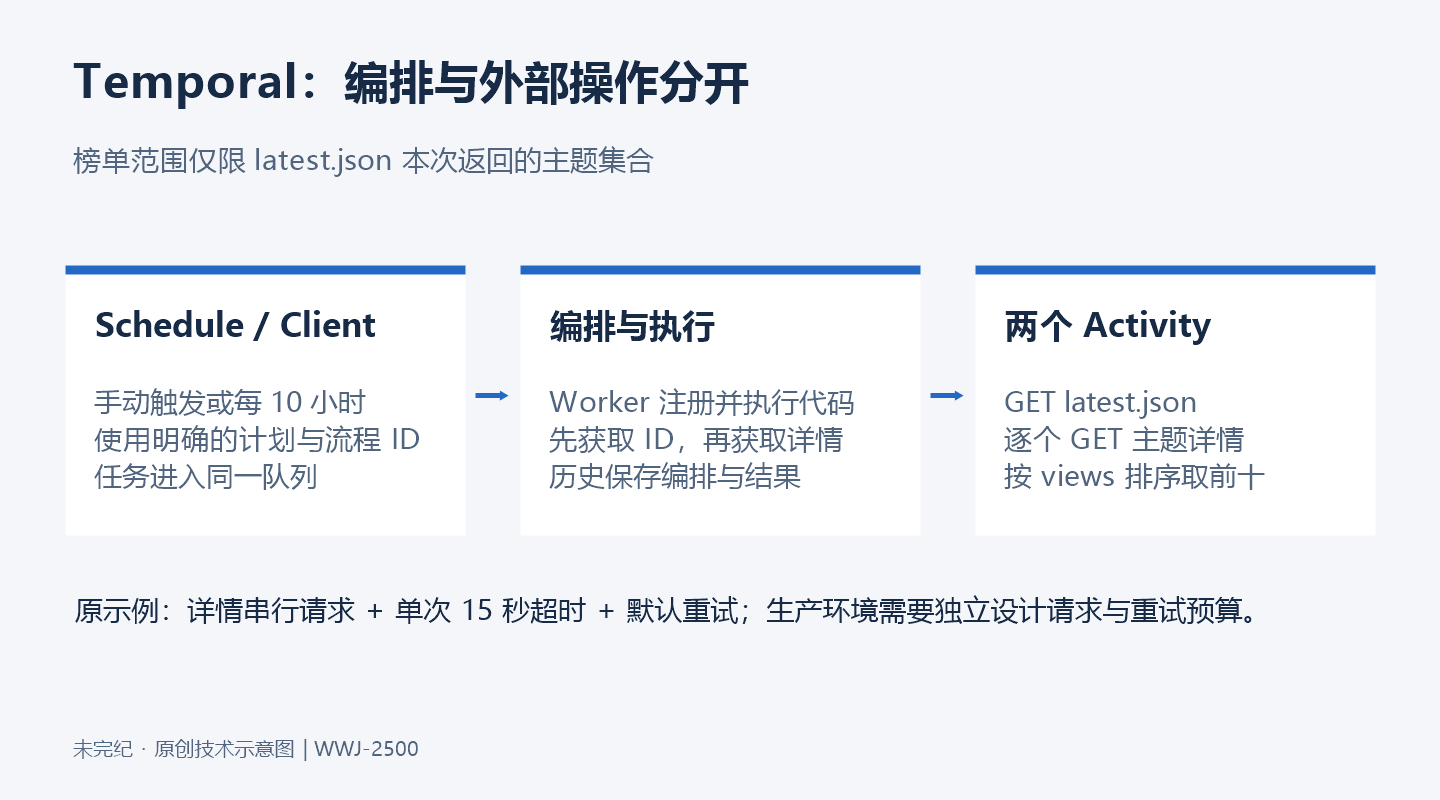
数据流水线通常包含三个部分:从来源获取数据,经过若干处理步骤,再把结果交给使用者。Temporal 用 Workflow 编排步骤,用 Activity 承载具体外部操作,并通过执行历史、超时与重试帮助处理失败。
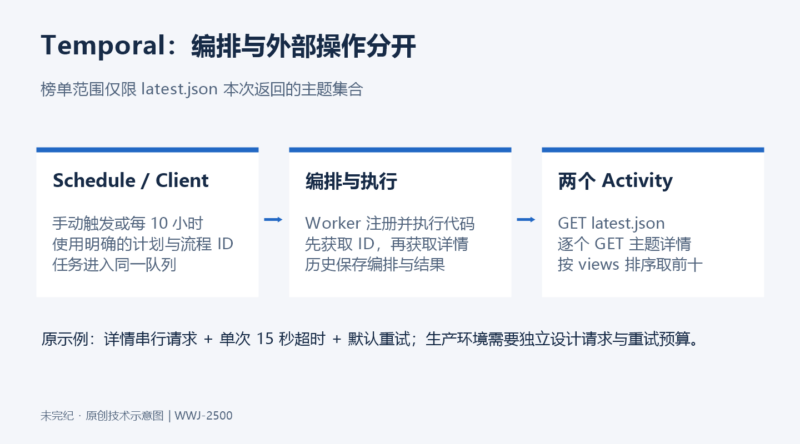
这个教程从 Temporal 社区论坛获取最新主题列表,逐个读取详情,按浏览量排序,返回其中前十条,然后创建每 10 小时运行一次的计划。统计范围必须说清楚:它只是在 latest.json 本次返回的主题集合中取浏览量前十,并不是全站最热榜,也不是“最近一段时间新增浏览量”的排行。
版本说明:原教程更新于 2023-05-01,列出的测试版本是 pandas 2.0.1 和 aiohttp 3.8.4。这些是原作者当时的记录,不是本文测试结果或当前安装建议。本文没有运行任何示例、请求论坛 API 或操作计划;编辑后的代码也只经过静态审核。
准备一个已有的 Temporal Python 开发环境
原文以前置的 Python Hello World 教程为基础:需要 Python SDK、可访问的 Temporal 服务以及能够运行 Worker 的 Python 环境,再安装数据处理与异步 HTTP 依赖。原文的安装形式为:
pip install pandas aiohttp这条命令没有锁定版本,也没有单独安装前置教程已经准备的 Temporal SDK。实际项目应在独立虚拟环境中选择仍受维护且相互兼容的版本,并记录依赖锁定结果;不要因教程列过旧测试版本就直接把它们作为生产配置。
下文保留六个文件组成的完整主线。除明确标出的展示修正、变量整理与删除命令 ID 更正,网络请求、两个 Activity、15 秒超时和计划间隔均保留原示例行为,因此后面的限制也仍然成立。
Activity:在外部系统上完成具体步骤
先建立 activities.py。数据类只返回标题、链接和浏览量;post_ids 获取主题 ID,top_posts 获取详情并排序。这里使用 aiohttp,使网络等待不会变成同步阻塞调用:
from dataclasses import dataclass
from typing import List

import aiohttp
from temporalio import activity

TASK_QUEUE_NAME = "temporal-community-task-queue"

@dataclass
class TemporalCommunityPost:
    title: str
    url: str
    views: int

@activity.defn
async def post_ids() -> List[str]:
    async with aiohttp.ClientSession() as session:
        async with session.get(
            "https://community.temporal.io/latest.json"
        ) as response:
            if not 200 <= int(response.status) < 300:
                raise RuntimeError(f"Status: {response.status}")
            payload = await response.json()
    return [str(topic["id"]) for topic in payload["topic_list"]["topics"]]

@activity.defn
async def top_posts(post_ids: List[str]) -> List[TemporalCommunityPost]:
    results: List[TemporalCommunityPost] = []
    async with aiohttp.ClientSession() as session:
        for item_id in post_ids:
            async with session.get(
                f"https://community.temporal.io/t/{item_id}.json"
            ) as response:
                if response.status < 200 or response.status >= 300:
                    raise RuntimeError(f"Status: {response.status}")
                item = await response.json()
                slug = item["slug"]
                results.append(
                    TemporalCommunityPost(
                        title=item["title"],
                        url=f"https://community.temporal.io/t/{slug}/{item_id}",
                        views=item["views"],
                    )
                )
    results.sort(key=lambda post: post.views, reverse=True)
    return results[:10]
社区基于 Discourse API。latest.json 响应中的 topic_list.topics 提供主题集合;每个 /t/{id}.json 返回主题详情,代码提取 slug、title 和 views。排序使用 reverse=True,最后取前十;不足十条时返回实际数量。
@activity.defn 让函数可以注册为 Activity。装饰器本身不会自动执行任务,也不意味着任意网络请求只会发生一次:活动失败后可能重试,副作用仍须由应用设计幂等性。这里主要是只读 GET,但重复请求仍会消耗论坛资源。
与原文差异:把 post_ids 内部响应变量改名为 payload,减少与函数名的混淆;把临时数据类构造合并进 append,排序变量名改得更清楚。请求顺序、URL、错误处理和返回含义没有改变。
Workflow:只负责编排
建立 your_workflow.py。先获取 ID,再把结果作为第二个 Activity 的参数:
from datetime import timedelta
from typing import List
from temporalio import workflow

with workflow.unsafe.imports_passed_through():
    from activities import TemporalCommunityPost, post_ids, top_posts

@workflow.defn
class TemporalCommunityWorkflow:
    @workflow.run
    async def run(self) -> List[TemporalCommunityPost]:
        news_ids = await workflow.execute_activity(
            post_ids,
            start_to_close_timeout=timedelta(seconds=15),
        )
        return await workflow.execute_activity(
            top_posts,
            news_ids,
            start_to_close_timeout=timedelta(seconds=15),
        )
@workflow.defn 标记 Workflow 类;同一个类中,用 @workflow.run 标记其异步入口。workflow.execute_activity 接收已定义的 Activity 及参数,还必须设置 Start-To-Close 或 Schedule-To-Close 等适用的 Activity 超时。
这里两个 Activity 都保留原文的 start_to_close_timeout=15 秒。它约束一次 Activity 尝试从开始到结束的时间,不等于整个 Workflow 的最长持续时间,也不包含完整的重试预算。
网络请求放在 Activity 中,Workflow 只使用结果继续编排。示例的 workflow.unsafe.imports_passed_through() 是 SDK 的导入机制名称,不是让读者绕过权限或在 Workflow 中任意执行外部 I/O 的指令。
默认重试不能代替错误分类
原文列出默认重试策略:初始间隔 1 秒,退避系数 2.0,最大间隔为初始间隔的 100 倍,最大尝试次数无限,默认不可重试错误列表为空。遇到暂时网络故障,这可以帮助流程等待恢复;但原示例把所有非 2xx 响应都抛成 RuntimeError,没有区分永久拒绝、请求错误和暂时故障。
静态审核发现:如果目标持续返回永久 4xx,仅靠原示例默认重试可能永不收敛。生产实现需要错误分类、总时限或尝试次数上限,以及可观察的失败出口。对 429 或暂时服务故障,还应尊重服务端限流信号;不能把“有重试”当作无限请求对方服务的理由。
第二个 Activity 的详情请求是串行的,所有主题共用 15 秒单次执行预算。集合大或网络慢时,可能每次都在后半段超时,再从头抓一遍。应先估算主题数量和端到端预算,再决定分页、有限并发、分批 Activity、明确 HTTP 超时、速率限制和检查点策略。本文没有随意扩大时限后宣称问题已解决。
Worker:注册代码并监听同一任务队列
建立 run_worker.py。Worker 连接本地 Temporal 服务,把 Workflow 和两个 Activity 注册到一致的队列名:
import asyncio
from temporalio.client import Client
from temporalio.worker import Worker

from activities import TASK_QUEUE_NAME, post_ids, top_posts
from your_workflow import TemporalCommunityWorkflow

async def main():
    client = await Client.connect("localhost:7233")
    worker = Worker(
        client,
        task_queue=TASK_QUEUE_NAME,
        workflows=[TemporalCommunityWorkflow],
        activities=[top_posts, post_ids],
    )
    await worker.run()

if __name__ == "__main__":
    asyncio.run(main())
客户端发起 Workflow 时指定的 Task Queue,必须与 Worker 监听的名称相同。workflows 和 activities 列表告诉 Worker 收到任务后应执行哪些代码。worker.run() 持续轮询并处理工作;只创建 Workflow 请求而没有运行对应 Worker,不会完成这些步骤。
连接边界:localhost:7233 是原教程的本地开发连接,没有展示 TLS、命名空间或生产认证。不能只把主机名换成公网地址就当成生产配置。本文没有连接任何 Temporal 实例。
启动 Workflow,并把结果交给 pandas
建立 run_workflow.py。客户端使用明确的 Workflow ID 和 Task Queue 发起执行,等待返回结果,再构造 DataFrame:
import asyncio
from dataclasses import asdict
import pandas as pd
from temporalio.client import Client

from activities import TASK_QUEUE_NAME
from your_workflow import TemporalCommunityWorkflow

async def main():
    client = await Client.connect("localhost:7233")
    stories = await client.execute_workflow(
        TemporalCommunityWorkflow.run,
        id="temporal-community-workflow",
        task_queue=TASK_QUEUE_NAME,
    )
    df = pd.DataFrame(
        [asdict(story) for story in stories],
        columns=["title", "url", "views"],
    )
    df = df.rename(columns={"title": "Title", "url": "URL", "views": "Views"})
    print("Top 10 by views within the latest.json topic set:")
    print(df)
    return df

if __name__ == "__main__":
asyncio.run(main())编辑修正:原文先 pd.DataFrame(stories),再强行把列名设成三列。结果为空时,DataFrame 可能没有列,直接改列名会失败。这里使用 asdict 和显式列名构造,再重命名展示列;空集合也保留列结构。输出说明改为“latest.json 集合内按浏览量排序”,避免把结果误称全站榜单。此修正版未执行测试。
在已启动本地 Temporal 服务、完成依赖准备的开发环境中,原教程用两个终端分别启动 Worker 与 Workflow:
# 终端一
python run_worker.py

# 终端二
python run_workflow.py
正常完成时,展示的是 Title、URL、Views 三列。原文有十条历史示例输出,其中浏览量随时间变化,本文不把它们当当前数据重列,也不生成伪造终端截图。
随后可在 Temporal Web UI 找到对应 Workflow,查看 Input and results 以及 Recent Events。事件历史记录编排过程和 Activity 结果,帮助恢复和重放;这并不表示任意 Activity 在函数内部执行到哪一行都能自动从该行续跑。需要继续内部长任务时,仍须设计合适的活动粒度与进度策略。
创建每 10 小时触发一次的计划
Temporal Schedule 将触发规则与要启动的 Workflow 放在服务侧管理,可以查看、暂停、触发、回填、更新和删除。它减少了对某一台机器上 cron 环境的依赖,但仍需要健康的 Temporal 服务、可用 Worker 和应用自己的监控。
建立 schedule_workflow.py:
import asyncio
from datetime import timedelta
from temporalio.client import (
    Client,
    Schedule,
    ScheduleActionStartWorkflow,
    ScheduleIntervalSpec,
    ScheduleSpec,
)

from activities import TASK_QUEUE_NAME
from your_workflow import TemporalCommunityWorkflow

async def main():
    client = await Client.connect("localhost:7233")
    await client.create_schedule(
        "top-stories-every-10-hours",
        Schedule(
            action=ScheduleActionStartWorkflow(
                TemporalCommunityWorkflow.run,
                id="temporal-community-workflow",
                task_queue=TASK_QUEUE_NAME,
            ),
            spec=ScheduleSpec(
                intervals=[ScheduleIntervalSpec(every=timedelta(hours=10))]
            ),
        ),
    )

if __name__ == "__main__":
    asyncio.run(main())
top-stories-every-10-hours 是 Schedule ID;action 中的 temporal-community-workflow 是 Workflow ID,两者有不同作用。ScheduleSpec 的 interval 决定每 10 小时触发一次。原文还提到 cron 表达式和日历规则,但本文的完整主线只使用 interval。
python schedule_workflow.py在 Web UI 的 Schedules 中,可以选择这条计划,查看未来触发时间和 Recent Runs。创建计划不是启动 Worker 的替代品;Worker 仍需持续运行。
生命周期边界:同一 Schedule ID 不能被当成每次随意重复创建的新计划;重复执行创建脚本应识别已有资源并按意图更新。直接运行和计划运行都使用固定 Workflow ID,也要考虑已有执行。原示例没有显式设置重叠策略。按当前 Temporal 官方文档,未覆盖默认值时使用 Skip:若前一次运行还未结束,本次到期触发会被略过,不会缓冲或排队,也不会与它并行。该默认值应按所部署服务与 SDK 版本复核;需要其他行为时再显式选择并评估后果。参见 Temporal Schedule overlap policy 与 Python SDK 策略定义。
原文建议把 10 小时改成 1 分钟,方便观察多次触发。本文只保留这项说明,不建议对公共论坛以高频方式反复抓取;需要快速观察调度时,应优先使用本地模拟数据或受控测试服务。
删除计划,明确被操作的 ID
原文最后提供清理计划的代码。建立 delete_schedule.py:
import asyncio
from temporalio.client import Client

async def main():
    client = await Client.connect("localhost:7233")
    handle = client.get_schedule_handle("top-stories-every-10-hours")
    await handle.delete()

if __name__ == "__main__":
    asyncio.run(main())
它获取的是 Schedule handle,delete() 删除相应计划。执行前必须确认服务、命名空间和 ID;本文仅保存示例,未执行删除。
python delete_schedule.py

# 等价 CLI 形式:仅在确实要删除这条计划时使用
temporal schedule delete --schedule-id top-stories-every-10-hours与原文差异:原文 CLI 使用泛指的 workflow-schedule-id,这里改为示例实际创建的 Schedule ID。删除计划与终止已经启动的 Workflow 是不同的操作;不能据此断言所有已发起执行都被撤回。
扩展为词频分析前,先补齐真正的新步骤
原文的 Next steps 建议新增一个 Activity,统计主题标题里出现最频繁的词或话题,再用结果生成词云。接入位置有两处:Worker 的 activities 列表要注册新函数,Workflow 则在 top_posts 后调用它。
静态审核更正:原文扩展片段把 top_posts = await workflow.execute_activity(top_posts, ...) 写在函数内部。左侧赋值会使同名标识被视为局部变量,右侧在赋值前引用它可能触发 UnboundLocalError。应把结果命名为 top_post_results 等不同名称,再把它传给下一步。
此外,freq_occurring_words 在原文中没有实现,也未给出分词、停用词、语言和返回结构。它是练习方向,不是已经完成的功能。本文没有编造一个词频输出,也没有把这部分计入上述六个文件的运行闭环。
进入实际业务之前的检查
如果把示例迁到自己的论坛或内部系统,应明确分页与统计窗口、请求配额、网络超时、永久错误和临时错误的分类、重试预算、计划 ID 以及重叠策略。凭证应通过受控的配置或密钥管理注入,不应写进代码、日志或 Workflow 输入。
事件历史会保存输入和返回值。本示例只返回标题、链接、浏览量和主题 ID 等必要数据,并不需要把完整论坛正文作为 Workflow 结果长期保存。生产环境仍需确定载荷大小、个人信息和保留周期;不要为了调试直接打印整份 API 响应。
本次静态检查没有发现示例中的硬编码秘密或直接执行外部文本的逻辑,但这不是无漏洞证明。完整教程提供的是编排模型和一条可理解的教学路径;可靠性仍依赖明确的业务范围、错误策略与经过验证的运行环境。
来源:Build a data pipeline with Python,Temporal 官方教程,原页更新于 2023-05-01;配套示例仓库。原站版权声明为 © Temporal Technologies Inc.;未核实到单篇独立许可,不擅自标成 MIT。本文中文译编及原创配图按单独授权范围交付;未确认单篇独立开放许可。










暂无评论内容