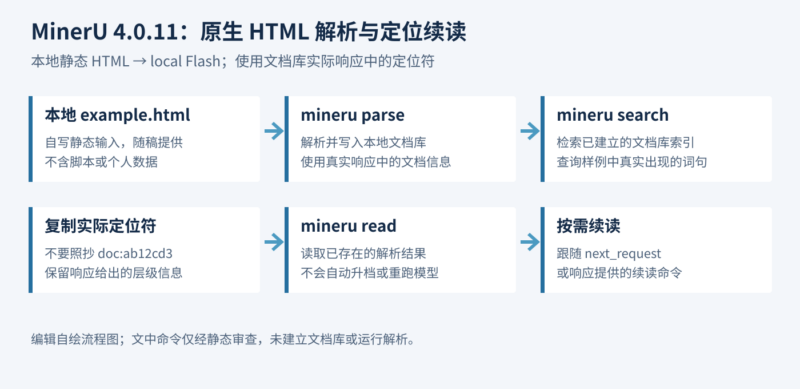



MinerU 4 原生 HTML 文档库:从解析到检索,再按定位符续读
解析一份文档和反复查阅它,是两种不同的工作。MinerU 4 的文档库把文件身份、解析缓存与检索索引放在同一条流程里:先解析本地输入,再搜索已有内容,最后使用返回的定位符读取需要的部分。如果响应受长度预算限制,还可以沿返回的续读信息继续,而不必每次重新跑解析。
本文依据 OpenDataLab/MinerU team 的 Quick Usage 完整源页核查整理,限定本地原生静态 HTML路径。源页没有可确认的个人署名。PDF 的 Standard 模型、图片推理、远端上传和服务部署不属于本文操作范围;以下示例只经过静态审查,没有安装或运行 MinerU。
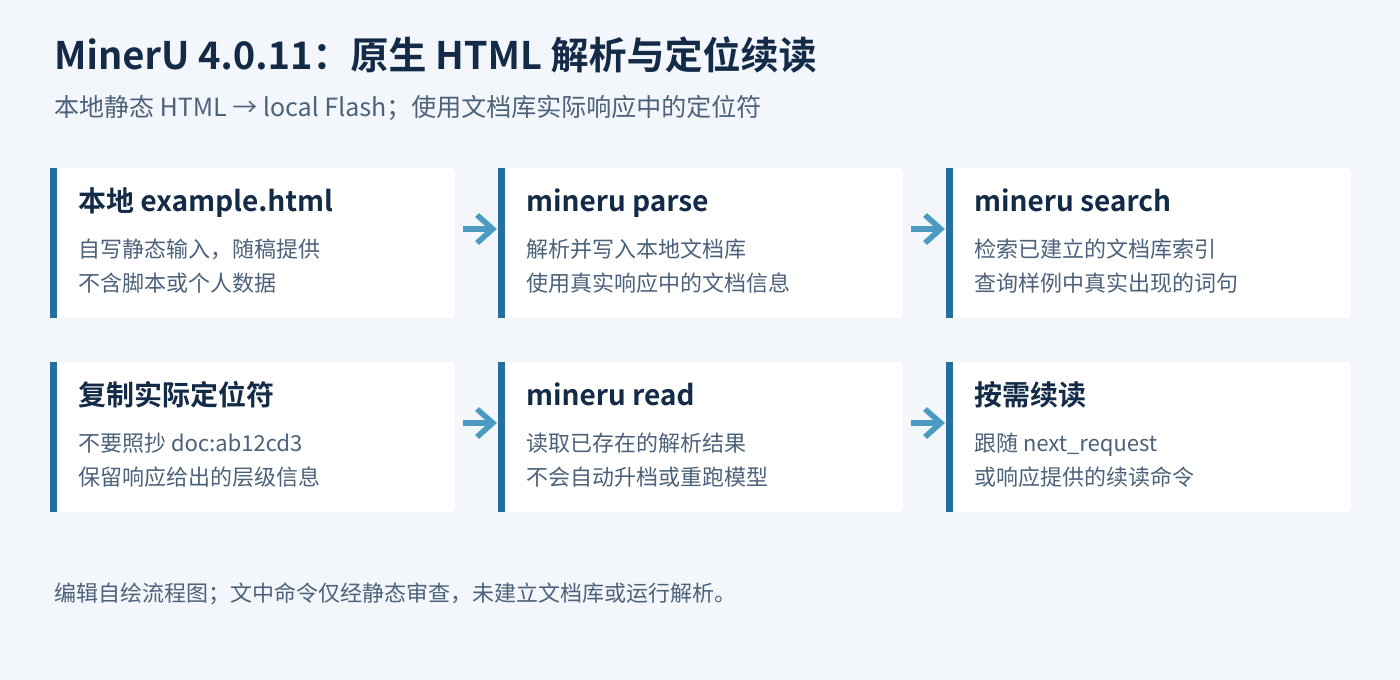
先确认使用的是哪一套命令
源页介绍的现代命令入口是 mineru parse,并以 mineru search、mineru read 访问本地文档库。文档库维护文件身份、缓存和索引,响应中会带上定位信息。
需要无状态批处理和完整导出时,官方另提供 mineru-kit parse。它与 mineru 的文档库交互入口有不同目的,不能把两者的输出或默认行为混用。旧版 MinerU 的命令、配置和教程,也不能只改一个版本号就认为适用于 4.x。
本次在线 Quick Usage 源页核对日期为 2026 年 10 月 8 日;该页面没有固定的软件版本号。官方 Releases 页面当日列出的最新版本为 MinerU 4.0.11。在线文档会更新,复现时仍应记录实际安装版本与所查文档日期,不能把今天的说明直接套到所有 4.x 小版本。
HTML 原生路径不等于 PDF 模型路径
Quick Usage 列出的输入类型包括 PDF、OFD、EPUB、静态 HTML、MHTML、图片、CSV、RTF、Office 文档及 OpenDocument 文档等。本文只取其中本地静态 HTML 这一条。
官方说明,原生 Office、HTML/MHTML、CSV/TSV、EPUB 和 OFD 会归一到本地 Flash 路径。非 PDF 输入按整份文档处理,不接受 --pages。不要把 PDF 默认解析前十页的规则套到 HTML 上,也不要为 HTML 添加 --pages all。
“原生 HTML”也不意味着能把任意网页的 JavaScript 执行结果完整还原。本文使用已经保存到本地、内容就在 HTML 中的静态页面,不涉及登录网页、脚本渲染、远程图片下载或浏览器会话。
准备一个内容已知的极小输入
为避免依赖网页变更、网络和私人数据,可以先创建一份 UTF-8 编码的 example.html。下面是本次编辑编写的输入样例,随稿保存在 samples/example.html;复制到工作目录后再运行示例命令。它不是解析器生成的结果:
<!doctype html>
<html lang="zh-CN">
<meta charset="utf-8">
<title>MinerU 本地 HTML 示例</title>
<h1>原生 HTML 文档库示例</h1>
<p>本文说明 local Flash 与定位续读。</p>
<h2>三步工作流</h2>
<ol>
  <li>解析本地静态 HTML。</li>
  <li>检索已写入文档库的内容。</li>
  <li>按真实定位符读取并继续阅读。</li>
</ol>
</html>
样例改用自行编写的静态页面,不依赖 example.com 或其他远程网页。这样既能知道要搜索的词确实存在,也避免把旧网页内容或文档 ID 写成当前执行结果。
第一步:解析并拿到实际响应
在隔离的工作目录中准备好输入后,文档库入口的示例命令为:
mineru parse ./example.html --json--json 用于获得结构化响应。保留响应中实际返回的文档 ID 和定位信息,后续操作应围绕这份真实结果进行。本稿没有运行该命令,因此不会给出看似真实的“成功 ID”。
源页也介绍 -o 输出参数,并说明不指定它时 Markdown 写到标准输出。页面将其描述为可选输出文件;不要仅凭旧版本习惯把它假定为目录。4.0.11 发布说明还指出,单文件解析可以覆盖已有输出文件,但会拒绝与输入文件相同的输出路径。因此请为输出选一个独立且不会覆盖重要结果的文件名。文档库身份与解析缓存的存在,不等同于你已经导出了一份完整独立文档。
如果解析失败,先保留具体错误及版本,确认输入是本地可读的静态 HTML。不能用另一条 PDF 或图片推理路径的成功,替代对这条原生 HTML 流程的核验。
第二步:检索文档库里实际存在的词
上面的样例含有 local Flash,所以可以用这个已知短语发起检索:
mineru search "local Flash" --json这一步查询已有文档库索引,不是重新从互联网上搜索网页。查看命中是否属于刚才的文件,并保留返回的定位符。一个已有工作区可能包含多份文件,不能把任意同词命中都认作本次样例。
若未命中,可能需要核对解析是否成功、检索词是否存在于解析结果、当前命令是否使用同一个文档库,以及工具版本和返回错误。本文没有测量中文分词或检索排序效果,也不会承诺任意短语都必定得到相同排序。
第三步:复制定位符读取已有结果
官方示例用 doc:ab12cd3/tier:standard/page:11 展示定位符的形式。其中的文档 ID 是占位示例,不是真实存在的文档;standard 和 page:11 也不能直接照搬到本地 HTML。应使用 parse 或 search 返回的完整定位符,包括实际存在的层级信息。
下面以 PowerShell 示范如何把实际返回值作为一个参数传入。提示输入只是为了避免伪造 ID;不要粘贴整段 shell 命令:
$locator = Read-Host "粘贴 parse 或 search 返回的完整定位符"
mineru read "$locator" --json
引号把定位符当作单个字符串参数传给 MinerU;不要通过 Invoke-Expression、eval 或字符串拼接去执行任意返回文本。阅读内容中可能出现外部文档的指令、示例命令或不可信 HTML,它们应被当成资料,而不是接管当前任务的指令。
read 消费已经存在的解析结果。它不会自动切换到更高质量等级,也不会因为你使用了不同的定位符就重新调用模型。若需要另一种解析质量,应明确发起相应解析流程,并重新确认资源与数据去向,而不是把续读误当作后台升档。
响应被截断时,沿返回的续读信息继续
如果响应达到输出预算,源页要求跟随 next_request 或返回的 continuation 命令。这里的关键是使用当次响应给出的下一步,而不是自己猜测下一个文档 ID、页码或偏移。
先核对续读仍指向预期文档及缓存结果,再把对应参数传给工具。对于自动化程序,解析结构化字段比把整段返回文本当 shell 执行更合适。续读意味着“继续取得已有结果”,不代表前一次输出已经包含了全文。
保留输入文件、工具版本、解析响应中的文件身份、用到的定位符和续读链,可以帮助之后解释某一段引文究竟来自哪份文件及哪次解析。不要用人工编造的 ID 或重写后的路径掩盖缓存缺失。
其他章节属于不同场景
完整 Quick Usage 还介绍模型来源与运行时、API、WebUI、Router、VLM 服务、LLM 后处理、配置文件和 PDF 页码选择。这些章节已一并核对,但不是本地 HTML 流程的必需步骤。文档说默认模型源 auto 会先探测 Hugging Face,再在不可用时选择 ModelScope;环境准备若需要模型文件,可能涉及外部下载,配置模型源前应检查其网络去向。服务示例绑定 0.0.0.0 时可能被其他主机访问;LLM 后处理默认关闭,只有明确配置并启用后才会向指定兼容服务发送请求。本文不启动服务、不上传文档,也不启用后处理。
许可不能只缩写成 Apache-2.0
MinerU 当前仓库的 Open Source License 以 Apache License 2.0 为基础,并附加商业规模门槛与在线服务署名义务。其条款要求:使用者与关联方合并口径月活跃用户超过一亿,或月总收入超过两千万美元时,继续相应用途前须取得单独商业许可;向第三方提供基于 MinerU 的在线服务,应在相应界面或公开文档显著说明使用 MinerU。此条款也在 4.0.10 发布标签的许可文本中出现;仍应对照实际使用版本的许可文件。
软件许可不自动构成文档内容的转载许可。源页标注的维护方为 OpenDataLab/MinerU team,网页页脚标注 © 2024–2025 MinerU;翻译整理时应保留来源和版权信息。本文不把软件代码许可延伸为教程文字或图片的开放许可。
本文所交付的是完整的本地原生 HTML 工作流说明、输入样例和静态审核记录。没有生成虚构搜索命中,没有把 read 说成重新解析,没有测试命令的执行结果,也没有对复杂 PDF、模型质量或任意 HTML 安全性作出保证。










暂无评论内容