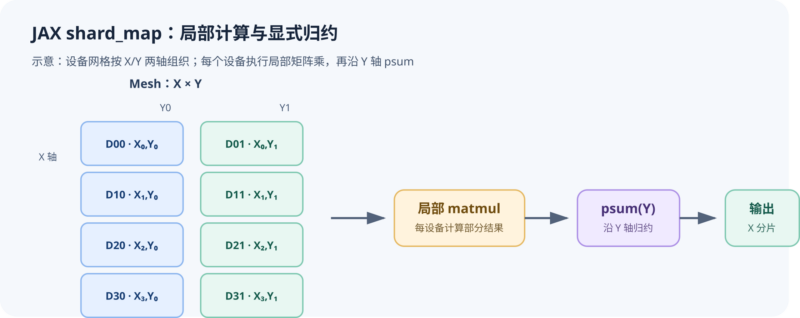



从自动分片到 shard_map:JAX 分布式数组与手动并行
JAX 的多设备并行有三种可以混合使用的方式。Auto 模式让程序保持全局数组视角,由编译器决定数据如何分片、计算如何分配及何时通信;Explicit 模式也保持全局视角,但分片进入 JAX 类型,可由程序明确指定和查询,计算划分仍交给编译器;Manual 模式让函数看到每台设备上的局部数据,并显式编写集合通信。
本文范围是 JAX 201 官方的两篇完整教程:Distributed arrays and automatic parallelization 与 Manual parallelism with shard_map。正文翻译整合两页各章的 Mesh、分片模式、布局、集合通信与并行案例;文末按源页顺序附回全部 fenced code examples 和源文件中已有的文本输出。原作者:The JAX authors;官方文档标注 © 2024 The JAX Authors。JAX 官方仓库根目录采用 Apache License 2.0,完整许可文本随本稿提供于 LICENSE-APACHE-2.0.txt。本稿为中文翻译与编辑改写,含新增说明和原创配图,并保留原作者、版权和来源链接。本文核对的两篇官方源文件来自提交 d353d04d62cab4d794df83762f531b02af74da0c(两页最后修改于 2026-09-22);附录含 109 个代码单元、16 个独立 Python 代码块、1 个伪语法块和 1 个原有文本输出块。2026-10-08 核对时,最新稳定发布为 JAX 0.11.2(2026-09-17);官方 /latest/ 文档滚动更新,且本次文档修订晚于该发行版,所以版本号不是这些代码已在 0.11.2 上运行的保证。JAX 的版本兼容规则及 jax.experimental 稳定性边界见 API compatibility。源 Markdown 未保存 notebook 代码单元的执行输出;附录只保留源文件中显式存在的文本输出,本稿没有执行代码、编译、初始化设备或测量性能。
示例采用当前文档中的 jax.P、jax.set_mesh、轴类型系统和 check_vma 等 API。它们必须与安装的 JAX 版本匹配。文档用 jax.config.update('jax_num_cpu_devices', 8) 模拟八个 CPU 设备;这应在设备初始化前设置,不表示当前机器实际拥有八个加速器。本文没有执行这些设置、代码、断言或编译。
| 模式 | 代码观察数据的视角 | 显式决定分片 | 显式集合通信 |
|---|---|---|---|
| Auto | 全局 | 通常交给编译器,可加约束 | 否 |
| Explicit | 全局 | 是,体现在类型中 | 否 |
| Manual | 每设备局部 | 是 | 是 |
一、Mesh 是具有命名轴的设备网格
先看显式模式的例子:建立形状为 (4, 2)、轴名为 ('X', 'Y') 的网格,将 (8, 4) 数组放置为 jax.P('X', 'Y')。类型显示为 float32[8@X,4@Y],每台设备持有一个 (2, 2) 块。对它计算 jnp.sin(x).T,结果类型是 float32[4@Y,8@X]:正弦和转置的计算已经自动分配到承载输入与输出的设备上。
网格不只表达设备数量。设备间通信沿网格轴进行,因此网格形状及设备排列会影响通信性能;合理的网格应尽可能反映物理连接拓扑。
抽象网格 AbstractMesh 只包含轴大小、轴名和轴类型;轴类型是 Auto、Explicit 或 Manual。具体网格 Mesh 还包含实际设备对象组成的 NumPy 数组,axis_sizes 对应设备数组的 shape。附录保留原文用于解释这些字段的概念类定义,它们不是需要自行替代 JAX 内置类的实现。
在程序顶层可直接调用 Mesh 构造函数,精确指定设备顺序;也可用 jax.make_mesh,让它根据硬件拓扑选取顺序。这里有一个容易忽略的默认值差异:jax.make_mesh 默认各轴是 Explicit;由于历史兼容原因,直接调用 Mesh 构造函数默认却是 Auto。直接构造 Mesh 时最好明确传入 axis_types。
jax.set_mesh(mesh) 可以全局设置具体网格,也可以写成上下文管理器 with jax.set_mesh(mesh): ...。在顶层可用 jax.get_mesh() 查询具体网格。进入 jit 后只能查询或更改抽象网格:分别使用 jax.sharding.get_abstract_mesh() 和 jax.sharding.use_abstract_mesh(...)。轴大小、轴名、轴类型可变,但网格总设备数,也就是各轴大小的乘积,不能变。
原文演示在 jit 内把 4 × 2 网格改为名叫 A 的长度 8 抽象轴,再将数组重分片为 jax.P('A', None),结果类型为 float32[8@A,4]。这里变化的是分布式布局语义,不能把它理解为增加设备。
二、Sharding 表达数组如何放到 Mesh 上
jax.sharding.Sharding 描述分布式内存布局:数组元素分别位于哪些设备的物理内存。顶层每个 jax.Array 都有自己的 Sharding。设置网格后,数组通常携带 NamedSharding,由一个具体 Mesh 和一个 PartitionSpec 构成;jax.P 是 PartitionSpec 的别名。没有设置网格的普通单设备数组通常使用 SingleDeviceSharding。
P('X', 'Y') 表示第一数组轴沿 X 分片、第二轴沿 Y 分片。通过 x.addressable_shards 可逐个查看本进程可寻址设备及其本地数据;原文的八个设备依次持有 8 × 4 全局数组的八个 2 × 2 子块。
用 jax.device_put(x, jax.P('Y', 'X')) 或 jax.reshard(x, jax.P('Y', 'X')) 可得到新的布局。已有上下文网格时可直接传 P;也可传完整 NamedSharding。device_put 是功能更多的运行时 API,reshard 则能在顶层与 jit 中一致表达重布局。
P('X', None) 只沿 X 分片,没有提到 Y,因而数据沿 Y 复制;末尾 None 可省略,所以这里的 P('X') 含义相同。每一对沿 Y 排列的设备持有相同的两行、四列数据。P(('X', 'Y')) 则把同一个数组轴沿两个网格轴共同切分,示例的八行分别放到八台设备。
还有第三种状态:P('X', None, unreduced={'Y'})。沿 Y 的物理块不是副本,而是尚未归约的部分和;逻辑数组值等于沿该轴把物理块相加后的结果。原页把原数组部分位置置零分散到两份物理数据中,以说明“unreduced”不是复制。延后归约在自动微分中尤其有用,进一步细节见 Autodiff and sharding 的相关说明。
每个数组都拥有自己的 Sharding,其中又有自己的 Mesh,因此同一作用域的数组可以关联不同网格。原文另建长度为 8、轴名为 A 的网格,用完整的 jax.NamedSharding(mesh2, jax.P('A', None)) 放置新数组,而原有数组仍保留 X/Y 网格。
三、Explicit:分片成为可查询的类型信息
在显式模式中,jax.typeof(x).sharding 在顶层和 jit 的追踪期间都可查询,因此也称“sharding in types”。类型表示大致是“dtype[大小@网格轴, …]”。出现的网格轴必须来自该值类型的网格、属于 Explicit,并且同一个轴名在一个数组类型中最多出现一次。
这些分片信息会随操作传播。例如 int32[4@X,1] 与 int32[1,8@Y] 广播相加,结果为 int32[4@X,8@Y]。在 jit 内打印同样可以看到这一推导。输入输出分片确定后,编译器负责划分计算并插入通信。对 float32[8@X,4@Y] 沿第零轴求和,结果为 float32[4@Y];原文编译文本中可找到 all-reduce,说明跨设备归约由编译器插入。
没有明确规则时,应要求输出注解
每个 primitive 都有分片传播规则。一般步骤是:为输出的每个数组轴找到对应输入轴;若这些输入轴分片相容,则沿用;若不能明确决定,要求显式 out_sharding。确定各输出轴后,如果同一个网格轴重复出现,同样报错。这让重要的并行决策显式暴露,而不是暗中采用任意默认布局。
zeros、arange等无输入操作默认创建未分片数组,可用 out_sharding 覆盖。sin、exp等逐元素单目操作保持输入分片。- 加减乘等双目操作中,对应维度的分片必须匹配或为 None;只出现在一侧的外积维度沿用该侧分片。结果若重复使用网格轴则报错。
矩阵乘法的收缩轴提供了典型歧义:f32[8,4@X] 与 f32[4@X,16] 相乘,可以做 all-reduce 得到完全复制的 f32[8,16],也可以沿第一或第二输出轴做 reduce-scatter,或者保留 {U:X} 部分和而暂不通信。Explicit 模式要求你选择,例如 jnp.dot(x, y, out_sharding=jax.P('X', None))。
并不是所有 dot 都必须手写输出。例如左侧未分片、右侧收缩轴沿 X 分片时,原文说明结果可为未分片数组,编译器可能通过 all-gather 右侧来实现,类似 FSDP 中的操作。
用 auto_axes 临时交给编译器
若不想逐个指定中间值分片,可使用 @auto_axes,把部分或全部网格轴暂时改为 Auto。Auto 轴不会出现在 jax.typeof 的分片信息中。装饰器可给函数增加调用端的 out_sharding 参数,也可通过 @auto_axes(out_sharding=...) 在定义处指定最终输出。
例如两个 4 × 4 数组分别为 P('X', None) 和 P(None, 'X'),直接相加会推导出 X 重复出现的非法布局;在 auto_axes 函数内相加,再指定结果为 P('X', None),就把中间布局交给编译器。该装饰器可在 Explicit 或 Auto 上下文调用,不能用于上下文已有 Manual 轴的情况。默认切换全部轴,也可用 axes=... 只切换一部分。
四、Auto:编译时决定分片
除了局部切换,也可以一开始就用 Auto 轴构造 Mesh。前面的收缩轴矩阵乘法在这种模式下不报歧义错误,编译器会决定结果布局。顶层可通过具体数组的 x.sharding 查看最终选择。
在 Auto 模式中可通过 jax.lax.with_sharding_constraint 对中间值施加分片要求。它也允许用于 Explicit 轴,但此时更像断言:检查该值现有分片是否与指定分片一致。
反过来,@explicit_axes 可在 Auto 程序内部局部切换到 Explicit,通过 in_sharding 指明输入分片。原文在 jit 函数里先计算正弦,再调用 explicit_g;在 explicit_g 中可以读取输入和乘二结果的类型分片。它与 auto_axes 形成对应:一个指定输入,另一个指定输出。
需要区分具体值与类型的分片。x.sharding 描述已实现的具体布局,包括 Explicit 和 Auto 轴,只能对顶层具体数组查询;jax.typeof(x).sharding 只显示 Explicit 轴,因为 Auto 轴属于编译器决策范围。因此同一物理数组在全 Explicit 上下文中二者一致,进入 auto_axes 后,具体布局可能仍为 P('X'),类型却只显示 P(None)。后者不是“数据已经复制”的证据。
五、Manual:用局部视角显式通信
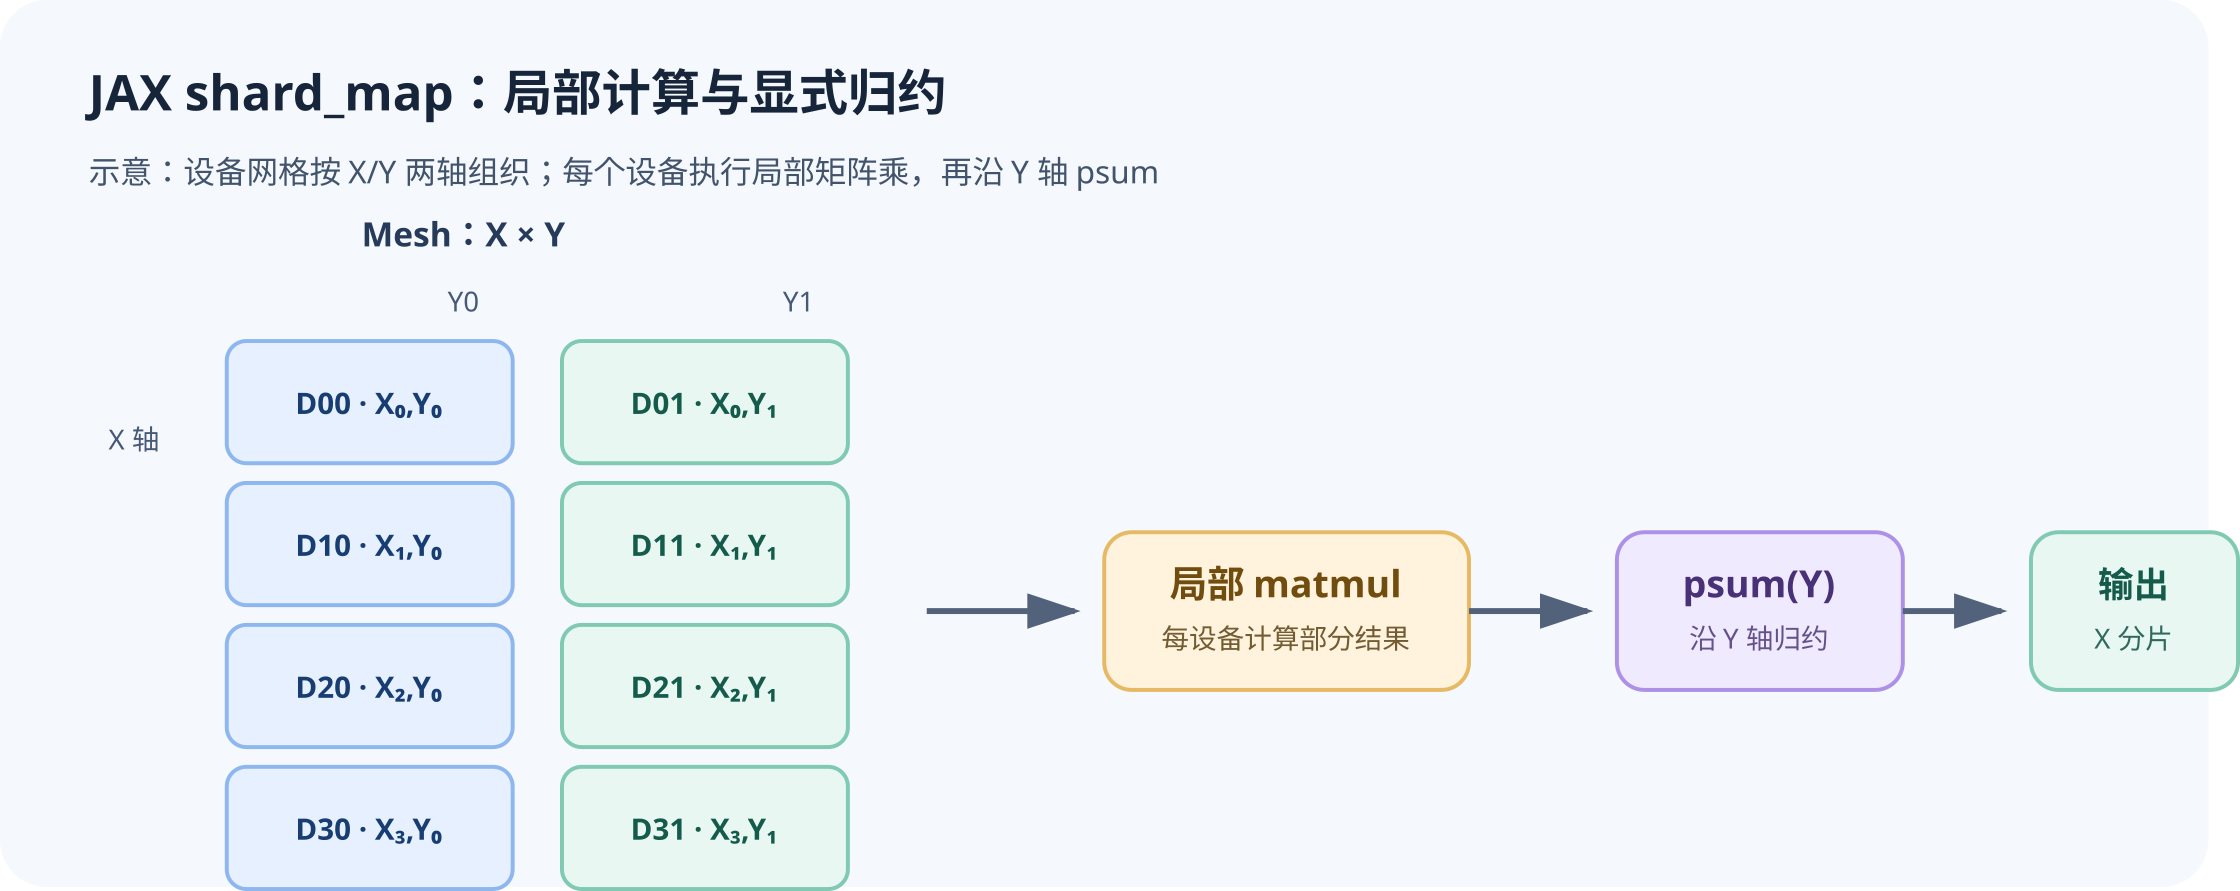
jax.shard_map 会把指定网格轴置为 Manual。函数体看到各设备的局部块,程序显式调用 psum、psum_scatter 等通信操作。原文在两个矩阵的收缩维度沿 X 分片后,先做局部 dot 得到部分和,再用 psum_scatter(..., 'X', tiled=True) 归约并分发结果,最终得到 float32[8@X,16]。
shard_map 是单程序多数据(SPMD)API:同一个函数作用于多个数据块,各实例通过集合通信协作。它与 jit 的自动划分互补,也可在设备组之间手动控制,而在组内继续交给编译器,并与 grad 自动微分组合。
基本矩阵乘法
建立 4 × 2 的 x/y 网格,把 a(8 × 16)放为 P('x', 'y'),b(16 × 4)放为 P('y', None)。shard_map 的函数体分别接收 (2, 8) 和 (8, 4) 的局部块;本地 dot 得到 (2, 4) 的部分和,沿 y 执行 psum 后得到完整行块。输出规格 P('x', None) 让全局结果为 8 × 4,沿 x 分片、沿 y 复制。
原文以 atol=rtol=1e-2 的树结构 allclose 辅助函数与全局 dot 比较,并用 visualize_array_sharding 展示结果。此例在调用前已用 device_put 将两个输入放成与 in_specs 相符的分片,因此手动版与 jit 参考版处理相同的局部块。版本边界要特别注意:JAX 0.9.1 起,在 Explicit 模式下,显式给出的 in_specs 会检查参数现有分片;不匹配就报错,不会隐式重分片。想改变布局,应先调用 jax.reshard;在全部网格轴均为 Explicit 时,也可省略 in_specs,让 JAX 从参数类型推断。以上行为见官方 CHANGELOG 与当前 shard_map 文档。
shard_map 保持秩,vmap 减少秩
没有集合通信时,vmap 可以理解为沿轴拆出元素,分别应用函数,再 stack 回去。例如输入 f32[8,5],每次调用看到 f32[5];若单次结果是 f32[3,7],最终为 f32[8,3,7]。逻辑调用次数由被映射输入轴长度决定。
shard_map 则像 split 成同秩的块,执行函数,再 concatenate:四设备网格中的 f32[8,5] 每个实例看到 f32[2,5];若局部输出为 f32[3,7],拼接后为 f32[12,7]。调用次数由网格设备数决定,而非某个数组轴的长度。未使用 jit 时,示例可即时执行并打印局部中间值。
in_specs:切分与逻辑复制
每个输入 PartitionSpec 把数组轴与网格轴关联,数组维度必须能被对应网格轴大小整除,否则报错。没有提及的网格轴不切分该输入,相当于让沿该轴的函数实例看到同一数据。
在 4 × 2 的 i/j 网格中,12 × 12 输入使用 P('i', None),每个实例看到 3 × 12。如果输出为 P('i', 'j'),不修改局部数据也会得到 12 × 24 的逻辑输出,因为沿 j 把相同结果拼接了两遍。原文用显式 jnp.tile(x, (1, 2)) 后再按 P('i', 'j') 输入,证明这种等价关系。
因此 in_specs 可以理解为同时内含 split 和逻辑 tile;真正是否复制数据,取决于已有物理布局。也可沿别的数组轴 tile,再采用 P(('j', 'i'), None) 表达相同关系。输入阶段可能需要真实通信,确保设备持有所需数据。
out_specs:拼接、块转置与去除重复副本
输出规格描述如何把每个函数实例的结果块组成一个全局数组。提及的轴参与拼接,顺序还可表达块级转置;局部输出的秩必须足以支持声明的拼接。
输出规格省略一个网格轴,是承诺沿该轴的结果相同,只需取一个逻辑副本;它不会自动执行求和。这在物理层面表示把各设备缓冲区解释为复制布局。原文用闭包中的 [[3.]] 展示 P(i,j)、P(i,None)、P(None,None) 分别组成 4 × 2、4 × 1 和 1 × 1 的结果;该例使用 Auto 网格,因为文档当时尚未实现 Explicit 轴下在 shard_map 函数体中闭包捕获数组。
对 12 × 12 输入按 i/j 分块,沿 j 做 psum,再用 P('i', None) 输出得到 12 × 6;沿 i 做 psum 并输出 P(None, 'j') 得到 3 × 12;沿两轴一起 psum 并输出 P(None,None) 得到 3 × 6。这里归约保证副本一致,省略轴才有依据。
out_specs 本身不会触发物理数据移动,只规定如何解释局部缓冲区。运行时不会逐一检查被去重的块数值是否相等;需要依靠下面的静态类型检查。
六、VMA 与 check_vma:追踪跨设备变化
shard_map 内部的值可能随某个 Manual 轴变化,也可能保持不变。把 arange(6.) 沿两个设备切分,每个实例拿到三元素不同数据;若输入规格为 P(),每个实例拿到同一完整数组。对前者沿 i 做 psum,两台设备都得到 [3., 5., 7.]。
启用默认的 check_vma=True 后,这种关系进入类型系统。float32[3]{V:i} 表示值可能随 i 变化;执行 psum 后的 float32[3] 表示不随任何 Manual 轴变化。可用 jax.typeof(x).manual_axis_type.varying 查询轴集合。两轴示例中,输入的 VMA 为 {i,j},沿 j 求和后变成 {i}。
这让代码可以打印、断言或分支检查预期变化轴,也帮助反向自动微分省掉防御性的 psum,并静态检查 out_specs。典型错误是把按 i 分片的输入原样返回,却声明 out_specs=P();默认检查会拒绝这一无法证明复制关系的程序。关闭 check_vma 会让这类错误变成静默的未定义行为,不能用它来“修复”计算。
pcast 与 scan 的类型匹配
jax.lax.pcast(x, 'i', to='varying') 可把沿 i 不变的值当作可能变化的值。它在运行时不通信,可理解为类型转换;反向自动微分中,其转置对应 psum。很多双目运算会自动插入这种转换,使两个输入的 VMA 匹配。jaxpr 中它表现为 pvary primitive。
有些场景需手动转换。例如 lax.scan 的 carry 输入输出类型必须一致;若 carry 是一个随 i 变化的 x 与一个不变的 y,每次循环交换两者,就会因 VMA 不一致报错。在进入 scan 前把 y 转为 varying,可让交换后的类型保持一致。附录保留原文的错误版与修正版代码;源 Markdown 不包含该例的单元输出,具体异常信息请查看官方页面。错误版用于解释诊断,不能当作正常运行示例。
| 原语 | 沿目标轴的类型变化 | 通信与转置 |
|---|---|---|
| psum_invariant(psum 的内部形式) | Varying → Invariant | AllReduceSum;转置为 pvary |
| pvary | Invariant → Varying | 运行时无通信;转置为 psum_invariant |
| all_to_all | Varying → Varying | AllToAll;转置仍为 all_to_all |
| axis_index | 无输入 → Varying | ReplicaId 与算术;无通信 |
| psum_scatter | Varying → Varying | ReduceScatterSum;转置为 all_gather |
| all_gather | Varying → Varying | AllGather;转置为 psum_scatter |
| pscatter | Invariant → Varying | 按设备索引取片;无通信;转置为 all_gather_invariant |
| all_gather_invariant | Varying → Invariant | AllGather;转置为 pscatter |
all_gather 的结果虽然在示例里数值相同,类型仍是 Varying,原因与它作为 psum_scatter 的转置有关。需要明确不变结果时使用 jax.lax.all_gather(..., to='invarying')。原文说明 pscatter 当时没有用户 API,表中仅为完整解释。
另外两种状态:unreduced 与 reduced
VMA 的 varying/invarying 之外,还有与显式分片对应的 unreduced 和 reduced。unreduced 表示每个实例持有全局逻辑值的一份部分和,例如收缩轴被切分时,本地 matmul 后、psum 前的状态。reduced 的数据与 invarying 一样各实例相同,区别在自动微分如何处理它。两者主要用于控制反向传播通信。
进入 shard_map 时,外部沿 i 分片的 f32[8@i] 在两个设备内变为 f32[4]{V:i};复制值仍为不变值;{U:i} 和 {R:i} 分别保留为内部 unreduced 与 reduced。Varying 描述的是函数实例沿网格轴变化,已经不再说明原全局数组的哪一个轴被切分。
pcast 在这些状态之间的转换均不执行通信:invarying 或 reduced 可转 varying,varying 可转 unreduced,invarying 可转 reduced。真正完成待定归约需要 psum 或 psum_scatter,它们接受 unreduced 输入。
七、shard_map API 参数
当前接口包括函数 f、必需的 out_specs、默认 Infer 的 in_specs、可省略的 mesh、控制手动轴集合的 axis_names,以及默认 True 的 check_vma。f 省略时返回装饰器。mesh 为 None 时从由 set_mesh 设置的上下文推断;具体 Mesh 或 AbstractMesh 也可直接传入。
in_specs 与 out_specs 可以是对应参数/结果树结构的 PartitionSpec。每个轴名可出现零或一次;输入中省略表示逻辑复制,输出中省略表示断言副本一致并只保留一个逻辑副本。默认 in_specs=Infer 只适用于全部网格轴为 Explicit 时,此时由参数类型推断。axis_names 指定函数体中改为 Manual 的轴子集;空集合表示全部网格轴手动控制。check_vma 同时影响副本一致性检查及相关自动微分优化。
局部形状与全局形状保持相同秩,每个被切分维度的长度除以相应网格轴大小;一个数组维度若对应多个网格轴,则除以它们大小的乘积。附录保留原文的简化公式与 API 示意定义;其中 PyTree 等注解为接口说明,不能孤立复制为可运行实现。
八、集合通信的语义与用途
没有通信时,可用 split、对每块应用函数、concatenate 来理解 shard_map。有集合通信时,要把函数拆成通信前的局部步骤、依赖所有实例数据的 collective,以及通信后的局部步骤。collective_ref 可能依赖全部块,因此表达真实的跨设备依赖。不同集合通信决定了交换什么数据、每个实例得到什么值。
psum:全归约求和
psum 沿一个或多个网格轴做 all-reduce sum。原文把 16 个数分为四个块 [3,1,4,1]、[5,9,2,6]、[5,3,5,8]、[9,7,1,2];求和后每个实例均得到 [22,20,12,17],所以 out_specs=P() 可以只暴露一个逻辑副本。
二维网格里,可只沿 i 归约,使结果沿 i 相同但仍随 j 变化;也可沿 ('i','j') 一起归约,使结果在两轴都相同。原文的 4 × 4 示例分别产生 2 × 4 与 2 × 2 的逻辑结果。机器学习中常用 psum 汇总损失,或在 shard_map 函数体内包含 grad 时汇总梯度。
all_gather:收集各块
all_gather 让每个实例取得沿某轴的数据全集。tiled=True 沿现有数组轴 concatenate;默认 tiled=False 沿新轴 stack。四个实例各持有 [3]、[9]、[5]、[2] 时,前者在每台设备得到 [3,9,5,2],后者得到四行一列。
此处默认类型语义不允许直接把 out_specs 改为 P();若用 P(‘i’) 拼接,最终逻辑输出包含四份收集结果。若只需要不变结果,可明确指定 to=’invarying’;若仅需把原始块拼成全局数组,也可不在函数体执行 all_gather,而让 out_specs=P(‘i’) 表达拼接。FSDP 常在计算前 all-gather 参数。
psum_scatter:求和后各取一片
psum_scatter 像 psum,但每个实例只拿到总和的一片。上述四块数据归约后,四台设备分别得到 [22]、[20]、[12]、[17];用 out_specs=P(‘i’) 拼接,最终逻辑值仍是 [22,20,12,17]。
这种方式无需让每台设备持有完整求和结果,通信通常少于完整 psum。可把 psum 想成 psum_scatter 后接 all_gather,原文指出 TPU/GPU 常采用这一结构;在相应通信算法下,reduce-scatter 的通信量可约为完整 all-reduce 的一半。这是算法直觉,不是本文实测比例。张量并行矩阵乘法和 FSDP 梯度累加会用到它。
ppermute:显式发送与环形通信
ppermute 接收网格轴名以及 (源索引, 目标索引) 列表。每个源把数据发送给对应目标。四台设备沿环前移时,全局 arange(8) 的块从 [0,1],[2,3],[4,5],[6,7] 变为 [6,7],[0,1],[2,3],[4,5]。源索引和目标索引都不能重复;未被列为目标的实例得到零数组。
通过只向邻居通信的 ppermute 加上本地累加,可实现 reduce-scatter。原文算法在每轮向上转发先前获得的片段,并把这轮收到的数据累加到相应位置;附录保留 size、axis_index、可选 reshape、环形排列及索引更新的完整代码。TPU 还可利用高维、双向物理网格变体。
从反向过程理解 all_gather,有助于看出它与 psum_scatter 的转置关系。ppermute 也可用于网络不同深度阶段之间的 SPMD 流水线、空间分片卷积的 halo 交换,以及底层张量并行矩阵乘法。
all_to_all:设备轴与数组轴之间的块转置
all_to_all 类似沿一个位置轴和一个跨设备轴做块矩阵转置。split_axis 决定哪个数组轴被拆分分发,concat_axis 决定收到的结果沿哪个轴拼接或堆叠。默认 tiled=False 时,split_axis 的长度必须等于网格轴长度,并在 concat_axis 处创建相应新轴;tiled=True 时只需整除,并沿现有轴拼接。
原文四块示例会把每块相同位置的元素交换到同一设备,得到 [3,5,5,9]、[1,9,3,7]、[4,2,5,1]、[1,6,8,2]。混合专家模型可以先按目标专家整理本地样本,再用 all_to_all 把样本送到专家设备。
编者注:原文部分 collective_ref 示意函数返回“所有实例结果列表”,而前文通用示意框架把 collective_ref 按实例调用。附录原样保留这些教学片段,不能不经适配就把它们拼成一个参考程序;真正 JAX 原语示例与这些纯 Python 语义草图应分开理解。
九、矩阵乘法:把通信与计算交错安排
矩阵乘法的并行策略取决于矩阵大小、硬件等条件。原文先在四设备 i 网格上,将左矩阵的非收缩首轴分片、右矩阵的收缩首轴分片,输出也沿首轴分片。最直接的版本先 all-gather 右侧,再执行本地矩阵乘法。这必须等待完整收集结束,通信与计算没有重叠。
原页给出的性能轨迹图来自更大的 (8192,8192) 左矩阵与 (8192,1024) 右矩阵。本文不重画或伪造该轨迹,也不把它当作当前机器表现;原始图及说明可从来源页检查。
为争取重叠,可将 all-gather 展开为环形 ppermute:先乘本设备持有的右块,再每轮转发右块,同时用 dynamic_slice_in_dim 取左侧对应列块并累加乘积。这样也避免每台设备一次聚集完整大型中间数组。单向环在 TPU 上只利用一半双向互连带宽,因此原文又给出双向版,把块一分为二,分别朝两个方向传递。
双向 all-gather 版使用“补零并相加”技巧:把两个半块分别填到互补的半边,再相加成为整块后做一次 dot。沿收缩维拼接的两个乘积之和等于这个整块乘法,使每步仍调用一次完整大小的矩阵乘法。原文配套性能图来自此前每步做两次半块乘法的版本,通信方向和重叠模式相同;这一版本差异必须保留。实际实现还可以用 jax.lax.fori_loop 折叠循环以缩短编译时间,并结合其他并行轴。
另一种布局把左右矩阵的收缩维都沿 i 分片。本地相乘后,对部分和调用 psum_scatter 就能获得所需输出分片。但直接版本同样要等待整个本地 matmul 完成才能开始分发。展开为 ppermute 后,可把局部乘法与发送部分和交错;原文也给出双向版本,分别计算、传递两组输出半块,再 concatenate。附录完整保留这六个矩阵乘法版本及 allclose 比较,避免只留下概念而丢失索引细节。
十、神经网络中的并行策略
原文用一个小型多层网络和随机数据演示:每层 dot 加 bias,隐藏层使用 ReLU,最终返回末层线性输出;损失为每个样本的平方误差沿特征求和,再对批次求均值。权重用正态随机数除以输入维度平方根初始化,偏置为正态随机数。层宽为 [784,128,128,128,128,128,8],batch_size 为 32。
这些是教学用随机网络,不是生产训练方案。自动划分时常不必改模型函数;使用 shard_map 时通常需要在损失、层或矩阵乘法处明确放入通信。
八路批次数据并行(DP)
把 inputs 和 targets 沿 batch 轴分到八设备,参数在每设备复制。各设备独立处理本地批次,损失末尾用 pmean 汇总。在批次等分的本例中,这相当于全局均值。前向末尾仅需标量归约;反向传播还需汇总参数梯度。
原文比较损失与参考模型,均显示约 11.920298,梯度树 allclose 为 True。再查看 value_and_grad 的 jaxpr,可见先有一个用于标量损失的 psum_invariant,再从最后一层到第一层逐个汇总参数梯度。这些数字和 True 均来自来源示例。
八路全分片数据并行(FSDP)
进一步把参数也沿 batch 分片,每次某一层需要完整权重或偏置时才 all-gather。相比所有参数长期复制在所有设备上,这可降低参数驻留内存,为更大模型或批次腾出空间。原文认为 XLA 的通信计算重叠可降低墙钟时间代价;编者注:这依赖硬件拓扑、形状和编译结果,不是无性能损失的普遍保证。
需要处理两个通信位置:predict 在层计算前收集参数,loss 在末尾汇总局部损失。还需避免把前向收集的完整权重都保存到反向,因此对每层使用 jax.remat。反向从保存的参数分片重新收集所需权重,而不必重复不需要的前向矩阵乘法;偏置本身也不必为该反向计算重新收集。
原文把此策略与 WUS、ZeRO-3 联系起来,并比较全复制参考与 FSDP 损失、梯度。编译后的梯度程序示例包含 17 次 all-gather:前向六层各收集一份权重和偏置,共 12 次;反向重收集其中五层的权重,再加 5 次。第一层权重只有求输入梯度才需要,而本例不求;不使用 remat 时,原例只有前向 12 次,但要保存已收集的权重。这个计数属于该版本和该模型示例,不是 API 保证。
八路张量并行(TP)
TP 让数据和激活沿特征维分片,权重沿输入特征维分片,偏置沿特征维分片。gemm_tp 内先本地 dot,再沿 feats 用 psum_scatter(..., scatter_dimension=1, tiled=True) 汇总并分散输出,最后加偏置。
这一例把 shard_map 放在库函数式的 gemm_tp 内,外层 predict/loss 仍使用全局数组语义。因此 loss_tp 中的 jnp.sum 可由编译器根据分片结果自动插入需要的通信。原文参考损失约为 11.920298,TP 约为 11.9203,梯度近似一致;浮点差异不应误认为逐位相同。
FSDP 与 TP 组合
使用 4 × 2 的 batch/feats 网格:数据按 P('batch','feats') 分片,参数首轴按 P(('feats','batch')) 分片。每层先沿 batch 收集参数,再本地 dot,沿 feats reduce-scatter,并通过 remat 支持反向重收集。
这里把 shard_map 放到顶层损失,因此必须手写两种归约:先沿 feats 对局部平方误差的特征和执行 psum,再对本地批次均值沿 batch 执行 pmean。单独 TP 例子不显式写 feats 归约,是因为外层仍在自动划分语境;把视角改到每设备后,不能遗漏这一通信。
SPMD 流水线并行(PP)
流水线并行同时计算网络不同深度的阶段:某设备处理前一阶段时,另一设备处理下一阶段,完成后向后传递结果。阶段数可以不同于层数,一个阶段可以负责多层。
SPMD 利用中间层计算结构相同、参数不同的特点:除首尾层之外,把权重和偏置堆叠起来,沿阶段轴分块,再通过 ppermute 推动微批次。原文策略近似 GPipe;还有其他变体,适用性取决于阶段间网络速度和批次大小。
本例令中间层数 L=len(params)-2=4,批次 N=32,特征数 F=128;阶段数 S=2,每微批 B=8。必须满足 S 整除 L、B 整除 N、S 整除微批总数 M=N/B。由此得到每阶段两层、四个微批、每阶段 K=M/S=2 个微批。
predict_pp 在流水线前后分别计算首尾层;spmd_pipeline 用 NaN 初始化尚未填充的状态与输出,在 M+L-1 次循环中注入微批、通过 vmap 应用阶段内层、写出最后阶段结果,并调用 shift 移动状态和输入输出。shift 使用 ppermute 和 roll 按索引推进数据,最后再做一次循环置换使结果回到需要的位置。
末尾把首尾层参数复制、堆叠的中间层参数沿 stages 分片、批次沿 stages 分片,设置该网格,再计算 loss_pp。原文显示损失约为 11.920298,最后调用 grad 仅以“不崩溃”为演示目标;并没有在此给出与参考梯度 allclose 的断言。不能把这一行扩写成已经证明流水线梯度完全正确。
十一、设备内部布局:Layout 与 Format
Sharding 回答数据放在哪台设备;设备内部还有一层布局问题,例如每个局部块按行优先还是列优先存放。jax.experimental.layout 用 Layout 表达设备内布局,用 Format 把 Layout 和 Sharding 配成完整描述。
Layout 的 major_to_minor 指定维度顺序:二维 (0,1) 为行优先,(1,0) 为列优先。Layout.AUTO 是请求编译器选择输入或输出布局的静态标记。Format 可让其中一个成分采用默认值;若显式指定 layout,必须同时提供 sharding。jit 与 device_put 一般接收 Sharding 或 Format,而不是直接接收 Layout。
这些 API 仍是实验性的。原文布局示例输出来自加速器平台,属于展示性片段;CPU 上 XLA 当前倾向行优先,不能把其列优先断言推广到 CPU。
原文假设 init_fn 很少调用,apply_fn 反复运行,因此优先优化 apply_fn 的输入布局。apply_fn 读取 x 的一行和 y 的一列,使用 Format(Layout.AUTO) 编译后,从 input_formats 读回选择:例中 x 为行优先,y 为列优先。随后让 init_fn 的输出采用这些格式,并检查 output_formats 与其一致。
调用已编译函数时,还要区分 committed 与 uncommitted 数组。未固定布局的输入可在调用前重新布局;已经明确放置的 committed 数组须匹配已编译函数的要求,不匹配时原例抛出 ValueError。附录保留未固定/固定与匹配/不匹配四种情况的原始代码;源 Markdown 不包含这些单元输出。
在 jit 内可用 with_layout_constraint 指定某个中间值的设备内布局,其角色类似分片层面的 with_sharding_constraint。原例对转置后的 y 强制行优先,再乘二。
十二、代码、输出与下一步阅读
下列两个附录按官方源页顺序恢复两篇教程中的全部 fenced code/output blocks,并以原文标题标出上下文;共 127 个块:109 个代码单元、16 个独立 Python 片段、1 个伪语法块和 1 个源文件中已有的文本输出。代码取自 JAX 官方仓库提交 d353d04d62cab4d794df83762f531b02af74da0c,对应源文件为 sharding.md 与 shard-map.md。源 Markdown 未保存代码单元执行后的 notebook 输出,因此本附录只保留源文件中显式存在的 fenced 输出;没有复造或补跑其他输出。正文标明“原文显示”的结果指官方教程页面展示的值,不是本轮实测。代码片段共享状态,并包含专门展示异常的示例;请按各页次序阅读,不能把两个附录拼成生产脚本。
本文只做静态代码审查。没有执行 JAX、编译 HLO、创建设备、测量通信或检查运行时结果;也没有发现需要公开的真实秘密或执行外部命令的注入链。风险集中在版本匹配、维度整除、复制语义、错误关闭检查、内存与通信成本,以及教学片段不能直接拼接的问题。进一步可阅读原文链接的自动微分与分片章节,理解 unreduced/reduced 和反向传播通信。
附录:官方教程代码与源输出
A. Distributed arrays and automatic parallelization
Distributed arrays and automatic parallelization
源 fenced block 01:notebook 代码单元
import jax
import jax.numpy as jnp
jax.config.update('jax_num_cpu_devices', 8)
Distributed arrays and automatic parallelization
源 fenced block 02:notebook 代码单元
jax.set_mesh(jax.make_mesh((4, 2), ('X', 'Y')))  # explicit mode by default

x = jnp.arange(8 * 4.).reshape(8, 4)
x = jax.device_put(x, jax.P('X', 'Y'))
print(jax.typeof(x))  # f32[8@X, 4@Y]
Distributed arrays and automatic parallelization
源 fenced block 03:notebook 代码单元
jax.debug.visualize_array_sharding(x)Distributed arrays and automatic parallelization
源 fenced block 04:notebook 代码单元
y = jnp.sin(x).T
print(jax.typeof(y))  # f32[4@Y, 8@X]
A `Mesh` is a grid of devices with named axes
源 fenced block 05:notebook 代码单元
from __future__ import annotations
import enum

class AbstractMesh:
  axis_sizes: tuple[int, ...]
  axis_names: tuple[str, ...]
  axis_types: tuple[AxisType, ...]

class AxisType(enum.Enum):
  Auto = enum.auto()
  Explicit = enum.auto()
  Manual = enum.auto()
A `Mesh` is a grid of devices with named axes
源 fenced block 06:notebook 代码单元
import numpy as np

class Mesh:
  devices: np.ndarray[jax.Device]
  axis_names: tuple[str, ...]
  axis_types: tuple[AxisType, ...]

  @property
  def axis_sizes(self) -> tuple[int, ...]:
    return self.devices.shape
A `Mesh` is a grid of devices with named axes
源 fenced block 07:notebook 代码单元
mesh = jax.make_mesh((4, 2), ('X', 'Y'))
print(mesh)
A `Mesh` is a grid of devices with named axes
源 fenced block 08:notebook 代码单元
jax.set_mesh(mesh)A `Mesh` is a grid of devices with named axes
源 fenced block 09:notebook 代码单元
@jax.jit
def f(x):
  abstract_mesh = jax.sharding.AbstractMesh((8,), ('A',), (jax.sharding.AxisType.Explicit,))
  with jax.sharding.use_abstract_mesh(abstract_mesh):
    y = jax.reshard(x, jax.P('A', None))
    return y * 2

z = f(x)
print(jax.typeof(z))  # f32[8@A, 4]
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 10:notebook 代码单元
print(x.sharding)
jax.debug.visualize_array_sharding(x)
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 11:notebook 代码单元
for s in x.addressable_shards:
  print(s.device, s.data, sep='\n', end='\n\n')
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 12:notebook 代码单元
y = jax.device_put(x, jax.P('Y', 'X'))
print(y.sharding)
jax.debug.visualize_array_sharding(y)
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 13:notebook 代码单元
y = jax.reshard(x, jax.P('Y', 'X'))
print(y.sharding)
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 14:notebook 代码单元
y = jax.device_put(x, jax.P('X', None))
print(y.sharding)
jax.debug.visualize_array_sharding(y)
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 15:notebook 代码单元
for s in y.addressable_shards:
  print(s.device, s.data, sep='\n', end='\n\n')
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 16:notebook 代码单元
y = jax.device_put(x, jax.P(('X', 'Y')))
print(y.sharding)
jax.debug.visualize_array_sharding(y)
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 17:notebook 代码单元
y = jax.device_put(x, jax.P('X', None, unreduced={'Y'}))
print(y.sharding)
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 18:notebook 代码单元
for s in y.addressable_shards:
  print(s.device, s.data, sep='\n', end='\n\n')
A `Sharding` describes how array values are laid out over a `Mesh`
源 fenced block 19:notebook 代码单元
mesh2 = jax.make_mesh((8,), ('A',))
z = jax.device_put(x, jax.NamedSharding(mesh2, jax.P('A', None)))
print(z.sharding)
print(y.sharding)
Explicit sharding mode makes sharding queryable at trace time
源 fenced block 20:notebook 代码单元
print(jax.typeof(x).sharding)Explicit sharding mode makes sharding queryable at trace time
源 fenced block 21:notebook 代码单元
jax.jit(lambda x: print(jax.typeof(x).sharding))(x)Explicit sharding mode makes sharding queryable at trace time
源 fenced block 22:原文未标语言的伪语法块
 <array_type> ::= <dtype>[<size_and_sharding>, ...]
 <size_and_sharding> ::= <size> | <size>@<MeshAxisName>
Explicit sharding mode makes sharding queryable at trace time
源 fenced block 23:notebook 代码单元
x = jax.device_put(np.arange(4).reshape(4, 1), jax.P("X", None))
y = jax.device_put(np.arange(8).reshape(1, 8), jax.P(None, "Y"))

z = x + y

print(f"{jax.typeof(x)=!s}")
print(f"{jax.typeof(y)=!s}")
print(f"{jax.typeof(z)=!s}")
Explicit sharding mode makes sharding queryable at trace time
源 fenced block 24:notebook 代码单元
@jax.jit
def add_arrays(x, y):
  z = x + y
  print(f"{jax.typeof(x)=!s}")
  print(f"{jax.typeof(y)=!s}")
  print(f"{jax.typeof(z)=!s}")
  return z

add_arrays(x, y)
Explicit sharding mode makes sharding queryable at trace time
源 fenced block 25:notebook 代码单元
x = jax.random.normal(jax.random.key(0), (8, 4),
                      out_sharding=jax.P('X', 'Y'))
print(jax.typeof(x))
Explicit sharding mode makes sharding queryable at trace time
源 fenced block 26:notebook 代码单元
y = x.sum(0)
print(jax.typeof(y))
Explicit sharding mode makes sharding queryable at trace time
源 fenced block 27:notebook 代码单元
compile_txt = jax.jit(lambda x: x.sum(0)).lower(x).compile().as_text()
print('all-reduce(' in compile_txt)
Result shardings follow simple rules, or error and require annotation
源 fenced block 28:notebook 代码单元
x = jax.device_put(jnp.arange(8 * 4.).reshape(8, 4), jax.P(None, 'X'))
y = jax.device_put(jnp.arange(4 * 16.).reshape(4, 16), jax.P('X', None))

try:
  jnp.dot(x, y)
except Exception as e:
  print("ERROR!")
  print(e)
Result shardings follow simple rules, or error and require annotation
源 fenced block 29:notebook 代码单元
z = jnp.dot(x, y, out_sharding=jax.P('X', None))

print(jax.typeof(z))
With `@auto_axes` the compiler chooses shardings within the decorated function
源 fenced block 30:notebook 代码单元
from jax.sharding import auto_axes, explicit_axes

x = jax.device_put(np.arange(16).reshape(4, 4), jax.P("X", None))
y = jax.device_put(np.arange(16).reshape(4, 4), jax.P(None, "X"))

try:
  x + y
except Exception as e:
  print("ERROR!")
  print(e)
With `@auto_axes` the compiler chooses shardings within the decorated function
源 fenced block 31:notebook 代码单元
@auto_axes
def add2(x, y):
  print("We're in auto-sharding mode here. This is the current mesh:\n"
        f"{jax.sharding.get_abstract_mesh()}")
  return x + y

result = add2(x, y, out_sharding=jax.P("X", None))
print(f"Result type: {jax.typeof(result)}")
Auto sharding mode decides shardings automatically during compilation
源 fenced block 32:notebook 代码单元
Auto = jax.sharding.AxisType.Auto
auto_mesh = jax.make_mesh((4, 2), ('X', 'Y'), (Auto, Auto))
jax.set_mesh(auto_mesh)

x = jax.device_put(jnp.arange(8 * 4. ).reshape(8, 4 ), jax.P(None, 'X'))
y = jax.device_put(jnp.arange(4 * 16.).reshape(4, 16), jax.P('X', None))

z = jnp.dot(x, y)  # not an error!
Auto sharding mode decides shardings automatically during compilation
源 fenced block 33:notebook 代码单元
print(z.sharding) # works at the top level only (i.e. outside `jit`)Auto sharding mode decides shardings automatically during compilation
源 fenced block 34:notebook 代码单元
@jax.jit
def f(x, y):
  z = jnp.dot(x, y)
  z = jax.lax.with_sharding_constraint(z, jax.P('X', None))
  return z

z = f(x, y)
print(z.sharding)
Auto sharding mode decides shardings automatically during compilation
源 fenced block 35:notebook 代码单元
@explicit_axes
def explicit_g(y):
  print(f'mesh inside g: {jax.sharding.get_abstract_mesh()}')
  print(f'y.sharding inside g: {jax.typeof(y) = }')
  z = y * 2
  print(f'z.sharding inside g: {jax.typeof(z) = }', end='\n\n')
  return z

@jax.jit
def f(arr1):
  print(f'mesh inside f: {jax.sharding.get_abstract_mesh()}', end='\n\n')
  x = jnp.sin(arr1)
  z = explicit_g(x, in_sharding=jax.P("X", "Y"))
  return z + 1

x = jax.device_put(np.arange(16).reshape(4, 4), jax.P("X", "Y"))
f(x)
Concrete array shardings can mention `Auto` mesh axes
源 fenced block 36:notebook 代码单元
jax.set_mesh(jax.make_mesh((4, 2), ('X', 'Y')))  # Explicit mode

def compare_shardings(x):
  print(f"=== with mesh: {jax.sharding.get_abstract_mesh()} ===")
  print(f"Concrete value sharding: {x.sharding.spec}")
  print(f"Type-specified sharding: {jax.typeof(x).sharding.spec}\n")

my_array = jnp.sin(jax.device_put(np.arange(8), jax.P("X")))
compare_shardings(my_array)

@auto_axes
def check_in_auto_context(x):
  compare_shardings(x)
  return x

check_in_auto_context(my_array, out_sharding=jax.P("X"))
Manual mode lets you write explicit collectives with a per-device view of data
源 fenced block 37:notebook 代码单元
mesh = jax.make_mesh((4, 2), ('X', 'Y'))
jax.set_mesh(mesh)

x = jax.device_put(jnp.arange(8 * 4. ).reshape(8, 4 ), jax.P(None, 'X'))
y = jax.device_put(jnp.arange(4 * 16.).reshape(4, 16), jax.P('X', None))

@jax.shard_map(out_specs=jax.P('X', None))
def matmul(x_shard, y_shard):
  z_summand = jnp.dot(x_shard, y_shard)
  return jax.lax.psum_scatter(z_summand, 'X', tiled=True)

z = matmul(x, y)
print(jax.typeof(z))

z_ref = jnp.dot(x, y, out_sharding=jax.P('X', None))
print(jnp.allclose(z_ref, z))
Specifying and reading layouts
源 fenced block 38:独立 Python 代码片段
import jax, jax.numpy as jnp
from jax.experimental.layout import Layout, Format
from jax.sharding import SingleDeviceSharding
import numpy as np

def init_fn(x, y):
  return x * 2, y * 3

def apply_fn(x, y):
  return x[0, :], y[:, 0]
Specifying and reading layouts
源 fenced block 39:独立 Python 代码片段
shape = (4 * 128, 8 * 128)
duck = jax.ShapeDtypeStruct(shape, jnp.float32)

# Compile the `apply` function with layouts inferred automatically
apply_exe = jax.jit(
    apply_fn,
    in_shardings=Format(Layout.AUTO),
    out_shardings=Format(Layout.AUTO),
).trace(duck, duck).lower().compile()

# Read back the inferred input layout
arg_formats, kwarg_formats = apply_exe.input_formats
assert len(kwarg_formats) == 0
assert arg_formats[0].layout.major_to_minor == (0, 1)
assert arg_formats[1].layout.major_to_minor == (1, 0)
Specifying and reading layouts
源 fenced block 40:独立 Python 代码片段
init_exe = jax.jit(init_fn, out_shardings=arg_formats).trace(
    duck, duck).lower().compile()

assert init_exe.output_formats == arg_formats
Specifying and reading layouts
源 fenced block 41:独立 Python 代码片段
def test(x, y, msg):
  print(f'-- {msg}:')
  print('x major_to_minor =', x.format.layout.major_to_minor)
  print('y major_to_minor =', y.format.layout.major_to_minor)
  try:
    apply_exe(x, y)
    print('-> `apply` called successfully')
  except ValueError as e:
    assert 'does not match' in str(e)
    print('-> error: mismatched input layouts')
  print()

dev = jax.devices()[0]

x1 = y1 = jnp.ones(shape)
test(x1, y1, 'uncommitted with mismatched layout')

x2, y2 = init_exe(x1, y1)
test(x2, y2, 'uncommitted with matching layout')

x3 = jnp.ones(shape)
y3 = jax.device_put(np.ones(shape), Format(Layout(major_to_minor=(1, 0)),
                                           SingleDeviceSharding(dev)))
test(x3, y3, 'committed with matching layout')

x4 = jnp.ones(shape)
y4 = jax.device_put(np.ones(shape), Format(Layout(major_to_minor=(0, 1)),
                                           SingleDeviceSharding(dev)))
test(x4, y4, 'committed with mismatched layout')
Specifying and reading layouts
源 fenced block 42:官方文本输出
-- uncommitted with mismatched layout:
x major_to_minor = (0, 1)
y major_to_minor = (0, 1)
-> `apply` called successfully

-- uncommitted with matching layout:
x major_to_minor = (0, 1)
y major_to_minor = (1, 0)
-> `apply` called successfully

-- committed with matching layout:
x major_to_minor = (0, 1)
y major_to_minor = (1, 0)
-> `apply` called successfully

-- committed with mismatched layout:
x major_to_minor = (0, 1)
y major_to_minor = (0, 1)
-> error: mismatched input layouts
Constraining intermediate layouts
源 fenced block 43:独立 Python 代码片段
from jax.experimental.layout import with_layout_constraint

@jax.jit
def f(x):
  y = x.T
  # Enforce a specific layout on `y`
  y = with_layout_constraint(y, Layout(major_to_minor=(0, 1)))
  return y * 2
B. Manual parallelism with shard_map
Overview
源 fenced block 01:notebook 代码单元
import jax

jax.config.update('jax_num_cpu_devices', 8)  # Use 8 CPU devices
So, let's see a `shard_map`!
源 fenced block 02:notebook 代码单元
from functools import partial

import jax
import jax.numpy as jnp

Explicit = jax.sharding.AxisType.Explicit
Auto = jax.sharding.AxisType.Auto
So, let's see a `shard_map`!
源 fenced block 03:notebook 代码单元
mesh = jax.make_mesh((4, 2), ('x', 'y'))
jax.set_mesh(mesh)

a = jax.device_put(jnp.arange( 8 * 16.).reshape(8, 16), jax.P('x', 'y'))
b = jax.device_put(jnp.arange(16 *  4.).reshape(16, 4), jax.P('y', None))

@jax.shard_map(in_specs=(jax.P('x', 'y'), jax.P('y', None)), out_specs=jax.P('x', None))
def matmul_basic(a_block, b_block):
  # a_block: f32[2, 8]
  # b_block: f32[8, 4]
  c_partialsum = jnp.dot(a_block, b_block)
  c_block = jax.lax.psum(c_partialsum, 'y')
  # c_block: f32[2, 4]
  return c_block

c = matmul_basic(a, b)   # c: f32[8, 4]
So, let's see a `shard_map`!
源 fenced block 04:notebook 代码单元
from jax.tree_util import tree_map, tree_all

def allclose(a, b):
  return tree_all(tree_map(partial(jnp.allclose, atol=1e-2, rtol=1e-2), a, b))

allclose(c, jnp.dot(a, b, out_sharding=jax.P('x', None)))
So, let's see a `shard_map`!
源 fenced block 05:notebook 代码单元
jax.debug.visualize_array_sharding(c)So, let's see a `shard_map`!
源 fenced block 06:notebook 代码单元
a = jax.device_put(a, jax.P('x', 'y'))
b = jax.device_put(b, jax.P('y', None))

@jax.jit
def matmul_reference(a, b):
  return jnp.dot(a, b, out_sharding=jax.P('x', None))

c_ref = matmul_reference(a, b)
allclose(c_ref, jnp.dot(a, b, out_sharding=jax.P('x', None)))
So, let's see a `shard_map`!
源 fenced block 07:notebook 代码单元
print('a blocks:'); jax.debug.visualize_array_sharding(a)
print('b blocks:'); jax.debug.visualize_array_sharding(b)
print('c blocks:'); jax.debug.visualize_array_sharding(c)
Rank-reducing vs rank-preserving maps
源 fenced block 08:notebook 代码单元
def check_vmap(f, xs):
  ans = jax.vmap(f, in_axes=(0,), out_axes=0)(xs)
  expected = jnp.stack([f(x) for x in xs])  # vmap reference semantics
  print(allclose(ans, expected))

check_vmap(lambda x: x @ x, jnp.arange(12).reshape(4, 3))
Rank-reducing vs rank-preserving maps
源 fenced block 09:notebook 代码单元
import numpy as np
mesh = jax.make_mesh((4,), ('i',), (Auto,))  # mesh.shape['i'] = 4
jax.set_mesh(mesh)

def check_shmap(f, y):
  ans = jax.shard_map(f, in_specs=jax.P('i'), out_specs=jax.P('i'))(y)
  expected = jnp.concatenate([f(y_blk) for y_blk in jnp.split(y, mesh.shape['i'])])
  print(allclose(ans, expected))

check_shmap(lambda x: x.T @ x, jnp.arange(32).reshape(8, 4))
Controlling how each input is split (unconcatenated) and tiled with `in_specs`
源 fenced block 10:notebook 代码单元
mesh = jax.make_mesh((4, 2), ('i', 'j'))
jax.set_mesh(mesh)

@jax.shard_map(in_specs=jax.P('i', None), out_specs=jax.P('i', 'j'))
def f1(x_block):
  print(x_block.shape)  # prints (3, 12)
  return x_block

x1 = jax.device_put(jnp.arange(12 * 12).reshape(12, 12), jax.P('i', None))
y = f1(x1)
Controlling how each input is split (unconcatenated) and tiled with `in_specs`
源 fenced block 11:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P('i', 'j'))
def f2(x_block):
  print(x_block.shape)
  return x_block

x = jnp.arange(12 * 12).reshape(12, 12)
x_ = jnp.tile(x, (1, mesh.shape['j']))  # x_ has shape (12, 24)
x_ = jax.device_put(x_, jax.P('i', 'j'))
y = f2(x_)  # prints (3,12), and f1(x) == f2(x_)
Controlling how each output is assembled by concatenation, block transposition, and untiling using `out_specs`
源 fenced block 12:notebook 代码单元
auto_mesh = jax.make_mesh((4, 2), ('i', 'j'), (Auto, Auto))
with jax.set_mesh(auto_mesh):
  x = jnp.array([[3.]])

  z = jax.shard_map(lambda: x, in_specs=(), out_specs=jax.P('i', 'j'))()
  print(z)  # prints the same as jnp.tile(x, (4, 2))

  z = jax.shard_map(lambda: x, in_specs=(), out_specs=jax.P('i', None))()
  print(z)  # prints the same as jnp.tile(x, (4, 1))

  z = jax.shard_map(lambda: x, in_specs=(), out_specs=jax.P(None, None))()
  print(z)  # prints the same as jnp.tile(x, (1, 1)), or just x
Controlling how each output is assembled by concatenation, block transposition, and untiling using `out_specs`
源 fenced block 13:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P('i', None))
def f3(x_block):
  return jax.lax.psum(x_block, 'j')

x = jax.device_put(jnp.arange(12 * 12).reshape(12, 12), jax.P('i', 'j'))
y3 = f3(x)
print(y3.shape)
Controlling how each output is assembled by concatenation, block transposition, and untiling using `out_specs`
源 fenced block 14:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P(None, 'j'))
def f4(x_block):
  return jax.lax.psum(x_block, 'i')

x = jax.device_put(jnp.arange(12 * 12).reshape(12, 12), jax.P('i', 'j'))
y4 = f4(x)
print(y4.shape)  # (3,12)


@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P(None, None))
def f5(x_block):
  return jax.lax.psum(x_block, ('i', 'j'))

y5 = f5(x)
print(y5.shape)  # (3,6)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 15:notebook 代码单元
mesh = jax.make_mesh((2,), ('i',))
jax.set_mesh(mesh)

@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f(x):
  print(x)
  return 2 * x

x = jax.device_put(jnp.arange(6.), jax.P('i'))
f(x)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 16:notebook 代码单元
@jax.shard_map(in_specs=jax.P(), out_specs=jax.P())
def f(x):
  print(x)
  return 2 * x

x = jnp.arange(6.)
f(x)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 17:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P())
def f(x):
  y = jax.lax.psum(x, 'i')
  print(y)
  return y

x = jax.device_put(jnp.arange(6.), jax.P('i'))
f(x)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 18:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P())
def f(x):
  print(jax.typeof(x))  # float32[3]{V:i}
  y = jax.lax.psum(x, 'i')
  print(jax.typeof(y))  # float32[3]
  return y

x = jax.device_put(jnp.arange(6.), jax.P('i'))
f(x)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 19:notebook 代码单元
mesh = jax.make_mesh((4, 2), ('i', 'j'))
jax.set_mesh(mesh)

@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P('i'))
def f(x):
  print(jax.typeof(x))  # float32[2,2]{V:(i,j)}
  y = jax.lax.psum(x, 'j')
  assert jax.typeof(y).manual_axis_type.varying == {'i'}
  print(jax.typeof(y))  # float32[2,2]{V:i}
  return y

x = jax.device_put(jnp.arange(8 * 4.).reshape(8, 4), jax.P('i', 'j'))
f(x)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 20:notebook 代码单元
mesh = jax.make_mesh((2,), ('i',))
jax.set_mesh(mesh)

x = jax.device_put(jnp.arange(6.), jax.P('i'))
try:
  y = jax.shard_map(lambda x: x, in_specs=jax.P('i'), out_specs=jax.P())(x)
except Exception as e:
  print(e)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 21:notebook 代码单元
@jax.shard_map(in_specs=jax.P(), out_specs=None)
def f(x):
  print(jax.typeof(x))  # float32[6]
  y = jax.lax.pcast(x, 'i', to='varying')
  print(jax.typeof(y))  # float32[6]{V:i}

x = jnp.arange(6.)
f(x)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 22:notebook 代码单元
@jax.shard_map(in_specs=(jax.P('i'), jax.P()), out_specs=jax.P('i'))
def f(x, y):
  return x * y

x = jax.device_put(jnp.arange(6.), jax.P('i'))
y = jnp.arange(3.)
print(jax.jit(f).trace(x, y).jaxpr)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 23:notebook 代码单元
mesh = jax.make_mesh((2,), ('i',))
jax.set_mesh(mesh)

@jax.shard_map(in_specs=(jax.P('i'), jax.P()), out_specs=jax.P('i'))
def f(x, y):
  def body(carry, _):
    c1, c2 = carry
    return (c2, c1), ()  # swap the carry
  (x_, y_), _ = jax.lax.scan(body, (x, y), (), length=2)
  return x_, y_

x = jax.device_put(jnp.arange(6.), jax.P('i'))
y = jnp.arange(3.)

try:
  f(x, y)
except Exception as e:
  print(e)
Tracking how values vary over manual mesh axes, and `check_vma=True`
源 fenced block 24:notebook 代码单元
mesh = jax.make_mesh((2,), ('i',))
jax.set_mesh(mesh)

@jax.shard_map(in_specs=(jax.P('i'), jax.P()), out_specs=jax.P('i'))
def f(x, y):
  def body(carry, _):
    c1, c2 = carry
    return (c2, c1), ()  # swap the carry

  y = jax.lax.pcast(y, 'i', to='varying')  # apply pcast to fix the error
  (x_, y_), _ = jax.lax.scan(body, (x, y), (), length=2)
  return x_, y_

x = jax.device_put(jnp.arange(6.), jax.P('i'))
y = jnp.arange(3.)

f(x, y)
Two more manual types: `unreduced` and `reduced`
源 fenced block 25:notebook 代码单元
mesh = jax.make_mesh((2,), ('i',))
jax.set_mesh(mesh)

x_sharded = jax.device_put(jnp.arange(8.), jax.P('i'))
x_replicated = jnp.arange(4.)
x_unreduced = jnp.einsum('i,i->', x_sharded, x_sharded,
                         out_sharding=jax.P(unreduced={'i'}))
x_reduced = jax.reshard(x_replicated, jax.P(reduced={'i'}))

@jax.shard_map(in_specs=(jax.P('i'), jax.P(), jax.P(unreduced={'i'}),
                         jax.P(reduced={'i'})),
               out_specs=jax.P('i'))
def f(a, b, c, d):
  print(jax.typeof(a))  # float32[4]{V:i}
  print(jax.typeof(b))  # float32[4]
  print(jax.typeof(c))  # float32[]{U:i}
  print(jax.typeof(d))  # float32[4]{R:i}
  return a

_ = f(x_sharded, x_replicated, x_unreduced, x_reduced)
API specification
源 fenced block 26:独立 Python 代码片段
from jax.sharding import Mesh, AbstractMesh, Infer
Specs = PyTree[PartitionSpec]

def shard_map(
    f: Callable | None = None, /, *, out_specs: Specs,
    in_specs: Specs | Infer = Infer,
    mesh: Mesh | AbstractMesh | None = None,
    axis_names: collections.abc.Set[AxisName] = frozenset(),
    check_vma: bool = True,
) -> Callable:
  ...
Collectives tutorial
源 fenced block 27:独立 Python 代码片段
mesh = jax.make_mesh((8,), ('i',))
x = jnp.arange(16.)
f_shmapped = jax.shard_map(f, in_specs=jax.P('i'), out_specs=jax.P('i'))
y = f_shmapped(x)
Collectives tutorial
源 fenced block 28:独立 Python 代码片段
def f_shmapped_ref(x):
  x_blocks = jnp.array_split(x, mesh.shape['i'])
  y_blocks = [f(x_blk) for x_blk in x_blocks]
  return jnp.concatenate(y_blocks)
Collectives tutorial
源 fenced block 29:独立 Python 代码片段
def f(x_blk):
  z_blk = f_part1(x_blk)
  u_blk = collective(z_blk, axis_name)
  v_blk = f_part2(x_blk, z_blk, u_blk)
  return v_blk
Collectives tutorial
源 fenced block 30:独立 Python 代码片段
def f_shmapped_ref(x):
  x_blocks = jnp.array_split(x, mesh.shape[axis_name])
  z_blocks = [f_part1(x_blk) for x_blk in x_blocks]
  u_blocks = [collective_ref(i, z_blocks) for i in range(len(z_blocks))]
  v_blocks = [f_part2(x_blk, z_blk, u_blk) for x_blk, z_blk, u_blk
              in zip(x_blocks, z_blocks, u_blocks)]
  return jnp.concatenate(v_blocks)
`psum`
源 fenced block 31:notebook 代码单元
import jax
import jax.numpy as jnp
from jax import lax
`psum`
源 fenced block 32:notebook 代码单元
mesh1d = jax.make_mesh((4,), ('i',), (Auto,))
jax.set_mesh(mesh1d)

@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P(None))
def f1(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.psum(x_block, 'i')
  print('AFTER:\n', y_block)
  return y_block
`psum`
源 fenced block 33:notebook 代码单元
x = jnp.array([3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, 8, 9, 7, 1, 2])
y = f1(x)
print('FINAL RESULT:\n', y)
`psum`
源 fenced block 34:独立 Python 代码片段
def psum_ref(_, x_blocks):
  tot = sum(x_blocks)
  return [tot] * len(x_blocks)
`psum`
源 fenced block 35:notebook 代码单元
mesh2d = jax.make_mesh((2, 2), ('i', 'j'), (Auto, Auto))
jax.set_mesh(mesh2d)

@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P(None, 'j'))
def f2(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.psum(x_block, 'i')
  print('AFTER:\n', y_block)
  return y_block

y = f2(jnp.arange(16).reshape(4, 4))
print('FINAL RESULT:\n', y)
`psum`
源 fenced block 36:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i', 'j'), out_specs=jax.P(None, None))
def f3(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.psum(x_block, ('i', 'j'))
  print('AFTER:\n', y_block)
  return y_block

y = f3(jnp.arange(16).reshape(4, 4))
print('FINAL RESULT:\n', y)
`all_gather`
源 fenced block 37:notebook 代码单元
jax.set_mesh(mesh1d)

@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f4(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.all_gather(x_block, 'i', tiled=True)
  print('AFTER:\n', y_block)
  return y_block

x = jnp.array([3, 9, 5, 2])
y = f4(x)
print('FINAL RESULT:\n', y)
`all_gather`
源 fenced block 38:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f5(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.all_gather(x_block, 'i', tiled=False)
  print('AFTER:\n', y_block)
  return y_block

y = f5(x)
print('FINAL RESULT:\n', y)
`all_gather`
源 fenced block 39:独立 Python 代码片段
def all_gather_ref(_, x_blocks, *, tiled=False):
  combine = jnp.concatenate if tiled else jnp.stack
  return [combine(x_blocks)] * len(x_blocks)
`psum_scatter`
源 fenced block 40:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f6(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.psum_scatter(x_block, 'i', tiled=True)
  print('AFTER:\n', y_block)
  return y_block

x = jnp.array([3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, 8, 9, 7, 1, 2])
y = f6(x)
print('FINAL RESULT:\n', y)
`psum_scatter`
源 fenced block 41:独立 Python 代码片段
def psum_scatter_ref(i, x_blocks, *, tiled=False):
  axis_size = len(x_blocks)
  tot = sum(x_blocks)
  if tiled:
    tot = tot.reshape(axis_size, -1, *tot.shape[1:])  # split leading axis
  return [tot[i] for i in range(tot.shape[0])]
`psum_scatter`
源 fenced block 42:独立 Python 代码片段
def psum(x, axis_name):
  summed_chunk = jax.lax.psum_scatter(x, axis_name)
  return jax.lax.all_gather(summed_chunk, axis_name)
`ppermute`
源 fenced block 43:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f7(x_block):
  sz = jax.lax.axis_size('i')
  print('BEFORE:\n', x_block)
  y_block = jax.lax.ppermute(x_block, 'i', [(i, (i + 1) % sz) for i in range(sz)])
  print('AFTER:\n', y_block)
  return y_block

y = f7(jnp.arange(8))
print('FINAL RESULT:\n', y)
`ppermute`
源 fenced block 44:独立 Python 代码片段
def ppermute_ref(i, x_blocks, perm):
  results = [jnp.zeros_like(x_blocks[0])] * len(x_blocks)
  for src, dst in perm:
    results[dst] = x_blocks[src]
  return results
`ppermute`
源 fenced block 45:notebook 代码单元
def psum_scatter(x, axis_name, *, tiled=False):
  size = jax.lax.axis_size(axis_name)
  idx = jax.lax.axis_index(axis_name)  # function instance index along axis_name
  if tiled:
    x = x.reshape(size, -1, *x.shape[1:])  # split leading axis
  shift = partial(jax.lax.ppermute, axis_name=axis_name,
                  perm=[(i, (i - 1) % size) for i in range(size)])
  for i in range(1, size):
    update = shift(x[(idx + i) % size])
    x = x.at[(idx + i + 1) % size].add(update)
  return x[idx]
`ppermute`
源 fenced block 46:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f8(x_block):
  print('BEFORE:\n', x_block)
  y_block = psum_scatter(x_block, 'i', tiled=True)
  print('AFTER:\n', y_block)
  return y_block

x = jnp.array([3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, 8, 9, 7, 1, 2])
y = f8(x)
print('FINAL RESULT:\n', y)
`all_to_all`
源 fenced block 47:notebook 代码单元
@jax.shard_map(in_specs=jax.P('i'), out_specs=jax.P('i'))
def f9(x_block):
  print('BEFORE:\n', x_block)
  y_block = jax.lax.all_to_all(x_block, 'i', split_axis=0, concat_axis=0,
                               tiled=True)
  print('AFTER:\n', y_block)
  return y_block

x = jnp.array([3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, 8, 9, 7, 1, 2])
y = f9(x)
print('FINAL RESULT:\n', y)
`all_to_all`
源 fenced block 48:独立 Python 代码片段
def all_to_all_ref(_, x_blocks, *, tiled=False):
  axis_size = len(x_blocks)
  if tiled:
    splits = [jnp.array_split(x, axis_size) for x in x_blocks]
    return [jnp.concatenate(s) for s in zip(*splits)]
  else:
    splits = [list(x) for x in x_blocks]
    return [jnp.stack(s) for s in zip(*splits)]
Matrix multiplies
源 fenced block 49:notebook 代码单元
import jax
import jax.numpy as jnp
Matrix multiplies
源 fenced block 50:notebook 代码单元
mesh = jax.make_mesh((4,), ('i',), (Auto,))
jax.set_mesh(mesh)

def device_put(x, pspec):
  return jax.device_put(x, pspec)
Example 1: `all_gather` on one side
源 fenced block 51:notebook 代码单元
lhs_spec = jax.P('i', None)
lhs = device_put(jax.random.normal(jax.random.key(0), (8, 8)), lhs_spec)
Example 1: `all_gather` on one side
源 fenced block 52:notebook 代码单元
rhs_spec = jax.P('i', None)
rhs = device_put(jax.random.normal(jax.random.key(1), (8, 4)), rhs_spec)
Example 1: `all_gather` on one side
源 fenced block 53:notebook 代码单元
@jax.jit
@jax.shard_map(in_specs=(lhs_spec, rhs_spec),
               out_specs=rhs_spec)
def matmul_allgather(lhs_block, rhs_block):
  rhs = jax.lax.all_gather(rhs_block, 'i', tiled=True)
  return lhs_block @ rhs
Example 1: `all_gather` on one side
源 fenced block 54:notebook 代码单元
out = matmul_allgather(lhs, rhs)
print(jnp.allclose(out, lhs @ rhs, atol=1e-3, rtol=1e-3))
Example 1: `all_gather` on one side
源 fenced block 55:notebook 代码单元
@jax.jit
@jax.shard_map(in_specs=(lhs_spec, rhs_spec),
               out_specs=rhs_spec)
def matmul_allgather_overlapped(lhs_block, rhs_block):
  size = jax.lax.axis_size('i')
  idx = jax.lax.axis_index('i')
  shift = partial(jax.lax.ppermute, axis_name='i',
                  perm=[(i, (i + 1) % size) for i in range(size)])

  B = lhs_block.shape[1] // size
  lhs_blocks = lambda i: lax.dynamic_slice_in_dim(lhs_block, i * B, B, 1)

  out_block = lhs_blocks(idx) @ rhs_block
  for i in range(1, size):
    rhs_block = shift(rhs_block)
    out_block += lhs_blocks((idx - i) % size) @ rhs_block
  return out_block
Example 1: `all_gather` on one side
源 fenced block 56:notebook 代码单元
out = matmul_allgather_overlapped(lhs, rhs)
print(jnp.allclose(out, lhs @ rhs, atol=1e-3, rtol=1e-3))
Example 1: `all_gather` on one side
源 fenced block 57:notebook 代码单元
@jax.jit
@jax.shard_map(in_specs=(lhs_spec, rhs_spec),
               out_specs=rhs_spec)
def matmul_allgather_overlapped_bidi(lhs_block, rhs_block):
  size = jax.lax.axis_size('i')
  idx = jax.lax.axis_index('i')
  shift_up = partial(jax.lax.ppermute, axis_name='i',
                     perm=[(i, (i + 1) % size) for i in range(size)])
  shift_dn = partial(jax.lax.ppermute, axis_name='i',
                     perm=[(i, (i - 1) % size) for i in range(size)])

  B = lhs_block.shape[1] // size // 2  # half-size blocks
  lhs_blocks = lambda i, hi: lax.dynamic_slice_in_dim(lhs_block, (2*i+hi) * B, B, 1)

  def block_matmul(rhs_lo, rhs_hi, i_lo, i_hi):
    lhs_lo = jnp.pad(lhs_blocks(i_lo, 0), [(0, 0), (0, B)])
    lhs_hi = jnp.pad(lhs_blocks(i_hi, 1), [(0, 0), (B, 0)])
    rhs_lo = jnp.pad(rhs_lo, [(0, B), (0, 0)])
    rhs_hi = jnp.pad(rhs_hi, [(B, 0), (0, 0)])
    return (lhs_lo + lhs_hi) @ (rhs_lo + rhs_hi)

  rhs_block_lo, rhs_block_hi = jnp.split(rhs_block, 2, axis=0)
  out_block = block_matmul(rhs_block_lo, rhs_block_hi, idx, idx)
  for i in range(1, size):
    rhs_block_lo = shift_up(rhs_block_lo)
    rhs_block_hi = shift_dn(rhs_block_hi)
    out_block += block_matmul(rhs_block_lo, rhs_block_hi,
                              (idx - i) % size, (idx + i) % size)
  return out_block
Example 1: `all_gather` on one side
源 fenced block 58:notebook 代码单元
out = matmul_allgather_overlapped_bidi(lhs, rhs)
print(jnp.allclose(out, lhs @ rhs, atol=1e-3, rtol=1e-3))
Example 2: `psum_scatter` the result
源 fenced block 59:notebook 代码单元
lhs_spec = jax.P(None, 'i')
lhs = device_put(lhs, lhs_spec)

rhs_spec = jax.P('i', None)
rhs = device_put(rhs, rhs_spec)
Example 2: `psum_scatter` the result
源 fenced block 60:notebook 代码单元
@jax.shard_map(in_specs=(lhs_spec, rhs_spec),
               out_specs=rhs_spec)
def matmul_psumscatter(lhs_block, rhs_block):
  out_summand = lhs_block @ rhs_block
  return jax.lax.psum_scatter(out_summand, 'i', tiled=True)

out = matmul_psumscatter(lhs, rhs)
print(jnp.allclose(out, lhs @ rhs, atol=1e-3, rtol=1e-3))
Example 2: `psum_scatter` the result
源 fenced block 61:notebook 代码单元
@jax.shard_map(in_specs=(lhs_spec, rhs_spec),
               out_specs=rhs_spec)
def matmul_psumscatter_overlapped(lhs_block, rhs_block):
  size = jax.lax.axis_size('i')
  idx = jax.lax.axis_index('i')
  shift = partial(jax.lax.ppermute, axis_name='i',
                  perm=[(i, (i - 1) % size) for i in range(size)])
  lhs_block = lhs_block.reshape(size, -1, lhs_block.shape[1])  # split 1st axis

  out_summand = lhs_block[(idx + 1) % size] @ rhs_block
  for i in range(1, size):
    out_summand = shift(out_summand)
    out_summand += lhs_block[(idx + i + 1) % size] @ rhs_block
  return out_summand
Example 2: `psum_scatter` the result
源 fenced block 62:notebook 代码单元
out = matmul_psumscatter_overlapped(lhs, rhs)
print(jnp.allclose(out, lhs @ rhs, atol=1e-3, rtol=1e-3))
Example 2: `psum_scatter` the result
源 fenced block 63:notebook 代码单元
@jax.shard_map(in_specs=(lhs_spec, rhs_spec),
               out_specs=rhs_spec)
def matmul_psumscatter_overlapped_bidi(lhs_block, rhs_block):
  size = jax.lax.axis_size('i')
  idx = jax.lax.axis_index('i')
  shift_up = partial(jax.lax.ppermute, axis_name='i',
                     perm=[(i, (i + 1) % size) for i in range(size)])
  shift_dn = partial(jax.lax.ppermute, axis_name='i',
                     perm=[(i, (i - 1) % size) for i in range(size)])

  B = lhs_block.shape[0] // size // 2  # half-size blocks
  lhs_blocks = lambda i, hi: lax.dynamic_slice_in_dim(lhs_block, (2*i+hi) * B, B, 0)

  out_summand_lo = lhs_blocks((idx - 1) % size, 0) @ rhs_block
  out_summand_hi = lhs_blocks((idx + 1) % size, 1) @ rhs_block
  for i in range(1, size):
    out_summand_lo = shift_up(out_summand_lo)
    out_summand_hi = shift_dn(out_summand_hi)
    out_summand_lo += lhs_blocks((idx - i - 1) % size, 0) @ rhs_block
    out_summand_hi += lhs_blocks((idx + i + 1) % size, 1) @ rhs_block
  return jnp.concatenate([out_summand_lo, out_summand_hi])
Example 2: `psum_scatter` the result
源 fenced block 64:notebook 代码单元
out = matmul_psumscatter_overlapped_bidi(lhs, rhs)
print(jnp.allclose(out, lhs @ rhs, atol=1e-3, rtol=1e-3))
Neural networks
源 fenced block 65:notebook 代码单元
import jax
import jax.numpy as jnp

def predict(params, inputs):
  for W, b in params:
    outputs = jnp.dot(inputs, W) + b
    inputs = jax.nn.relu(outputs)
  return outputs

def loss(params, batch):
  inputs, targets = batch
  predictions = predict(params, inputs)
  return jnp.mean(jnp.sum((predictions - targets) ** 2, axis=-1))
Neural networks
源 fenced block 66:notebook 代码单元
def init_layer(key, n_in, n_out):
  k1, k2 = jax.random.split(key)
  W = jax.random.normal(k1, (n_in, n_out)) / jnp.sqrt(n_in)
  b = jax.random.normal(k2, (n_out,))
  return W, b

def init(key, layer_sizes, batch_size):
  key, *keys = jax.random.split(key, len(layer_sizes))
  params = list(map(init_layer, keys, layer_sizes[:-1], layer_sizes[1:]))

  key, *keys = jax.random.split(key, 3)
  inputs = jax.random.normal(keys[0], (batch_size, layer_sizes[0]))
  targets = jax.random.normal(keys[1], (batch_size, layer_sizes[-1]))

  return params, (inputs, targets)
Neural networks
源 fenced block 67:notebook 代码单元
layer_sizes = [784, 128, 128, 128, 128, 128, 8]
batch_size = 32

params, batch = init(jax.random.key(0), layer_sizes, batch_size)
8-way batch data parallelism
源 fenced block 68:notebook 代码单元
mesh = jax.make_mesh((8,), ('batch',))
jax.set_mesh(mesh)

# replicate initial params on all devices, shard data batch over devices
batch = jax.device_put(batch, jax.P('batch'))
params = jax.device_put(params, jax.P())

# adapt the loss function to sum the losses across devices
@jax.shard_map(out_specs=jax.P())
def loss_dp(params, local_batch):
  inputs, targets = local_batch
  predictions = predict(params, inputs)  # use reference `predict`
  local_loss = jnp.mean(jnp.sum((predictions - targets)**2, axis=-1))
  return jax.lax.pmean(local_loss, 'batch')
8-way batch data parallelism
源 fenced block 69:notebook 代码单元
print(jax.jit(loss)(params, batch))
print(jax.jit(loss_dp)(params, batch))
8-way batch data parallelism
源 fenced block 70:notebook 代码单元
def allclose(a, b):
  return tree_all(tree_map(partial(jnp.allclose, atol=1e-2, rtol=1e-2), a, b))

print(allclose(jax.jit(jax.grad(loss))(params, batch),
               jax.jit(jax.grad(loss_dp))(params, batch)))
8-way batch data parallelism
源 fenced block 71:notebook 代码单元
jaxpr = jax.jit(jax.value_and_grad(loss_dp)).trace(params, batch).jaxpr
for line in str(jaxpr).splitlines():
  if 'psum' in line:
    print(line)
8-way fully sharded data parallelism (FSDP)
源 fenced block 72:notebook 代码单元
# shard data batch *and params* over devices
mesh = jax.make_mesh((8,), ('batch',))
jax.set_mesh(mesh)
batch = jax.device_put(batch, jax.P('batch'))
params = jax.device_put(params, jax.P('batch'))

# gather weights just before their use, and (via remat) re-gather them on the
# backward pass rather than saving them
@jax.remat
def layer_fsdp(W_frag, b_frag, inputs):
  W = jax.lax.all_gather(W_frag, 'batch', tiled=True)
  b = jax.lax.all_gather(b_frag, 'batch', tiled=True)
  return jnp.dot(inputs, W) + b

def predict_fsdp(params_frag, inputs):
  for W_frag, b_frag in params_frag:
    outputs = layer_fsdp(W_frag, b_frag, inputs)
    inputs = jax.nn.relu(outputs)
  return outputs

@jax.shard_map(out_specs=jax.P())
def loss_fsdp(local_params, local_batch):
  inputs, targets = local_batch
  predictions = predict_fsdp(local_params, inputs)
  local_loss = jnp.mean(jnp.sum((predictions - targets) ** 2, axis=-1))
  return jax.lax.pmean(local_loss, 'batch')
8-way fully sharded data parallelism (FSDP)
源 fenced block 73:notebook 代码单元
repl_params = jax.device_put(params, jax.P())
repl_batch = jax.device_put(batch, jax.P())
print(jax.jit(loss)(repl_params, repl_batch))
print(jax.jit(loss_fsdp)(params, batch))

print(allclose(jax.jit(jax.grad(loss))(repl_params, repl_batch),
               jax.jit(jax.grad(loss_fsdp))(params, batch)))
8-way fully sharded data parallelism (FSDP)
源 fenced block 74:notebook 代码单元
hlo = jax.jit(jax.grad(loss_fsdp)).lower(params, batch).compile().as_text()
print(hlo.count('all-gather('))
8-way tensor parallelism (TP)
源 fenced block 75:notebook 代码单元
mesh = jax.make_mesh((8,), ('feats',))
jax.set_mesh(mesh)

batch = jax.device_put(batch, jax.P(None, 'feats'))
params = jax.device_put(params, jax.P('feats'))

def predict_tp(params, inputs):
  for W, b in params:
    outputs = gemm_tp(inputs, W, b)
    inputs = jax.nn.relu(outputs)
  return outputs

@jax.shard_map(in_specs=(jax.P(None, 'feats'), jax.P('feats', None), jax.P('feats')),
               out_specs=jax.P(None, 'feats'))
def gemm_tp(inputs, W, b):
  block_result = jnp.dot(inputs, W)
  return jax.lax.psum_scatter(block_result, 'feats',
                              scatter_dimension=1, tiled=True) + b

def loss_tp(params, batch):
  inputs, targets = batch
  predictions = predict_tp(params, inputs)
  return jnp.mean(jnp.sum((predictions - targets) ** 2, axis=-1))  # NOTE psum!
8-way tensor parallelism (TP)
源 fenced block 76:notebook 代码单元
repl_params = jax.device_put(params, jax.P())
repl_batch = jax.device_put(batch, jax.P())
print(jax.jit(loss)(repl_params, repl_batch))
print(jax.jit(loss_tp)(params, batch))

print(allclose(jax.jit(jax.grad(loss))(repl_params, repl_batch),
               jax.jit(jax.grad(loss_tp))(params, batch)))
FSDP + TP, with `shard_map` at the top level
源 fenced block 77:notebook 代码单元
mesh = jax.make_mesh((4, 2), ('batch', 'feats'))
jax.set_mesh(mesh)

batch = jax.device_put(batch, jax.P('batch', 'feats'))
params = jax.device_put(params, jax.P(('feats', 'batch')))

# same as layer_fsdp, except the matmul is also tensor-parallel, as in gemm_tp
@jax.remat
def layer_fsdp_tp(W_frag, b_frag, inputs):
  W = jax.lax.all_gather(W_frag, 'batch', tiled=True)
  b = jax.lax.all_gather(b_frag, 'batch', tiled=True)
  block_result = jnp.dot(inputs, W)
  return jax.lax.psum_scatter(block_result, 'feats',
                              scatter_dimension=1, tiled=True) + b

def predict_fsdp_tp(params_frag, inputs):
  for W_frag, b_frag in params_frag:
    outputs = layer_fsdp_tp(W_frag, b_frag, inputs)
    inputs = jax.nn.relu(outputs)
  return outputs

@jax.shard_map(in_specs=(jax.P(('feats', 'batch')), jax.P('batch', 'feats')),
               out_specs=jax.P())
def loss_fsdp_tp(local_params, local_batch):
  inputs, targets = local_batch
  predictions = predict_fsdp_tp(local_params, inputs)
  sq_err = jax.lax.psum(jnp.sum((predictions - targets) ** 2, axis=-1), 'feats')
  return jax.lax.pmean(jnp.mean(sq_err), 'batch')
FSDP + TP, with `shard_map` at the top level
源 fenced block 78:notebook 代码单元
repl_params = jax.device_put(params, jax.P())
repl_batch = jax.device_put(batch, jax.P())
print(jax.jit(loss)(repl_params, repl_batch))
print(jax.jit(loss_fsdp_tp)(params, batch))

print(allclose(jax.jit(jax.grad(loss))(repl_params, repl_batch),
               jax.jit(jax.grad(loss_fsdp_tp))(params, batch)))
SPMD pipeline parallelism (PP)
源 fenced block 79:notebook 代码单元
L = len(params) - 2        # num layers, excluding first and last
N = batch_size             # batch size
F = params[0][0].shape[1]  # num features

# choose some pipeline parameters
S = 2      # number of stages
B = 8      # size of each microbatch
assert L % S == 0, "S (number of stages) must divide L (number of inner layers)"

# compute some useful quantities
M, ragged = divmod(N, B)  # M is number of microbatches
assert not ragged, "B (size of each microbatch) must divide total batch size"
K, ragged = divmod(M, S)  # K is microbatches per stage
assert not ragged, "S (number of stages) must divide number of microbatches"
print(f'{S} stages, {L // S} layer(s) per stage, {L} pipelined layers total')
print(f'{B} examples per microbatch, {M} microbatches total')
SPMD pipeline parallelism (PP)
源 fenced block 80:notebook 代码单元
mesh = jax.make_mesh((S,), ('stages',), (Auto,))

def predict_pp(params, inputs):
  (W_first, b_first), inner_params, (W_last, b_last) = params
  inputs = jax.nn.relu(jnp.dot(inputs, W_first) + b_first)
  inputs = spmd_pipeline(lambda Wb, x: jax.nn.relu(x @ Wb[0] + Wb[1]),
                        inner_params, inputs)
  outputs = jnp.dot(inputs, W_last) + b_last
  return outputs

@jax.shard_map(in_specs=((jax.P(), jax.P('stages'), jax.P()), jax.P('stages')), out_specs=jax.P())
def loss_pp(params, batch):
  inputs, targets = batch
  predictions = predict_pp(params, inputs.reshape(K, B, -1)).reshape(K * B, -1)
  local_loss = jnp.mean(jnp.sum((predictions - targets)**2, axis=-1))
  return jax.lax.pmean(local_loss, 'stages')
SPMD pipeline parallelism (PP)
源 fenced block 81:notebook 代码单元
def spmd_pipeline(fn, stage_params, inputs):
  stage = jax.lax.axis_index('stages')
  outputs = jnp.zeros_like(inputs) * jnp.nan
  state = jnp.zeros((L // S, B, F)) * jnp.nan
  for i in range(M+L-1):
    state = state.at[0].set(jnp.where(stage == 0, inputs[i % K], state[0]))
    state = jax.vmap(fn)(stage_params, state)
    outputs = outputs.at[(i-L+1) % K].set(jnp.where(stage == S-1, state[-1], outputs[(i-L+1) % K]))
    state, inputs, outputs = shift(i, state, inputs, outputs)
  outputs = jax.lax.ppermute(outputs, 'stages', [(i, (i+1) % S) for i in range(S)])
  return outputs

def shift(i, state, inputs, outputs):
  sh = lambda x, d: jax.lax.ppermute(x, 'stages', [(i, (i+d) % S) for i in range(S)])
  state = jnp.roll(state, +1, axis=0).at[0].set(sh(state[-1], +1))
  if (i % K) == (-1 % K):
    inputs = sh(inputs, +1)
  if ((i-L+1) % K) == (-1 % K):
    outputs = sh(outputs, +1)
  return state, inputs, outputs
SPMD pipeline parallelism (PP)
源 fenced block 82:notebook 代码单元
first_params, *inner_params, last_params = params
from jax.sharding import NamedSharding

Ws, bs = zip(*inner_params)
params_stacked = jnp.stack(Ws), jnp.stack(bs)
first_params = jax.device_put(first_params, NamedSharding(mesh, jax.P()))
params_stacked = jax.device_put(params_stacked, NamedSharding(mesh, jax.P('stages')))
last_params = jax.device_put(last_params, NamedSharding(mesh, jax.P()))
params_ = first_params, params_stacked, last_params

batch_ = jax.device_put(batch, NamedSharding(mesh, jax.P('stages')))
SPMD pipeline parallelism (PP)
源 fenced block 83:notebook 代码单元
jax.set_mesh(mesh)
print(jax.jit(loss_pp)(params_, batch_))
SPMD pipeline parallelism (PP)
源 fenced block 84:notebook 代码单元
_ = jax.jit(jax.grad(loss_pp))(params_, batch_) # don't crash









暂无评论内容