


从窗口函数推导 TopN 或 Limit:读懂 TiDB 的六种执行计划
原文:PingCAP 及 TiDB 文档贡献者《从窗口函数中推导 TopN 或 Limit》。本文依据官方中文 stable 页面整理;随稿页面快照的版本导航显示 v8.5,本轮于 2026 年 10 月 8 日复核了页面内容。本功能自 v7.0.0 引入。本文保留六组示例的语义和执行计划要点,并明确标注编辑修正;没有执行 SQL 或测量性能。
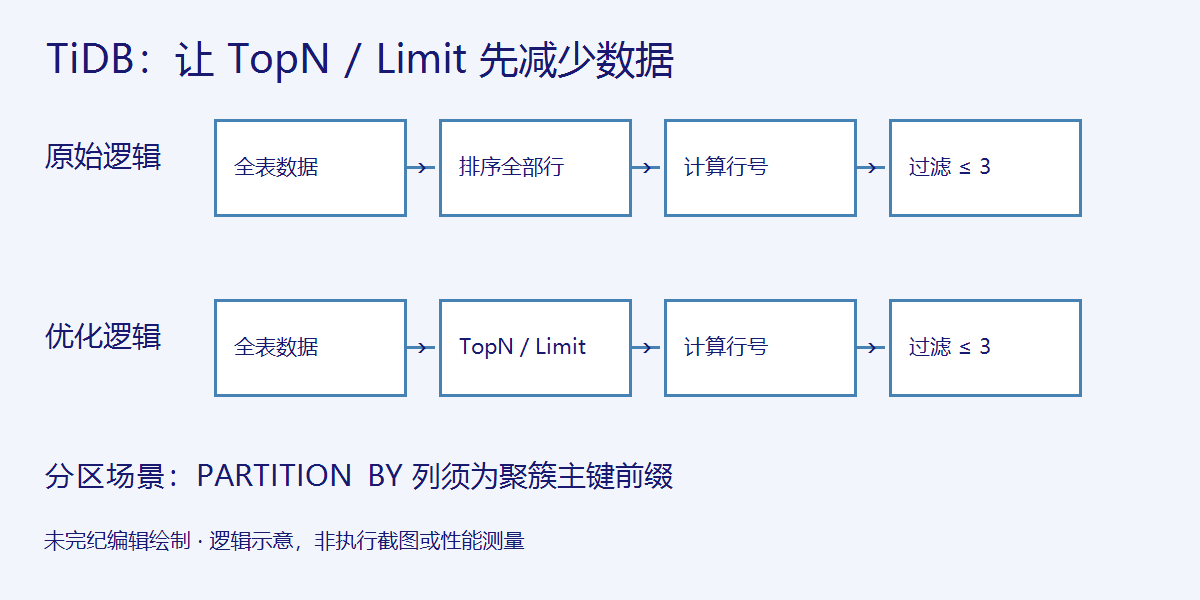
窗口函数常用来给行编号,再由外层查询筛选前几行。看起来只要三行,数据库却可能先排序整张表,为所有行计算编号,最后才丢弃绝大多数结果。TiDB 的这条优化规则会识别这种模式,从窗口函数及其上层过滤条件中推导出 TopN 或 Limit,让更少的数据进入后续窗口计算。
先理解改写的含义
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (ORDER BY a) AS rownumber
  FROM t
) AS dt
WHERE rownumber <= 3;
按直接的执行顺序,TiDB 对 t 的数据排序,生成行号,再执行 rownumber <= 3。推导 TopN 后,可以用下面的 SQL 表达其逻辑效果:
WITH t_topN AS (
  SELECT a FROM t ORDER BY a LIMIT 3
)
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (ORDER BY a) AS rownumber
  FROM t_topN
) AS dt
WHERE rownumber <= 3;编辑修正:原文前一条查询使用 t,改写示意却读取 t1。这里统一为 t,只修正名称,未改变优化意图。这段改写用于解释规则,不要求应用手工把所有窗口查询改成 CTE。
TopN 只需保留排序后的前 N 行,可能降低排序及后续计算的工作量。TiKV 和 TiFlash 都支持 TopN 下推,进一步减少返回上层的数据量。但是否获得性能收益取决于数据分布、访问路径和实际计划,本文没有提供速度倍数保证。
开关与支持范围
原文所述版本默认关闭这条规则。可在当前会话启用,完成核对后也可关闭:
SET SESSION tidb_opt_derive_topn = ON;
-- 当前会话关闭:
SET SESSION tidb_opt_derive_topn = OFF;
官方文档还提供通过优化规则黑名单关闭此规则的管理方式。它不同于当前会话开关,涉及管理员权限;生效范围与集群节点操作按目标版本的黑名单文档确认。不要把本页 stable 的默认值当作未来版本的固定承诺,也不要将集群级变更当作单会话设置。
- 仅支持
ROW_NUMBER()。开头提到RANK()是在介绍编号类窗口函数,并不表示该函数支持此改写。 - 过滤必须针对
ROW_NUMBER()的结果,且为<或<=。不能据此推断等号、下界或复杂谓词一定适用。 - 存在
PARTITION BY时,分区列必须是主键的前缀,而且主键必须是聚簇索引。
下面六组示例原本反复创建同名表。为便于读者在一个隔离测试库中对照,本文改用不同表名;没有加入会删除已有数据的清理语句。CREATE TABLE 会写入模式信息,表名若已存在,应停止并检查,不能直接覆盖生产对象。
示例一:不分区,也不排序
CREATE TABLE wwj_window_plain(id INT, value INT);
SET SESSION tidb_opt_derive_topn = ON;

EXPLAIN
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER () AS rownumber
  FROM wwj_window_plain
) AS dt
WHERE rownumber <= 3;
没有排序要求,前置算子可用 Limit。原文计划的关键路径如下,数值为原文的估算行数:
Projection  estRows 2.40
└─Selection  estRows 2.40  le(rownumber, 3)
  └─Window   estRows 3.00  row_number()
    └─Limit  estRows 3.00  offset:0, count:3
      └─TableReader
        └─Limit          cop[tikv], offset:0, count:3
          └─TableFullScan keep order:false, stats:pseudo
关键是 Window 下方多出 Limit,且 TiKV 侧也出现 Limit。没有 ORDER BY 的“前三行”没有业务上的稳定顺序;结果可用于演示规则,不能用于要求固定行选择的分页。
示例二:不分区,但按 value 排序
CREATE TABLE wwj_window_ordered(id INT, value INT);
SET SESSION tidb_opt_derive_topn = ON;

EXPLAIN
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (ORDER BY value) AS rownumber
  FROM wwj_window_ordered
) AS dt
WHERE rownumber <= 3;
Projection estRows 2.40
└─Selection estRows 2.40
└─Window estRows 3.00 order by value
└─TopN estRows 3.00 value, offset:0, count:3
└─TableReader
└─TopN cop[tikv], value, offset:0, count:3
└─TableFullScan estRows 10000.00, stats:pseudo这里必须比较排序值,因此推导出 TopN。扫描估算行数仍为 10000,并不表示只读取了三行;优化减少的是保留、传递和后续处理的数据。value 有重复时,仅按它排序不足以确定相同行之间的先后。如应用需要确定结果,应在实际查询中加入能唯一确定顺序的键,并重新检查计划;本文不把这样的额外排序条件伪装成原文示例。
示例三:按聚簇主键前缀分区,不排序
CREATE TABLE wwj_window_partition(
  id1 INT, id2 INT, value1 INT, value2 INT,
  PRIMARY KEY(id1, id2) CLUSTERED
);
SET SESSION tidb_opt_derive_topn = ON;

EXPLAIN
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (PARTITION BY id1) AS rownumber
  FROM wwj_window_partition
) AS dt
WHERE rownumber <= 3;
Projection → Selection → Shuffle → Window
→ Sort(id1) → TableReader
→ Limit [cop[tikv]]
partition by id1, offset:0, count:3
→ TableFullScanid1 是聚簇主键 (id1, id2) 的前缀,满足条件。TiKV 侧出现的不是全表只取三行的 Limit,而是 partition Limit:对每一组相同 id1 的数据分别限制为三行。上层仍可出现 Sort、Window 和 Shuffle,不要以“还有排序”为由判断规则没有生效。
示例四:按聚簇主键前缀分区,并排序
CREATE TABLE wwj_window_partition_ordered(
  id1 INT, id2 INT, value1 INT, value2 INT,
  PRIMARY KEY(id1, id2) CLUSTERED
);
SET SESSION tidb_opt_derive_topn = ON;

EXPLAIN
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (
    PARTITION BY id1 ORDER BY value1
  ) AS rownumber
  FROM wwj_window_partition_ordered
) AS dt
WHERE rownumber <= 3;
Projection → Selection → Shuffle → Window
→ Sort(id1, value1) → TableReader
→ TopN [cop[tikv]]
partition by id1 order by value1, offset:0, count:3
→ TableFullScan此时推导出 partition TopN,每个 id1 分组内部按 value1 选择前三行。它与全局 ORDER BY value1 LIMIT 3 的语义不同,不能互换。原文扫描估算为 10000 行,TopN 及其上层估算显示为 3;这些是原文计划的估算展示,不是每组数量分布或实际读取行数的实验记录。
value1 若有并列值,该列不足以确定组内的先后或稳定选出哪三行。业务需要可重复的行选择时,应在目标 SQL 的窗口排序中加入唯一键,并重新核对计划;这条建议不是原文示例中的 SQL。
示例五:分区列不是主键前缀
CREATE TABLE wwj_window_wrong_prefix(
  id1 INT, id2 INT, value1 INT, value2 INT,
  PRIMARY KEY(id1, id2) CLUSTERED
);
SET SESSION tidb_opt_derive_topn = ON;

EXPLAIN
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (PARTITION BY value1) AS rownumber
  FROM wwj_window_wrong_prefix
) AS dt
WHERE rownumber <= 3;
分区列换成了 value1,它不是主键前缀。原文计划为 Projection、Selection、Shuffle、Window、Sort、TableReader 和 TableFullScan,没有下推的 Limit 或 TopN。Window 与扫描的估算行数仍为 10000,过滤后为 8000;不能把这些估算解释为实际返回了 8000 行。
示例六:有主键前缀,但主键不是聚簇索引
CREATE TABLE wwj_window_nonclustered(
  id1 INT, id2 INT, value1 INT, value2 INT,
  PRIMARY KEY(id1, id2) NONCLUSTERED
);
SET SESSION tidb_opt_derive_topn = ON;

EXPLAIN
SELECT *
FROM (
  SELECT ROW_NUMBER() OVER (PARTITION BY id1) AS rownumber
  FROM wwj_window_nonclustered USE INDEX()
) AS dt
WHERE rownumber <= 3;
id1 仍是主键前缀,但主键变为非聚簇索引。原文保留 USE INDEX() 的访问路径约束,计划同样没有被此规则改写。聚簇条件与前缀条件必须同时满足,不能只检查 SQL 中有没有主键。
如何核对自己的查询
先核对 TiDB 版本、会话变量与表定义,再逐一确认窗口函数、过滤运算符、分区列和聚簇主键。随后查看 EXPLAIN 中 Window 下方是否出现正确的全局或分区 TopN/Limit,以及它是否进入存储层。原文为说明结构使用了伪统计信息(stats:pseudo),算子编号也会随版本和计划改变,不能把固定编号作为判断标准。
如果要证明性能收益,需要在授权测试环境、可比较的数据和负载下另行采样;EXPLAIN ANALYZE 会实际执行查询,并不是本轮完成的工作。这里完成的是 SQL 与计划的静态核对。示例没有拼接外部输入,也没有嵌入凭证;这项有限审查不等于对应用查询和数据库部署的全面安全保证。
来源:PingCAP 官方原文;tidb_opt_derive_topn 文档;优化规则黑名单文档。原文页面无个人作者署名,页面及 docs-cn 仓库声明版权归 PingCAP;整理改编部分依据 仓库许可声明,按 CC BY-SA 3.0 提供,并按许可“按原样”提供、不作担保。改动包括重组和改写说明、修正 t/t1 名称不一致、拆分示例表名、精简计划展示、补充估算/并列排序/操作范围说明。配图为未完纪编辑原创绘制;本文不表示 PingCAP 为本稿背书。










暂无评论内容